ARTICLE · 1212437
艾莎·明鉴 OCR:面向医学文档的图像处理与文字识别
点击上方蓝色文字关注我们

医学资料可能来自扫描件、手机拍照,也可能是对着电脑屏幕拍摄的照片。页面横置、摩尔纹干扰,以及密集排列的文字和数字,都会增加识别难度。
面向临床研究资料的采集与复核,艾莎医学研发了艾莎·明鉴 OCR 图像处理引擎,将图像处理、文字识别与字符定位串联起来,同步输出文字及对应坐标,支持私有化部署。
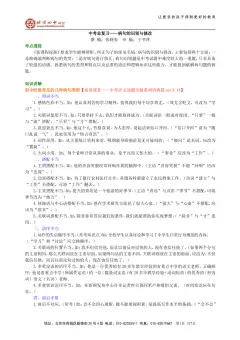
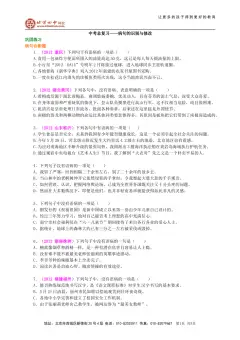
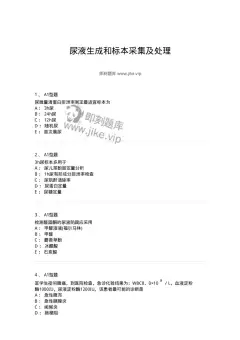
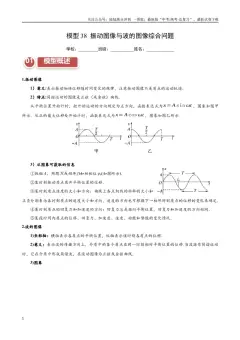
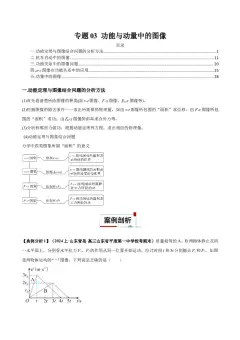
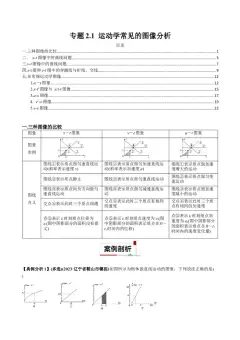
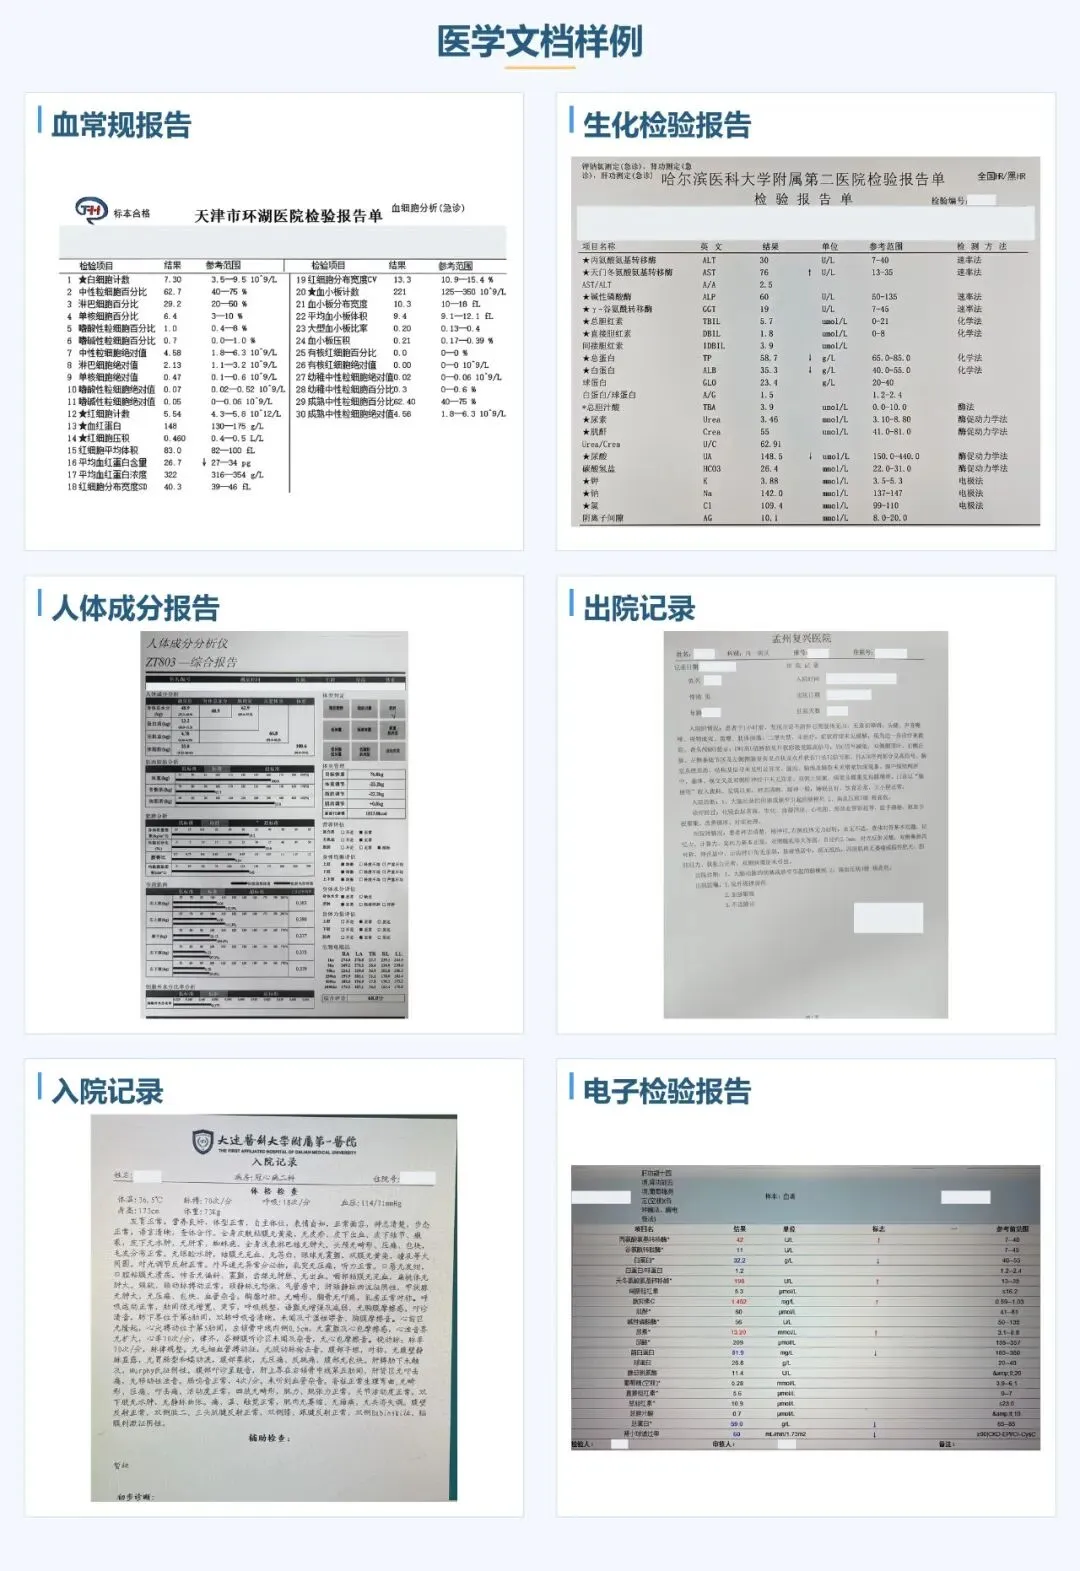
检验报告中的数值与单位、病历中的长段记录、表单里的分散字段,版式各不相同,都需要能够回到原图核对的识别结果。以下示例保留真实文档的标题、正文和表格,对身份信息及项目标识作脱敏处理,成组展示原图、处理效果与识别坐标。
页面方向识别
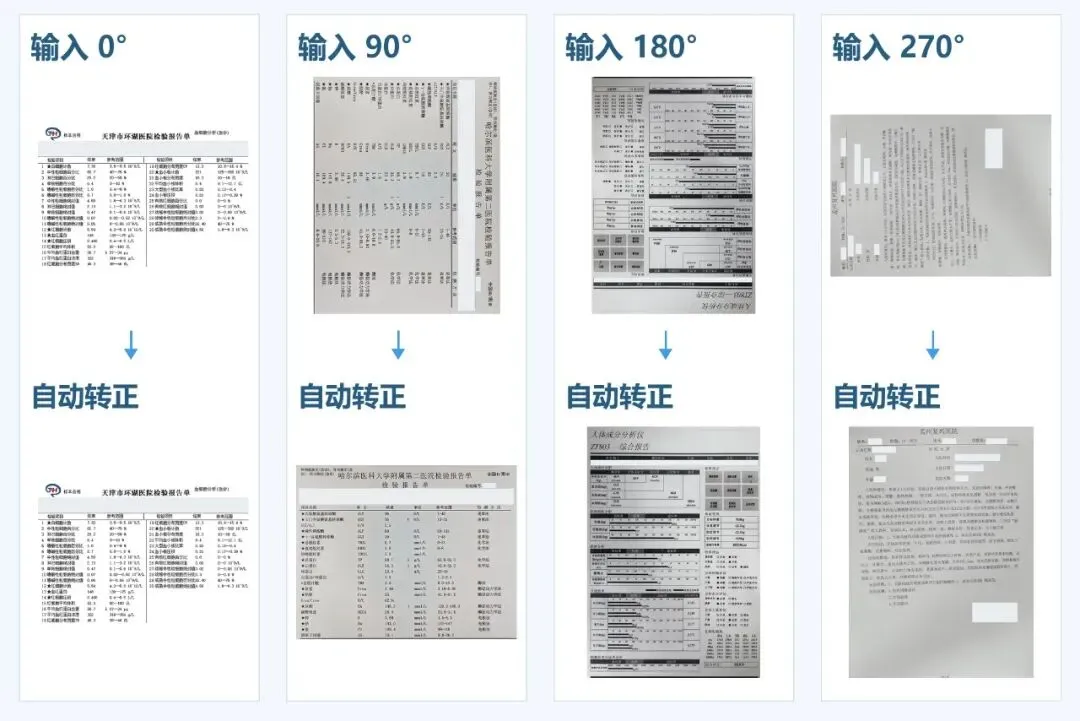
针对 0°、90°、180°、270° 四种页面方向,系统通过多视角概率融合判断朝向,再将原图转正。以 90° 为单位的旋转通过像素重排完成,无需插值,可避免旋转过程使细小文字和小数点变模糊。
多尺度去摩尔纹
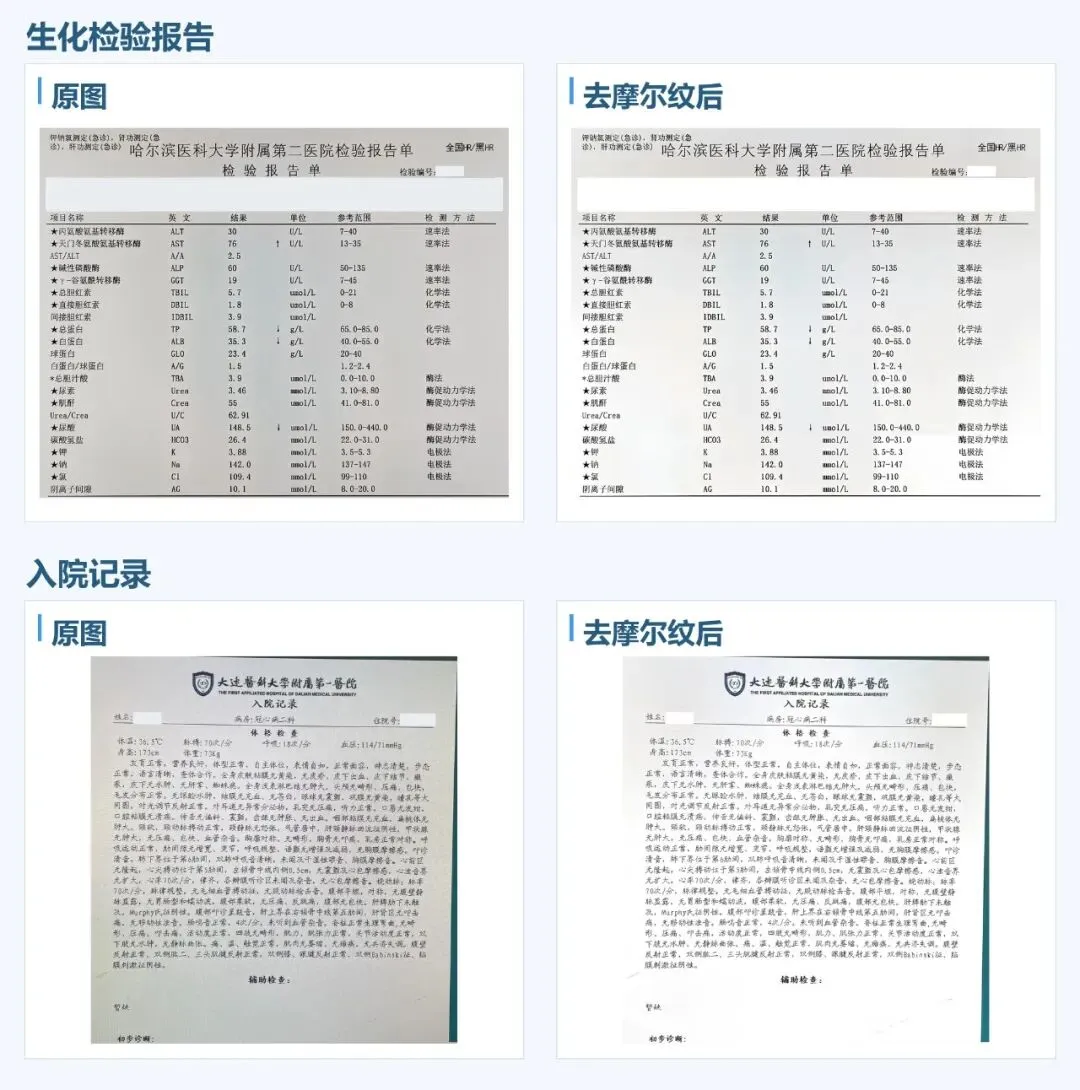
拍摄屏幕产生的摩尔纹,既可能覆盖大块背景,也可能穿过文字笔画。多尺度残差网络通过提取并融合不同尺度的图像特征,减轻纹理干扰。去摩尔纹处理在页面转正后进行,保持图像尺寸不变;大图分块计算时保留相邻区域的信息,减少分块边界的影响。
文本区域定位
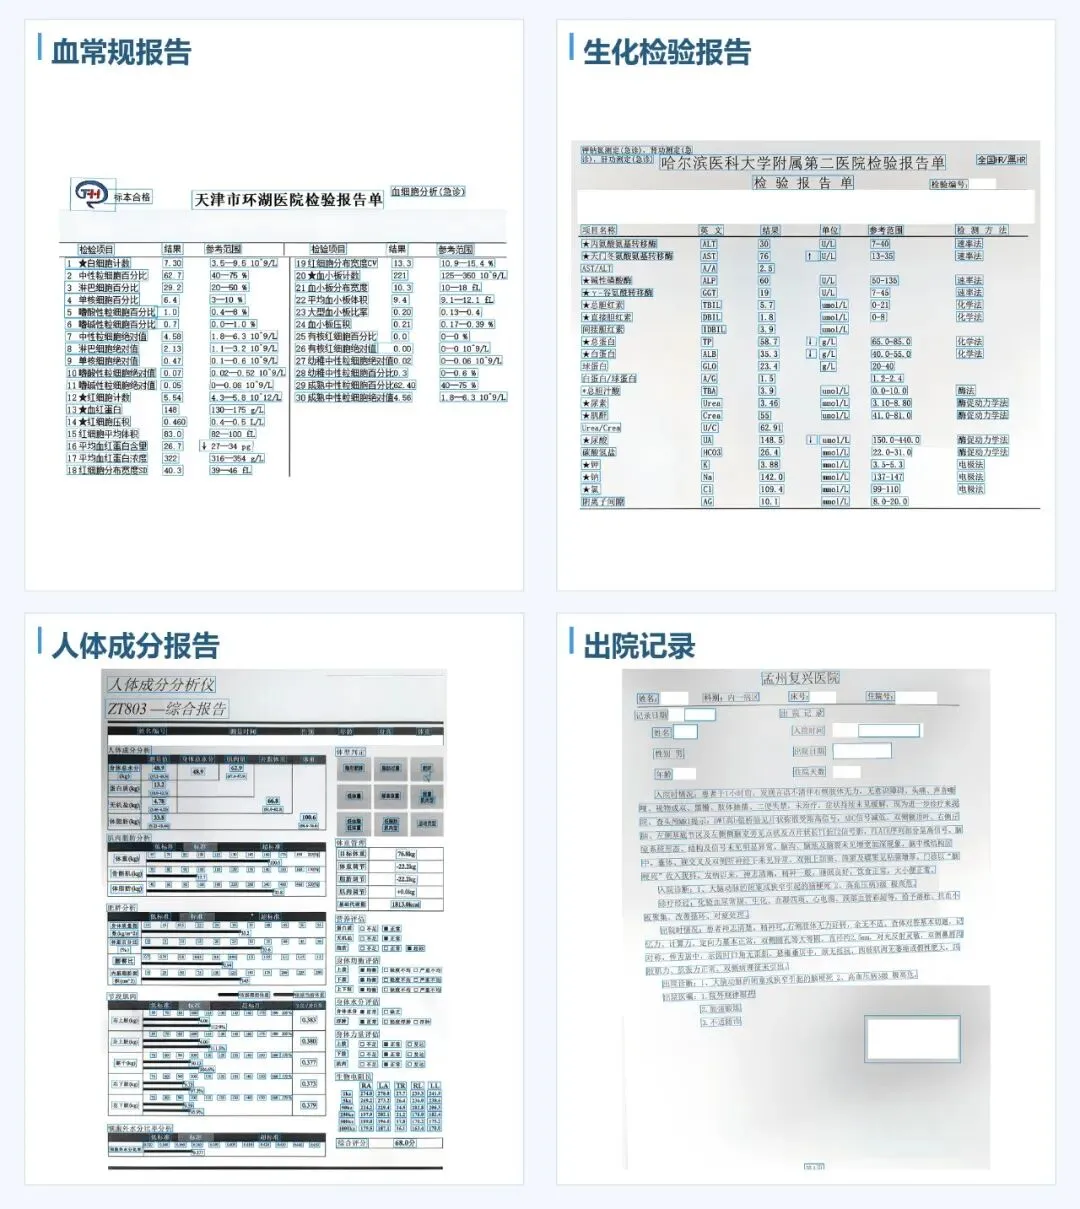
模型先定位文字区域,用四点多边形描述文本行的位置与形态。识别时,将这些区域变换为规则的文本图像,再通过逆变换将识别坐标映射回原图。检验项目、数值和分散字段的位置因此得以保留,便于后续选取、标注与复核。
文字识别与逐字定位
序列识别模型统一处理中文、英文缩写、数字和符号。借助CTC 序列对齐,系统根据字符在图像特征序列中的响应位置估计其范围,再将坐标映射回原图。每个字符的边界由实际响应估算,而非按字数等宽划分。
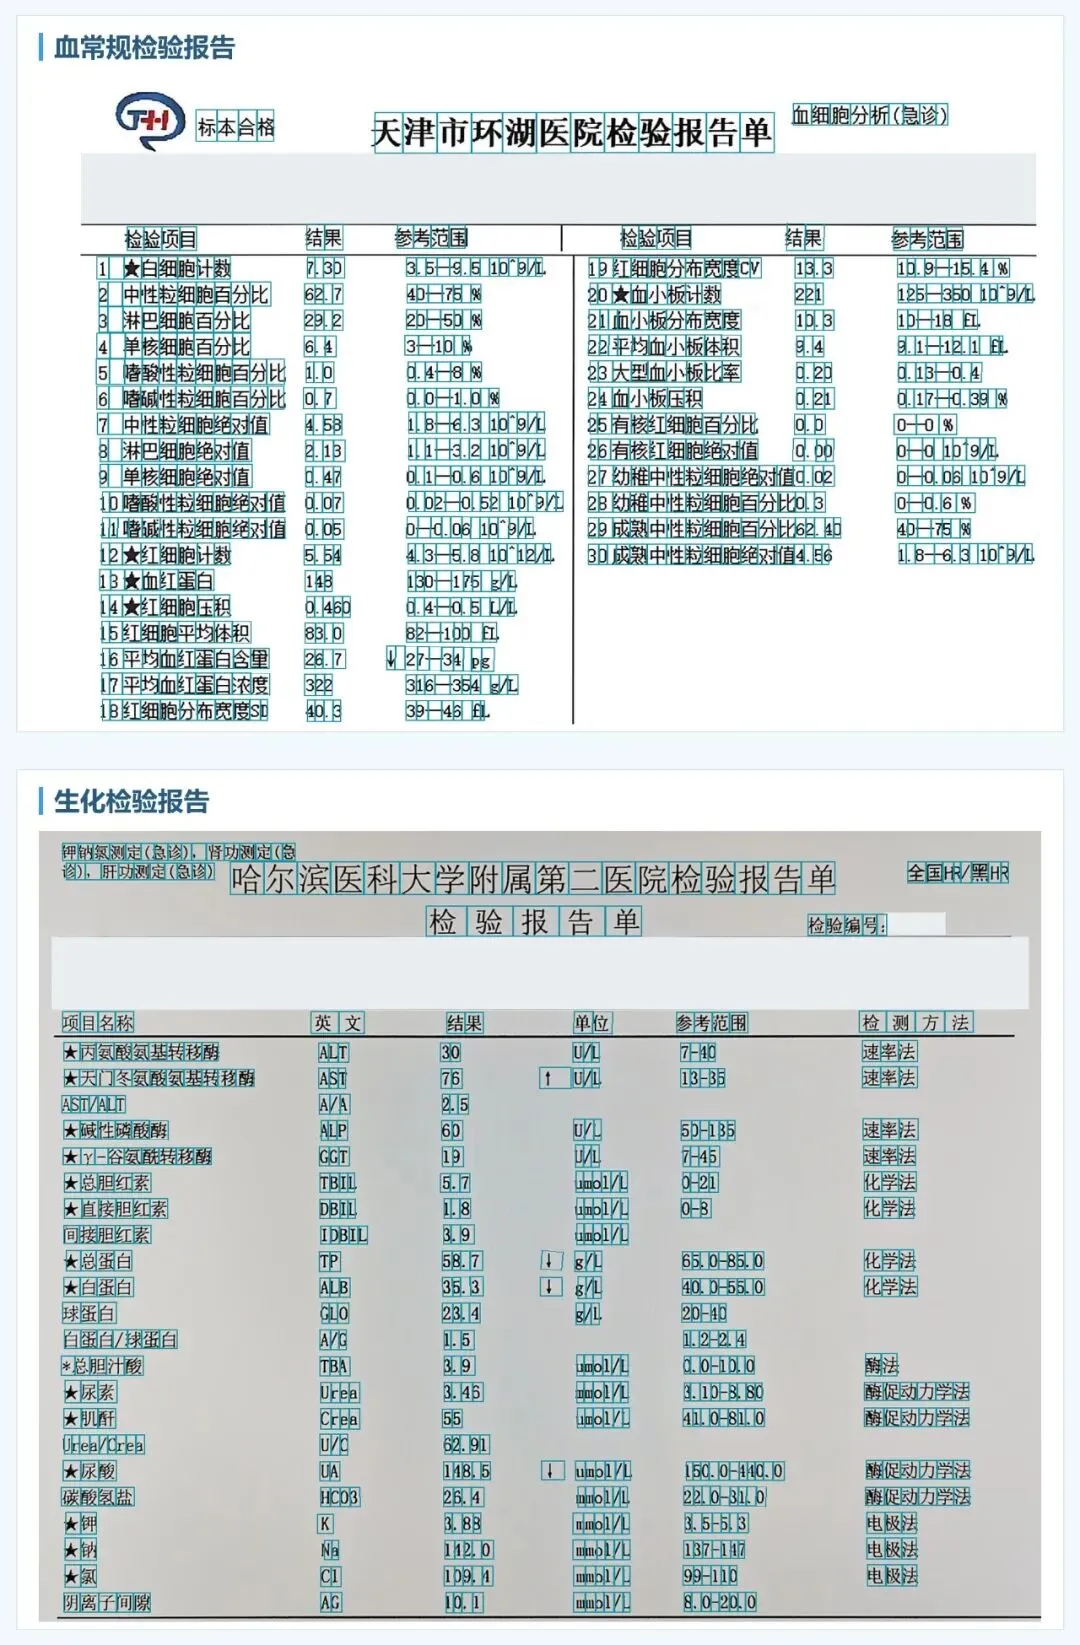
文字与坐标由同一份字符序列生成,一个输出字符对应一个字符框,也包含模型实际识别出的空格。在业务系统中选中数值或文字,即可回看原图中的对应位置。字符框是基于序列对齐估算的范围,其边界精度仍受图像质量和识别结果影响。
部署在自己的业务环境中
明鉴 OCR 将图像处理、文字识别和字符定位集成在同一套服务中,便于接入现有业务流程。模型权重在本地加载,核心推理在院内或企业服务器上运行,可通过接口对接文档采集、转录与涂鸦系统。
欢迎联系艾莎医学,结合实际业务中的典型文档,交流效果验证、系统对接与私有化部署需求。

关于艾莎医学
艾莎医学成立于2013年,是一家专注为国内外创新药械企业提供上市后临床研究、学术营销、患者管理及相关技术研发的创新数字化临床CRO公司。
目前,艾莎医学拥有近百人的技术平台研发团队,业内最完整且领先的数字化产品矩阵,覆盖全国的全职服务团队。累计服务项目500+,合作医院1,000+,承包多个国家级科研项目,覆盖感染、肿瘤、血液、肝病、内分泌、肾病、脑科学、罕见病等20+疾病领域,广受业界认可。艾莎医学基于数字化技术的创新临床研究运营管理模式,极大地提升了临床研究的管理效率及管理半径,助力创新药械的快速研发及临床验证,更好、更快地为解决患者未被满足的需求而服务。
业务涵盖研究方案设计、项目管理、患者招募、伦理立项、中心管理、数据采集监查、统计分析等临床研究服务,医生继续教育、患者科普教育等学术营销服务,慈善赠药项目管理、患者用药随访、疾病风险评估等患者病程管理服务,机构管理系统等IT产品定制服务。
更多信息,敬请垂询
商务合作:stan.fu@ashermed.com
服务热线:service@ashermed.com

END