ARTICLE · 1272497
文档解析与知识库建设:RAG 落地最耗时的环节
AI · 文档解析 · 知识库
文档解析与知识库建设:RAG 落地最耗时的环节
做企业 RAG,真正耗时的不是写检索代码,而是把一堆脏文档变成高质量知识库——解析失败、表格稀碎、切分截断、更新不同步。管道上游是垃圾,下游全白搭。这篇讲离线管道的每个环节。
这是 RAG 四部曲收官篇,先放总图:
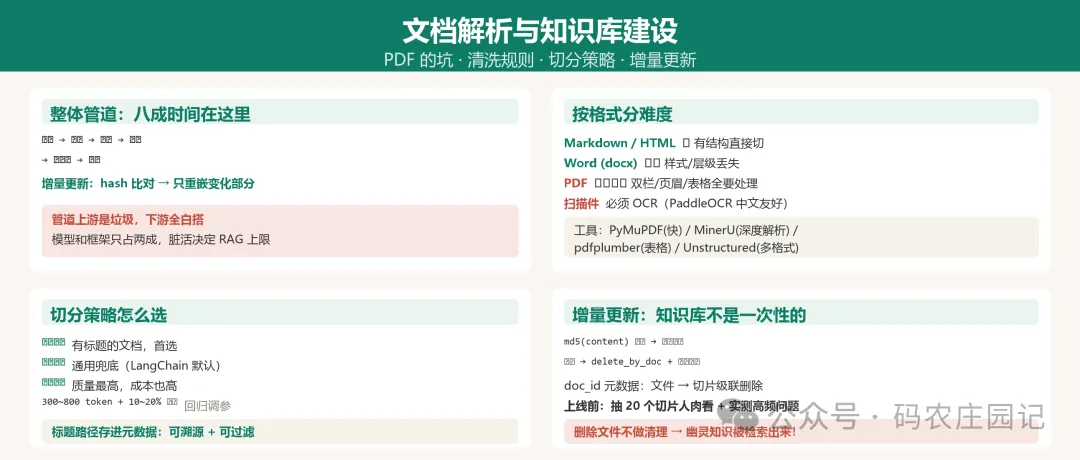
整体管道 → 解析难度 → 切分策略 → 增量更新
01
文档解析:坑最多的一环
PDF 的真实坑:
— 双栏论文按文本流抽出会串行、阅读顺序错乱;
— 扫描件没有文字层,要 OCR(PaddleOCR,中文友好);
— 表格抽成纯文本就废了,尽量转 Markdown 表格保留结构;
— 页眉页脚/水印混在正文里,污染所有切片。
清洗规则三件事:去页眉页脚(按位置/重复模式识别)、去水印文字;合并被硬换行打断的句子(中文常见「……软件\n工程……」);去重复段落、异常字符,过滤空切片。
02
切分策略深挖:四种怎么选
递归字符切分(LangChain 默认)的思想:优先按天然边界切,边界太大才降级——切出来的片段尽量是完整段落,硬切只是最后的兜底:
结构切分:Markdown 按标题层级切,并把标题路径存进元数据——
好处立竿见影:回答可溯源(引用时带章节)、检索可过滤(按文档/部门权限)、上下文更完整(同章节内容优先召回)。
03
增量更新:知识库不是一次性的
每次全量重建 = 时间 × embedding 费用双浪费。文件级 hash 比对即可覆盖大多数场景:
三个要点:
— 切片可级联删除:靠 doc_id 元数据把「文件 → 切片」关系存进向量库;
— 删除文件要有对应清理,否则出现「幽灵知识」被检索出来;
— 只改一行字的文档目前仍会整文件重嵌——追求极致可做切片级 diff,多数场景没必要。
扩展阅读:切分的基础要点(父子块、表格代码不可分割)见本系列第 1 篇《RAG 检索增强生成入门》;向量库选型与在线检索见第 2 篇《向量数据库与 RAG 实操》;检索精调见第 3 篇《混合检索与 Rerank》。
RAG 四部曲到此收官:《RAG 检索增强生成入门》建立认知,《向量数据库与 RAG 实操》跑通链路,《混合检索与 Rerank》调优检索,本篇搞定离线管道——从脏文档到可上线,一套打通。建议收藏成套,新朋友点个关注,从头翻起。
· END ·
码农庄园记 · 文档解析与知识库建设