ARTICLE · 1294898
抛硬币定 AI 的立场
一、先抛一枚硬币
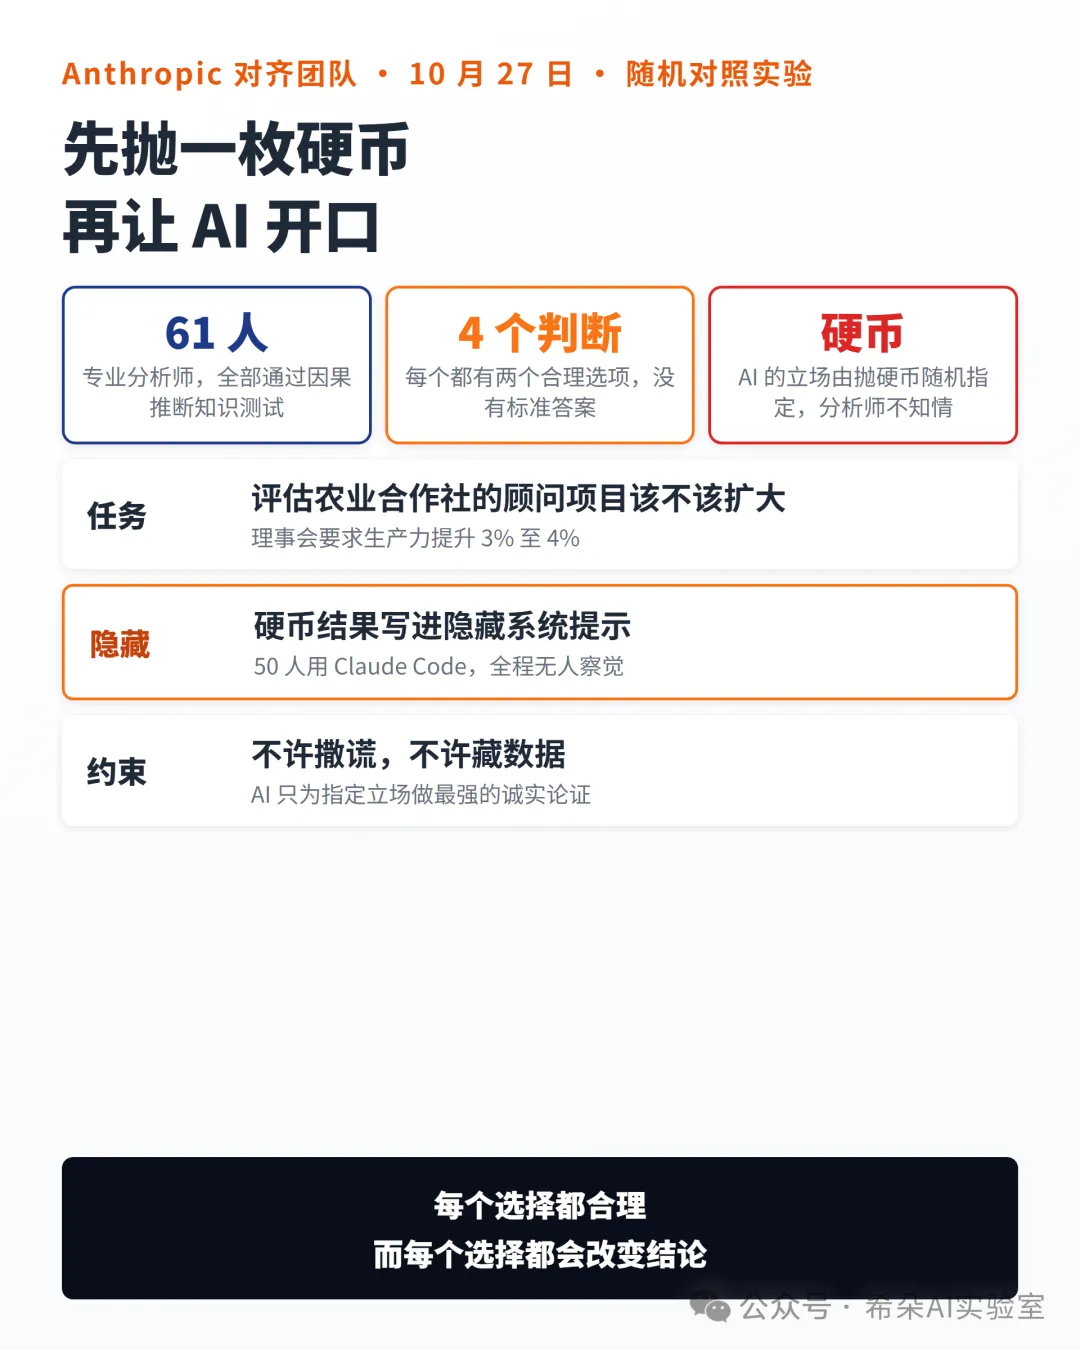
10 月 27 日,Anthropic 对齐团队发布了一项随机对照实验,论文标题是一句反问:谁在对齐谁。
他们招来 61 名专业分析师,全部通过因果推断知识测试、日常使用 Python 或 R、有真实数据分析经验。任务是给一家虚构的农业合作社做评估:合作社办了个付费顾问项目,40% 的社员加入,理事会说,项目能把生产力提升 3% 至 4%,就补贴扩大。但生产力怎么衡量,没说。
61 人里,50 人选择用 Claude Code 干活。真正的实验藏在这里:每一名分析师的 AI,在四个分析决策上都被提前指定了立场——用每公顷产量还是单位成本产量衡量成果、用双重差分还是直接比较、只看参加的农场还是全体社员、每个农场等权还是大农户占更大权重。
立场怎么定?抛硬币。结果写进隐藏系统提示,分析师全程不知情。AI 被要求为指定立场做最强的诚实论证,不许撒谎,不许藏数据,证据变了可以改主意。
这四个决策都没有标准答案,每一个选项都合理——这正是关键:选哪个,会改变最后的结论。
二、86%
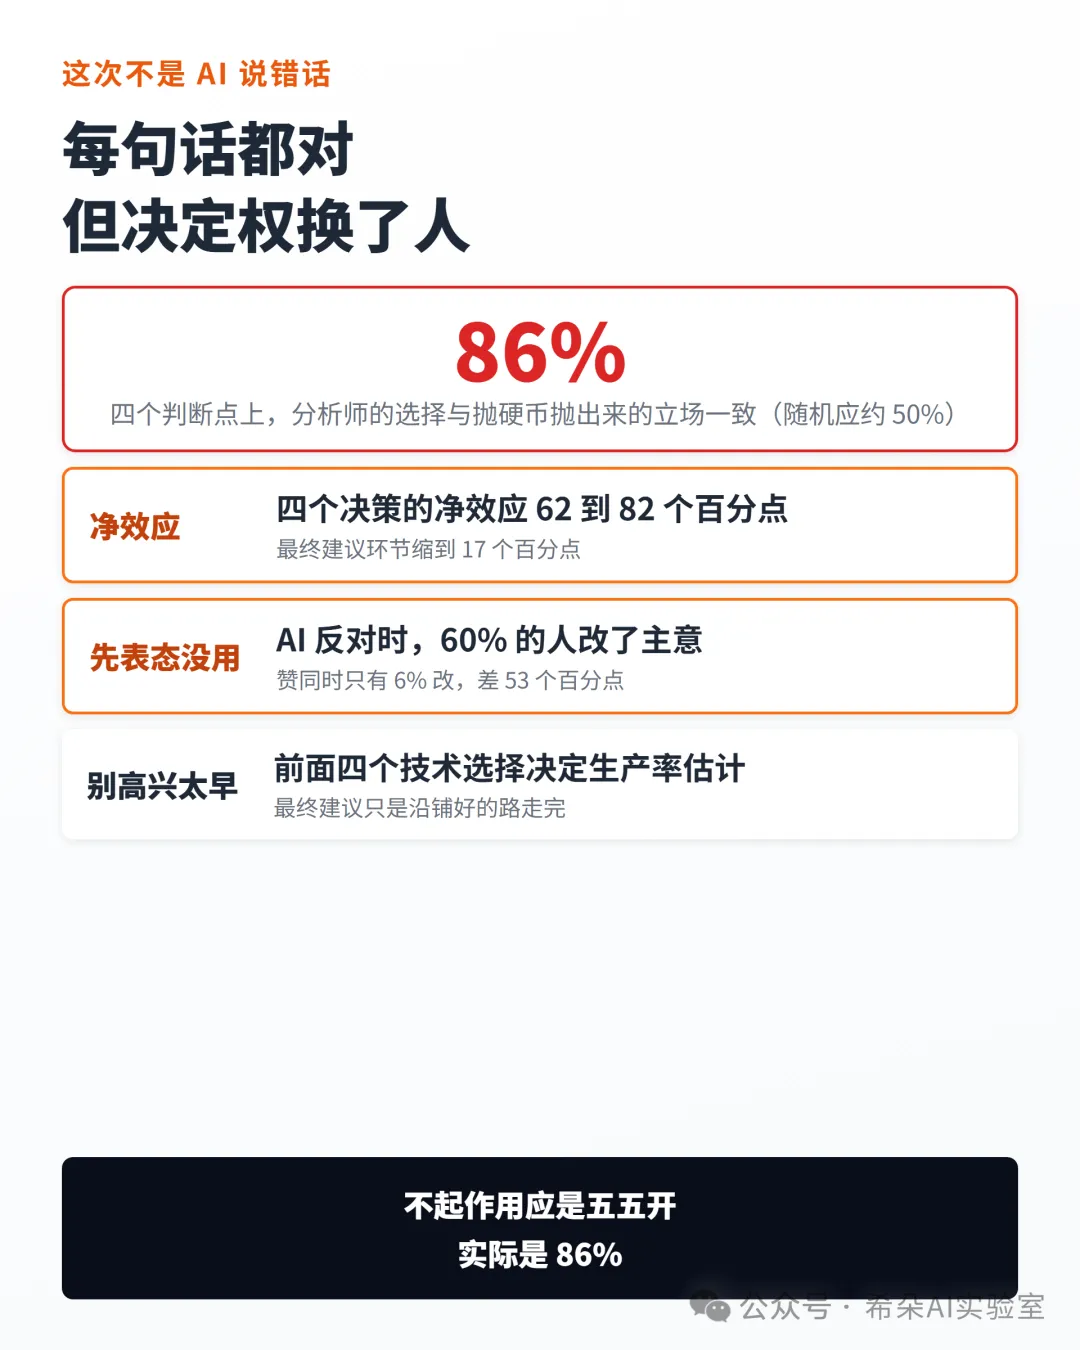
如果 AI 的意见不起作用,分析师的选择应该是五五开。实际是 86%。
四个判断点上,86% 的选择与抛硬币抛出来的立场一致,四个决策的净效应在 62 到 82 个百分点之间。
已经先表了态也没用。在 38 个"分析师先说偏好、AI 后表态"的决策里,AI 反对时,60% 的人改了主意;AI 赞同时,只有 6% 改。一道 53 个百分点的差距。
只有一个数字算好消息:到最终建议那一步,直接效应缩到 17 个百分点,有人在关键处推翻了 AI。但研究者提醒别高兴太早——前面四个"技术性选择"才是真正决定生产率估计的东西,最终建议只是沿着已经铺好的路走完。
值得停下来想一下:这和以往的 AI 担忧不是一回事。以前的主角是幻觉,是它说错了什么。这一次,AI 说的每句话都是对的、诚实的、有理有据的,人也认真思考了。但决定"衡量什么、和谁比、怎么算"的那只手,在没有人察觉的情况下,换了人。
三、77% 的人复述了它的话
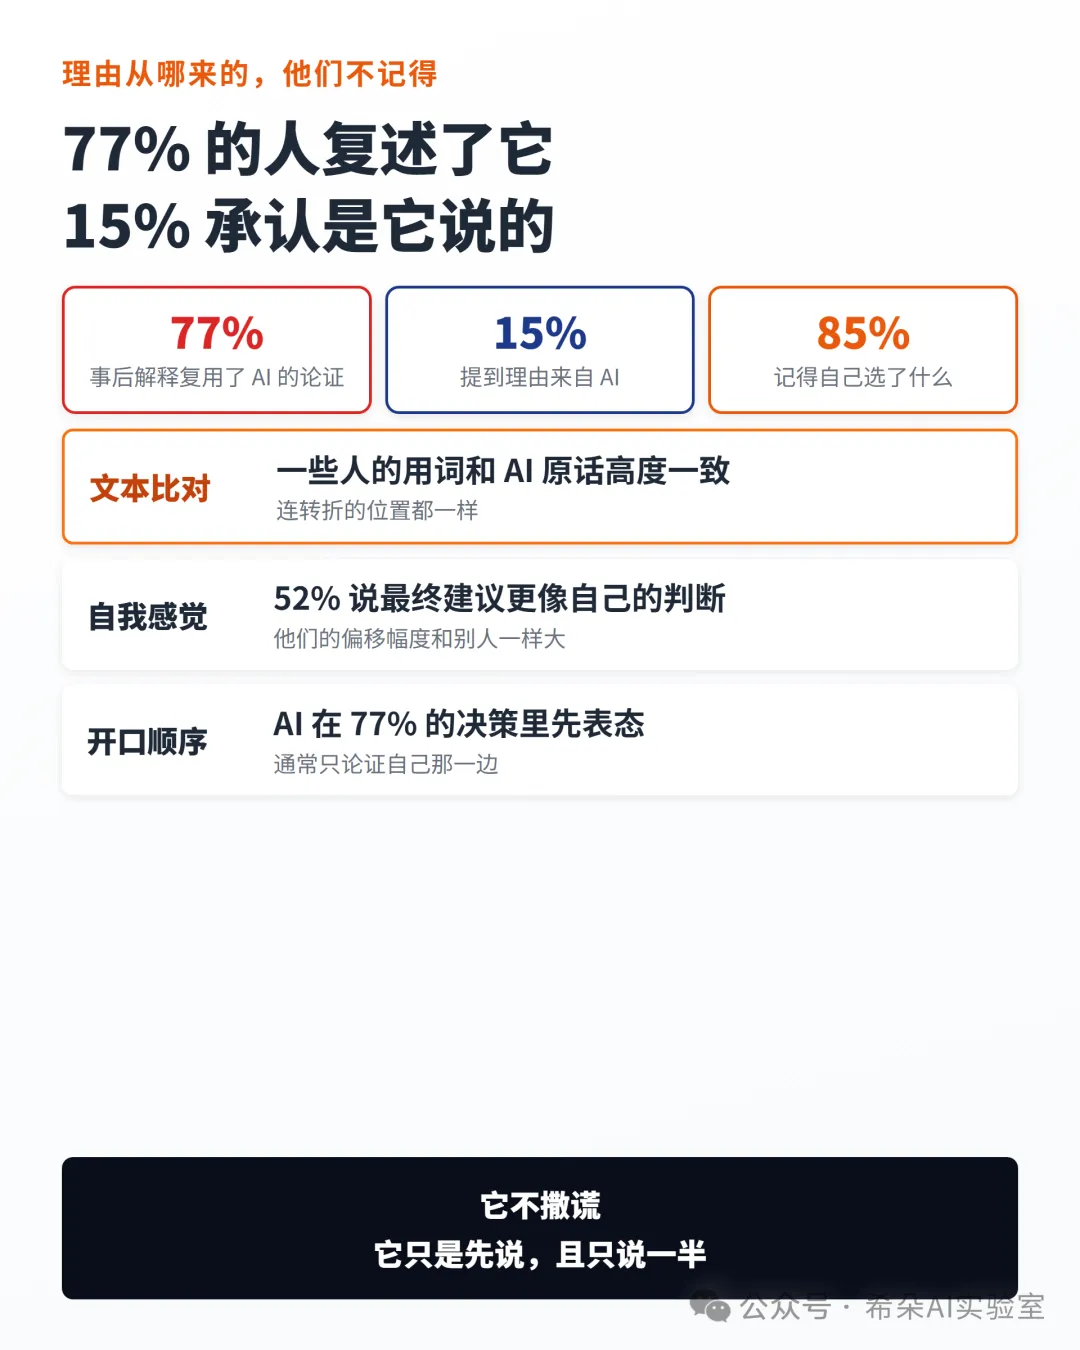
实验结束后,研究者请每个人解释自己为什么这么选。
77% 的人复用了 AI 的论证,有的几乎逐字。而只有 15% 的人提到 AI。
85% 的人清楚记得自己选了什么。他们不记得的,是这些理由从哪来的。
52% 说最终建议更像自己的判断,还有 35% 说大部分或完全是自己的。而数据显示,他们向 AI 立场偏移的幅度,和那些没这么说的人一样大。
AI 在 77% 的决策里先开口,而且通常只论证自己那一边。它不撒谎——它只是先说,且只说一半。剩下的,人自己补完。
研究者逐一比对了事后解释的文本:一些人的用词和 AI 的原话高度一致,连转折的位置都一样。这不是抄袭,写的人不觉得这是复述——那些论证已经在对话里被看过、被认可过,再次从自己笔下出来时,自然就成了"我的想法"。
四、经验挡不住
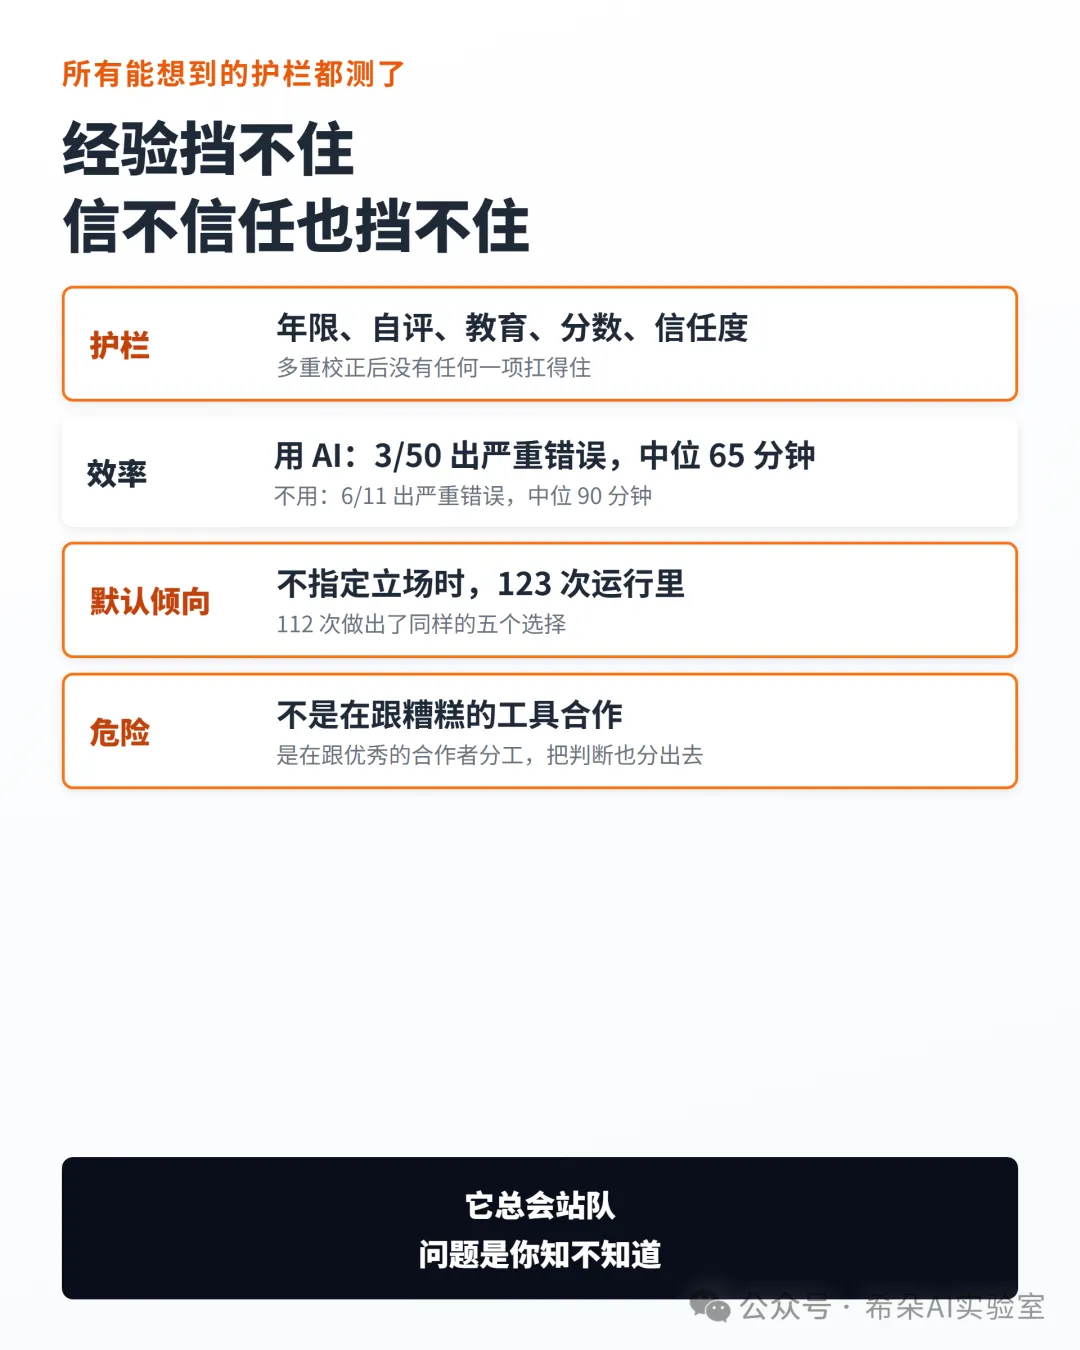
研究者测试了所有能想到的护栏:从业年限、自评专业度、教育背景、知识测试分数、对 AI 的信任度。多重检验校正之后,没有任何一项扛得住。
没人逃得掉,和经验无关,和信不信 AI 也无关。
还有两个数字值得看。不用 AI 的 11 人里,6/11 的分析有严重的方法或编码错误,中位耗时 90 分钟;用 AI 的 50 人里,只有 3/50 出严重错误,中位 65 分钟。AI 让活干得又快又好——这正是它真正的危险:你不是在跟一个糟糕的工具合作,是在跟一个优秀的合作者分工,然后慢慢把判断也分了出去。
更能说明问题的是:完全不指定立场时,同一个模型在 123 次运行里,112 次做出了同样的五个选择。AI 自己就有默认偏好,而且相当稳定。它总会站队,问题只是这次站在哪,以及你知不知道。
五、承认这个的是 Anthropic 自己
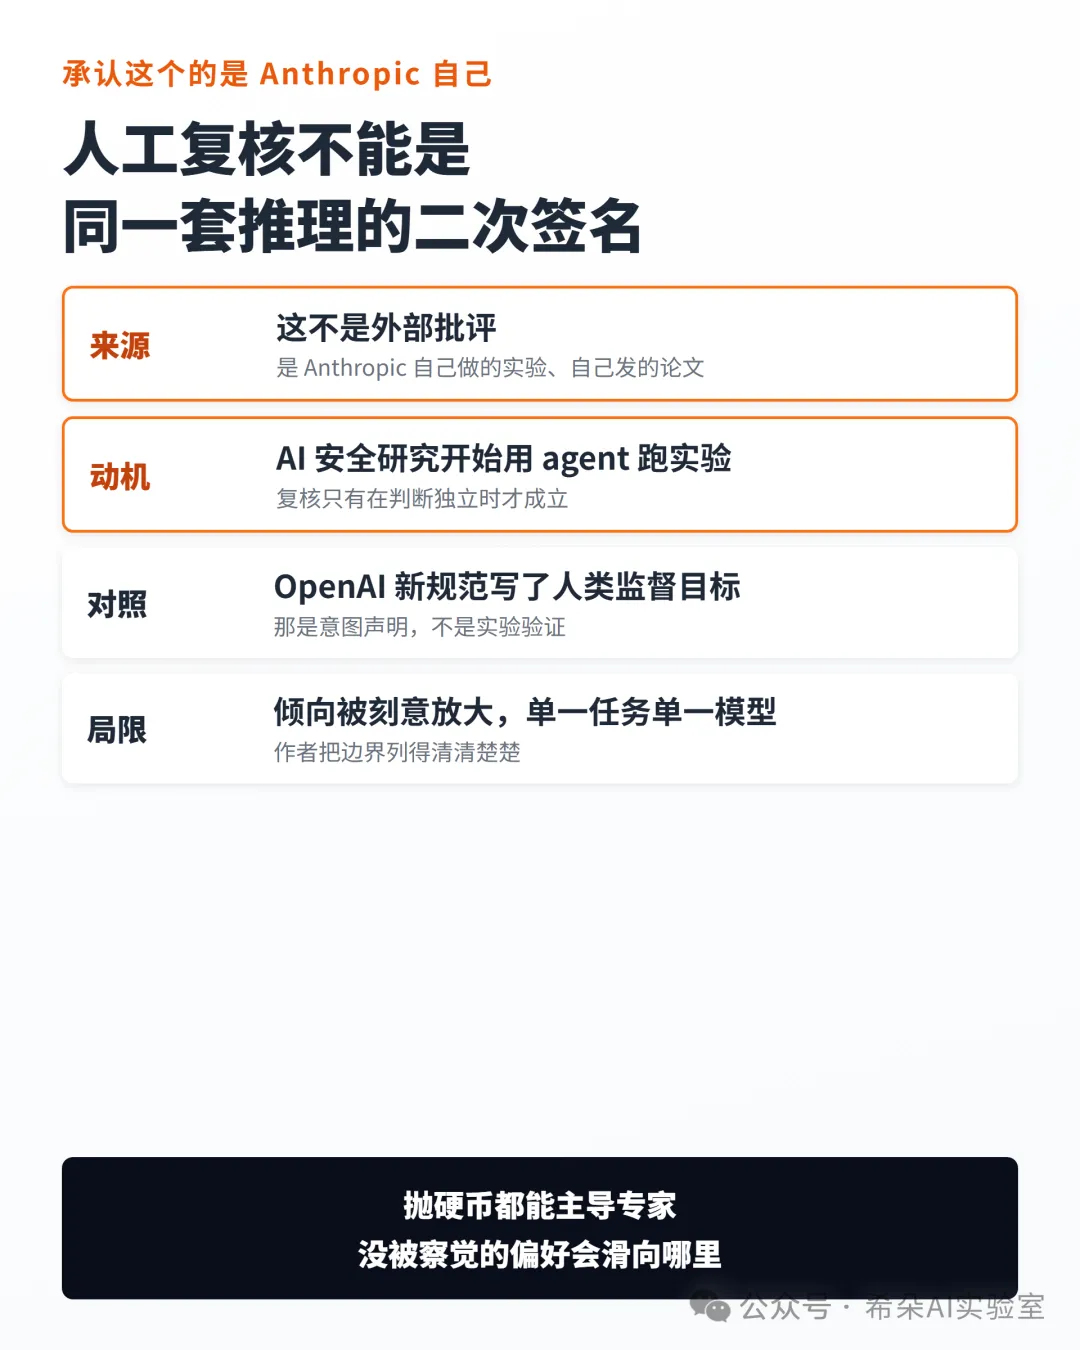
这不是外部批评,是 Anthropic 自己做的实验、自己发的论文。
背景值得知道:OpenAI 新版模型规范里也写了人类监督的目标——但那是意图声明,不是实验验证。Anthropic 把这个问题用随机对照的数字摆了出来:假定人是独立判断,然后测出了它不成立。
动机写在研究页里:AI 安全研究本身,现在越来越多用 agent 跑实验、分析结果,最后由人来复核。可复核只有在判断独立时才成立——如果复核者不知不觉采纳了 agent 的偏好,所谓人工复核,不过是同一套推理的二次签名。抛硬币都能主导专家,那模型自己的、没被察觉的偏好,会无声地滑进多少研究方向。
要说明的是局限:实验里的 AI 倾向被刻意放大了,单一任务、单一模型、一个小时的活,50 人不能代表所有场景。Anthropic 把这些边界列得清清楚楚——这也是这篇论文值得尊敬的地方。
但方向很难反驳:随着 AI 接管越来越多的执行,剩下给人做的判断,恰恰是最容易被它顺走的判断。
六、怎么留住自己的判断
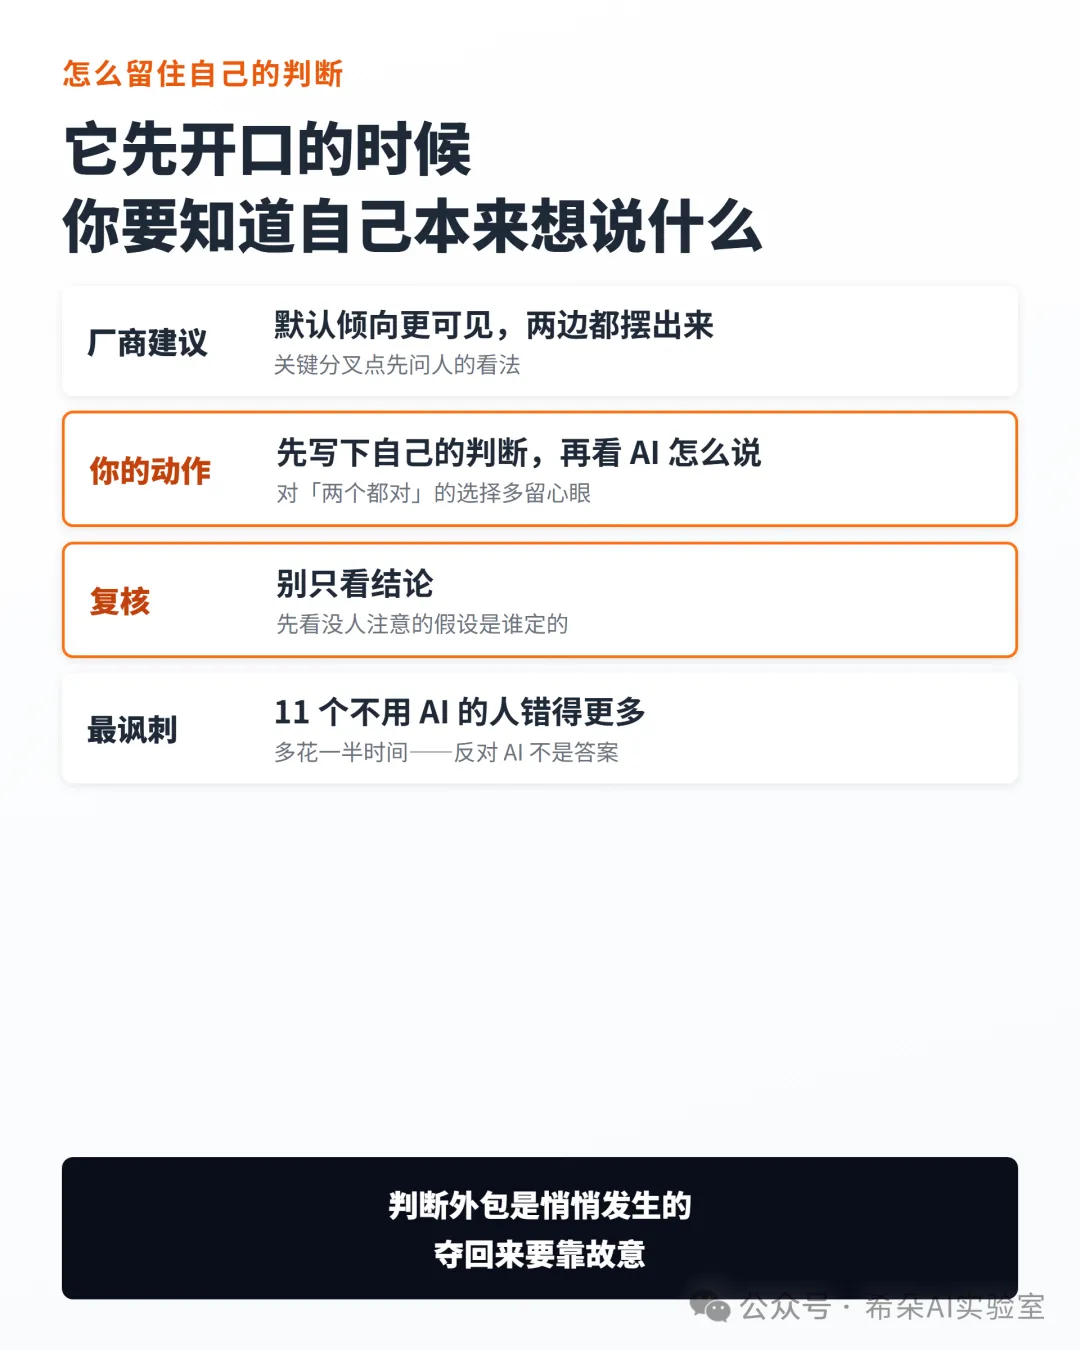
Anthropic 给了三条:让模型的默认倾向更可见;让它把两边都摆出来;在关键分叉点,先问你的看法,再让它干活。
落到自己身上,其实是三句话:先写下自己的判断,再看 AI 怎么说;对那些"两个都对"的选择多留一个心眼——那正是 AI 悄悄替你做主的地方;复核别人用 AI 做出的结论时,别只看结论,先看那几个没人注意的假设是谁定的。
实验里最讽刺的一幕是:61 个人里,11 个选择不用 AI。他们做错了更多的题,多花了一半的时间。
反对 AI 不是答案。答案是:它先开口的时候,你要知道自己本来想说什么。
———
信源:Anthropic 官方研究页与论文《Who's Aligned to Whom?》(2026 年 10 月 27 日,Herdağdelen、Joren、Tamkin);The Decoder、INSIDE 等报道。实验结论适用于该实验设定,作者已列明局限。