ARTICLE · 1076910
《人工智能通识》习题解答(第3章)
1. 以“计算机识别图像”为例,说明它的机器学习的过程。
机器学习的完整过程可分为数据准备、模型构建、训练优化、推理部署四大核心阶段。
第一步:准备数据
首先准备一批带标签的图片,这就是训练数据。比如给机器看一堆苹果和香蕉的照片,每张都提前标记好“这是苹果”或“这是香蕉”。
第二步:构建模型
接着要选一个模型来“消化”这些数据。可以使用卷积神经网络(CNN),它能自动从图片里一层层学出图片的特征。
第三步:训练模型
把训练图片输入模型,得到它的预测结果。使用损失函数(比如交叉熵)算出预测值和真实标签差多少。根据差值,用梯度下降法调整参数,让预测慢慢变准。
第四步:评估与部署
训练完还要用没参加过训练的新图片来测试,看它是不是真的学会了,而不是死记硬背。评估指标常用准确率、混淆矩阵等。
2. 机器学习的核心任务包括哪些?“分类”与“回归”有什么区别?
机器学习的核心任务:让计算机从数据中自动学习规律,并基于这些规律对未知数据做出预测或决策。通俗说,就是“用数据教电脑找规律”,而不是靠人一条条写规则。
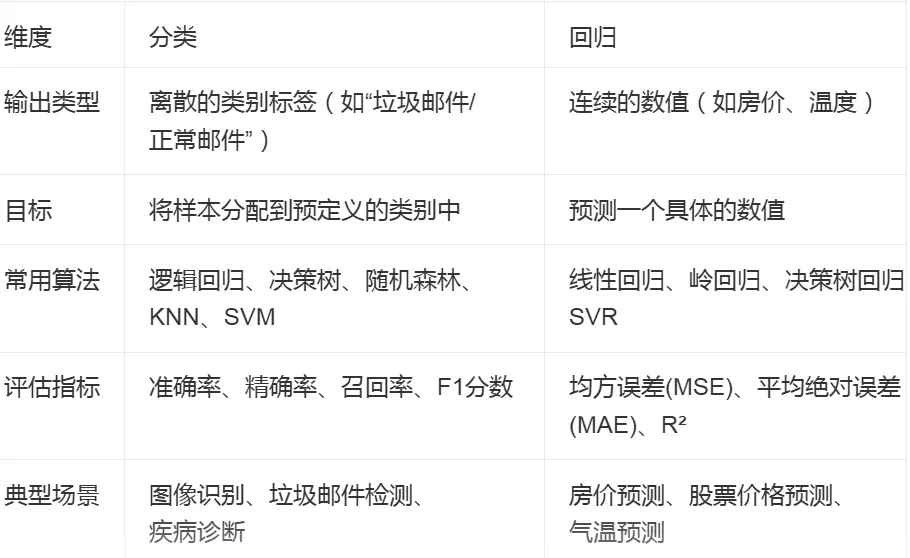
回归和分类都是机器学习里的预测任务,最核心的区别是输出结果不同:回归是计算具体的数值,分类是确定所属的类别。
3. 有监督学习和无监督学习的主要区别是什么?分别列出一种典型的算法及其主要功能。
有监督学习和无监督学习的核心区别在于训练数据有没有标签:有监督学习用“带正确答案”的数据训练模型去预测,无监督学习则从“没有答案”的数据里自己找规律。
有监督学习的典型算法:线性回归,主要功能是预测连续数值,比如根据房屋面积、地段预测房价,它假设特征和目标之间是线性关系。
无监督学习的典型算法:K-means聚类,主要功能是把相似的数据点自动分成K个组,比如把客户按购买行为分成几类人群,以便做差异化营销。
4. 强化学习的核心思想是什么?描述智能体与环境交互的基本流程。
强化学习的核心思想是“试错学习”:智能体没有标准答案,只能通过不断尝试动作、接收环境反馈的奖励或惩罚,逐步调整策略,最终学会在什么状态下做什么动作,才能让长期累积的奖励最大化。
5. 支持向量机(SVM)的核心思想是什么?并举出一个应用SVM的实际例子。
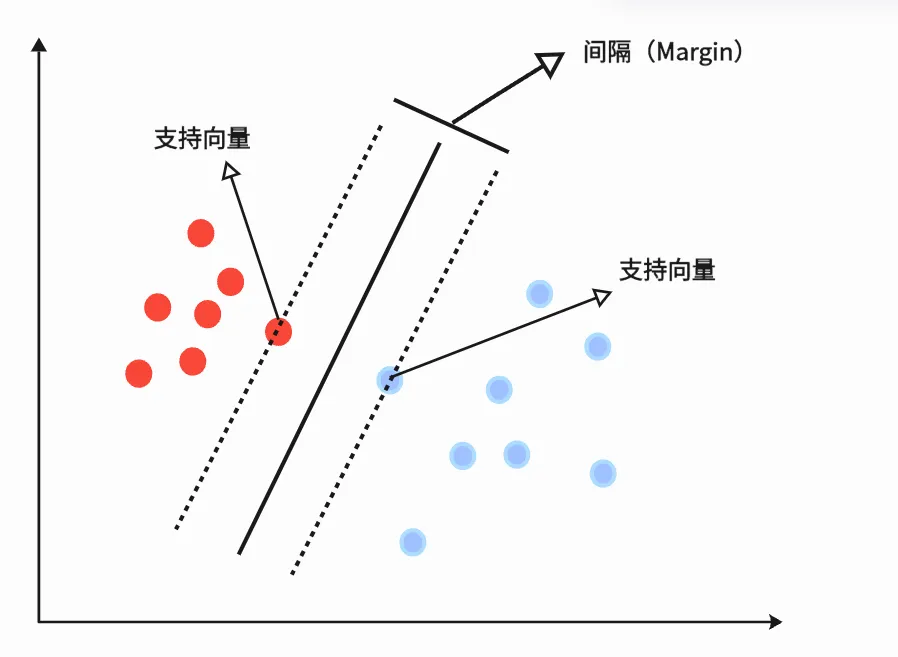
支持向量机(SVM)的核心思想是:找到一个最优分类超平面,让两类样本之间的间隔(Margin)最大化,从而让模型对新数据有更好的泛化能力。
具体来说,可以把每个样本看成特征空间里的一个点,SVM 要画的这条“分界线”(超平面)不仅要能把两类分开,还要离两边最近的样本都尽量远。那些恰好落在间隔边界上、决定这条线位置的样本,就是支持向量。
在建模方式上,回归模型通常直接学习从输入到输出的函数映射,而分类模型更自然地从概率建模的角度出发,学习输入对应各类别的条件概率分布。
6. 根据题目要求,画出相应的决策树。
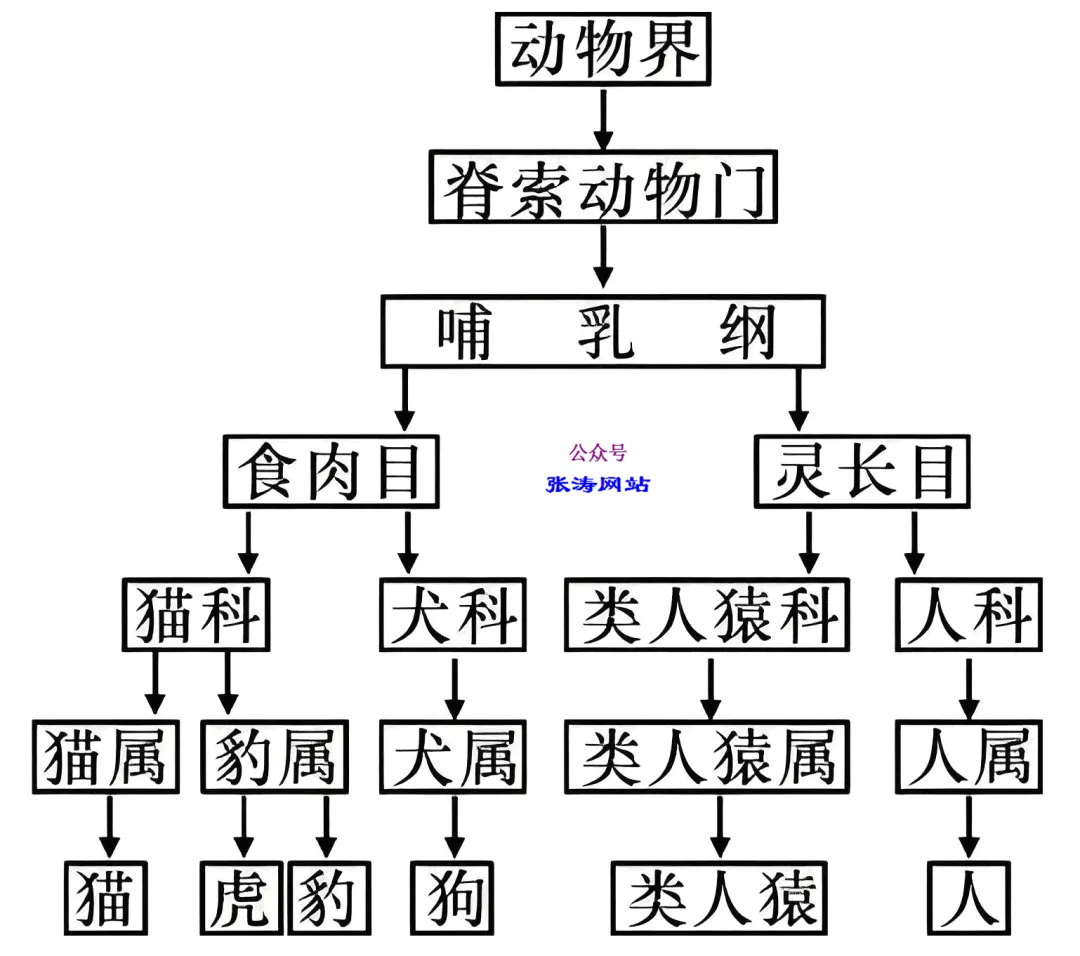
(1)根据动物的特征,画出判断动物所属类别的决策树。
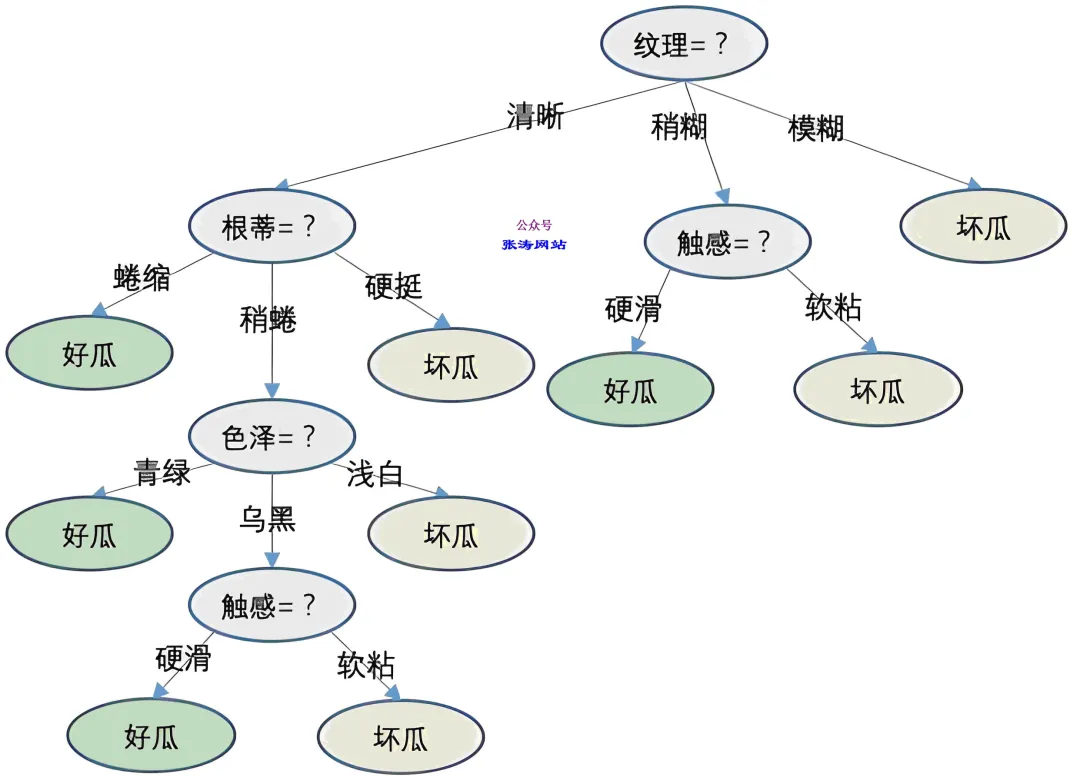
(2)根据西瓜的特征,画出判断西瓜是否成熟的决策树。
欢迎访问本公众号的系列文章!