ARTICLE · 1101264
AI 语料是什么?——用 5 分钟搞懂大模型的"粮食"
AI 语料是什么?——用 5 分钟搞懂大模型的"粮食"开篇:一个容易被忽略的问题 日常语境里,"数据"是个大筐。但在 AI 领域,我们需要区分:
一个学生能考多少分,除了天赋(算法)和学习时间(算力),很大程度上取决于教材质量。教材错漏百出 → 学得一团糟;教材过于单一 → 只会做某一类题;教材难度错配 → 学不动或学不深。大模型同理:语料的质量、广度、难度分布,直接塑造模型的能力边界。 同样有锅有灶(算力),不同厨师(团队)做出完全不同的菜。数据的"配比"就是配方:中文占比多少?代码数据放多少?高质量书籍 vs 低质量网页的比例?数学/推理类数据加不加?这些选择没有标准答案,但每一个都影响最终模型的"口味"。
不准确。大量低质量数据可能:引入错误与偏见;稀释高质量样本的效果;增加清洗与算力成本。近年研究反复验证:精心筛选的中等规模语料,效果可能优于粗糙的海量数据。 法律与合规风险极高。版权、隐私(个人信息)、数据来源合法性,都是硬约束。行业里"能公开访问"≠"能用于训练"。合规是语料工作的第一道门槛。 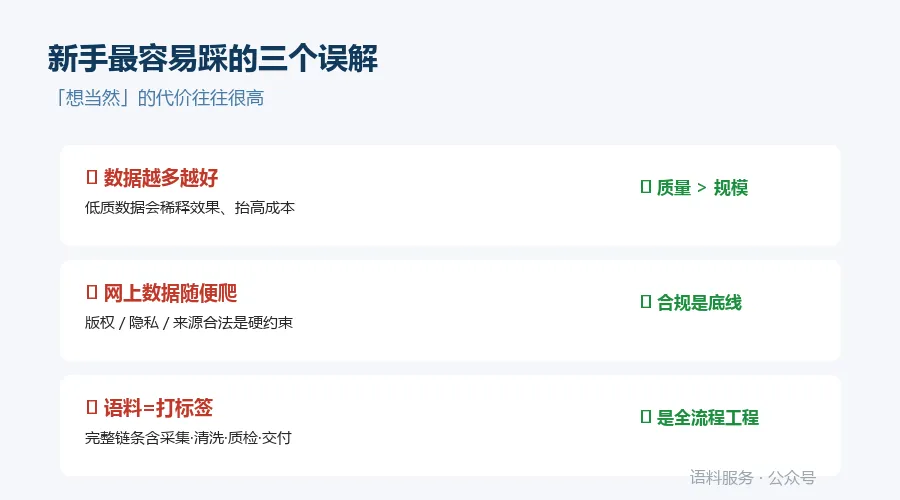
下一篇,我们将用三个真实案例,具体看看"语料如何决定模型能力的上限"——包括为什么同样的模型架构,换个数据集效果会差出一大截。
当我们惊叹于 ChatGPT 能写代码、Claude 能读长文档、国产大模型能答专业问题时,很少人会追问:这些能力,究竟是从哪里来的?答案藏在三个词里:算法、算力、数据。前两者常被热议,而数据——更准确地说,是语料——往往是那个"看不见却决定成败"的环节。本篇用最直白的方式,带你搞懂:什么是 AI 语料,它为什么如此重要。
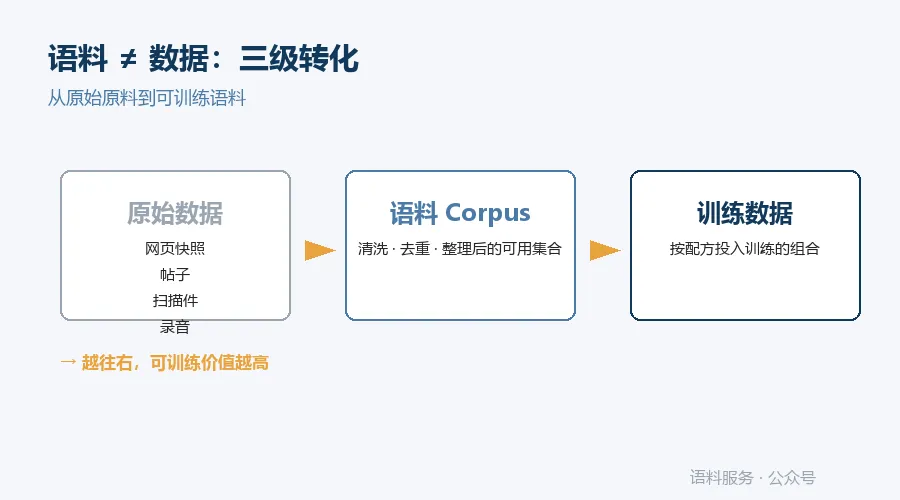
一、语料 ≠ 数据:先分清这两个概念
一句话理解:原始数据是"刚收割的稻谷",语料是"脱壳、筛过、能下锅的米"。所以行业内说"我们做语料",通常意味着:不只是拿到数据,还要让它变得可用、好用。
二、语料决定了什么?三个直观类比
类比 1:语料是"教材"
类比 2:语料是"食谱配方"
类比 3:语料是"地基"
模型架构可以抄,训练框架可以开源,但独家、高质量、成规模的语料,往往是最难复制的资产。这也是为什么各大模型厂商都在"抢数据"——地基不牢,楼越高越危险。
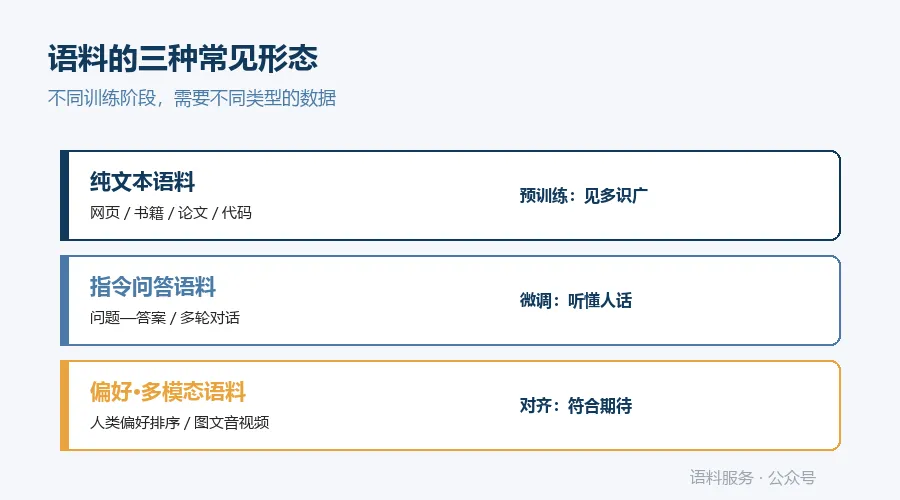
三、语料长什么样?三类常见形态
不同阶段的模型,需要不同类型的语料。所以语料工作不是"一次性采购",而是贯穿模型生命周期的持续工程。
四、三个常见误解(新手最容易踩)
误解 1:"数据当然是越多越好"
误解 2:"网上的数据随便爬就行"
误解 3:"语料就是标注员打标签"
太窄了。完整链条至少包括:采集 → 清洗 → 去重 → 标注 → 质检 → 配比 → 交付。标注只是其中一环,且正在被自动化工具大量替代。
五、为什么现在值得关注语料赛道?
三个信号:
模型能力趋同:算法和算力逐渐拉不开差距,数据成为新的竞争焦点;
合规要求收紧:各国针对 AI 训练数据的政策陆续落地,合规语料变成稀缺资源;
垂直行业爆发:金融、医疗、法律、教育等行业大模型兴起,行业语料需求激增。
换句话说:语料正在从"幕后"走向"台前"。
本期小结
语料 = 可用的、经过加工的训练数据,不等于原始数据;
语料的质量、广度、配比,决定模型的能力边界;
语料工作是一条完整链条,不是简单标注;
合规与质量,比"数据量"更重要;
语料赛道正处在从幕后到台前的关键期。
下期预告
📌 持续更新系列文章:行业动态、重点企业、应用案例、领军人物、开源项目、招投标信息等栏目。 如果你是语料从业者、AI 产品经理,或正在关注这个赛道,欢迎关注我们。