ARTICLE · 1135750
AI大模型产业深度观察:算力的差距、叹息的墙壁
AI大模型产业深度观察:算力的差距、叹息的墙壁宝子们,今天聊点扎心的。 2026年,国内大模型发布会一场接一场,人形机器人在上海WAIC展台跳舞跳得比年会上的你还起劲,智能体号称要接管你的工作...... 热闹是真热闹。但你要是把镜头拉近,拉到产业链的中下游 —— 那些真正在训模型、真正在造机器人的公司 —— 你会发现一个所有人都心照不宣但没人愿意大声说的事实: 他们都在等算力。等得望眼欲穿,等得抓耳挠腮,等得老板亲自飞深圳算力卡工厂蹲货。(拓展阅读:元烺识:半导体与AI——撑起中国未来三十年的国运双轮) 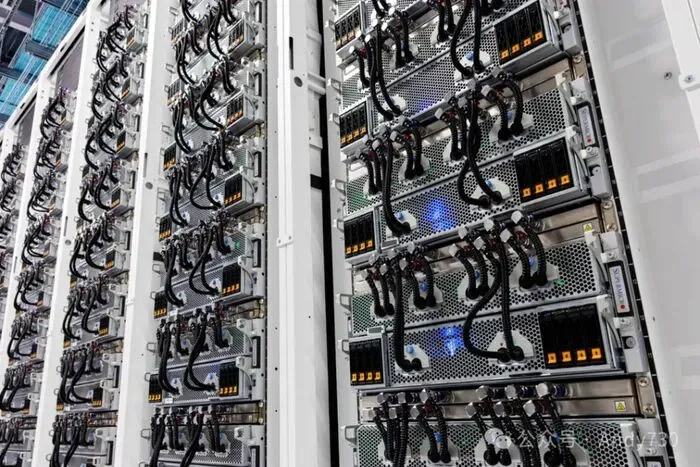
先说大模型训练。GPT-4要训练更新一次小版本,花大概7800万到1亿美元,用了25000张A100算力卡跑了好几个月。Google Gemini Ultra 更狠,花了1.92亿美元。2025 年以后的前沿模型,单次训练成本已经干到 2亿到5亿美金区间。 换算成人民币,训一个万亿参数的基座模型,全成本50亿到180亿。这还只是一次。模型要迭代、要对齐、要做安全评测,每一轮都是一笔亿级账单。 
DeepSeek的梁文锋在内部路演说了个数字,我印象很深:DeepSeek现在手里大概2万张 H 系列等效算力,比美国头部公司落后12到18个月。国产算力卡能用的,只有1.6万张。 1.6万张是什么概念?Meta在印第安纳州建了一个数据中心,规划30万到 50万张GPU,单项目投资 100 亿美金。OpenAI跟 AWS合作,2026 年底前要部署数万张专属集群。 人家一个项目的量,就是我们头部公司全部家当的十几倍。这已经不是差距,而是运动健将和小学生比田径。 大模型训练的算力需求是 "脉冲式" 的 ——训练的时候猛用,训完就喘口气。但具身智能不一样,它是持续性的、永不关机的算力消耗。 公式很简单:机器人数量×每天运行小时数。一个仓库3000台自主机器人,每天跑20小时,GPU 负载是固定的。没有深夜低谷,没有节假日回落。GPU就是在那里,不停地跑。 中国移动搞了个 "灵犀数霄" 具身智能训练场,他们算了笔账:机器人在某个领域达到专业水平,需要10万小时数据训练;要迈向通用人工智能,数据需求是10亿小时。 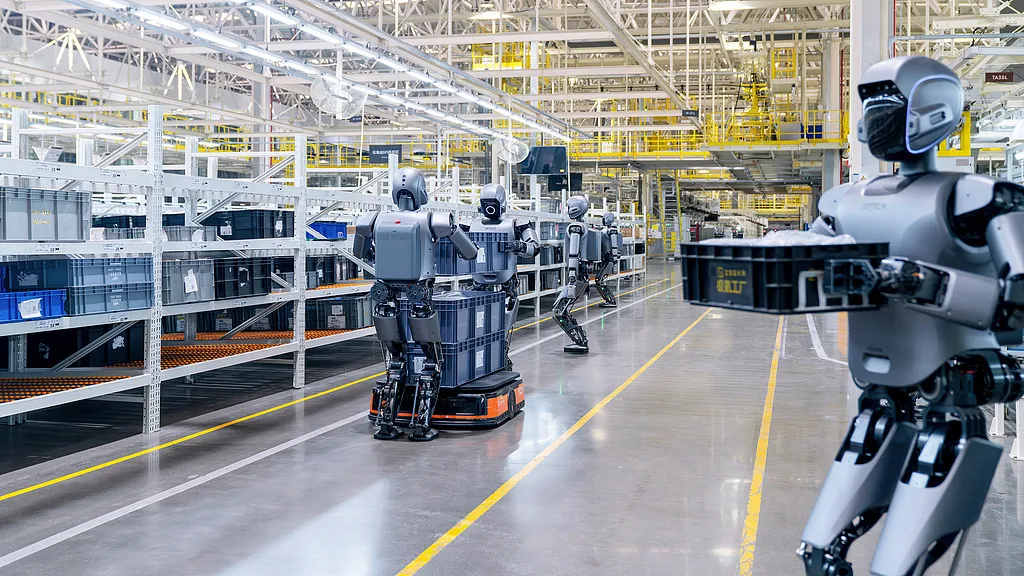
原力灵机的唐文斌说了句大实话:"好好做模型的公司,不超过 10 家。" 判断标准很简单 —— 看你在算力上花了多少钱。15万小时数据训练,小几千卡,投入小几个亿。"算力上没花过亿的,大概率没在真正训模型。" 乐享科技的李元庆更直接,量产爬坡期第一道坎就是算力:"RTX6000国内拿不到,5090、4090的平替还在测试,国产卡逐步可用但迁移有成本。能用的卡价格极贵,这就是现实。" 现实就是,机器人还没开始大规模赚钱,算力账单已经先把创业公司的现金流干穿了。 有人说,不是有华为昇腾吗?不是有海光、寒武纪吗? 有,确实有。但我们得说实话。 国产目前最强的昇腾910C,实测性能大概是英伟达H100的六成。但是请注意,H100是2022年的产品。现在英伟达已经出到B200 了。也就是说,我们最强的卡,大约相当于人家四年前旗舰的60%。 更要命的不是单卡算力,是显存和互联。昇腾910B显存 64GB、带宽 1.6TB/s,H200是141GB、4.8TB/s,差两倍。训大模型的都知道,HBM 不够,参数装不下;带宽不够,梯度传不动。 这俩一卡脖子,集群效率直接腰斩。 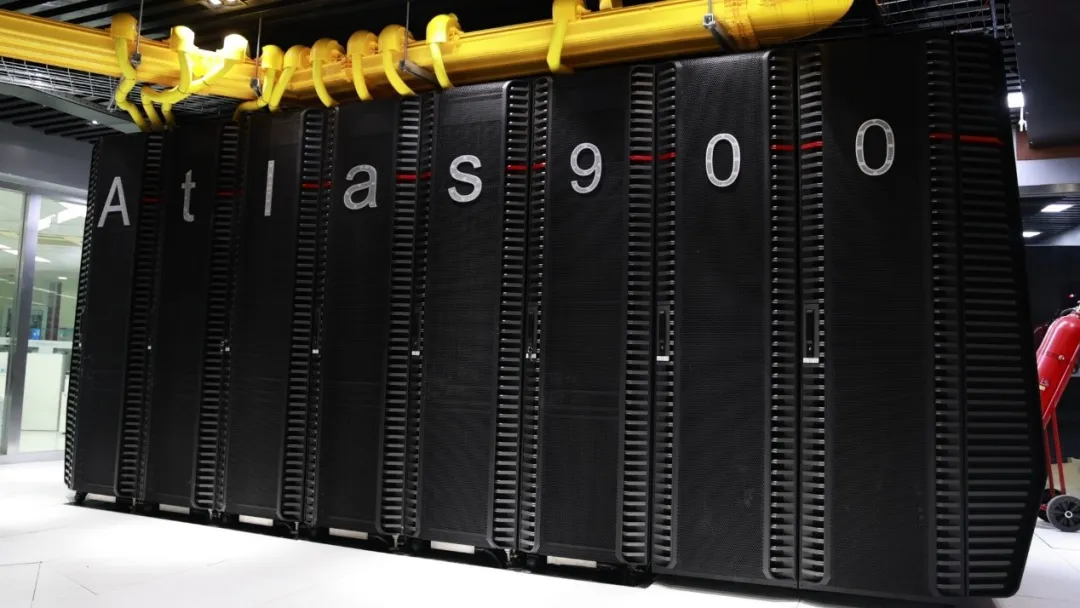
华为2026年发布的Atlas 950超节点,支持8192张昇腾卡,FP8总算力8 EFLOPS,这是里程碑。DeepSeek计划在内蒙古部署16万颗昇腾 950DT,要搞全球最大的华为AI芯片集群,首次用国产算力做前沿模型预训练。这是好事,大好事。 但出货量的天花板在那摆着。 2025年昇腾出货81.2万张,2026 年预期 130 多万张。阿里平头哥 2026年预期40万张。海光、寒武纪万级到十万级。 全加起来,2026年国产高端AI芯片出货大概200到250万张。 听起来不少?但我们这200多万张里,相当比例是中低端推理卡。 真正能撑大模型预训练的高端国产卡,有效供给比纸面数字少得多。 第一个数字:2800 EFLOPS。当前中国智能算力总需求 4423 EFLOPS,有效供给只有1590EFLOPS,缺口超过 2800个单位。相当于要再建 1.8 个全国的智能算力总规模,才能满足现在的需求。 第二个数字:不到1万张 H100等效。DeepSeek1.6 万张昇腾910C,按 60% 性能换算,等效不到1万张 H100。而一次 GPT-4 级别的完整训练需要2.5万张A100跑数月。我们头部公司的全部国产算力家当,连一次 GPT-4 级别的完整训练都撑不下来。 第三个数字:30%。全国智算中心GPU平均利用率只有 30%。2025年国内智算可提供38亿卡时,实际只用了14亿,用算占比36.8%。每投100块钱建算力,70块钱在空转。 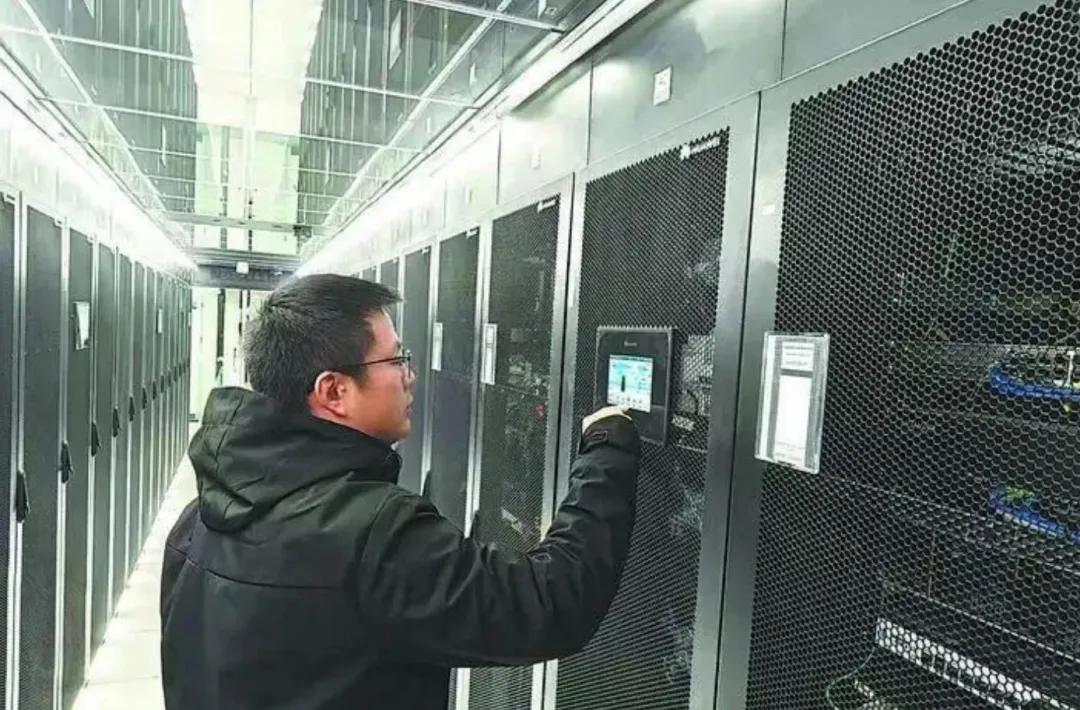
你说“哎?这不对啊,一边说缺算力,一边说70%在空转?” 不矛盾。这叫结构性错配。空转的是 "不对的算力"—— 中低端推理卡、西部没人用的机柜、国产卡生态没适配好上架了跑不起来的集群。 某西部智算园区,新建十万卡国产机房,上架率不到20%。而真正需要的高端训练算力,依然一卡难求。 低端过剩,高端短缺;西部吃不饱,东部不够用;有卡的用不起来,要用的拿不到卡。这就是中国算力市场的 "冰火两重天"。 这里必须说一个很多人没意识到的结构性问题。 中国电信、中国移动,还有各地国资控股的 AIDC 中心,它们有机房、有电力、有网络、有地、有钱,是算力基建的天然主力军。 但是 —— 它们拿不到受美国出口管制的高端算力卡。 美国商务部对高端算力卡进行严格的出口管制,对算力卡去向进行穿透审查。一旦被认定为受管制实体的关联方,芯片采购直接断,还可能触发更广泛的制裁。所以这些国资主体,哪怕手里攥着百亿预算,也不拿不到国际主流算力卡。 这不是钱的问题,这是算力被人卡了脖子。 写到这,心情是复杂的。 一方面确实憋屈。人家一个Meta的数据中心就是50万张卡,我们头部公司全部家当1.6万张国产卡,还得精打细算着用。昇腾910C追H100追了半天,人家已经B200了。CUDA生态十几年的积累,不是喊几句 "自主可控" 就能替代的。 但另一方面,我也看到了一些让人心里踏实的东西。DeepSeek敢用 16 万颗昇腾做前沿模型预训练,这是拿真金白银给国产生态投信任票。华为 Atlas 950超节点做到8192卡互联,这是硬实力。国产芯片出货量每年在翻倍,软件栈在一个个大模型公司的真实业务负载里打磨成熟。 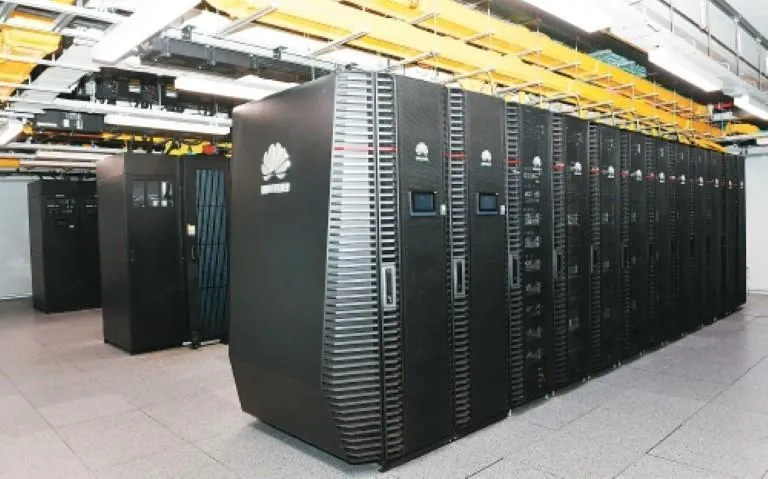
“钢少气多”,并不是在朝鲜战场上才有的情景。 虽然算力的囚徒困境不会一夜消失,HBM 的产能、先进制程的突破、CUDA 生态的替代,每一项都是硬骨头,都需要时间,都需要代价。 但我始终相信一件事:对一个拥有完整工业体系、14多亿人市场、和 "宁可自己吃苦也要把饭碗端在自己手里" 的民族来说,被卡脖子的地方,往往就是下一个爆发的起点。 当年盾构机被卡脖子,现在中国盾构机占全球三分之二市场。当年高铁被卡脖子,现在中国高铁里程世界第一。当年大飞机被卡脖子,C919 已经在天上飞了。 算力这关,迟早也能过去。区别只在于,需要多久,代价多大。 而在那一天到来之前,每一个在等卡的工程师、每一个在算力账单前皱眉的创业者、每一个在国产集群上调试模型的技术员 —— 他们都是这场突围战里,真正的战士。他们在用新时代的“小米加步枪”,试图挑战新时代的“飞机加大炮”。 ———————————————— 作者简介:一位85后硬核博主,INTJ。“有中国式社会主义特色的价值投资理论”的倡导者。前私募、券商高管,曾作为成员参与MIT(麻省理工学院)某实验室“人工智能产品与服务设计”项目研究。中、美、英、澳等多国注册会计师/会计师资格持有者。财会金融+AI量化+医药机械+军工知识全能点满,陪你一起硬核成长、悄悄变强。
一、算力这东西,缺起来要人命
二、具身智能:算力消耗的新范式,更狠
三、国产算力卡:能用,但......
四、算力缺口到底多大?
五、最憋屈的一件事:算力卡脖子
六、“钢少气多”