ARTICLE · 1209098
Excel手敲20分钟 vs 10秒跑完:测试人的数据提效,只差一个Faker
亲爱的小伙伴们,由于微信公众号改版,打乱了发布时间,为了保证大家可以及时收到文章的推送,可以点击上方蓝字关注测试工程师成长之路,并设为星标就可以第一时间收到推送哦!
感谢您抽出

.

.

阅读本文
PART 01 — 每个测试人都干过的傻活
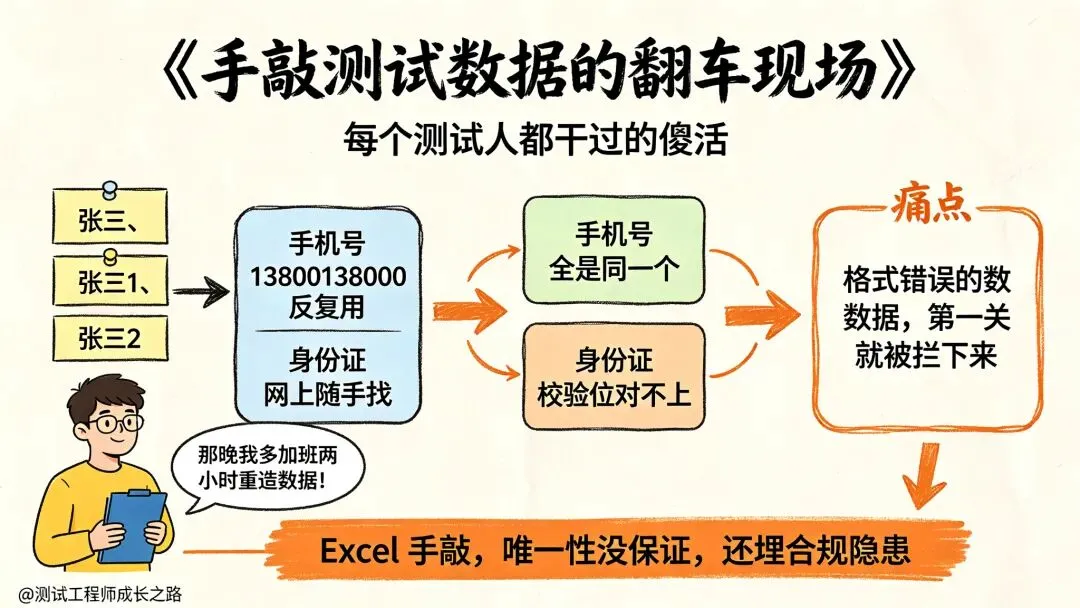
先问一个扎心的问题:你上一次在测试环境造测试数据,是什么时候?
我印象很深。记得之前有一次准备一轮新用户注册的回归,需要 200 组"看起来正常"的用户数据:姓名、手机号、身份证、地址。我的操作是——Excel 拖拽填充,姓名列"张三、张三1、张三2",手机号从头到尾 13800138000 循环,身份证网上随手找了一批。
结果在测试过程中开发回我一句:"你这手机号全是同一个,唯一性校验怎么测?身份证连校验位都对不上,实名认证模块直接给抛异常了。"
那天晚上我多加班两小时重造数据。第二天痛定思痛,把压箱底的 Python 库翻出来系统用了一遍——就是 Faker,一个专治"测试数据不会造"的开源库。
PART 02 — Faker 是个什么库
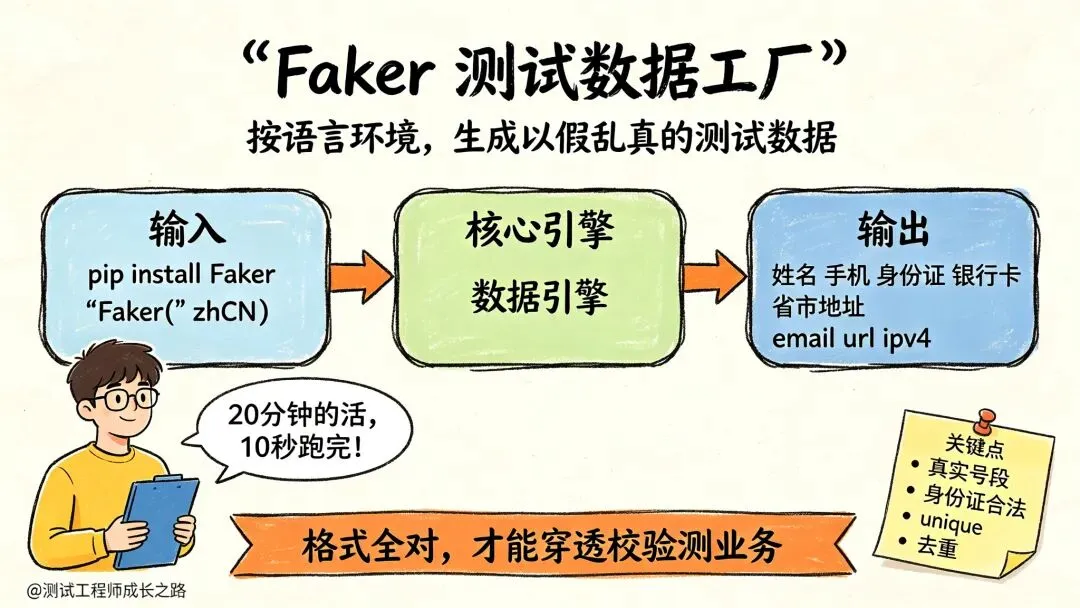
Faker 是 Python 圈的假数据生成标准库:19,400+ star、每周下载量 1,600 万次级别,2026 年 9 月底还在发版维护,从 2012 年首次发布一路迭代到现在,非常稳。
一句话说它干什么:按"语言环境"生成以假乱真的测试数据——Faker("zh_CN") 生成的就是中文姓名、真实号段手机号、校验位合法的身份证,而不是 asdfsadf 这种一眼假的东西。
为什么"以假乱真"对测试重要?因为格式错误的数据会在业务层第一道关口就被拦下来,你根本测不到后面的逻辑。格式全对的数据才能穿透校验,去测真正的业务分支。这是 Faker 和"随便编个字符串"的本质区别,下面用实验数据说话。
PART 03 — 五分钟上手:四要素一键生成
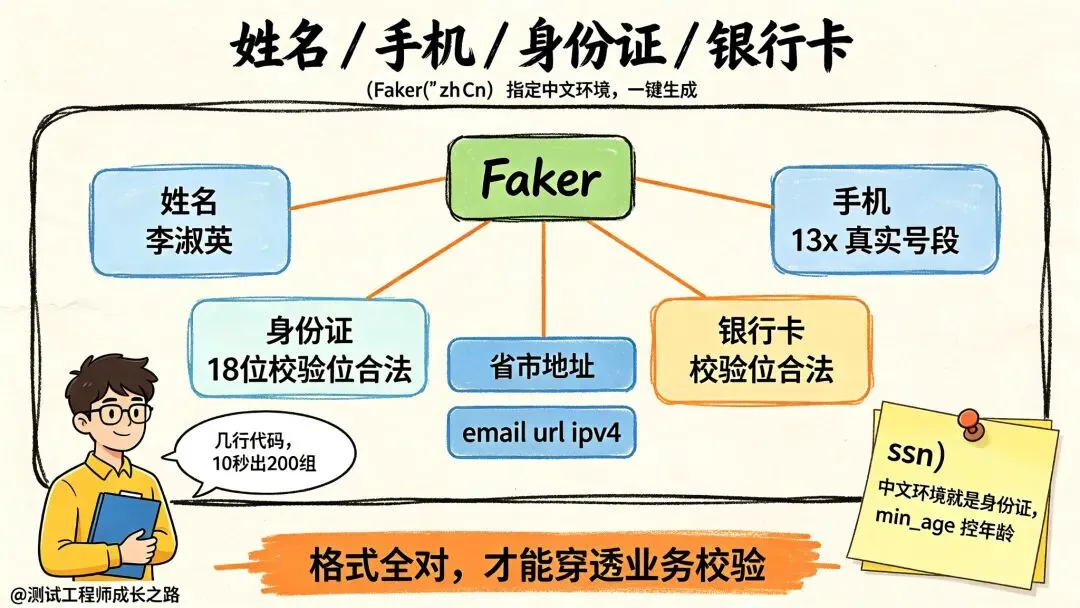
安装就是一行:
# 要求 Python 3.10 及以上pip install Faker 然后是每个测试人最常用的"四要素"(姓名、手机、身份证、银行卡),脚本如下:
from faker import Fakerfake = Faker("zh_CN") # 中文环境,关键参数print(fake.name()) # 姚军print(fake.phone_number()) # 13213209468print(fake.ssn(min_age=18, max_age=60)) # 320113197308253674print(fake.company()) # 明腾信息有限公司print(fake.job()) # 设备主管print(fake.credit_card_number())# 5232755350642375代码就这么多。Faker("zh_CN") 指定中文环境后,所有生成器自动切到中文语料——姓名是"姚军""李淑英"这种真名感的组合,手机号落在 13x-19x 真实号段,身份证是 18 位标准格式。ssn() 这个方法名容易迷惑人,在中文环境里它生成的就是身份证号,还能用 min_age/max_age 控制出生年龄段——测"未成年人不可购买"这类需求时特别顺手。
对比一下手工流程:同样的 200 组数据,Excel 手敲 20 分钟起步,现在几行代码 10 秒跑完,还自带唯一性。顺手再记一组接口测试常用的数据:
print(fake.email()) # testerroad@example.orgprint(fake.user_name()) # TesterRoadprint(fake.url()) # https://www.testerroad.cn/print(fake.ipv4(private=True)) # 172.27.182.37(私网地址)print(fake.uuid4()) # 44e1a00c-fe30-49e7-bb26-052eaf6cd076注册、登录、幂等性、网络配置类用例的数据源一次配齐。ipv4(private=True) 这个参数值得记住——测试环境里公网 IP 会触发外部调用,私网段的 IP 才是安全的选择。
四要素之外,地址是注册、收货类用例的另一大高频字段:
print(fake.address()) # 吉林省澳门县永川合肥街z座 952344print(fake.province()) # 新疆维吾尔自治区print(fake.city()) # 太原市print(fake.district()) # 西峰print(fake.postcode()) # 628965看到"吉林省澳门县"了吗?省、市、区各自随机,拼出来的地址格式对但地理上不存在。这是特性不是 bug:表单校验、必填、长度限制这类场景要的就是"长得像地址";但如果你的业务有省市区三级联动校验(AddressPicker 类组件),这种数据会直接失败。先给结论:地址格式测试交给 Faker,行政区划联动的逻辑测试得换成真实区划数据,别硬凑——这个"分工原则"后面还会展开。
PART 04 — 进阶四招+一个外挂:校验、复现、去重、时间窗
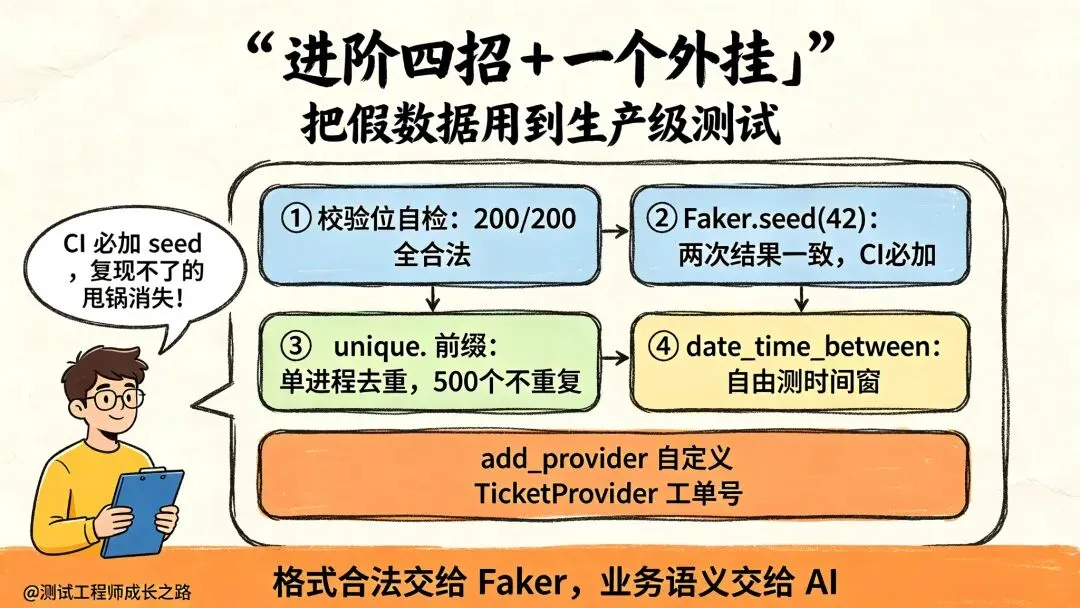
基础用法谁都会,真正的分水岭在下面四招。
第一招:生成的身份证到底合不合法?自己校验一遍。
我写了个校验位验证脚本(GB 11643-1999 标准,加权求和对 11 取模),对着 Faker 生成的身份证跑了一遍:
W = [7,9,10,5,8,4,2,1,6,3,7,9,10,5,8,4,2]CODE = "10X98765432"defcheck_id(idc): s = sum(int(idc[i]) * W[i] for i inrange(17))return CODE[s % 11] == idc[17].upper()results = [check_id(fake.ssn()) for _ inrange(200)]print(f"{sum(results)}/200") # 200/200,全部合法200 张全部通过校验位验证。 这个结论对我很重要:连最严的实名认证接口都骗得过,格式问题基本绝迹。反过来想,你手敲或网上找的那批身份证,有几个敢打包票?(这也是为什么"网上找的身份证"还有隐私合规风险——那些可能对应真人,而 Faker 生成的是随机号码,几乎不可能对应任何真实个人。)
第二招:seed 固定,失败可复现。
随机数据有个天然问题:今天跑失败、明天跑过了,你怎么知道是 bug 修好了还是数据换了?答案是固定随机种子:
Faker.seed(42)a = [fake.name() for _ inrange(3)]Faker.seed(42)b = [fake.name() for _ inrange(3)]print(a == b) # Trueprint(a) # ['王丹', '刘旭', '宋超'],两次完全一致CI 里必加这一行。报错时把 seed 值贴进 bug 单,开发本地跑出一模一样的数据,"我这里复现不了"这句经典甩锅直接消失。
第三招:批量去重,一行前缀。
测唯一性校验(手机号注册、昵称占用)时,加个 unique. 前缀就行:
phones = [fake.unique.phone_number() for _ inrange(500)]print(len(set(phones))) # 500,无一重复我实测 500 个手机号去重后还是 500。注意两点:unique 是在单个生成器实例内保证的,跨进程不保证,数据库唯一约束该建还得建;另外唯一池耗尽时会抛 RetryLimitExceeded 异常,大批量造数记得 try/except 或分批生成。
第四招:日期时间,测"时间窗"必备。
会员7天有效期、订单近30天可退、18-60岁可注册——这类时间窗需求的数据,三个方法全覆盖:
print(fake.date_time_between(start_date='-30d', end_date='now'))# 2026-10-06 14:21:54.540887(近30天随机时刻)print(fake.date_of_birth(minimum_age=18, maximum_age=60))# 1997-06-22(18-60岁随机出生日期)print(fake.date_between(start_date='today', end_date='+7d'))# 2026-10-14(未来7天随机一天)输出直接是 datetime/date 对象,进断言不用再解析字符串,比手写 datetime.now() - timedelta(days=random.randint(0,30)) 干净得多。
一个外挂:自定义 Provider,业务数据也归它管。
公司内部的数据格式 Faker 肯定不认识——工单号、会员编码、业务流水号这种。用 add_provider 自己封装,几行搞定:
from datetime import datetimefrom faker.providers import BaseProviderclassTicketProvider(BaseProvider):"""业务自有格式:前缀+开单年月+随机段"""defticket_no(self): prefix = self.random_element(['TK', 'BG', 'SR'])returnf"{prefix}{datetime.now().strftime('%Y%m')}{self.random_int(10000, 99999)}"fake.add_provider(TicketProvider)print(fake.ticket_no()) # SR20261098063封装完之后 fake.ticket_no() 用起来跟原生方法一模一样。这里有个细节值得说:年月我用的是 datetime.now()(开单当月),而不是 Faker 的 date_time_this_year()——后者返回的是当年随机时刻,拼出来会是随机月份,业务系统里工单号的年月段通常代表真实开单时间,这里别用随机值糊弄。更值钱的是团队协作层面:项目里所有数据构造函数都收敛到 provider 里,新人接手时扫一眼 provider 列表,就知道这个项目要造哪几类数据——比翻三个月的 Excel 模板强多了。
PART 05 — 接入 pytest:中文环境的一个隐藏坑
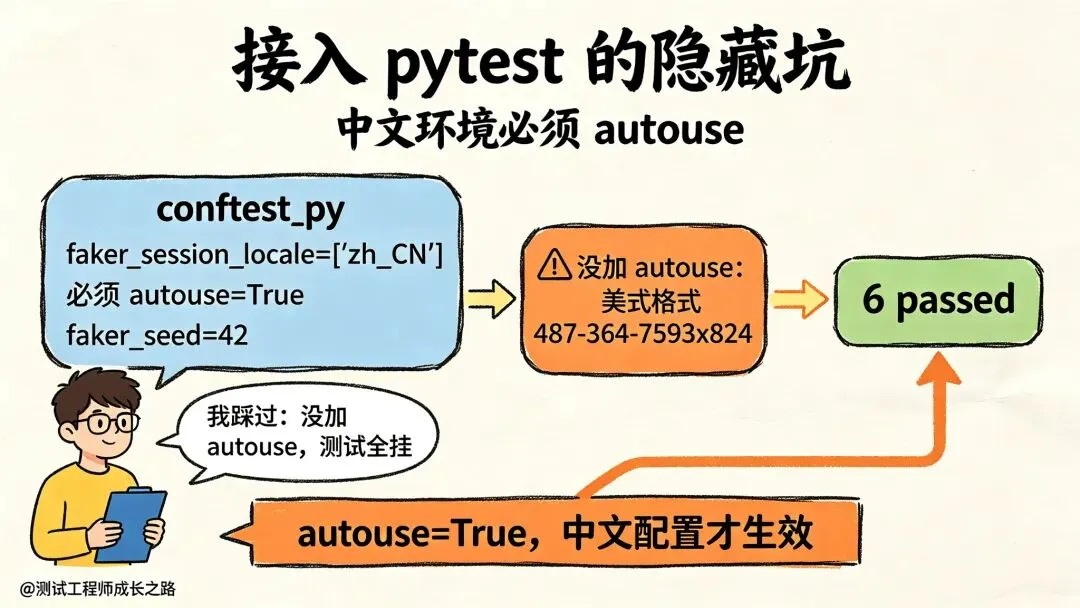
Faker 自带 pytest 插件,装完就有一个内置的 faker fixture。但直接用会踩一个坑,我自己踩的,给大家排雷。
我在conftest.py里按记忆写了中文配置,结果测试全挂,报错一看:生成的是 487-364-7593x824 这种美式格式,还带 x824 分机。中文配置根本没生效。翻官方文档才发现,faker_session_locale 这个 fixture 必须加 autouse=True,否则 pytest 内置的 faker fixture 不吃你这套配置。正确姿势:
# conftest.pyimport pytest@pytest.fixture(scope='session', autouse=True) # autouse 是关键deffaker_session_locale():return ['zh_CN']@pytest.fixture(scope='session', autouse=True) # 两个 fixture 都要 autousedeffaker_seed():return42# 顺手把 CI 复现也配上配好之后,测试函数里直接注入 faker 参数就是中文环境了。再配合 pytest 参数化把金额边界一起吃掉,这是我实际跑通的用例(6 passed):
import pytestfrom faker import Fakerfake = Faker("zh_CN")LIMIT = 9999.99# 示例规则:0~9999.99 允许提交,满 1 万拒绝def can_submit(amount: float) -> bool:"""被测规则:金额落在 [0, LIMIT] 才允许提交"""return0 <= amount <= LIMIT# 金额边界用参数化铺进去,期望值一并带上@pytest.mark.parametrize("amount,expected", [ (0, True), (0.01, True), (9999.99, True), (10000.00, False),], ids=lambda v: f"amount={v[0]}")def test_order_amount_boundary(amount, expected):assert can_submit(amount) is expecteddef test_unique_users(faker): # 内置 fixture,已是中文 names = [faker.unique.name() for _ inrange(20)]assert len(set(names)) == 20def test_register(faker): user = {"name": faker.name(), "phone": faker.phone_number()}assert len(user["phone"]) == 11and user["phone"].startswith("1")test_order_amount_boundary[amount=0] PASSEDtest_order_amount_boundary[amount=0.01] PASSEDtest_order_amount_boundary[amount=9999.99] PASSEDtest_order_amount_boundary[amount=10000.0] PASSEDtest_unique_users PASSEDtest_register PASSED6 passed金额四边界走参数化、身份类数据走 faker fixture,这套结构可以直接搬进你的项目。生成脚本的活,从此从"人肉 Excel"变成"跑测试顺手就造了"。
PART 06 — 一个对照实验:为什么别让 AI"随便编点数据"
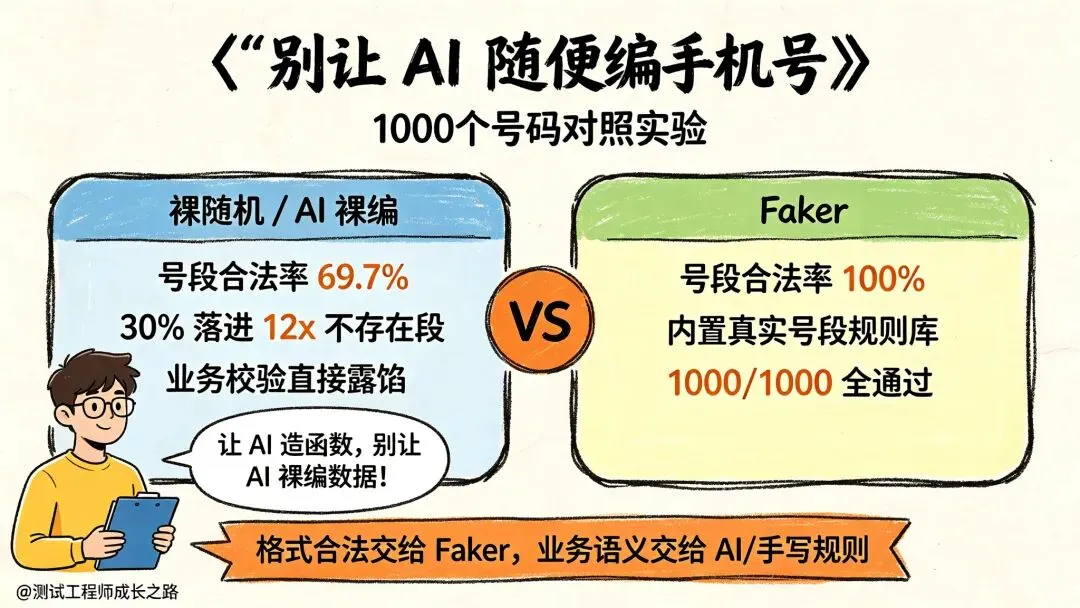
现在很多人造数据直接甩给 AI:"帮我生成 100 个手机号"。我做了个对照实验,量化一下这事的风险:
import randomfrom faker import Fakerrandom.seed(7)fake = Faker("zh_CN")def random_phone(): # 新手和 AI 最常生成的:11位随机数字return"1" + "".join(random.choice("0123456789") for _ inrange(10))VALID = ("13","14","15","16","17","18","19")rand_ok = sum(1for _ inrange(1000) if random_phone()[:2] in VALID)fk_ok = sum(1for _ inrange(1000) if fake.phone_number()[:2] in VALID)# 裸随机 11 位:号段合法 697/1000# Faker 生成: 号段合法 1000/1000裸随机手机号只有 69.7% 落在真实号段,剩下 30% 进了 12x 这种不存在的段——业务一调运营商校验就露馅。Faker 是 100%,因为它内置了号段规则库。
这不是说 AI 不能用。AI 编数据有两个 Faker 替代不了的场景:语义关联数据("姓名跟性别匹配、地址跟邮编匹配"这种跨字段一致性,Faker 也做不了完全对应,但 AI 理解业务上下文更强)和特定业务规则的数据("VIP 等级和消费金额符合分布")。但让 AI 裸编手机号、身份证,就是扬短避长。
我的分工原则:格式合法性交给 Faker,业务语义交给 AI 或手写规则。落到执行清单上就三行:格式类字段(姓名/手机/身份证/银行卡)→ Faker 一把梭;业务规则类(等级和金额的分布、跨字段一致性)→ 手写生成函数或让 AI 辅助写;两者组合时,Faker 出"格式合法的壳",往壳里塞业务逻辑的是你自己。这里补一条 Faker 的边界提醒:它的输出只适合做"测试布局和填充示例数据",永远不能作为业务规则正确性的证明。数据造得再真,断言写得不对,测试照样白跑。工具解决的是"数据从哪来",不管"测得对不对"。
顺着说下 AI 的正确打开方式:让 AI 造机器,别让 AI 造数据。 同样是"要 100 条符合二八分布的 VIP 用户数据",直接让 AI 在对话里吐数据,吐完这批就没了,下次再要格式还飘;而让 AI 写一个"生成函数"——函数体里调 Faker 和随机分布,落成项目里的 provider 或工具脚本——一次写好,永久复用,还能进 CI。AI 的价值在生成"造数据的代码",数据本身永远由代码现场产出。
还有一个工程细节:Faker 官方明确说数据集在 patch 版本之间不保证一致——如果你把生成的数据硬编码进了断言,记得在 requirements 里锁死版本号(Faker==40.40.0),不然哪天升级后数据变了,测试莫名其妙红了,查半天。
PART 07 — 提效账本和边界
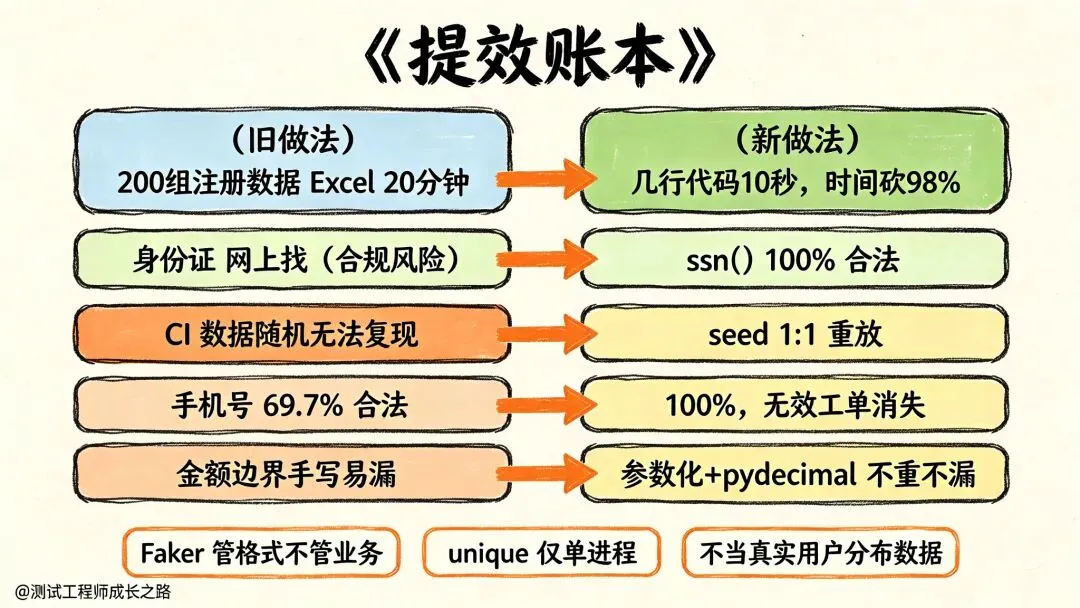
老规矩上账本:
前提说明:以上数据均来自我本机实测,你跑出来的姓名手机号肯定跟我不同(seed 不同),但"200/200 合法""69.7% vs 100%"这类结构性结论是稳定的。手工造数据耗时因人而异,按量级理解。
最后说边界,三句话:第一,Faker 管格式不管业务——数据能穿透校验,但"这条数据该不该下单成功"它不管,断言还得你写。第二,unique 只在单进程内有效,分布式造数另说。第三,别把 Faker 输出当真实用户数据用——它是假的,这是优点(隐私合规),也是边界(测真实数据分布的统计特性时,得另想办法)。
我的用法已经沉淀成标准动作:新项目拉起来先放 conftest.py(中文 locale + seed),四要素数据一律 Faker,AI 只负责写那些" Faker 表达不了的业务规则数据"的生成函数。
你们团队现在测试数据怎么造?还在 Excel 手敲的请在评论区扣 1,被"数据格式不对"打回来的留个言,看看谁的遭遇最惨 🤔
如果你觉得这篇文章还不错,不妨动动手指,给它点个赞👍,让更多人看到它的魅力。觉得内容对你有帮助,就大胆地分享到朋友圈吧,让知识传递得更远。同时,也欢迎在评论区留下你的想法和见解,我们一起交流探讨。当然,别忘了关注我,这样你就不会错过我后续的精彩分享啦!最后,记得点个“在看”👀,让我们共同见证测试之美!
•(END)•
记得拉至文末为糖糖点个“在看”
喜欢这篇文章欢迎转发、分享朋友圈~
目前100000+人已关注我们