ARTICLE · 1273755
第 4.2 章:Embedding 文档并存入 Milvus
《RAG 实战案例》第 4.2 节。
调用 Qwen Embedding 生成 Chunk 向量,先用 20 份文档跑通 Milvus HNSW 索引链路,再观察全量构建的限流问题。
本节目标
上一节已经能把完整文档切成 Chunk,但目前只能拿到文字。要根据问题找到语义相近的内容,还需要把每个 Chunk 转换成向量,并把向量保存到 Milvus。
这一节完成下面的离线索引链路:
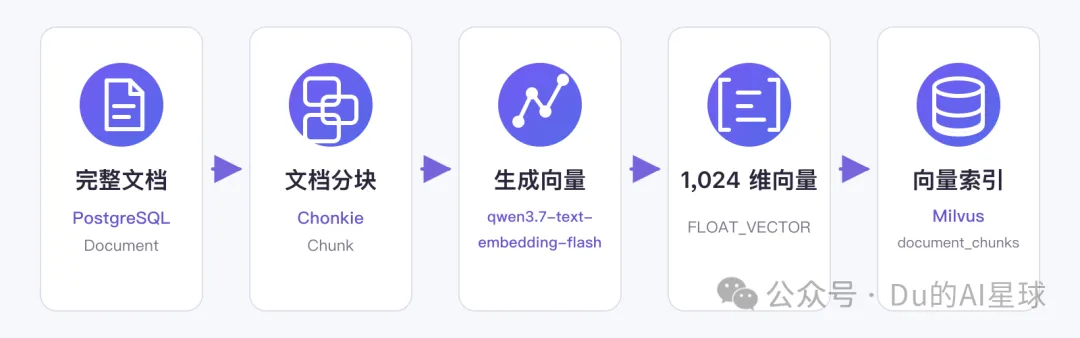
最终得到正式命令:
rag index build安装模型与 Milvus 依赖
在项目根目录执行:
uv add dashscope pymilvusdashscope 是阿里云百炼官方 Python SDK,pymilvus 是 Milvus 官方 Python SDK。安装说明分别见 阿里云百炼 SDK(https://help.aliyun.com/zh/model-studio/install-sdk)和 Milvus Python SDK(https://milvus.io/docs/install-pymilvus.md)。
配置 API Key 和索引参数
本节直接使用阿里云百炼提供的千问模型,不再重复介绍账号开通和 API Key 创建。如果还没有准备好,请先阅读【Python AI应用入门:开通阿里云百炼并准备调用凭证】。
打开阿里云百炼业务空间管理页面(https://bailian.console.aliyun.com/cn-beijing/settings/workspace) ,找到创建 API Key 时使用的业务空间,拷贝 DashScope 的API Host 作为 RAG_DASHSCOPE_BASE_HTTP_API_URL。
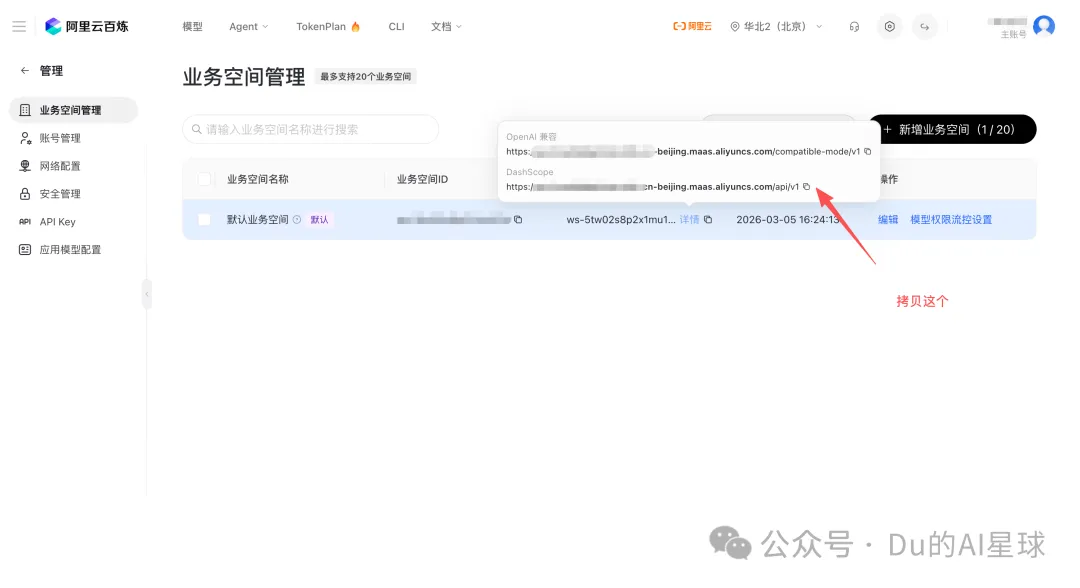
本节使用 DashScope SDK,因此复制 DashScope 一行中以 /api/v1 结尾的地址,不要复制以 /compatible-mode/v1 结尾的 OpenAI 兼容地址。
API Key、DashScope 地址和调用的模型必须属于同一个业务空间和地域。
在本地 .env 中增加:
RAG_DASHSCOPE_API_KEY=替换成自己的_API_KeyRAG_DASHSCOPE_BASE_HTTP_API_URL=替换DashScope的API HostRAG_EMBEDDING_MODEL=qwen3.7-text-embedding-flashRAG_EMBEDDING_DIMENSIONS=1024RAG_EMBEDDING_BATCH_SIZE=20RAG_MILVUS_URI=http://localhost:19530RAG_MILVUS_COLLECTION=document_chunks不要把真实 API Key 写进 .env.example,也不要提交到 Git。在 .env.example 中只保留空值和非敏感配置:
修改 src/enterprise_rag_cli/config.py,在 Settings 中增加:
dashscope_api_key: SecretStr | None = Nonedashscope_base_http_api_url: AnyHttpUrlembedding_model: str = "qwen3.7-text-embedding-flash"embedding_dimensions: int = 1024embedding_batch_size: int = Field(default=20, ge=1, le=20)milvus_uri: str = "http://localhost:19530"milvus_collection: str = "document_chunks"qwen3.7-text-embedding-flash 支持 256、512、768 和 1,024 维向量,单次最多处理 20 条文本。我们使用 1,024 维和每批 20 条,模型规格见 qwen3.7-text-embedding-flash(https://help.aliyun.com/zh/model-studio/qwen3-7-text-embedding-flash)。
调整 Chunk 结构
向量检索返回 Chunk 后,还要告诉用户它来自哪份文档。现在修改 src/enterprise_rag_cli/domain/models.py 中的 Chunk,增加两个字段:
class Chunk(BaseModel): chunk_id: str = Field(min_length=1) document_id: str = Field(min_length=1) # 新增字段 source_type: str = Field(min_length=1) source_id: str = Field(min_length=1) position: int = Field(ge=0) text: str = Field(min_length=1) token_count: int = Field(gt=0)然后修改 application/chunking.py 中创建 Chunk 的部分:
Chunk( chunk_id=make_chunk_id( document.document_id, source_chunk.text, position, ), document_id=document.document_id, # 新增内容 source_type=document.source_type, source_id=document.source_id, position=position, text=source_chunk.text, token_count=source_chunk.token_count,)现在 Milvus 检索结果需要直接展示原始来源,所以补充 source_type 和 source_id。
封装 Embedding 调用
创建 src/enterprise_rag_cli/infrastructure/embeddings.py:
from __future__ import annotationsfrom http import HTTPStatusimport dashscopefrom dashscope import TextEmbeddingfrom enterprise_rag_cli.config import Settings# 向量文本def embed_texts( texts: list[str], settings: Settings,) -> list[list[float]]: if not texts: return [] if len(texts) > settings.embedding_batch_size: raise ValueError("单批文本数量超过 embedding_batch_size") if settings.dashscope_api_key is None: raise RuntimeError("请先配置 RAG_DASHSCOPE_API_KEY") api_key = settings.dashscope_api_key.get_secret_value().strip() if not api_key: raise RuntimeError("请先配置 RAG_DASHSCOPE_API_KEY") dashscope.base_http_api_url = str( settings.dashscope_base_http_api_url ).rstrip("/") response = TextEmbedding.call( api_key=api_key, model=settings.embedding_model, input=texts, dimension=settings.embedding_dimensions, ) if response.status_code != HTTPStatus.OK: raise RuntimeError( f"Embedding 调用失败:{response.code} {response.message}" ) # 根据index字段来排序 rows = sorted( response.output["embeddings"], key=lambda item: item["index"], ) vectors = [row["embedding"] for row in rows] if len(vectors) != len(texts): raise RuntimeError("Embedding 返回数量与输入数量不一致") if any( len(vector) != settings.embedding_dimensions for vector in vectors ): raise RuntimeError("Embedding 返回维度与配置不一致") return vectors模型返回的每条结果都有 index。代码先按它排序,确保向量顺序和输入 Chunk 顺序一致,再检查数量与维度。DashScope 的请求和响应字段见 文本向量同步接口(https://help.aliyun.com/zh/model-studio/text-embedding-synchronous-api)。
创建 Milvus Collection
创建 src/enterprise_rag_cli/infrastructure/vector_store.py:
from __future__ import annotationsfrom pymilvus import DataType, MilvusClientfrom enterprise_rag_cli.config import Settingsfrom enterprise_rag_cli.domain.models import Chunk# 创建milvusdef create_milvus_client(settings: Settings) -> MilvusClient: return MilvusClient(uri=settings.milvus_uri)# 创建集合def recreate_chunk_collection( client: MilvusClient, settings: Settings,) -> None: collection_name = settings.milvus_collection # 删除整个集合数据,测试环境,我们为了简单这么写 # 生产环境下,一般是建立一个临时 Collection,把数据写入到这个临时 Collection 中,确保索引构建完成后,再通过 Alias 切换到新的 Collection,最后才删除旧的 Collection if client.has_collection(collection_name=collection_name): client.drop_collection(collection_name=collection_name) # 创建数据结构 # auto_id 标识主键 id 不自动生成 # enable_dynamic_field 参数控制是否允许插入 Schema 中未定义的字段 schema = MilvusClient.create_schema( auto_id=False, enable_dynamic_field=False, ) # 创建 chunk_id字段,主键,VARCHAR 类型,最长 64 字节 schema.add_field( field_name="chunk_id", datatype=DataType.VARCHAR, is_primary=True, max_length=64, ) schema.add_field( field_name="document_id", datatype=DataType.VARCHAR, max_length=64, ) schema.add_field( field_name="source_type", datatype=DataType.VARCHAR, max_length=64, ) schema.add_field( field_name="source_id", datatype=DataType.VARCHAR, max_length=128, ) schema.add_field( field_name="position", datatype=DataType.INT64, ) schema.add_field( field_name="text", datatype=DataType.VARCHAR, max_length=8192, ) # 存储向量,dim 是维度 schema.add_field( field_name="vector", datatype=DataType.FLOAT_VECTOR, dim=settings.embedding_dimensions, ) index_params = client.prepare_index_params() index_params.add_index( field_name="vector", # 使用HNSW索引,这里不过多解释,官方解释已经很清晰( https://milvus.io/docs/hnsw.md ) index_type="HNSW", # metric_type="COSINE" 表示使用余献相似度衡量两个向量相似度 metric_type="COSINE", # M是控制HNSW图构建的邻居连接规模 # efConstruction是HNSW 建立索引时搜索候选邻居的范围 params={"M": 16, "efConstruction": 200}, ) # 创建集合 client.create_collection( collection_name=collection_name, schema=schema, index_params=index_params, # 一致性级别:Bounded 表示有界陈旧一致性,允许一定程度的数据可见性延迟 consistency_level="Bounded", )# 写入数据库def insert_chunks( client: MilvusClient, collection_name: str, chunks: list[Chunk], vectors: list[list[float]],) -> None: # zip() 同时遍历两个列表,strict=True:确保两个列表长度一致 rows = [ { "chunk_id": chunk.chunk_id, "document_id": chunk.document_id, "source_type": chunk.source_type, "source_id": chunk.source_id, "position": chunk.position, "text": chunk.text, "vector": vector, } for chunk, vector in zip(chunks, vectors, strict=True) ] # 向 Milvus 批量插入数据 client.insert(collection_name=collection_name, data=rows)Milvus 的 Collection 类似关系数据库中的表:Schema 定义每一行有哪些字段,向量字段额外建立 HNSW 索引。这里使用余弦相似度,因为我们要比较文本向量的方向是否接近。
Collection Schema 和 HNSW 参数可参考 Milvus 创建 Collection(https://milvus.io/docs/create-collection.md) 与 Milvus HNSW(https://milvus.io/docs/hnsw.md)。
整合索引流程
创建 src/enterprise_rag_cli/application/indexing.py:
from __future__ import annotationsfrom dataclasses import dataclassfrom pymilvus import MilvusClientfrom sqlalchemy.orm import Sessionfrom enterprise_rag_cli.application.chunking import ( create_chunker, split_document,)from enterprise_rag_cli.config import Settingsfrom enterprise_rag_cli.domain.models import Chunkfrom enterprise_rag_cli.infrastructure.document_repository import ( load_parsed_documents,)from enterprise_rag_cli.infrastructure.embeddings import embed_textsfrom enterprise_rag_cli.infrastructure.vector_store import ( create_milvus_client, insert_chunks, recreate_chunk_collection,)# 统计数据@dataclass(slots=True)class IndexStats: documents: int = 0 chunks: int = 0# 执行向量文本并写入Milvus数据库def _write_batch( chunks: list[Chunk], settings: Settings, client: MilvusClient,) -> int: vectors = embed_texts( [chunk.text for chunk in chunks], settings, ) insert_chunks( client=client, collection_name=settings.milvus_collection, chunks=chunks, vectors=vectors, ) return len(chunks)# 向量并索引def build_vector_index( session: Session, settings: Settings, document_limit: int | None = None,) -> IndexStats: # 从SQLPostgre上读取文档 documents = load_parsed_documents(session, limit=document_limit) if not documents: raise ValueError("PostgreSQL 中没有可以建立索引的文档") # 创建Milvus client = create_milvus_client(settings) stats = IndexStats() try: # 创建集合 recreate_chunk_collection(client, settings) # 创建文档切割容器 chunker = create_chunker( settings.chunk_size, settings.chunk_overlap, ) # 待处理Chunk pending: list[Chunk] = [] for document in documents: stats.documents += 1 # 把切割后的文档放在待处理容器中 pending.extend(split_document(document, chunker)) # 按批量向量数量切割Chunk,拿去向量并存储数据库 while len(pending) >= settings.embedding_batch_size: batch = pending[: settings.embedding_batch_size] stats.chunks += _write_batch(batch, settings, client) del pending[: settings.embedding_batch_size] # 把剩余的向量并存入数据库 if pending: stats.chunks += _write_batch(pending, settings, client) # 将已写入数据推进到持久化存储 client.flush(collection_name=settings.milvus_collection) return stats finally: client.close()这个流程只在内存中保留一个很小的待处理列表。攒够 20 个 Chunk 就调用一次 Embedding,再立即写入 Milvus,不需要先把全部文档向量都放进内存。
实现 rag index build
创建 src/enterprise_rag_cli/commands/index.py:
from __future__ import annotationsimport typerfrom rich.table import Tablefrom enterprise_rag_cli.application.indexing import build_vector_indexfrom enterprise_rag_cli.config import get_settingsfrom enterprise_rag_cli.infrastructure.database import create_session_factoryfrom enterprise_rag_cli.presentation import consoleapp = typer.Typer(no_args_is_help=True)@app.command("build")def build( limit: int | None = typer.Option( None, "--limit", min=1, help="只索引前 N 份文档,适合先做小规模检查",),) -> None: """重新建立当前文档库的向量索引。""" settings = get_settings() session_factory = create_session_factory(settings) with console.status("正在切分文档、生成向量并写入 Milvus…"): with session_factory() as session: stats = build_vector_index( session=session, settings=settings, document_limit=limit, ) table = Table(title="向量索引构建结果") table.add_column("项目") table.add_column("数量", justify="right") table.add_row("文档", str(stats.documents)) table.add_row("Chunk", str(stats.chunks)) table.add_row("向量维度", str(settings.embedding_dimensions)) table.add_row("Milvus Collection", settings.milvus_collection) console.print(table)修改 src/enterprise_rag_cli/cli.py,导入索引子命令:
from enterprise_rag_cli.commands.index import app as index_app在现有命令注册代码旁增加:
app.add_typer( index_app, name="index", help="建立和管理检索索引",)测试运行索引
先启动 PostgreSQL 和 Milvus Standalone:
docker compose up -d postgres standalonedocker compose ps第一次先索引 20 份文档,确认 API Key、Embedding 和 Milvus 都能正常工作:
uv run rag index build --limit 20命令完成后会看到类似结果:
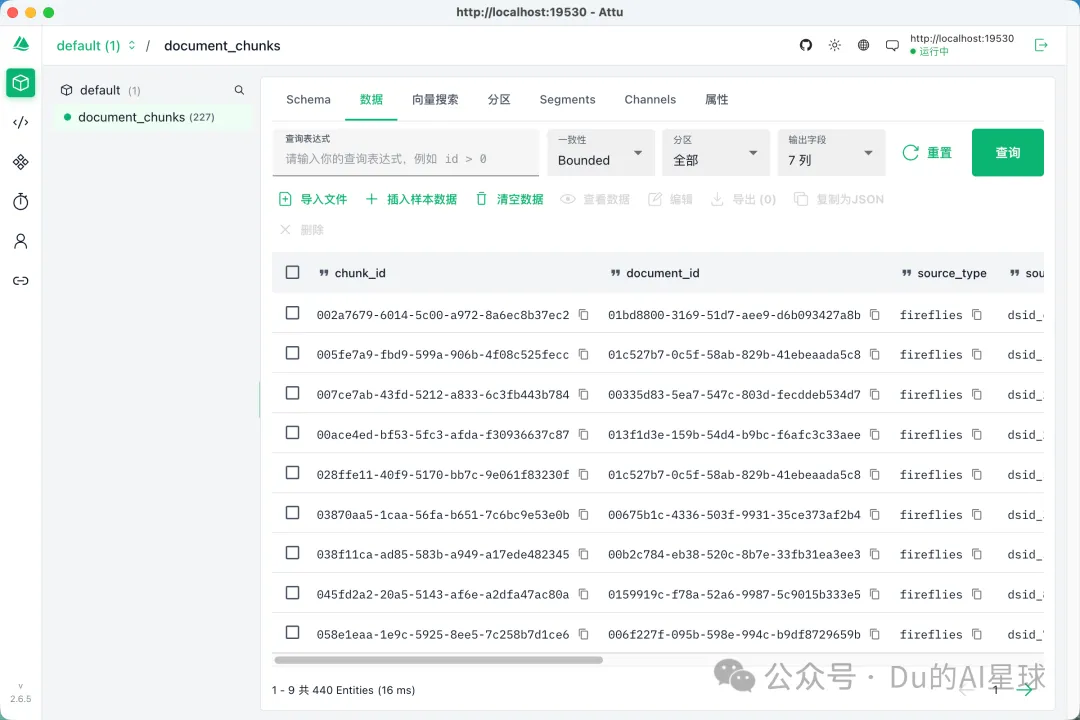
向量索引构建结果┏━━━━━━━━━━━━━━━━━━━┳━━━━━━━━━━━━━━━━━┓┃ 项目 ┃ 数量 ┃┡━━━━━━━━━━━━━━━━━━━╇━━━━━━━━━━━━━━━━━┩│ 文档 │ 20 ││ Chunk │ 227 ││ 向量维度 │ 1024 ││ Milvus Collection │ document_chunks │└───────────────────┴─────────────────┘Chunk 数量由文档长度决定,实际结果可能略有不同。只要命令正常结束,并且文档数为 20,就说明文档切分、向量生成和 Milvus 写入已经全部跑通。
使用 Attu 查看写入的数据
Attu 是 Milvus 的可视化管理工具,作用类似于 PostgreSQL 使用的 Navicat。可以从 Attu Releases(https://github.com/zilliztech/attu/releases) 下载并安装。
打开 Attu 后使用下面的连接信息:
• Milvus 地址: http://localhost:19530• Milvus 数据库: default• 用户名和密码:留空 • SSL:不勾选
连接成功后,打开 document_chunks Collection,在“数据”页面单击“查询”,可以看到已经写入的 Chunk:
建立完整索引
小规模索引已经成功。接下来不设置 --limit,尝试为 PostgreSQL 中的全部文档建立索引:
uv run rag index build命令运行一段时间后,应该会出现类似错误:
RuntimeError: Embedding 调用失败:Throttling.AllocationQuotaAllocated quota exceeded, please increase your quota limit.原因是完整文档库会连续发送大量请求,累计 Token 达到百炼的每分钟上限后,就会触发 Throttling.AllocationQuota。具体限流规则可以查看百炼限流文档(https://help.aliyun.com/zh/model-studio/rate-limit)。
当前代码还有另一个问题:命令开始时会先删除并重建 document_chunks Collection。如果中途调用失败,Milvus 中只会留下已经写入的部分数据。
相关链接
• 阿里云百炼业务空间管理页面:https://bailian.console.aliyun.com/cn-beijing/settings/workspace • 阿里云百炼 SDK:https://help.aliyun.com/zh/model-studio/install-sdk • qwen3.7-text-embedding-flash:https://help.aliyun.com/zh/model-studio/qwen3-7-text-embedding-flash • 文本向量同步接口:https://help.aliyun.com/zh/model-studio/text-embedding-synchronous-api • Milvus 创建 Collection:https://milvus.io/docs/create-collection.md • Milvus HNSW:https://milvus.io/docs/hnsw.md • Attu:https://github.com/zilliztech/attu/releases • 百炼限流规则:https://help.aliyun.com/zh/model-studio/rate-limit • 本节源码:https://github.com/agua-du/enterprise-rag-cli