ARTICLE · 1282326
深度学习在跨文档与底稿关联审核中的研究及应用
【研究机构】海通证券股份有限公司
01
课题背景及意义
1.1
课题背景
1.1.1 业务及监管需求
证券公司投行业务存在大量的文档工作,主要文档篇幅较大且结构复杂,编制过程涉及大量工作底稿记录和引用,通常由项目组成员分工完成,难以保证内容的一致性。保荐机构需对其真实、准确、完整性承担相应法律责任,如《公开发行证券的公司信息披露内容与格式准则第41号——科创板公司招股说明书》第一百条规定,保荐人(主承销商)应在招股说明书正文后声明:“本公司已对招股说明书进行了核查,确认不存在虚假记载、误导性陈述或重大遗漏, 并对其真实性、准确性、完整性承担相应的法律责任。
《证券发行上市保荐业务工作底稿指引》(中国证监会公告[2009]5号)中第十一条规定:保荐机构应当对招股说明书进行验证,并按照本指引的要求在验证文件与工作底稿之间建立起索引关系,即要求发行文档必须与相关底稿进行数据、文段、表格等的关联检查,保证发行文档与底稿无出入,但由于底稿众多,且发行文档数据繁杂,人工处理十分耗时且容易出现错误和遗漏。
1.1.2 研究基础
金融文档智能处理具有良好的生态化和可持续性研发特点,其处理生态主要包含“写”、“读”、“查”、“审”四类活动。作为行业信息化转型的探索者和先行者,海通证券在金融文档智能处理领域进行积极探索和持续应用落地。2018年、2019年在证券期货业金融科技研究发展中心(深圳)先后立项课题 “金融文档智能语义分析应用”与“智能数据检索引擎的研究与应用”。在投行文档(债券募集说明书、IPO招股说明书)单文档智能复核、合同智能审核、智能文档检索、智能数据检索等场景进行应用落地,建设了金融文档智能语义分析平台和应用体系,具备了一定的研究基础。
如下图所示,语义分析平台提供数据、算法以及模型开发、训练、上线等全流程开发支持,全面支撑智能语义分析的各类应用。平台的底层框架基于深度学习,在此之上训练部署各类通用智能语义分析应用模块,以支撑多种个性化服务。通过标注数据、人工训练模型、模型自我学习、重复标注学习达到模型的智能深度学习,实现对金融文档的智能语义理解。富格式文档认知和理解层则负责结构解析和认知理解,将计算机视觉、自然语言处理、领域知识相结合,将文档分解为表格、文本段落、图片等元素,再对每一部分结合上下文进行信息抽取,最终转换为结构化知识,以支持下游各项任务。基于认知推理的语义分析层则关注于业务问题凝练和解决,将细粒度语义分析技术应用到具体的业务痛点中,以支持语义复核、意图理解、语言生成等。
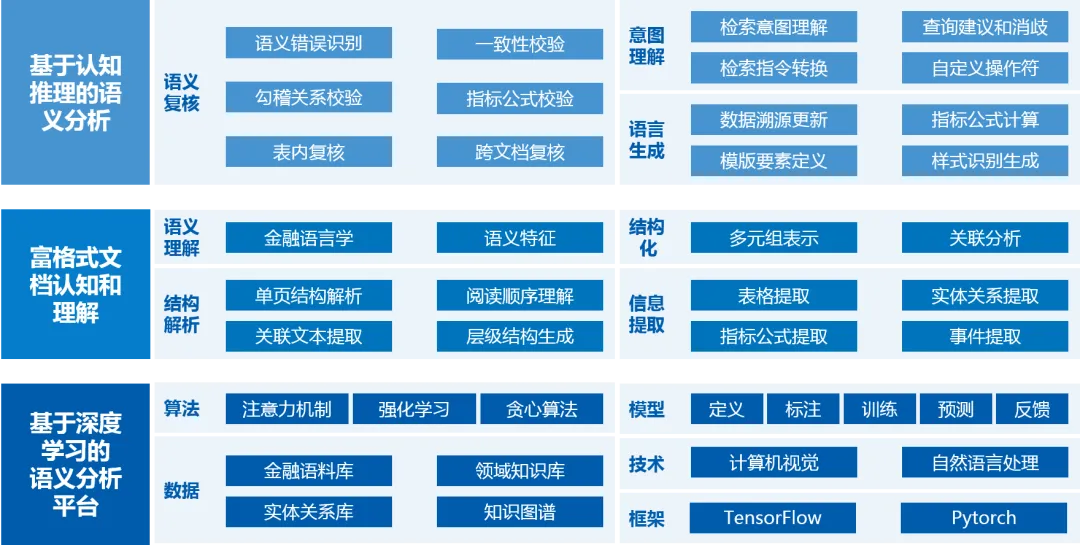
图1 金融文档智能语义分析平台
1.2
课题意义
利用深度学习、自然语言理解等前沿的人工智能技术实现底稿自动关联和跨文档审核应用,在帮助降低合规风险、提高质量控制审核能力等方面具有较好的应用价值和研究意义。一方面可以减少人工审核的工作量,提高文档质量,加速审核及保荐流程,缩短保荐时间;另一方面有助于提高证券行业的人工智能化水平,让复杂的文本工作变的简单、准确和高效,开拓业务人员对人工智能的认知,有利于行业人工智能化的进程。
02
课题完成情况及成果应用
课题完成了基于主文档的跨文档与底稿关联审核应用,在数据勾稽关系审核方面,运用主文档中的业务逻辑(数值变动、指标计算等),锁定各文档数据,进行相应计算和比较;在内容一致性方面,将具备类似描述的元素块,进行句子和单元格粒度的的比较。应用到债券募集说明书、招股说明书(含科创板)、新三板(公转书、精选层)等主文档与底稿中,取得了较好的应用效果,具体如下。
2.1
底稿关联审核应用
2.1.1 跨文档关联审核
1)跨文档数据勾稽关系审核
财务审计报告是具有审计资格的会计师事务所的注册会计师出具的关于企业会计的基础工作即计量,记账,核算,会计档案等会计工作是否符合会计制度,企业的内控制度是否健全等事项的报告,是对财务收支、经营成果和经济活动全面审查后作出的客观评价。
所以审计报告中的财务数据具有相当的权威性,招股说明书中相关财务报表及相关计算数据大部分以审计报告为标准数据,日常在编写和审核招股书财务数据过程中,引用相关财务数据基本都来自审计报告,所以对于该类底稿的核对,将主文档招股说明书与该类文档的数据建立关联,进行一一核对,并将不一致之处以红色进行标记,如图2所示,左侧为主文档中具体的位置,右侧下为底稿(审计报告)中具体的位置,右侧上为不一致性的详细信息提示,用户可以便捷地通过鼠标点击进行具体数据来源的跳转、定位及追溯审查。
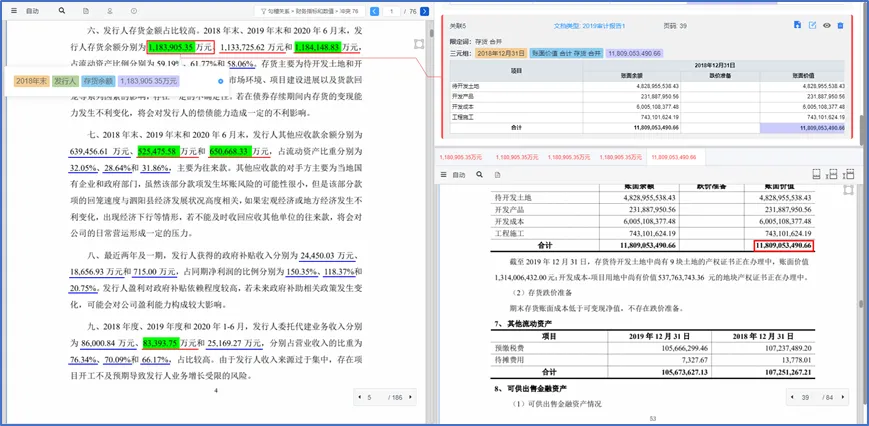
图2 跨文档数据勾稽关系审核
2)元素块(文段与表格)一致性审核
除审计报告外,应用还可以支持法律意见书、发行保荐书、上市保荐书、招股书摘要这几类副文档类型。与审计报告不同,这几类文档财务数据较少,只有少部分财务数据,通过系统可进行勾稽,项目组在编写招股书时,会从这几类文档中,摘取一些结论性的文字加入到招股书中,其中有些文字可能会经过一些修辞上或者顺序上的修改以适合招股书文档,在修改中可能会出现疏漏,这一类的问题在招股书审核中很难被发现,比如删除文字时,多删除了一个“不”字,导致文段所表达的意思与底稿完全不同,闹出乌龙事件。
对于这些文档,除了对里面的财务数据进行勾稽关系进行比较之外,还对相似的元素块(“文段”和“表格”)进行比对。对于相似的文段,比对逻辑为每个字符(含数字)、每个标点、每个符号都进行比对,两个文段不同处,进行删除线(删除)和下划线(增加)的标记,如图3.a所示。对于表格,则进行单元格级别的语义匹配及对比,并将不一致地方进行提示,如图3.b所示。
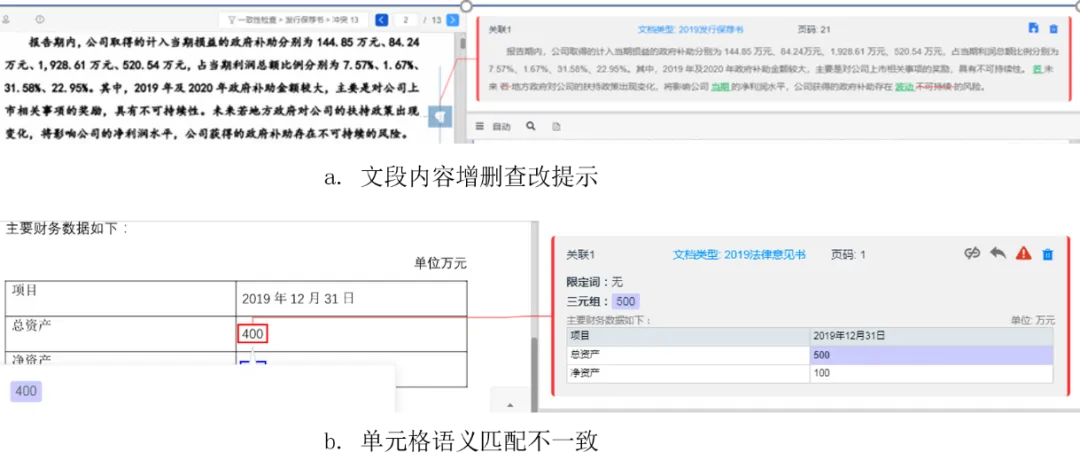
图3 跨文档元素块一致性审核
2.1.2 应用支持文档类型
应用支持以项目为单位将主文档(招股说明书、债券募集说明书、新三板公转书等)和工作底稿(选择审计报告、发行保荐书、上市保荐书、法律意见书等)上传到应用,通过自动解析发现文档间的不一致性和勾稽关系错误,将审核出的冲突和文档间的关联关系进行展示,应用支持主文档及关联底稿类型如图4所示。
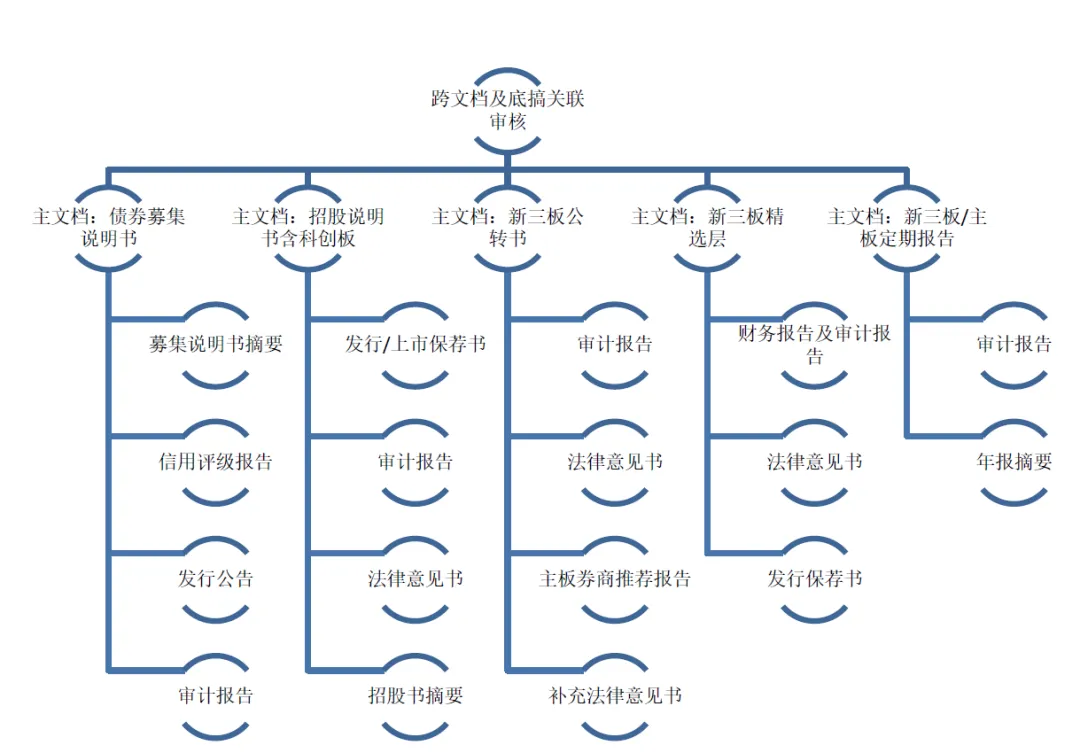
图4 应用支持主文档及关联底稿类型
2.2
应用效果
2.2.1 基于语义的单元格自动匹配
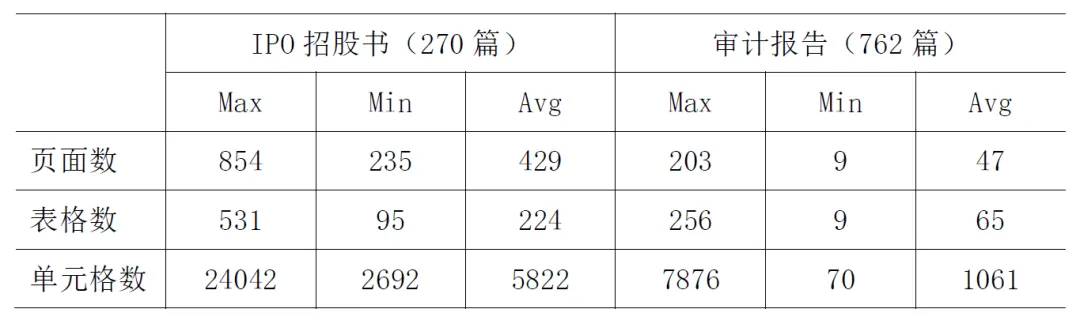
验证使用的数据集有两个,一个是270篇的IPO招股书,和762篇的审计报告。如下表所示,可以看到IPO招股书的页数和表格数量是比较多的,按照它这个数据单元格数量,平均情况下一篇招股说明书及审计报告有几千万的数据单元格对。课题组通过规则做了一些过滤操作,去掉了一些语义明显不匹配的单元格对。如,最终在单卡P40上能在10分钟内完成约400页,700多个表格中所有单元格的语义匹配,匹配(分类:是,否)的F1-score在0.8左右。
表1 基于语义的单元格自动匹配效果
2.2.2 对比人工处理关联效率
由于这些金融文档中表格数量比较多,并且表格在协同编辑过程中会被频繁更新,这些数值型事实在它们的多个提及之间可能出现不一致。这种错误会严重影响读者对公司的评价,甚至会使读者怀疑整个过程的可靠性。由于公司披露的文件通常具有法律效力,因此在正式发布之前应该彻底消除这些错误。
传统上,有一个特殊的工作称为授权阅读,即手工执行数值交叉检查。一位经验丰富的专业人士需要1个小时来反复检查10页的内容。然而给定的检查时间通常是比较有限的。不仅如此,反复的阅读容易导致疲劳和粗心。因此,即使在手动检查之后,这些数据不一致的错误仍然不可避免。
为比较应用提供的引导式交叉核对(将语义匹配的单元格自动推荐展示给审计人员进行审核)与完全采用手动方法进行单元格匹配和审核之间的效率。课题组建立了一个数学模型来比较这两种方法。
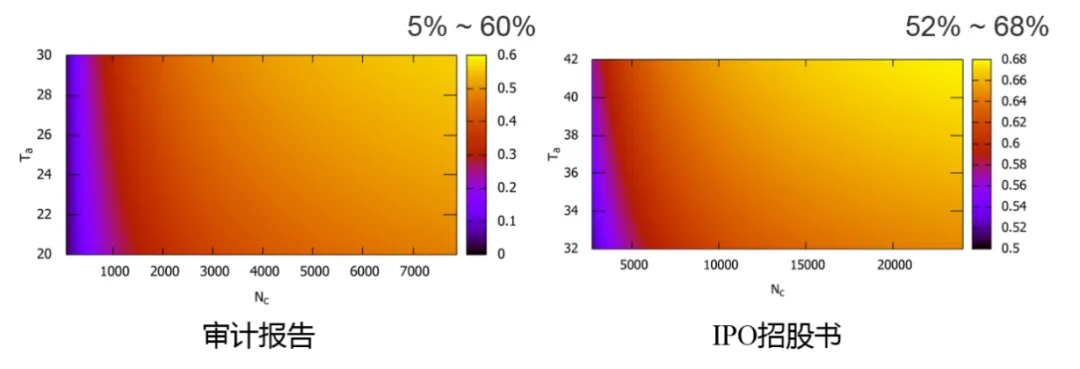
图5 引导式交叉核对比手工交叉核对节省时间
通过对专业审计人员的调查显示,采用完全手工的方法,平均处理一份数百页的IPO招股说明书需要18个小时,处理一份数十页的审计报告需要2个小时。通过实证实验对应用效果进行衡量,结果如下图所示,如图5所示,利用单元格语义自动匹配提供的引导式交叉核对功能,在审计报告和IPO招股书中,节省时间的比例分别为5% ~ 60%和52% ~ 68% 。虽然审计报告的这个范围差异很大,但是节省时间的比例大多数仍然在 40% ~ 60%,该结论与专业审计人员反馈的效果基本一致。在跨文档与底稿关联审核中,数据点和检测项都是成倍增加的,其效率也会随着文档数目的增加越来越高。
03
关键技术及创新点
3.1
技术创新
3.1.1 基于CV+NLP的富格式文档识别
为解决底稿多数为扫描件格式带来的困难,课题组设计了基于CV+NLP(计算机视觉+自然语言处理)的富格式文档认知理解过程,如图6所示,将文档看成文本、表格、图片等多种模态在二维平面上的视觉呈现,采用深度学习和自然语言处理技术,以循环神经网络模型为基础,结合视觉特征与语义特征的卷积神经网络语义进行定位和识别。首先进行“文档结构识别”,将文档分解为表格、文本段落、图片等元素;之后对每一部分,结合上下文进行信息抽取和理解,整理为结构化知识,以支持下游文档智能的各项任务,除支持细粒度跨文档审核之外,还能拓展应用到智能撰写、表格智能设计等中。
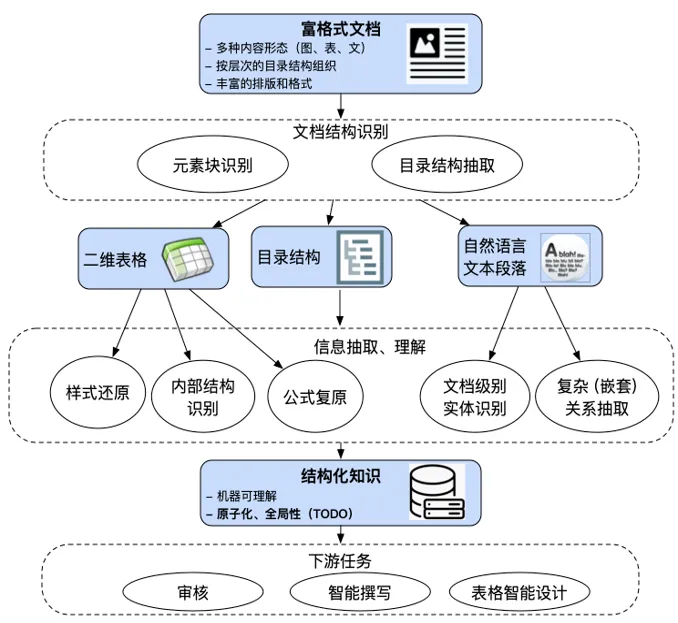
图6 基于CV+NLP+DK的富格式文档认知理解过程
3.1.2 基于增强文本语义的表格识别理解
对于PDF文档及扫描件的表格抽取与理解,采用图像分割的方法进行表格行列结构的识别,输入信息包括线条和色块的位置和颜色、字符的位置和编码、以及原始的页面图像。先将整个表格区域划分成n行m列的基础单元格,即识别贯穿线,然后再判断相邻的基础单元格是否属于同一个单元格,也就是合并基础单元格。
模型的整体框架如图7所示,绿色框内是识别贯穿线,首先将表格的信息以三维的方式输入特征提取网络得到像素级别的特征图,然后再分别经过垂直贯穿线网络和水平贯穿线网络去识别出两个方向的贯穿线。蓝色框内是合并单元格,在得到贯穿线后,就能得到基础单元格的文本特征,与像素特征拼接后进入合并网络分类。
课题组为了强化文本语义,输入的信息不再仅用原始的图像信息,还包含了字符的位置和编码、线条和色块的位置和颜色。同时,在识别和合并阶段都强化了文本语义信息。此外,使用到的字符语义和基础单元格的短文本语义都用语言模型进行了预训练。
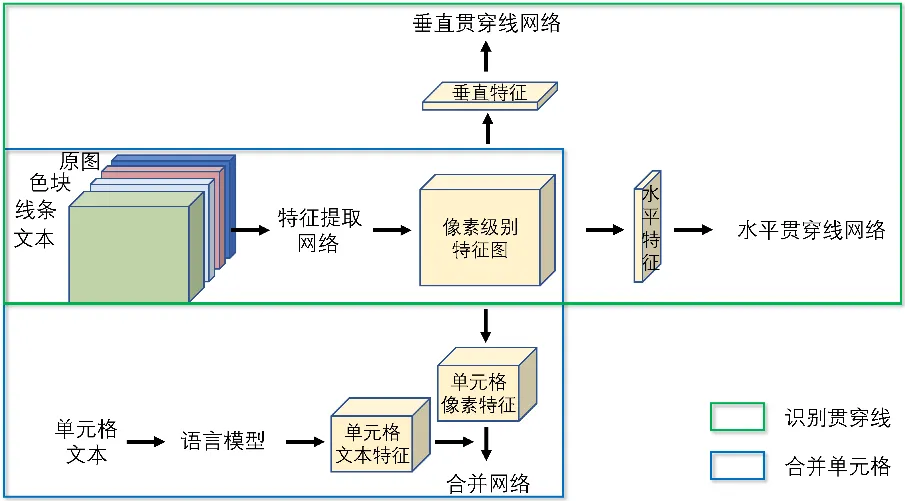
图7 基于增强文本语义的表格识别理解框架
3.2
业务创新
设计基于主文档的关联审核策略,支持以项目为单位将主文档及底稿进行解析,自动发现文档间内容不一致性和数据勾稽错误。如图8所示,从数据勾稽关系、元素块(文段/表格)相似性、引导式单元格交叉核对等方面实现多文档关联审核。
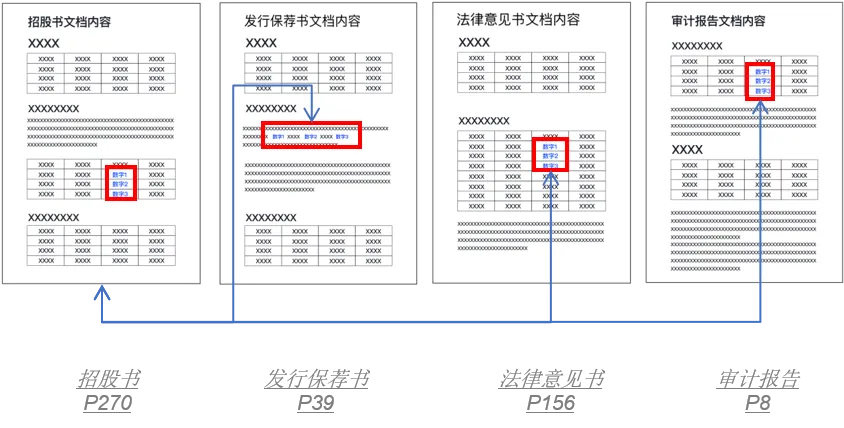
图8 基于主文档的跨文档关联审核策略
1)对审计报告等具备权威财务数据的底稿,采用跨文档的数据勾稽关系进行审核。运用从主文档中抽取出的各类勾稽关系(数值变动、指标计算等),锁定各文档数据,进行相应计算和比较,并将不一致和计算错误进行定位和高亮显示;
2)对于法律意见书、发行保荐书、上市保荐书、招股书摘要等财务数据较少的底稿,除进行数据勾稽关系审核之外,还在内容一致性方面进行审核,将具备类似描述的元素块(文段和表格),进行句子和单元格粒度的比较,并将元素块之间的不同之处,进行增删改标记。
3)对于单元格数值交叉检查,利用基于表格语义的单元格自动匹配技术,将语义含义相同的单元格进行自动匹配,提供引导式交叉核对的方式供专业审计人员辅助进行一致性检查,设计模型进行实证实验显示,与完全手动方法比较,引导式交叉核对能节省人工60%复核时间,显著提升工作效率。
04
总结与展望
4.1
总结
本课题结合投行发行文档的文档类型及特点,采用计算机视觉+自然语言处理相结合的方法,在富格式文档识别与理解方面有所突破,同时设计了基于主文档的跨文档关联审核应用,实现对债券发行、主板发行、科创板、以及新三板发行等场景的跨文档审核,从数据勾稽关系、元素块相似性、单元格匹配等方面进行自动检查和错误提示。从目前的使用情况来看,该应用能显著节省人工复核时间,达到预期效果,验证了方案的可行性,在提高投行文档合规性、提高人工交叉比对效率等方面有着较好的应用价值和研究意义。
4.2
展望
1)模型优化
对于现有模型进行进一步优化,计划选用预训练模型BERT作为神经网络表示层,更新的模型和表示方法,结合命名实体识别结果,对财务指标限定词的提取更加准确、细致,结合更多训练数据,提升模型抽取效果及处理速度。
2)底稿扩展
项目中现在可以支持发行保荐书、信用评级报告、法律意见书、上市保荐书、审计报告、招股书摘要等底稿的关联审核,后续会增加其他类型的底稿文档,继续进行标注,实现文档类型的扩充,进一步增强系统功能。
3)场景拓展
截至目前,课题组已将语义分析等智能化处理技术应用在富格式文档理解(读)、文档检索(查)、单文档及跨文档审核(审)、文档生成(写)等文档处理活动中,接下来计划打造良好的文档智能处理生态,通过规范、协同、管理等手段将各类文档处理活动进行有效结合(如:写搜结合,写审结合、规范化模版、对接底稿管理系统等),提高文档处理效率。从文档到知识,智能到智慧,帮助用户从纷繁、枯燥的金融文档工作中解放出来,推动智能金融发展。