ARTICLE · 1093735
FreeRTOS 堆内存管理源码剖析:释放一块内存,空闲块数量反而变少了?
这个系列拆过的组件有一个共同点:创建时都要申请内存,而且走的是同一个函数 pvPortMalloc。创建任务要它(任务栈 + 任务控制块)、创建队列要它、创建事件组要它、创建流缓冲还是要它——《FreeRTOS任务创建与删除机制源码剖析》里你看着任务栈从堆里割出来,《FreeRTOS 流缓冲与消息缓冲源码剖析:主体不用等待链表,也不用关中断的"队列"》里你看着它"一次 malloc 连结构带缓冲区"。但这个函数自己长什么样,系列一直没拆——它是整个内核的地基,本篇就来拆它。
先看一个反直觉的现象。实验里往堆中间释放一块 112 字节的内存,释放前空闲块有 2 个,释放后反而只剩 1 个——你多还了一块内存,空闲块的个数却变少了。这不是 bug:被释放的块压根没有作为新块挂进链表,它直接并进了前一个空闲块、又吞掉了后一个空闲块。这一"并"一"吞",就是 heap_4 管理内存的全部核心,也是它敢说"碎片攒不起来"的底气。
这篇文章沿着一条主线走:堆怎么创建、创建时注意什么、创建了什么、怎么分配给下次用、怎么释放、释放时怎么合并、日常怎么管理。先把实验跑起来看见"块数变少",再进源码看它每一步怎么做的。
平台:STM32F103RET6(Cortex-M3,标准库)内核:FreeRTOS V11.1.0(本工程实际源码,代码块首行注释标注来源)本工程 configTOTAL_HEAP_SIZE = 4096,configSUPPORT_DYNAMIC_ALLOCATION = 1,configAPPLICATION_ALLOCATED_HEAP = 0,configHEAP_CLEAR_MEMORY_ON_FREE = 1,configENABLE_HEAP_PROTECTOR = 0,configUSE_MALLOC_FAILED_HOOK = 0——本文按此配置剖析
一、概述
1.1 堆是什么
把所有花哨概念剥掉,FreeRTOS 的堆就是一个静态数组:
/* heap_4.c */PRIVILEGED_DATA static uint8_t ucHeap[ configTOTAL_HEAP_SIZE ];
本工程 configTOTAL_HEAP_SIZE = 4096,链接器给这个数组在 SRAM 里划 4KB,堆的全部物理内存就这些。pvPortMalloc 干的事是从这 4KB 里割一块给你,vPortFree 把用完的块还回来。没有页表、没有虚拟地址、没有垃圾回收——和你自己写一个"4KB 数组的管理器"面对的问题一模一样:记录哪些字节闲着、给申请者划一块、收回来接着用、别让空闲的字节碎成渣。
官方在 FreeRTOS/portable/MemMang/ 下给了五份实现,一个工程只能编入一份(pvPortMalloc 符号会冲突)。各自适配的场景一句话说清:
| 绝大多数场景的默认选择——本工程用的就是它 | 做 | ||
heap_5 的核心逻辑和 heap_4 逐行相同,只是初始化时把多段内存串成一条链。本文拆 heap_4,拆完你直接能看懂 heap_5。
1.2 内存块长什么样
堆不打散成"字节"来管,而是切成块(block)。每个块(空闲的、已分配的都一样)最前面 8 字节是一个管理头:
/* heap_4.c */typedef struct A_BLOCK_LINK{struct A_BLOCK_LINK * pxNextFreeBlock; /* 空闲时:指向下一个空闲块 */size_t xBlockSize; /* 本块大小(含这8字节头), 最高位=已分配标志 */} BlockLink_t;
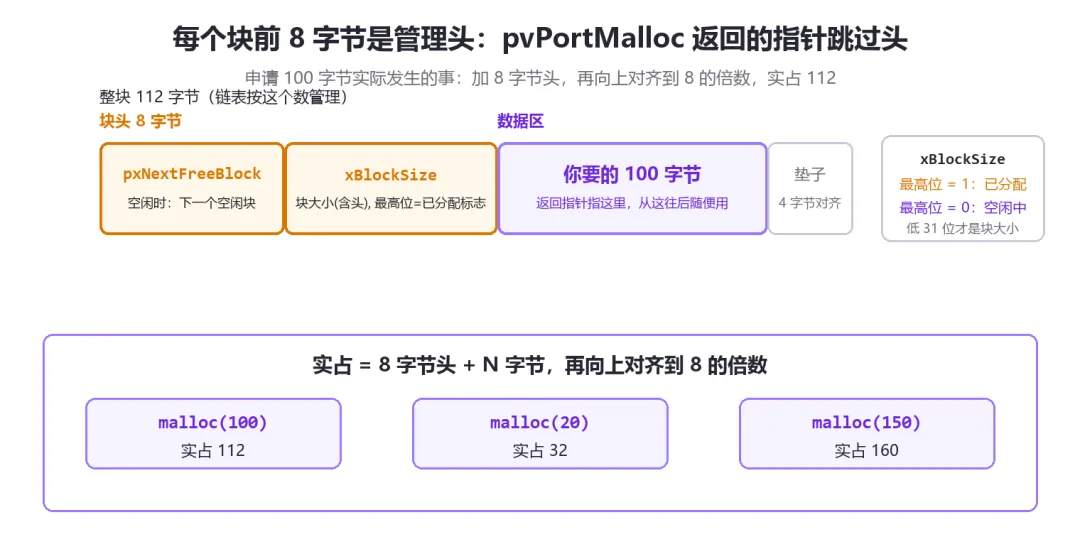
由这块头推出本篇所有数字的计算规则:
实占 = 8 字节头 + 你要的 N,再向上对齐到 8 的倍数: malloc(100)实占 112、malloc(20)实占 32、malloc(150)实占 160;块大小永远落在 8 的倍数上; xBlockSize的最高位被征用当标志位:置 1 表示已分配,清 0 表示空闲( heapBLOCK_ALLOCATED_BITMASK),所以块大小上限是 2GB 而不是 4GB——4KB 的堆用不到万分之一;xPortGetFreeHeapSize()返回所有空闲块的 xBlockSize 之和。注意口径:它说"总共闲多少",不说"最大一整块多大"——这是两个量,第三节你会看到它们怎么分道扬镳。
1.3 API 家族
pvPortMalloc(字节数) | ||
vPortFree(指针) | ||
pvPortCalloc(个数, 单个大小) | ||
xPortGetFreeHeapSize() | ||
xPortGetMinimumEverFreeHeapSize() | 评估堆够不够,看这个数 | |
vPortGetHeapStats(&统计) |
HeapStats_t 定义在 portable.h(经 FreeRTOS.h 间接包含,不用额外加头文件),vPortGetHeapStats 和 xPortGetMinimumEverFreeHeapSize 只有 heap_4 / heap_5 提供——换别的实现前对着这张表核一遍。
二、使用场景
什么时候轮得到堆管理说话?两种情况。
第一种:内核对象的动态创建。xTaskCreate、xQueueCreate、xSemaphoreCreateMutex、xStreamBufferCreate……内部全是一条路:pvPortMalloc。你在应用代码里从没写过 pvPortMalloc,但你每创建一个对象,堆就瘦一圈——哪怕一个任务都不创建,vTaskStartScheduler 一跑,空闲任务、定时器守护任务的栈和 TCB 也已经从堆里割走两回了。
第二种:你自己有大块变长的临时数据。比如一帧不确定长度的协议报文、一张解码中的图片行缓冲。这些内存的生死由业务控制,用堆比用静态数组灵活——代价是你要管好它的生老病死:谁申请谁释放、绝不重复释放、绝不越界。
什么时候不该用堆?对象个数编译期定死、且一个都不会删——开 configSUPPORT_STATIC_ALLOCATION 用静态版本(xTaskCreateStatic 等),内存放 .bss/.data 段,省下 8 字节管理头和链表维护,还避开第 5 节坑清单里的所有坑。取舍标准就一条:生命周期编译期定死 → 静态;运行期决定生灭 → 动态。
三、测试场景用例(先跑起来)
完整代码
实验思路:把堆切成"大-小-大-小-大"五块、再吃掉尾部整块,然后按能制造碎片的顺序释放,全程盯三个数:空闲总字节、最大整块、空闲块数。整个实验在 main() 里、调度器启动前跑——此时堆还没初始化(第一次 malloc 才建堆,见 4.2),基线最干净;启动流程篇拆过,这个阶段调度器没意见可提,用内核 API 完全安全。
三个数全来自官方 API:xPortGetFreeHeapSize 给空闲总数,vPortGetHeapStats 给最大整块和空闲块数:
/* ==================================================================* FreeRTOS 实验:看 heap_4 释放时怎么合并* (配套公众号 heap_4 内存管理篇)* 在 main() 里、调度器启动前跑:此时堆是完整一块,基线最干净* ================================================================== *//* 打印一行快照:空闲总字节 + 最大整块 + 空闲块数量 */staticvoidvHeapReport( constchar * pcTag ){HeapStats_t xStats;vPortGetHeapStats( &xStats );printf( "%s:空闲 %u 字节,最大整块 %u 字节,空闲块 %u 个\r\n",pcTag,( unsigned int ) xPortGetFreeHeapSize(),( unsigned int ) xStats.xSizeOfLargestFreeBlockInBytes,( unsigned int ) xStats.xNumberOfFreeBlocks );}voidheap_demo( void ){void * pvA, * pvB, * pvC, * pvD, * pvE, * pvF;printf( "\r\n=== heap_4 内存管理实验 ===\r\n" );/* 第 1 步:分配 5 块,实际块大小 112/32/112/32/112(含 8 字节块头) */pvA = pvPortMalloc( 100 );pvB = pvPortMalloc( 20 );pvC = pvPortMalloc( 100 );pvD = pvPortMalloc( 20 );pvE = pvPortMalloc( 100 );vHeapReport( "分配A-E后" );/* 第 2 步:一口吃掉尾部整块(申请"空闲-8"恰好用完最后一块) */pvF = pvPortMalloc( xPortGetFreeHeapSize() - 8 );vHeapReport( "分配F吃掉尾部后" );/* 第 3 步:放 B、D——堆里出现两个互不相邻的空洞 */vPortFree( pvB );vPortFree( pvD );vHeapReport( "释放B、D后" );/* 第 4 步:趁没合并,先试一次 150——空闲才 64,粗筛都过不了 */pvB = pvPortMalloc( 150 );if( pvB != NULL ){printf( "申请150字节:成功\r\n" );}else{printf( "申请150字节:失败(空闲64字节 < 需要160字节)\r\n" );}/* 第 5 步:放 C——夹在两个空洞中间的大块,关键一步 */vPortFree( pvC );vHeapReport( "释放C后(关键)" );/* 第 6 步:合并成果验证:再申请 150(需要一块 160 的整块) */pvB = pvPortMalloc( 150 );if( pvB != NULL ){printf( "再申请150字节:成功(从合并出的176整块里拿到)\r\n" );}else{printf( "再申请150字节:失败\r\n" );}/* 第 7 步:全部释放,看能不能回到初始状态 */vPortFree( pvA );vPortFree( pvB );vPortFree( pvE );vPortFree( pvF );vHeapReport( "全部释放后" );}
main() 里把原来的实验入口换成它(本实验不需要任务,也不需要调度器):
int main(void){NVIC_PriorityGroupConfig( NVIC_PriorityGroup_4 );USART1_Init( 115200 );heap_demo(); /* 跑完停在死循环 */for( ; ; );}
实验输出
| 申请150字节(第一次) | 失败 | ||
| 释放C后(关键) | 176 | 176 | 1 |
七个快照连起来看一遍(紫 = 空闲、灰 = 已分配):
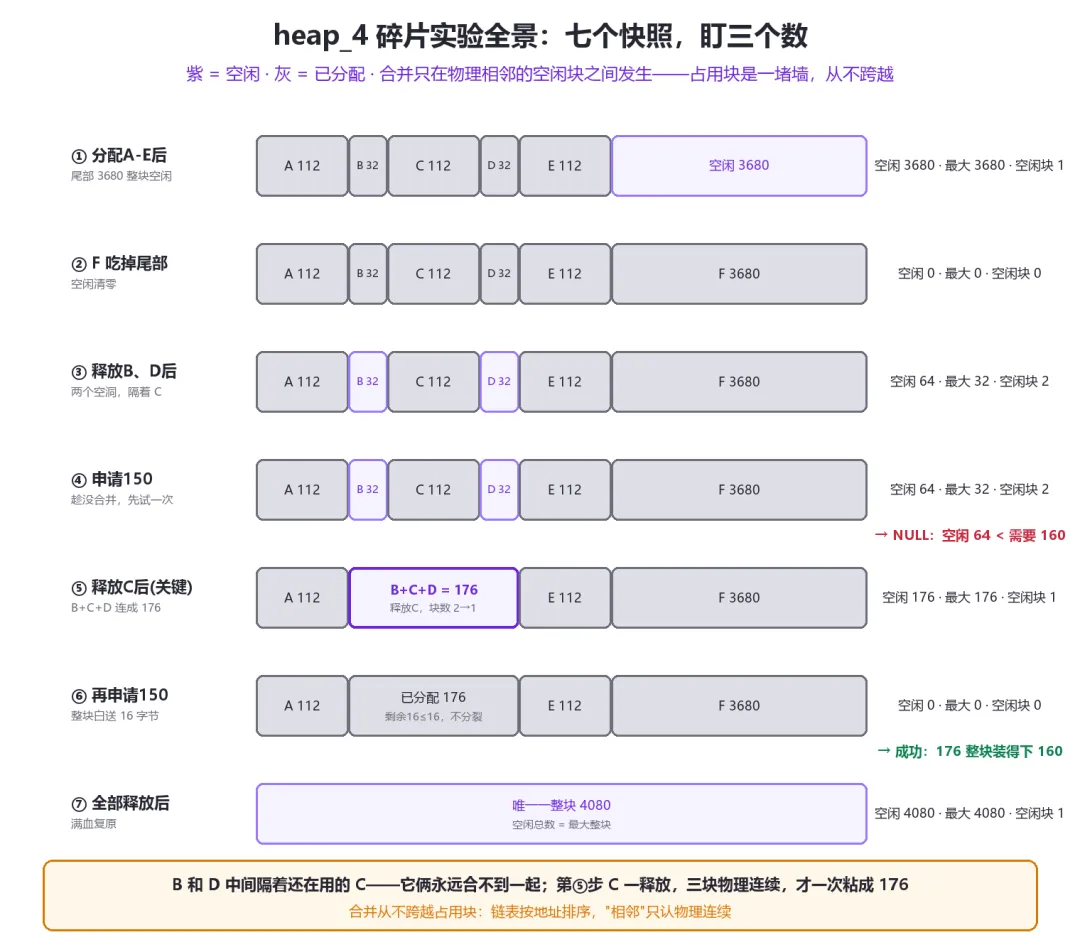
三个现象进源码前先记下
- 释放让堆变碎
:放掉 B、D 两个 32 字节的小块,空闲总数涨了 64,但最大整块从 3680 跌到 32、空闲块从 1 变 2——空闲字节是回来了,可整块能力碎没了。这时候谁要 150 字节,分配必然失败——第 4 步真的试了一次:返回 NULL; - 释放让堆变整
:放掉 C 这一块,空闲字节只涨 112(64→176),但空闲块从 2 变 1、最大整块从 32 跳到 176。释放了一块内存,块数反而变少——说明 C 根本没有作为新块挂进链表,它并进了左邻 B 的地盘,顺手又吞了右舍 D。三个孤岛(32+112+32)就此合成了一个 176 的整块; - 满血复原
:同一个 150 的申请,合并前(第 4 步)失败、合并后(第 6 步)成功——差别不在释放了多少内存,在有没有一整块装得下 160 的申请。全部释放后,空闲 4080、最大整块 4080、空闲块 1——和开机第一刻一模一样。每次释放都在合并,堆就永远回得到起点。
下面进源码,看这三个现象各自对应哪几行代码。
四、源码剖析
4.1 堆的全部状态
heap_4 管着 4KB 内存,但它的全部管理状态小得可怜——一条空闲块链表加四个计数器:
/* heap_4.c */PRIVILEGED_DATA static uint8_t ucHeap[ configTOTAL_HEAP_SIZE ]; /* 堆本体:4KB 数组 */PRIVILEGED_DATA static BlockLink_t xStart; /* 链表头哨兵(本体在堆外) */PRIVILEGED_DATA static BlockLink_t * pxEnd = NULL; /* 链表尾哨兵(本体藏在堆尾) */PRIVILEGED_DATA static size_t xFreeBytesRemaining = 0; /* 空闲字节总数 */PRIVILEGED_DATA static size_t xMinimumEverFreeBytesRemaining = 0; /* 历史最低空闲水位 */PRIVILEGED_DATA static size_t xNumberOfSuccessfulAllocations = 0; /* 累计分配次数 */PRIVILEGED_DATA static size_t xNumberOfSuccessfulFrees = 0; /* 累计释放次数 */
空闲链表有一条铁律:按地址从低到高排序。这不是为了好看——物理上相邻的两个空闲块,在链表里也必然前后脚,"找邻居"才能在链表上就近完成。4.5 节你会看到,合并的全部前提就是这条排序规则。
4.2 创建:prvHeapInit,堆的第一次 malloc 才出生
堆不是开机就初始化的。ucHeap 在开机时就是一个没人碰过的普通数组(内容全 0,躺在 .bss 段),直到第一次 pvPortMalloc,prvHeapInit 才被调用(判断依据:pxEnd == NULL)。
/* heap_4.c prvHeapInit() (节选) */staticvoidprvHeapInit( void ){BlockLink_t * pxFirstFreeBlock;portPOINTER_SIZE_TYPE uxStartAddress, uxEndAddress;size_t xTotalHeapSize = configTOTAL_HEAP_SIZE;/* 1. 数组起点向上对齐到 8 */uxStartAddress = ( portPOINTER_SIZE_TYPE ) ucHeap;if( ( uxStartAddress & portBYTE_ALIGNMENT_MASK ) != 0 ){uxStartAddress += ( portBYTE_ALIGNMENT - 1 );uxStartAddress &= ~( ( portPOINTER_SIZE_TYPE ) portBYTE_ALIGNMENT_MASK );xTotalHeapSize -= ( size_t ) ( uxStartAddress - ( portPOINTER_SIZE_TYPE ) ucHeap );}xStart.pxNextFreeBlock = ( void * ) uxStartAddress;xStart.xBlockSize = ( size_t ) 0;/* 2. 堆尾扣 8 字节,pxEnd 哨兵的本体放这里 */uxEndAddress = uxStartAddress + ( portPOINTER_SIZE_TYPE ) xTotalHeapSize;uxEndAddress -= ( portPOINTER_SIZE_TYPE ) xHeapStructSize;uxEndAddress &= ~( ( portPOINTER_SIZE_TYPE ) portBYTE_ALIGNMENT_MASK );pxEnd = ( BlockLink_t * ) uxEndAddress;pxEnd->xBlockSize = 0;pxEnd->pxNextFreeBlock = NULL;/* 3. 全堆就一个空闲块:从起点到哨兵前,挂上链表 */pxFirstFreeBlock = ( BlockLink_t * ) uxStartAddress;pxFirstFreeBlock->xBlockSize = ( size_t ) ( uxEndAddress - uxStartAddress );pxFirstFreeBlock->pxNextFreeBlock = pxEnd;xMinimumEverFreeBytesRemaining = pxFirstFreeBlock->xBlockSize;xFreeBytesRemaining = pxFirstFreeBlock->xBlockSize; /* 真机实测 = 4080,来历见下文三条 */}
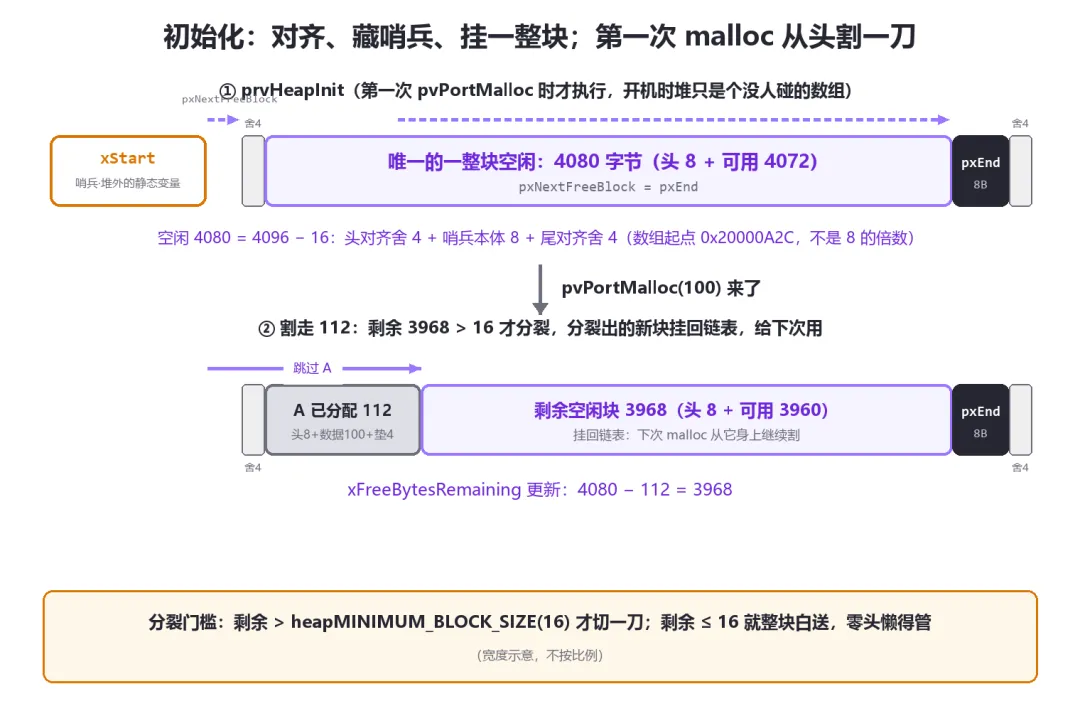
初始化一共三件事,对应的"创建时需要注意什么"也有三个注意点:
- 起点对齐:数组地址如果不是 8 的倍数,起点上移、总量缩水。别默认静态数组天然对齐——本工程的 ucHeap 被链接器摆在 0x20000A2C(map 文件可查),尾数 0xC 差 4 个到 8 的倍数,起点上移到 0x20000A30,头部 4 字节用不上,总量先缩成 4092;- 4080 = 4096 − 16:堆尾要扣 8 字节给 pxEnd 哨兵放本体——哨兵跟着堆走,出不了"指针还在、堆没了"的幺蛾子。而且哨兵的地址还要向下对齐:起点 + 4092 − 8 = 0x20001A24,尾数又差 4,再舍 4 字节,哨兵最终落在 0x20001A20,它身后到数组尽头的 4 字节也跟着废了。头 4 + 哨兵 8 + 尾 4,固定开销 16 字节——所以 configTOTAL_HEAP_SIZE 不是全部可用,真机开机第一刻的空闲就是 4080(实验输出表里的基数);- 懒初始化:第一次 malloc 才建堆。如果你把 configAPPLICATION_ALLOCATED_HEAP 设成 1,ucHeap 数组改由你自己提供,链接器不再分配——本工程是 0,用内核自带的。
4.3 怎么给下次用:pvPortMalloc 的五个步骤
分配是"割":从链表上找一块够大的,割下你要的部分,剩余的挂回链表给下次用。
/* heap_4.c pvPortMalloc() (节选) */void * pvPortMalloc( size_t xWantedSize ){BlockLink_t * pxBlock, * pxPreviousBlock, * pxNewBlockLink;void * pvReturn = NULL;size_t xAdditionalRequiredSize;/* 步骤1:加 8 字节头,再向上对齐到 8 */if( xWantedSize > 0 ){/* 源码此处还有加法溢出检查:溢出直接置 0(返回 NULL),节选略 */xWantedSize += xHeapStructSize;if( ( xWantedSize & portBYTE_ALIGNMENT_MASK ) != 0x00 ){xAdditionalRequiredSize =portBYTE_ALIGNMENT - ( xWantedSize & portBYTE_ALIGNMENT_MASK );xWantedSize += xAdditionalRequiredSize;}}vTaskSuspendAll(); /* 堆操作的"锁":挂起调度器,不关中断 */{if( pxEnd == NULL ){prvHeapInit(); /* 首次调用,建堆 */}/* 步骤2:粗筛——空闲总数够不够(注意:只看总数!) */if( ( xWantedSize > 0 ) && ( xWantedSize <= xFreeBytesRemaining ) ){/* 步骤3:从低地址往高地址找,第一个够大的块 */pxPreviousBlock = &xStart;pxBlock = xStart.pxNextFreeBlock;while( ( pxBlock->xBlockSize < xWantedSize )&& ( pxBlock->pxNextFreeBlock != NULL ) ){pxPreviousBlock = pxBlock;pxBlock = pxBlock->pxNextFreeBlock;}if( pxBlock != pxEnd ) /* 找到了 */{/* 返回的指针跳过 8 字节块头 */pvReturn = ( void * ) ( ( ( uint8_t * ) pxPreviousBlock->pxNextFreeBlock )+ xHeapStructSize );/* 步骤4:从链表摘下这个块 */pxPreviousBlock->pxNextFreeBlock = pxBlock->pxNextFreeBlock;/* 步骤5:剩余 > 16 字节才分裂;≤ 16 整块白送 */if( ( pxBlock->xBlockSize - xWantedSize ) > heapMINIMUM_BLOCK_SIZE ){pxNewBlockLink = ( void * ) ( ( ( uint8_t * ) pxBlock ) + xWantedSize );pxNewBlockLink->xBlockSize = pxBlock->xBlockSize - xWantedSize;pxBlock->xBlockSize = xWantedSize;pxNewBlockLink->pxNextFreeBlock = pxPreviousBlock->pxNextFreeBlock;pxPreviousBlock->pxNextFreeBlock = pxNewBlockLink;}xFreeBytesRemaining -= pxBlock->xBlockSize;if( xFreeBytesRemaining < xMinimumEverFreeBytesRemaining ){xMinimumEverFreeBytesRemaining = xFreeBytesRemaining;}heapALLOCATE_BLOCK( pxBlock ); /* xBlockSize 最高位置 1 */pxBlock->pxNextFreeBlock = NULL; /* 已分配块不在任何链表上 */}}}( void ) xTaskResumeAll();return pvReturn;}
五个步骤对着实验数字看:
- 步骤 1 解释了 112/32/160:实验注释里每个"实际块大小"都是这一步算出来的;- 步骤 2 和步骤 3 是两道筛子:粗筛看总数,细查找块(源码在粗筛之前还验一道申请大小没顶到最高位,4KB 的堆够不到,略)。实验第 4 步的申请 150 是被粗筛拦下的——150 加头对齐要 160,空闲总数才 64,第一道筛子就过不去;碎片还有更隐蔽的死法:还是这个处境(空闲 64、最大整块 32),申请 48 的话粗筛通过(56 ≤ 64)、细找失败(没有任何一块空闲 ≥ 56),照样返回 NULL。总数够、块不够,两层筛子之间漏下去的就是碎片;- 步骤 5 解释了"分裂"和"F 的技巧":割完还剩多于 16 字节就切一刀,剩余部分作为新空闲块当场挂回链表——这就是"给下次用"的全部实现。实验第 2 步的 malloc(空闲−8) 让对齐后请求恰好等于尾块大小,剩余 0 ≤ 16 不分裂、整块交付,堆的空闲清零,为后续实验铺出干净舞台;
分配出去的块 pxNextFreeBlock写成 NULL——这不是顺手清洁,4.4 节vPortFree靠"这个字段必须还是 NULL"抓双重释放。
整个过程用 vTaskSuspendAll / xTaskResumeAll 包住,挂起调度器、不关中断——任务之间不会互相踩,中断照常响应(这也是堆 API 进不了 ISR 的原因之一,见坑清单第 8 条)。
4.4 怎么释放:vPortFree,先验明再回收
/* heap_4.c vPortFree() (节选) */voidvPortFree( void * pv ){uint8_t * puc = ( uint8_t * ) pv;BlockLink_t * pxLink;if( pv != NULL ) /* 传 NULL 直接返回,安全 */{puc -= xHeapStructSize; /* 从数据指针倒退 8 字节,摸到块头 */pxLink = ( void * ) puc;heapVALIDATE_BLOCK_POINTER( pxLink ); /* 块头地址必须在堆内 */configASSERT( heapBLOCK_IS_ALLOCATED( pxLink ) != 0 ); /* 必须是"已分配"状态 */configASSERT( pxLink->pxNextFreeBlock == NULL ); /* 必须没被释放过 */if( heapBLOCK_IS_ALLOCATED( pxLink ) != 0 ){if( pxLink->pxNextFreeBlock == NULL ){heapFREE_BLOCK( pxLink ); /* xBlockSize 最高位清 0 *//* 本工程 configHEAP_CLEAR_MEMORY_ON_FREE = 1:释放即清零 */#if ( configHEAP_CLEAR_MEMORY_ON_FREE == 1 ){( void ) memset( puc + xHeapStructSize, 0,pxLink->xBlockSize - xHeapStructSize );}#endifvTaskSuspendAll();{xFreeBytesRemaining += pxLink->xBlockSize;prvInsertBlockIntoFreeList( pxLink ); /* 核心:进 4.5 */}( void ) xTaskResumeAll();}}}}
释放前的三道断言是三重校验:块头在堆内、最高位是"已分配"、pxNextFreeBlock 还是分配时写下的 NULL。双重释放为什么抓得住?第一次 free 把块插回空闲链表,pxNextFreeBlock 不再是 NULL,第二次 free 触发第三道断言当场卡死(前提是开了断言——本工程是开的)。写越界把块头打烂,靠的是第二、三道断言拦下(前提是块头被改得不合法);要是字段恰好被改成合法值,三道全过,堆结构静默损坏、死在八竿子打不着的地方——坑清单第 5 条说的"更糟"就是它。
本工程还有个值得知道的配置:configHEAP_CLEAR_MEMORY_ON_FREE = 1,每次释放把数据区 memset 清零。好处是野指针读回来的全是 0 而不是旧数据,坏处是 free 变慢(块越大越慢)。调试上的注意点留到坑清单第 7 条说。
验完正身,块被交给本篇的主角。
4.5 怎么合并:prvInsertBlockIntoFreeList,先看前邻、再看后邻
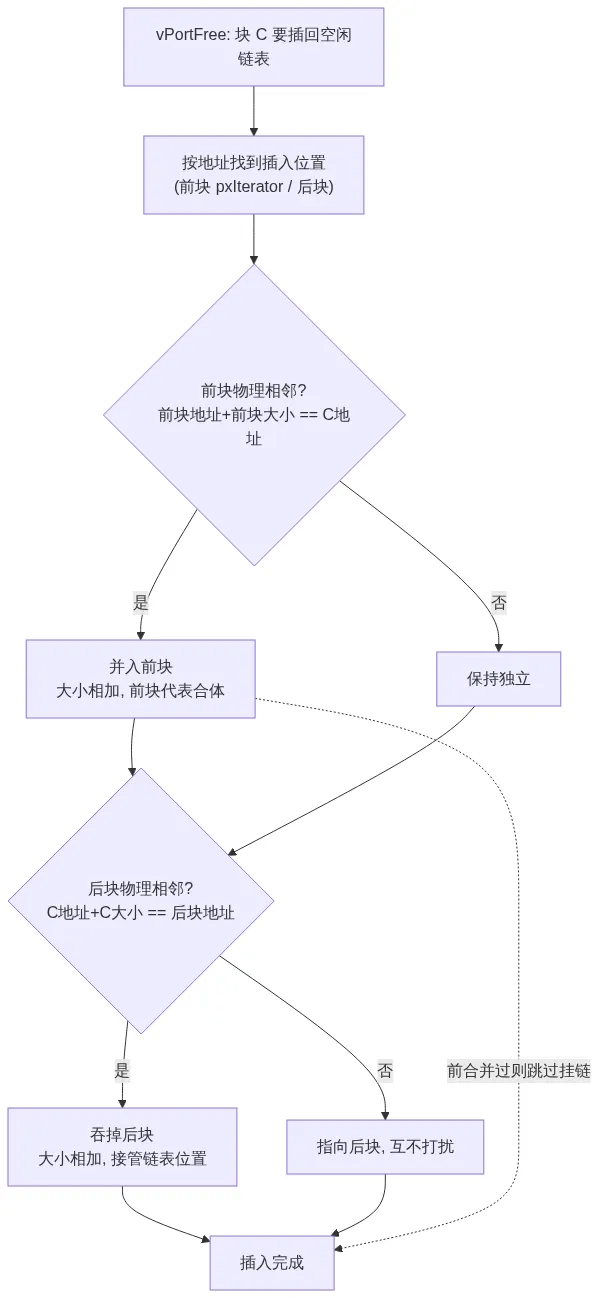
释放的块要插回空闲链表。直接插行不行?行——但堆会越来越碎(1.1 的表里 heap_2 就是这么干的,也是它退出主流的原因)。heap_4 在插回之前多做两件事:查前邻、查后邻,物理相邻就当场粘成一个块:
/* heap_4.c prvInsertBlockIntoFreeList() */staticvoidprvInsertBlockIntoFreeList( BlockLink_t * pxBlockToInsert ){BlockLink_t * pxIterator;uint8_t * puc;/* 1. 按地址找插入位置:走到"地址刚好比我小"的那个空闲块后面 */for( pxIterator = &xStart;pxIterator->pxNextFreeBlock < pxBlockToInsert;pxIterator = pxIterator->pxNextFreeBlock ){/* 空循环,纯找位置 */}/* 2. 前合并:我紧跟在 pxIterator 后面吗? */puc = ( uint8_t * ) pxIterator;if( ( puc + pxIterator->xBlockSize ) == ( uint8_t * ) pxBlockToInsert ){pxIterator->xBlockSize += pxBlockToInsert->xBlockSize;pxBlockToInsert = pxIterator; /* 我并入前块,前块代表我们俩 */}/* 3. 后合并:pxIterator 的下一个空闲块紧跟在我后面吗? */puc = ( uint8_t * ) pxBlockToInsert;if( ( puc + pxBlockToInsert->xBlockSize ) ==( uint8_t * ) pxIterator->pxNextFreeBlock ){if( pxIterator->pxNextFreeBlock != pxEnd ){/* 我和后块合成一块,接管它的链表位置 */pxBlockToInsert->xBlockSize += pxIterator->pxNextFreeBlock->xBlockSize;pxBlockToInsert->pxNextFreeBlock =pxIterator->pxNextFreeBlock->pxNextFreeBlock;}else{pxBlockToInsert->pxNextFreeBlock = pxEnd;}}else{pxBlockToInsert->pxNextFreeBlock = pxIterator->pxNextFreeBlock;}/* 4. 前面没合并过,才把我挂进链表(合并过的话,位置已经占好了) */if( pxIterator != pxBlockToInsert ){pxIterator->pxNextFreeBlock = pxBlockToInsert;}}
"相邻"的判定朴素到不像话:块 A 从地址 p 开始、大小 s,那 p + s 就是 A 的物理尽头——那里如果站着另一个空闲块,它俩就是邻居。两次判定、两次加法,就是 heap_4 合并的全部代码。
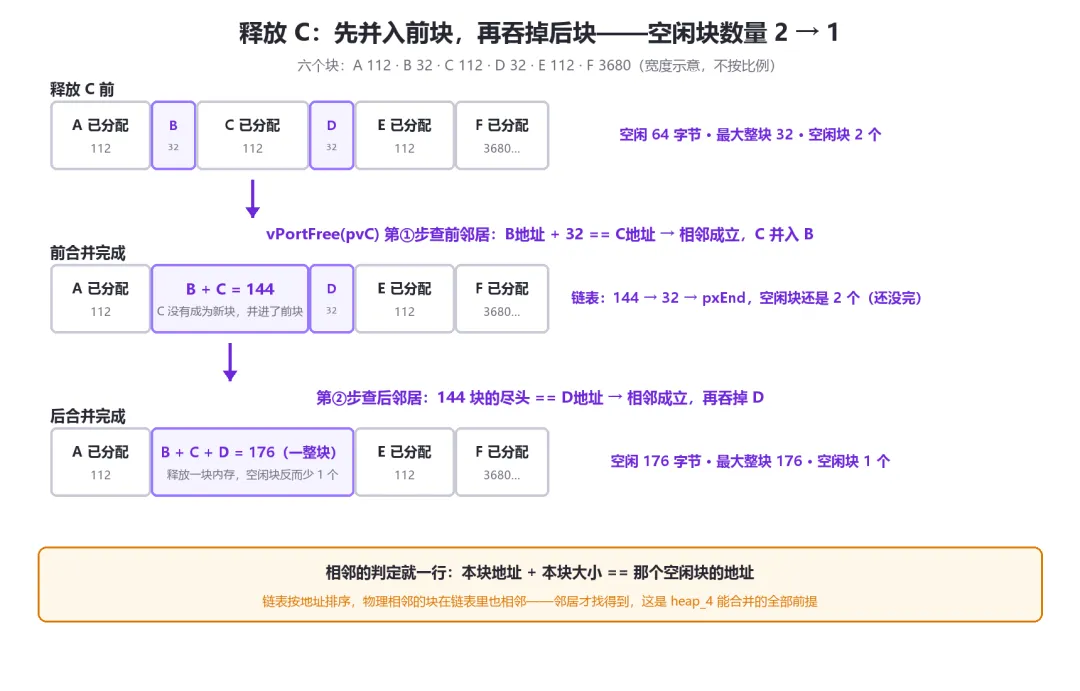
把实验第 5 步放进来推演。释放 C 之前,堆的格局(紫 = 空闲):
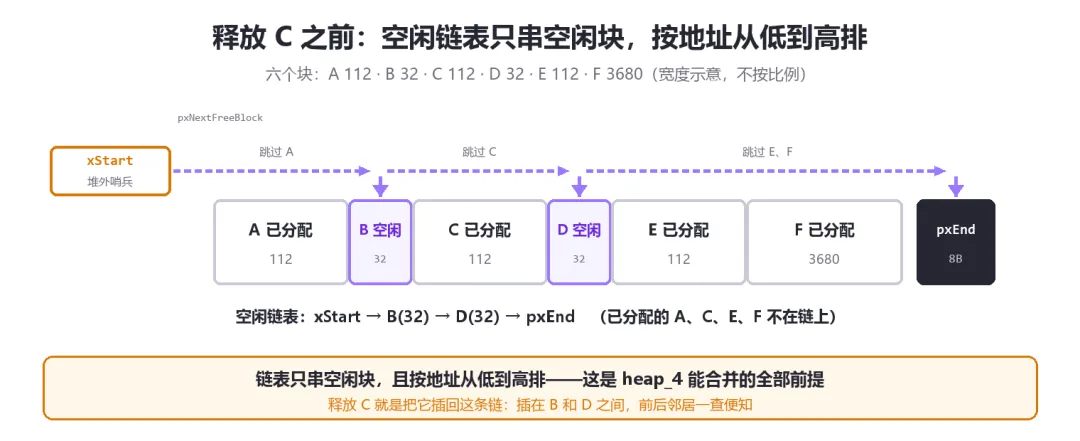
vPortFree(pvC) 进来,pxBlockToInsert 指向 C:
- 找位置
:从 xStart 沿链表走,走到 B——B 的下一个是 D,地址比 C 大,所以 C 该插在 B 和 D 之间; - 查前邻
: B地址 + 32 == C地址?成立——C 紧贴 B 之后。B.xBlockSize = 32 + 112 = 144,C 并入 B,不再单独存在; - 查后邻
: (B+C) 的尽头 == D地址?B 地址 + 144 正好落在 D 上——成立。再吞 D:xBlockSize = 144 + 32 = 176,链表位置接管 D 的下家; 前合并发生过,跳过第 4 步的挂链——B 的位置就是合体的位置。
结果:链表里一个 176 的整块取代了 B、D 两个内存碎片。释放 C 这一下,空闲块数量从 2 变 1——这就是实验表里那记反直觉的数字,现在你知道它是怎么来的了。
用一张图把"两眼"记牢:
顺带把实验第 4 步和第 6 步的对照也解释掉:
- 第 4 步申请 150 失败:150 加头对齐要 160,空闲总数才 64——粗筛第一关就不过,返回 NULL。就算放行也白搭:最大整块 32,凑不出 160 的整块;- 第 6 步申请 150 成功:150 对齐后 160,落在合并出的 176 整块里。剩余 176−160=16,不大于 16,不分裂——这 16 字节并进块头的大小里(xBlockSize 记 176,释放时整块归还),用户拿到的还是自己申请的 150,多出的 16 字节谁也不用。同一个申请,中间只差一步释放 C——没有 4.5 的合并,它永远失败(三个孤岛最大才 112);- 全部释放后满血:放 A,A 自己单独成一块(1 块);放 pvB(那个 176),和 A 相邻,并成 288;放 E,并成 400;放 F,并成 4080。链表回到只有一个大块的状态,和开机第一刻一样。每次释放都顺手合并,堆就永远回得到起点——这就是 heap_4 的碎片治理。
思考一下:把第 5 步换成释放 E,三个数会怎么变?
先自己推一遍再往下看。提示:第 4 步结束时 E 的左邻是 D(空闲),右邻是 F(还在用)。
答案:只能单向合并。E 并入前邻 D,32 + 112 = 144;右邻 F 在用,合不动。E 并没有成为新块,它并进了 D 的块里。格局变成:
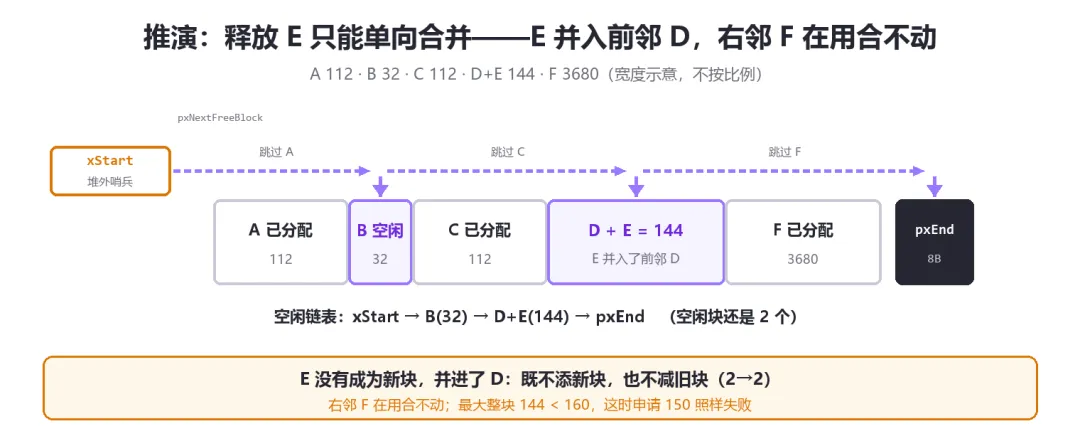
| 144 | ||
| 1 | 2 |
两个值得记的结论:
- 块数 2→2,一个没少
。释放 C 是双向合并(前后都空着),块数减一;释放 E 只有半边空,并进 D——既不添新块,也不减旧块; - 同样腾出 112 字节,位置决定收益
。三个数看着差别不大?再走一步就见分晓:这时申请 150(需要 160 的整块),144 < 160,照样失败——空闲总数和实验里一模一样是 176,malloc 却拿不出。碎片最气人的地方就在这:空闲总数明明够,最大整块却不够。
补一刀:如果先释放 E、再释放 C 呢?C 的前邻 B(32)、后邻 D+E(144)这时都是空的,一次双向合并串成 32+112+144 = 288 的巨块,空闲块 2→1。释放顺序不影响最终合出多大,但影响每一步中间有没有整块可用——这也是为什么工程上建议分配和释放尽量成对:谁申请谁释放,后申请的先还——块归还的顺序越贴近分配的逆序(像栈一样),中间状态就越不容易碎。
4.6 怎么管理:三个水位 + 一次体检
堆跑起来了,怎么知道它健不健康?heap_4 的管理数据刚好凑齐一套体检指标:
/* 三个水位 */size_t xNow = xPortGetFreeHeapSize(); /* 现在剩多少 */size_t xLow = xPortGetMinimumEverFreeHeapSize(); /* 历史最惨剩多少 *//* 一次体检:HeapStats_t(portable.h) */HeapStats_t xStats;vPortGetHeapStats( &xStats );
xAvailableHeapSpaceInBytes | ||
xSizeOfLargestFreeBlockInBytes | ||
xSizeOfSmallestFreeBlockInBytes | ||
xNumberOfFreeBlocks | ||
xMinimumEverFreeBytesRemaining | ||
xNumberOfSuccessfulAllocations | ||
xNumberOfSuccessfulFrees |
判读方法就三句话:
- xLow 贴近 0 或一直下降:堆在往耗尽走。configUSE_MALLOC_FAILED_HOOK = 0 时(本工程),malloc 失败是静默的,没人报警,只有这个水位在提醒你;- 空闲总数不小、最大整块很小:碎片在长。病根通常是"频繁小对象创建删除",药方是改对象池或改静态创建;- 分配次数和释放次数的差长期单调变大:有内存只借不还,回头查谁 malloc 没 free。
长期跑的工程可以加一个低优先级监控任务,每隔几分钟打印 xNow / xLow / 最大整块 / 空闲块数 四个数——四个数字的趋势比任何单次读数都有说服力。
五、踩坑清单
- "堆耗尽"和"栈溢出"会互相冒充
:都是死机、HardFault 居多。任务栈本身就在堆里(创建任务篇拆过), configTOTAL_HEAP_SIZE太小,最先遭殃的是空闲任务、定时器守护任务的创建——失败发生在vTaskStartScheduler内部,现象是"调度器起不来/卡死",不是你检查得到的返回值。先看xPortGetMinimumEverFreeHeapSize再查栈溢出钩子,别把堆耗尽当栈溢出修; configUSE_MALLOC_FAILED_HOOK = 0时 malloc 失败是静默的:本工程就是这个配置, pvPortMalloc返回 NULL 没有任何报错。动态创建的返回值必须判:xTaskCreate的返回值、xQueueCreate的句柄判空,一个都不能省。想加保险就开钩子,在vApplicationMallocFailedHook里点灯打印;configTOTAL_HEAP_SIZE要把固定开销算进去:本工程固定 16 字节开销(头尾对齐共舍 8 + pxEnd 哨兵本体 8)不属于你;任务栈、TCB、队列存储区全从这一个数里出。调大它要真机验证——把 xPortGetMinimumEverFreeHeapSize跑到历史最低,留出余量再定值,拍脑袋定大小是坑清单第 1 条的主要来源;- malloc(0) 返回 NULL
:不是错误,但很容易当成"出错了"。申请长度来自变长数据(报文长度、字符串长度)时,长度为 0 的路径要么提前绕过,要么容忍 NULL; - 越界写数据区 = 打烂块头
: pvPortMalloc给你的指针前面 8 字节是pxBlockSize和链表指针。数组越界往前写几字节,free 时要么触发断言卡死,要么更糟——链表指针改了,堆结构静默损坏,死在八竿子打不着的地方。configENABLE_HEAP_PROTECTOR = 1可以给块头里的链表指针再加一层保险:存储时和一个随机金丝雀值异或,越界把指针改花了就过不了校验断言,怀疑内存被踩时建议打开排查; - 双重释放靠断言抓,前提是断言开着
: vPortFree三道防伪专抓 double free,开了configASSERT当场停;没开的话链表被插成环,下次 malloc 死循环。释放路径必须"谁申请谁释放",同一次释放只执行一次; - 释放即清零是本工程行为,不是 FreeRTOS 行为
: configHEAP_CLEAR_MEMORY_ON_FREE = 1,free 顺手 memset。调试时别再依赖"free 完数据还在"——读回来全是 0;写敏感数据的项目反而可以靠它防数据残留; - ISR 里没有堆 API 可用
:malloc/free 没有 FromISR 版本,也不可能有——它们的锁是挂起调度器,而 ISR 根本不受调度器约束。中断里要动态内存?中断篇的老答案:用 xTimerPendFunctionCallFromISR把活转交守护任务,让任务上下文去 malloc。
六、总结
把这一篇放回系列的坐标系里:
- 结构上,堆是一个 4KB 静态数组 + 一条按地址排序的空闲块链表 + 四个计数器——prvHeapInit 只做三件事:对齐、把哨兵藏进堆尾、挂上唯一的一整块 4080;- 分配上,"给下次用"靠分裂:加头对齐、粗筛总数、细找整块、割走后剩余当场挂回链表——总数够、整块不够时返回 NULL,两层筛子之间漏下去的就是碎片;- 释放上,heap_4 比普通实现多做两件事:查前邻、查后邻。判定只有一行"本块地址 + 本块大小 == 那个空闲块的地址",相邻就两次加法粘成一个块——释放让块数变少,不是 bug,是它工作的痕迹;- 管理上,判堆健康看三个数:历史最低水位防耗尽、最大整块对比空闲总数防碎片、分配释放计数防泄漏。本工程 configUSE_MALLOC_FAILED_HOOK = 0,没人替你报警,水位要自己盯。
到这里,拆过的组件源码都收尾了。回看这些文章,其实一直在拆两样东西:等待的艺术(链表、位图、句柄槽位,任务总要睡觉,事件总要唤醒)和内存的来源(TCB、栈、队列存储区、环形缓冲,全从一个 4KB 数组里长出来)。最后这篇拆的就是这个 4KB 数组本身——所有组件的地基。heap_4 没有任何魔法,它只是在你每次还内存的时候,顺手看了看这笔内存两边的邻居是不是也闲着。
— 写在最后 —
如果这篇文章对你有帮助,欢迎点赞、在看、转发三连支持,这是我持续更新的最大动力。
有问题欢迎在评论区指出,我都会认真看。
点个关注不迷路,更多硬核技术剖析持续更新中,下期再见。