ARTICLE · 1147956
PDF 一复制就乱?LightOnOCR-3 开始连图表一起读
一份 PDF 看起来清清楚楚,复制出来却是一团乱:左右两栏串在一起,表格丢了列,图里的数字还得一个个敲。
最烦的往往不是读完它,而是把里面的信息,变成能继续用的资料。
10 月 8 日,LightOn 发布了 LightOnOCR-3。这个新模型把目标往前推了一步:不只转录文字,还能标出版面区域、描述图片,并把图表中的数据提取成表格。官方研究页
听起来很适合救急。但“提取出一张表”和“得到一张能放心用的表”,中间还有几道检查。今天就说清楚:它的新变化在哪里,哪些人值得试,哪些地方还不能省心。
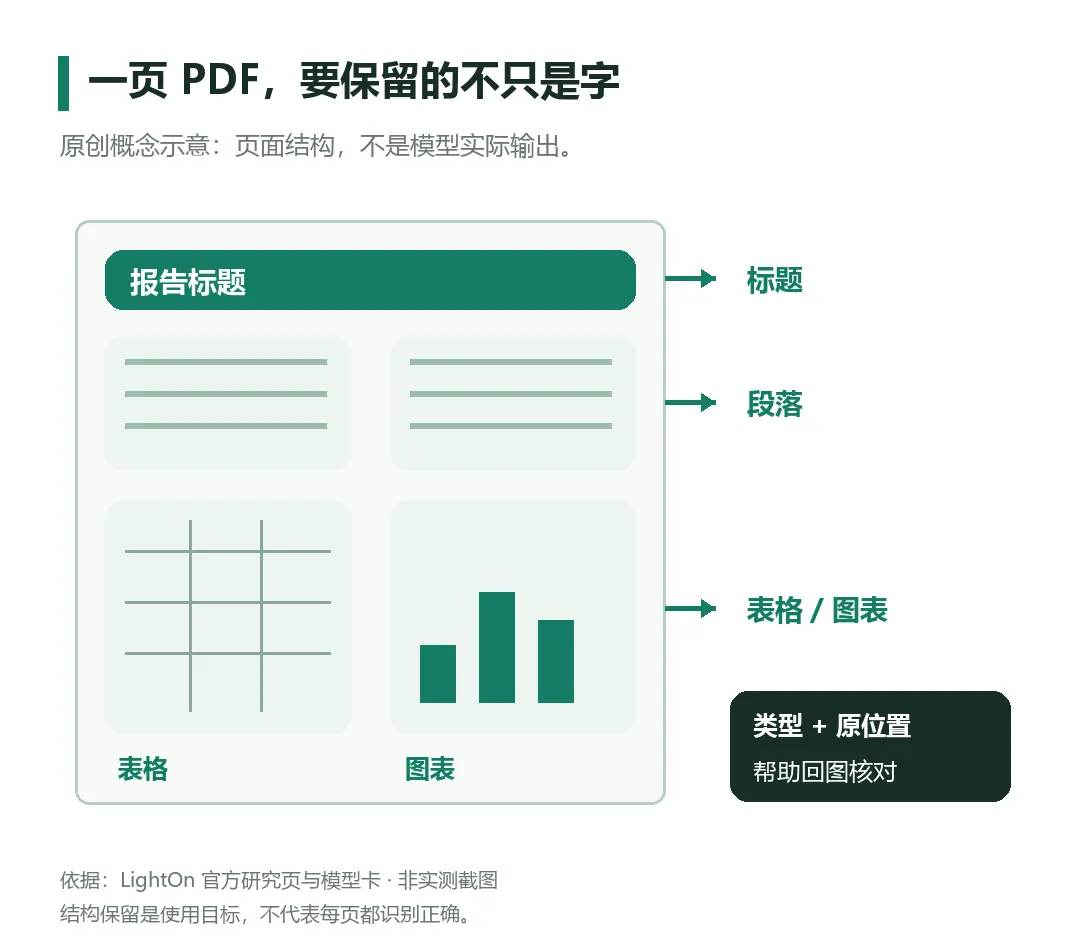
一页资料包含文字、表格和图表;原创概念示意,不是模型实际识别结果
01|复制出文字,只完成了一半
假设你正在整理一份行业报告。里面有正文、柱状图、旁边的说明,还有页脚。
你当然可以逐页截图,再让 AI 总结。但如果你要把其中的图表数据拿去做对比,把某个结论放进演示稿,还得知道:数字属于哪一项,单位是什么,原文在哪一页。
只留下文字,可能把这些关系拆散。左栏最后一句接到了右栏开头,表格里一行数字脱离了表头,图下注释混进正文——结果读起来像一段话,却不一定还能表达原来的意思。
LightOnOCR-3 的新模式试图保留这些联系。官方模型卡介绍,输入页面图像后,使用 grounding 模式,会在内容块前加上类型标签和位置框;图片可以附带简短描述,图表则输出数据点的 HTML 表格。官方模型卡与输出格式
换句话说,你拿到的有机会不只是“这一页写了什么”,还包括“哪一块是什么、在页面哪里”。
位置的价值,是方便回到原图核对。它不是准确性的保证。 一个标得很整齐的框,也可能圈住了认错的内容。
02|同一页资料,两种提取方式
这套模型保留了两种使用方式。
空提示词走文字转录,输出页面文字;只把提示词改成 grounding,就会增加版面与视觉信息。官方列出 0.8B、1B 和 4B 三个型号,供不同部署条件选择。发布团队技术说明
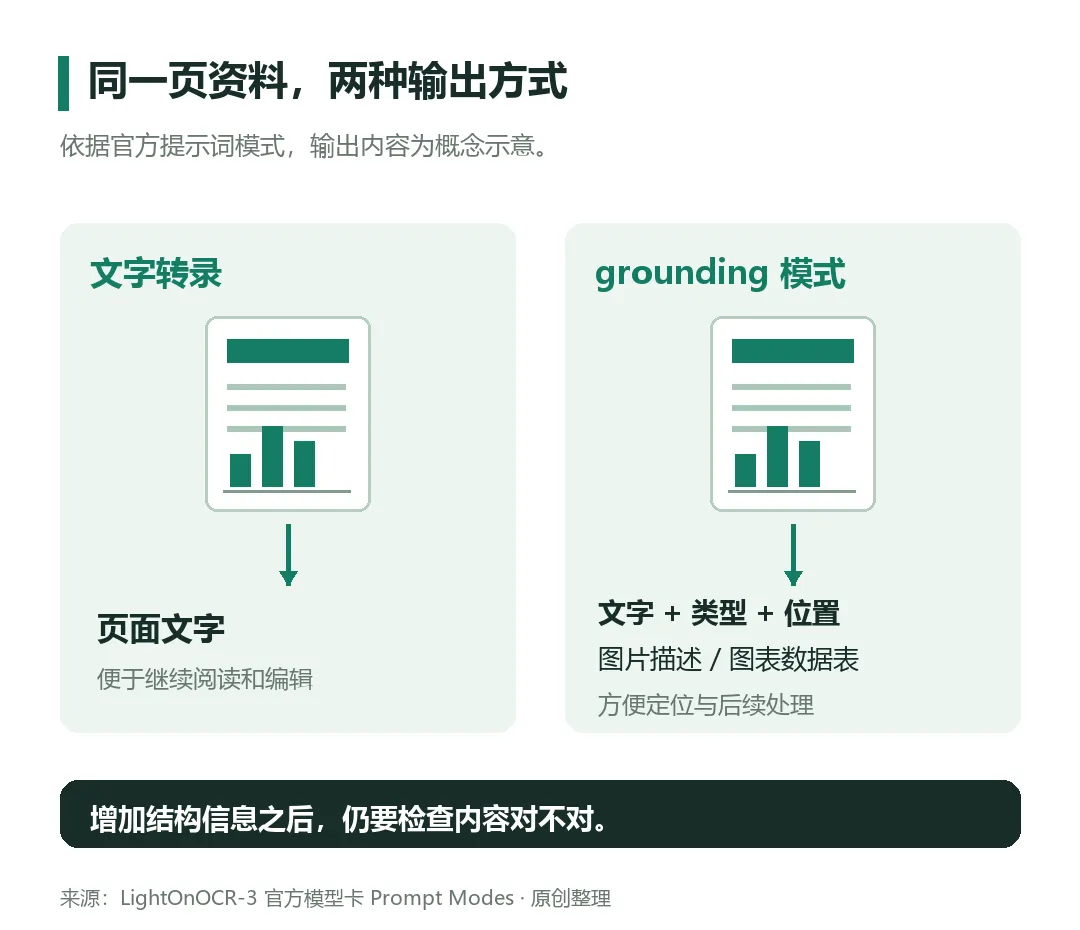
文字转录与 grounding 输出的区别;依据官方模型卡,原创流程示意
对读者而言,真正的变化不是提示词少打了几个字,而是后续整理的起点变了。
做资料研究的人,可以把提取结果和页面位置一起保存,引用时更容易找回出处。经常整理图表的人,可以先拿到候选数据,再对照原图检查,不必每次都从空表格开始录入。
搭建企业知识库的人,也有理由关注:标题、段落、表格如果能分开处理,后续搜索和问答就能更贴近文档结构。这里说的是一种应用思路,不代表装上模型就自动拥有完整的知识库。
模型也不是一个已经打包好的万能 PDF 编辑器。它处理的是页面图像,开发者还要负责把 PDF 转成图像、调用模型,并把结果送进自己的应用。
官方 GitHub 仓库提供了客户端、命令行工具、结果查看器和评测相关代码;发布团队还给出了在线演示入口。有技术基础的人,可以从这些入口验证自己的页面。项目仓库 · 官方演示入口
普通用户则可以先观察相关文档工具是否接入。没有必要为了偶尔处理一份资料,就立即折腾完整的部署环境。
03|别把榜单分数读成中文材料保证
发布团队给出了多项基准。其中,4B 版本在 olmOCR-Bench 的综合分为 86.3,而表中 Infinity Parser Pro 为 87.6。团队也说明,评分前的格式归一化,会明显影响结果。官方评测及口径
这些是项目方公布的评测,不是本文复测。86.3 也不能直接解释为“你手里的 PDF 有 86.3% 能识别正确”。
更需要留意的是,报告中的文档类型并不等于你的材料类型。法语文档成绩好,不能推出中文扫描件、潦草手写字或每一种财务表格都可靠。选模型时,自己的样本比一个综合排名更有说服力。
还有一个常见误区:表格排得越漂亮,越容易让人放松警惕。
模型可能保留了表格形状,却把一个负号、一处小数点或某个单位读错。图片描述也可能是合理猜测,不能直接替代原图证据。重要字段应逐个核对,不能只扫一眼排版就交付。
因此,我更看重它是否让错误更容易被发现。结构化输出如果能够帮助你快速找到原位置、确认字段,比一段看起来流畅却找不到出处的摘要更适合继续使用。
04|先拿三页难材料,别直接搬整库
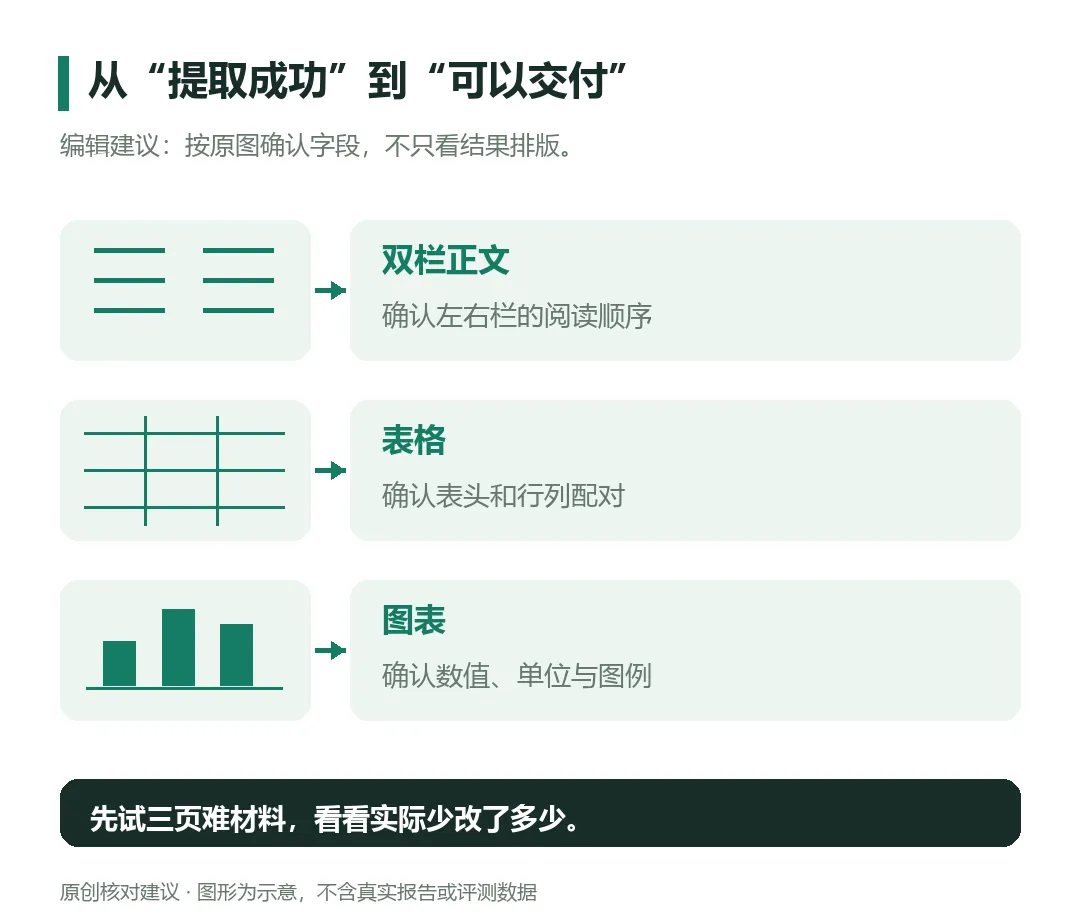
核对原图、字段与表头关系;原创检查示意,非实测截图
如果你准备试,先找三种真实页面:一页双栏正文,一页带表头和脚注的表格,一页带单位的图。
不用先追求数量。把自己最容易卡住的页面找出来,手动记录几个正确答案,再看模型返回什么。
双栏页检查阅读顺序,表格页检查行列配对,图表页检查数值、单位和图例。与此同时,确认提取结果能否方便地回到原图位置。
最后,把“运行完成”换成一个更实际的判断:整理完这几页,我究竟少改了多少地方?
若它只是把手动录入变成逐项纠错,未必值得换工具。若它稳定保留了结构,让你能快速确认来源,再考虑扩大到更多材料。
涉及内部资料时,先用脱敏样本验证。上传在线演示之前,也应确认资料是否适合交给外部服务;模型开源,并不代表任何在线入口都在你电脑里运行。
我的判断是,LightOnOCR-3 值得关注的地方,在于它把“提取文字”推进到了“保留可继续处理的内容关系”。
我们并不缺一个能把报告说得头头是道的 AI。更需要的是,交给它一页材料后,数字没有丢,关系没有乱,回头还能找到依据。
你最常遇到的 PDF 麻烦,是复制乱序、表格难搬,还是图里的数字不好提取?先选一个最费时间的问题来试。
资料核对:截至北京时间 2026 年 10 月 9 日晚。依据 LightOn 官方研究页、发布团队 10 月 8 日技术文章、模型卡和 GitHub 仓库整理;这些原始资料来自同一项目方,并非独立复测。功能及评测为项目方说明,使用场景与核对建议为编辑判断。本文未试跑模型,配图均为原创示意,不展示虚构实测结果。