ARTICLE · 1107270
[044] 选源码还是选目标码——结构覆盖的层次、盲区与 A 级追溯
〇、先看标准怎么说
0.1 啥叫软件结构
结构覆盖分析针对哪个层次做,标准没有指定。标准用的词也很微妙,是「软件结构」,不是源代码结构,也不是目标码结构。DO-178C 第 6.4.4.2.b 条的原文(中译本)是:
「结构覆盖范围可以对源代码、对象代码或可执行对象代码进行分析。独立于执行结构覆盖分析的代码形式,如果软件级别是 A,并且使用编译器、链接器或其他方法生成不直接可追溯到源代码语句的额外代码,则应该执行额外的验证,以建立这样生成的代码序列的正确性。」
这句放开的表述容易被读成「挑一个省事的做」。放开的是选择权,论证义务并没有免掉:一旦不选源码,就欠下一笔「与源码级同等」的账,这个下面会详聊。
为什么放开层次反而多出一笔举证义务?因为目标没绑层次,可目标的分量是按等级钉死的:A 级要修正条件/判定覆盖,B 级要判定覆盖,C 级要语句覆盖。层次一放开,就出现一个明显的空子,挑一层看着好交差的去顶这个目标。同等性论证就是堵这个空子的:尺子可以换,刻度不能变松。
把表 A-7 里与结构覆盖有关的目标摊开看,五个目标的主语一模一样,都是「软件结构」:
五个目标里没有一个字提到在哪种形态的程序上度量。目标是同一个,层次是另一回事。
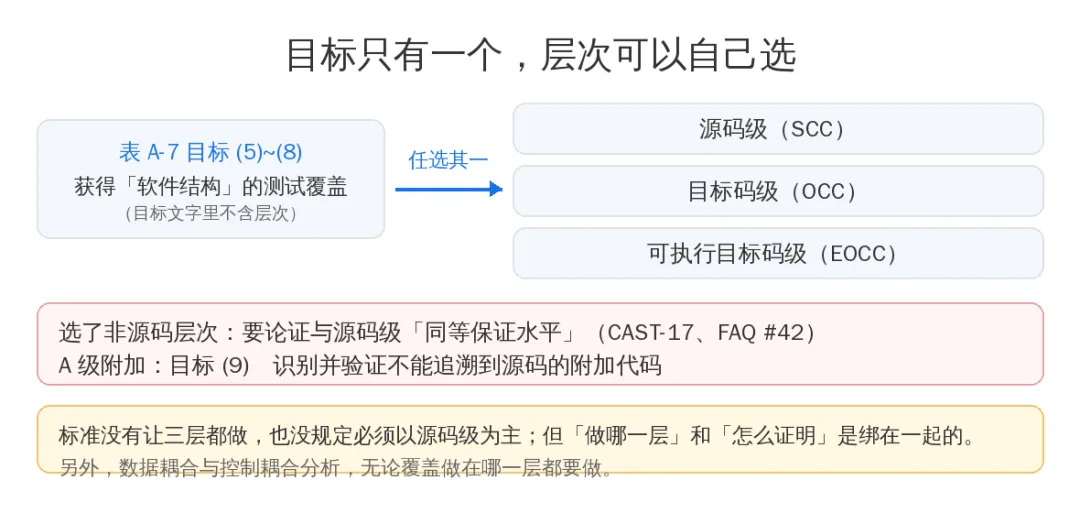
图 1|目标只有一个,层次可以自己选
标准还给 A 级软件单独留了附加要求:如果编译器产生了不能直接追溯到源代码语句的附加代码,就必须对附加代码做附加验证,确定这些代码序列的正确性(同条 §6.4.4.2.b)。表 A-7 里对应的是目标 (9),只对 A 级生效。
至于「不能直接追溯到源代码语句的附加代码」指什么,标准也给了解释:引入在源代码级别不立即明显的分支或副作用的代码,编译器生成的数组边界检查就是典型例子。
0.2 三类分析对象/层次
结构覆盖的分析对象有三类。源码级结构覆盖、目标码级结构覆盖、可执行目标码级结构覆盖,业内缩写分别是 SCC、OCC、EOCC(结构覆盖分析这项活动整体还有个简称 SCA,跟这三层不是一回事)。区别在于分析的是哪个形态的程序:源代码-人写的那一份,目标码-编译链接出来的那一份,可执行目标码-装到目标机上加载运行的那一份。
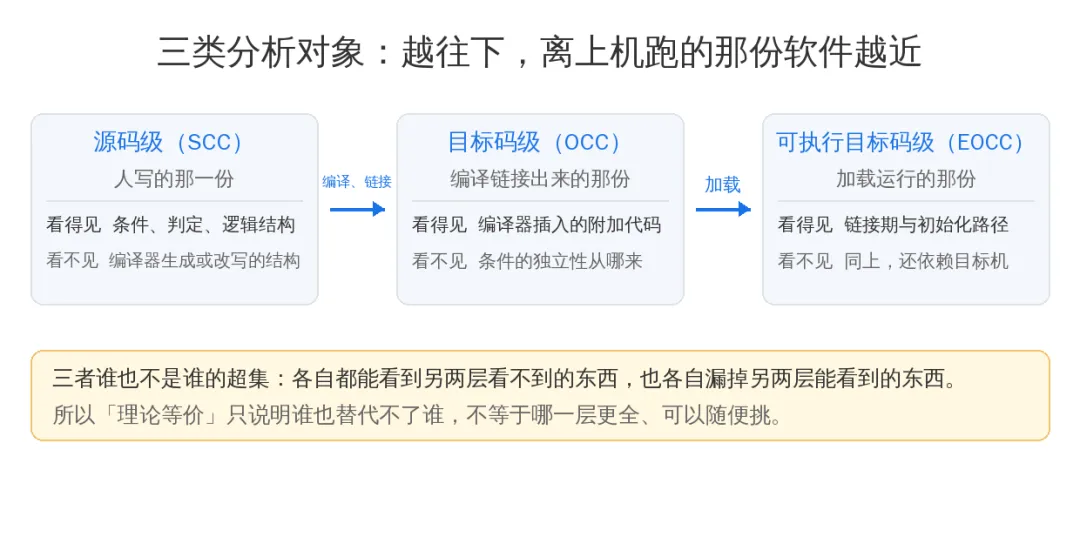
图 2|三类分析对象:越往下,离上机跑的那份软件越近
0.3 澄清文件补上的三句话
FAQ #42 补的是等价性:在目标码级做覆盖分析是可以的,只要能够提供论证,说明目标码级的分析与源码级的同一分析是等价的。
DP #19 管的是独立性。这项分析的独立性要求,按分析工作实际上在复核哪一份产物来定:复核测试用例的(看用例有没有把该覆盖的点设计进去),要求由测试用例开发者以外的人来做;复核测试规程和测试执行结果的(看实际跑到了哪些代码结构),要求由这两者的作者以外的人来做。
还有关于A级额外目标的说明:
DO-248C 的 DP #12 讲得最直白,原文是:「从对象代码到源代码可追溯性分析的目的是识别在源代码级别不可见的附加功能。此分析并不是为了证明每个对象代码语句都是正确的。」同一份文件还要求:「代表性代码结构的选择应与适当的认证机构达成一致。」结论段又强调了一遍:「这一过程应在早期阶段与相关核证机构进行讨论和同意,以便达成符合 DO-178C/DO-278A 目标的协议。」
一、三个层次各看到什么、漏掉什么
1.1 源码级:逻辑看得清,生成物看不见
源码级最大的好处是人和工具都熟。想靠补测试去提高覆盖率,在源码上做得动;在指令层面,哪条对应哪个条件都指不出来。多数商用覆盖工具本身就是为源码级设计的。
盲区在生成物这一侧。编译器和链接器生成或修改出来的结构,源码上没有对应的行:内联展开、跳转表、初始化序列、数组边界检查、异常处理例程、常量折叠、死代码消除,以及被重新组织的控制流。
1.2 目标码级:生成物看得见,布尔结构读不出
目标码是汇编和指令的形态。源码里「由条件和零个或多个布尔运算符组成的那个判定」,编译之后往往变成一串分支和标志位测试。哪个条件独立影响了判定的结果,在指令层面是看不出来的。
这就带出一条常被忽略的结论:目标码级的分支覆盖,一般情形下不等于源码级的修正条件/判定覆盖。
1.3 可执行目标码级:真实上机的那份
真正装到飞机上跑的是可执行目标码。这一层是加载之后的形态,链接期插入的代码、库合并的结果、启动与初始化路径,只有在可执行目标码这一层才看得完整。
1.4 没有哪一层是另一层的超集
把三个层次摆在一起看:
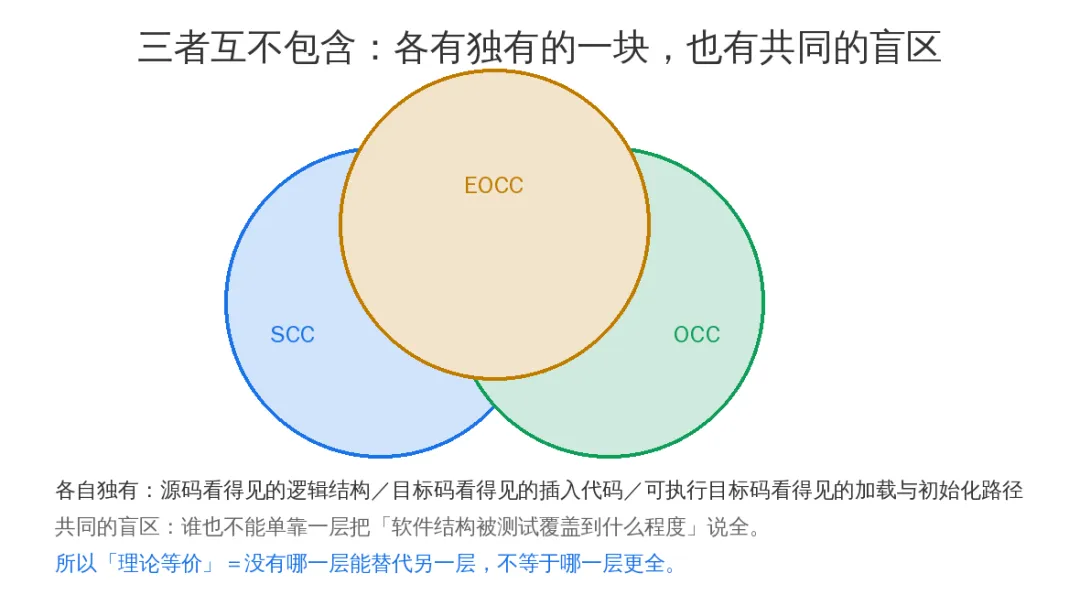
图 3|三者互不包含:各有独有的一块,也有共同的盲区
三层之间的关系可以概括成一句话:作为单独的结构覆盖度量,三者谁也不是谁的超集,各自都能看到另外两层看不到的东西,也各自漏掉另外两层能看到的东西。
这句话有出处。FAA 面向对象技术验证第三阶段的研究报告(AR-07-20)在对比三种覆盖分析时给的原话是:
「Therefore, SCA at any level (SCC, OCC, and EOCC) is theoretically equivalent to SCA at any of the other levels because each is incomplete.」
译过来就是:因为每一种都不完整,所以任何一层的结构覆盖分析与另一层在理论上是等价的。
这句话容易读歪,它不是说「三层都差不多、挑个省事的就行」,也不是说「三层都不靠谱、都一个样」。它讲的是一件更窄的事:在「谁比谁更强」这个问题上,三层互不包含,没有哪一层能把另一层的结果换算出来。拿三双眼睛打个比方,结构工程师、电工和消防员看同一栋楼,谁都看不全,所以谁也不能说自己的检查比别人的更有含金量;但要验收电路,还只有电工那双眼管用。
问题在于,标准也没把这句「等价」当成挑省事层次的理由。表 A-7 里要求的准则强度是按等级钉死的,你挑的那一层必须真能把这分量出来。目标码级最多量到分支覆盖,量不出「条件独立影响」这回事,所以选了它,就得另拿一份论证把缺口补上。这就是后面要说的同等性。
同一份报告还说明,三层各自只在一小部分子域上占优,对绝大多数子域,谁也不比谁更强,这就是「理论等价」的全部含义。承认了这一点,做法也就清楚了:一层为主、另层补盲,而不是拿一层的结果去顶另一层。
二、难点在哪儿
2.1 指标上的差距问题(同等性难证明)
NASA 有一份专门讲修正条件/判定覆盖的技术备忘录,编号 NASA/TM-2001-210876,标题是《A Practical Tutorial on Modified Condition/Decision Coverage》。里面给过一个常被引用的数字:源码级做到 100% 语句覆盖的测试集,到目标码级可能只覆盖 75% 或更少。
这个数字引自 Beizer 对逻辑密集现代代码的估算,不是实测统计,但它指向的方向是明确的:源码级达标,推不出目标码级达标。同理,源码级做到修正条件/判定覆盖,不保证目标码级也做到,反过来也一样。
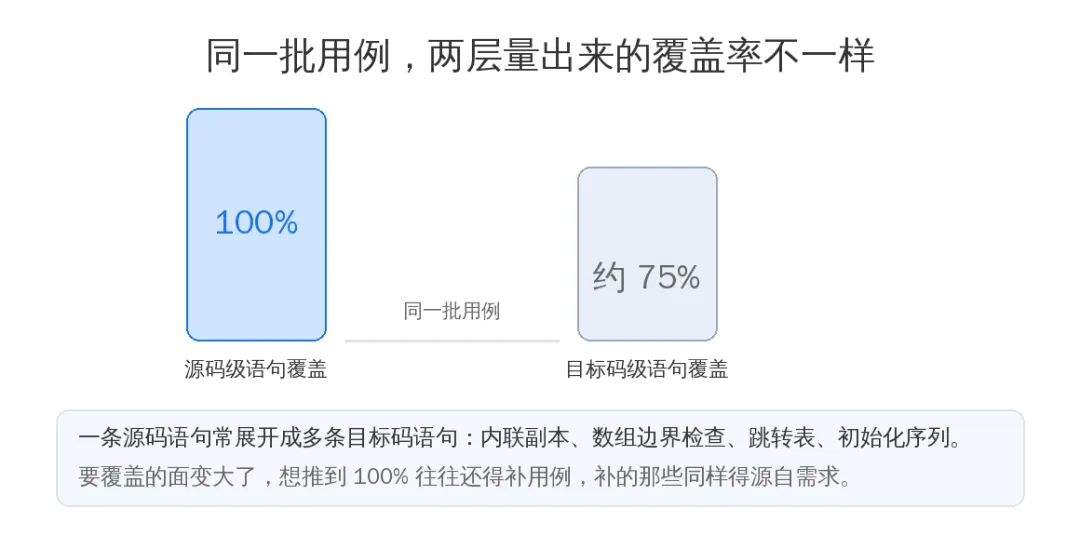
图 4|同一批用例,两层量出来的覆盖率不一样
2.2 编译器的隐藏操作不可知的问题
编译器要做的就是把源码变换成等价的目标码,中途增、删、改都会发生。
减掉的是分支、重复计算、常量折叠和死代码。增加的是内联带来的代码副本、数组边界检查、用库函数实现原生指令集不支持的操作(取模是常被举的例子)、数据拷贝循环、初始化序列、异常处理。改动的是指令调度和分支优化的结果,控制流的形态和源码不再对应。
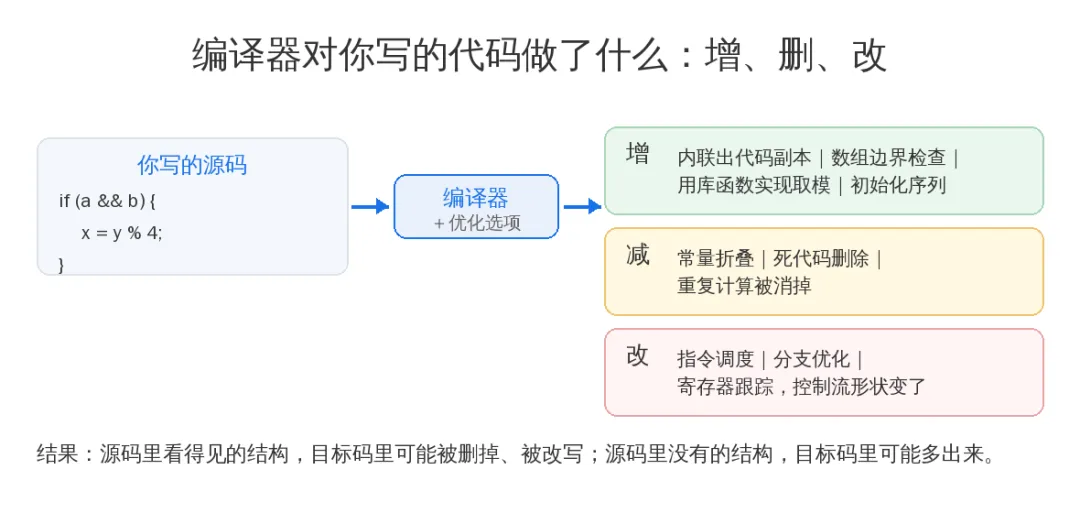
图 5|编译器对源码做的手脚:增、删、改
内联这件事 DO-248C 的 FAQ #80 专门点过:内联不只影响内存、栈和 WCET,也影响结构覆盖和源代码目标码的可追溯性,最好用设计标准控制住,比如禁止在内联里写条件语句和迭代语句。
2.3 条件多了,覆盖准则对不上的问题
目标码级做分支覆盖省事,这条结论有出处。AR-07-17 里写得很直接:短路逻辑在目标码或可执行目标码级的分支覆盖,在一般情形下不等价于源码级的修正条件/判定覆盖;要弥合这个主要差别,必须证明每个条件的独立性。
同一批研究还给了一个分档的结论,比「不等价」三个字更有用。只有一个条件的判定,目标码分支覆盖与源码级修正条件/判定覆盖是等价的,两者都只要求这个条件取到真、取到假。
条件数上去以后就不保证等价。报告实测到三种必然不等价的情形:与运算左侧的子表达式本身带有多条真路径、或运算天生有两条真路径因而不能当与的左操作数、以及即使运算符全同也不保证。弥合的办法报告也写明了:把源码侧确定出来的独立对拿到目标码侧执行并确认,等价性才成立。换句话说,选目标码级省不掉源码侧的分析。
也就是说,省掉的那部分恰好是 A 级真正要看的东西:条件的独立性。要补回来,只能把每个条件的独立影响重新证一遍,那是源码级 MC/DC 的活。所以目标码级到底用什么准则、和源码级的准则怎么对应,是选层次时就要回答的问题。
2.4 工具和环境的限制
多数结构覆盖工具是为源码级做的,做不了目标码级;少数能做的,方法又分插桩和非插桩,非插桩那种依赖硬件环境的支持(调试接口、跟踪口),换一块板子可能就不成立。
还有一种相反的场景:第三方库没有源码,只能在目标码层做覆盖。
资源受限的机载环境还有一层麻烦。插桩本身要占代码空间、内存和带宽,装不下就得分多次构建、分片采集、事后合并。一旦分了多次,「结果能不能合并」就取决于工具,而有些工具的合并功能不在鉴定范围内,那就得自己鉴定,或者最终出分的那一次不用。
2.5 抽样的代表性问题
先说为什么要抽样。A 级那项附加验证,要回答的问题很具体:编译器有没有在目标码里加进源码看不见的代码。一个中等规模的机载软件,目标码语句数往往是源码语句数的几倍,逐条比对照源码和目标码,工程量上做不完,也没有必要。
指南给的办法是拿有代表性的代码结构去抽:单独写一段包含 case、if-then-else、循环(包括嵌套例程这类复杂结构)的代码,用它去编译,再逐段分析生成的目标码。这条路可以接受,前提是抽到的代码结构必须完全代表目标码构建里实际用到的结构,而且这组代表结构的选择要与局方事先达成一致。
更硬的一条是假设。目标码覆盖的结论建立在「编译器会怎么生成代码」这个前提上,而工程上通常既不做源代码到目标码的一致性分析,也不评审编译器功能。前提拿不出证据,结论就悬着。这是「同等」两个字最难兑现的地方。
三、相关技术指南怎么说
相关文件先说清楚:
3.1 CAST-17:同等都同等在哪
这份立场文件的原话是:目标码级的覆盖分析应当与源码级提供同样的保证水平(the same level of assurance)。
围绕这一条,这份文件列了一串要处理的问题:能不能产生与软件等级相匹配的相同最小测试数;用例是不是源自需求(不许拿基于代码结构的模块测试来充数);为维持等价而定的设计编码规则有没有写进设计编码标准和检查单并且严格执行;对编译器行为的假设有没有数据支撑(例如短路形式配合相应的优化设置,同时注意编译器激进优化或自优化时行为不可预测)。
后面几条同样在这个清单里:必要时有没有做目标码分析或工具鉴定;目标码、源码、设计、需求之间有没有建立追溯;嵌套层数、单个判定里的条件数、嵌套调用这类架构与复杂度限制有没有成文并遵守;未覆盖的目标码有没有数据支撑。文件还顺带点了一句,数据耦合与控制耦合分析,无论覆盖做在哪一层,都还是要做。
这串要求里难理解的是「相同最小测试数」(也就是最小用例数)。这一条管的是对具体软件结构的最小测试数,也就是尺子的刻度密度,不是实际要写多少条用例。同一个判定,比如三个条件相与,源码级修正条件/判定覆盖的理想最小是 4 条起(短路和耦合逻辑还要更多),目标码分支覆盖 2 条就够。拿后者去顶前者,这一条立刻对不上,所以它是判断「有没有用弱准则顶强目标」最省事的一个抓手。
实际用例数是另一码事,取决于要覆盖的结构面有多大。目标码里的语句和分支通常比源码多,所以把覆盖推到 100% 往往还要补用例,补的那些同样得源自需求。两者并不矛盾:尺子的刻度必须一致,要量的东西在目标码那边更大。
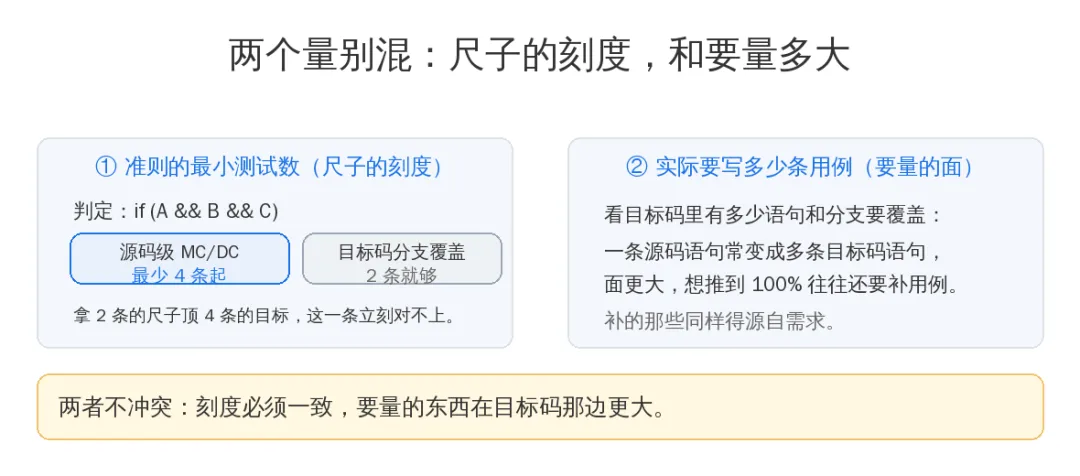
图 6|两个量别混:尺子的刻度,和要量多大
回过头看,「相同最小测试数」不是使用目标码覆盖的前提条件,真正的前提是那句更笼统的同等保证水平,最小测试数只是它最容易落地的一条。工程上很少为了一款编译器去做完整的编译器功能评审,所以编译器假设那一条的实际落法是:把编译器行为调查、编码标准、编译开关一致性这几件事的证据串起来,形成可检查的一条链。
3.2 CAST-12:三步法
识别出所有不能直接追溯的附加目标码,确定这段代码的功能,再验证这些代码序列的正确性。文件里同时澄清了一件事:这里的「正确性」不等于达到修正条件/判定覆盖,别拿覆盖准则去套附加代码。
做法上给的建议很具体:用有代表性的语言结构(case、if-then、循环)编译并分析生成的目标码;检查链接映射,防止意外的库合并把代码带进来;把优化程度、编译开关、编译器插入码这些因素都考虑进去;方法与认证机构事先达成一致。
3.3 AR-07-17 与 AR-07-20:面向对象的做法
面向对象软件里有些东西只在目标码层可见:方法表、构造器和初始化器、析构器、finalizer 和 finally 块。只看源码覆盖看不到这些,所以面向对象软件要么做源码级加目标码级的组合覆盖,要么做源代码到目标码的追溯,才能满足相应等级的结构覆盖目标。
这部分要展开写是另一篇的活,这里只给入口:想深读的可以看 AR-07-17 的 §3、AR-07-20 的 §2。
四、实际该怎么落
4.1 先定层次,再定方法
常见组合是源码级为主,目标码级用来补盲、并覆盖没有源码的模块,A 级再叠一层附加代码的追溯分析。
定层次要和硬件条件、工具能力一起定,因为非插桩的目标码覆盖依赖目标硬件;也要和软件等级一起定,等级越高,选非源码层次要补的论证越多。
从可操作性上看,B 级和 C 级放在哪一层都站得住:判定覆盖和语句覆盖在指令层能直接量出来,不存在「条件独立影响」这种只在源码概念里成立的东西。A 级不一样,修正条件/判定覆盖要靠源码侧定出来的独立对来组织,选目标码级等于源码侧的活一点没省,还多出一整套等价论证,所以 A 级以源码级为主更经济。
4.2 编译器行为调查,和一份靠谱的的编码标准
有个省事的做法是项目早期就做编译器行为调查:拿典型的代码结构(case、if-then、循环,加上取模、浮点运算、字符串处理这一类)配几组编译选项各编译一遍,把生成的目标码看一遍,记下哪些组合会插入新代码。
这件事的意义有两层。一层是摸清自己的编译环境,另一层是据此收紧编码标准,少用那些会大量插入代码的结构。分析要尽早做,等验证真正开始再补,往往要回头改代码。
调查结果还有复用的余地:只要编译器版本与设置不变、用到的代码结构没变,结论可以搬到别的项目上。反过来,编译器升级、优化档调整、新引入一类代码结构,前面的结论都要重新评。
4.3 编译开关和优化等级,测试与部署必须一致
这一条是硬红线。测试用的编译开关、优化等级和最终交付的那一份不一致,目标码就不是同一份东西,覆盖结论互不相认。链接映射同样要看,防止不相干的库被合进来。
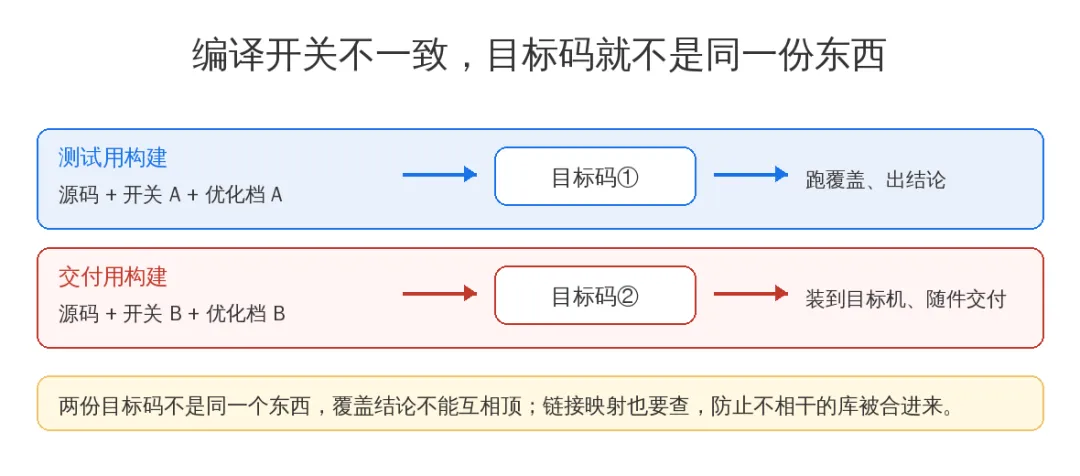
图 7|编译开关不一致,目标码就不是同一份东西
即是编译器版本没变、开关也没动,也不能默认源码级的结论可以直接搬到目标码上,两边的账是分开记的。
4.4 追溯分析的操作口径
三步落到具体动作上是这样:抽样编译有代表性的代码结构,逐段识别编译器插入的代码;判断这段代码在程序里干什么;再用分析、评审、测试里合适的手段确认行为可以接受。抽样只出现在这项追溯分析里,覆盖率本身不能抽样,那是测试真实执行出来的数据,跑出来多少就是多少。
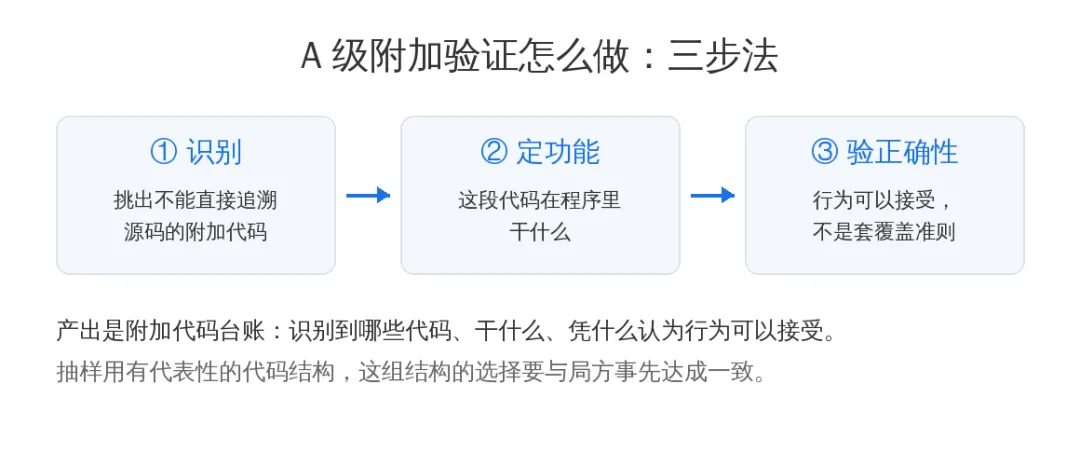
图 8|A 级附加验证的三步法
测试这一侧要按插入代码的性质定判据。举个例子,如果取模是靠库函数实现的,那就得给库实现补测试,用例用等价类的方法设计出来。
这里还得分清一件事:目标 (9) 不是覆盖率目标(是覆盖率范畴内的要求,但不是一个收集覆盖率的活动)。这个目标不要求你在目标码上再收集一次语句或判定覆盖率,也不要求报那个百分比。产出是一份附加代码台账:识别到哪些不能直接追溯的代码、这些代码干什么、凭什么认为行为可以接受。
工程上倒是常拿目标码级的覆盖报告或者反汇编扫描当筛查器,用「哪些目标码区域没有被任何源码语句对应的执行覆盖到」把候选挑出来,但这属于分析手段,不是一份能拿去记分的覆盖结论。真拿目标码级的覆盖数字去声称满足目标 (5) 到 (8),那就回到 CAST-17 那套等价性论证上了,而且这种事要跟局方事先谈定。
时机上还有一件事:这项分析要在验证真正开始之前完成,因为结论会回过头影响编码标准。等到验证跑完再补,往往要动代码,那时候以经不是原来那份目标码了。
方法、抽样原则、责任分工和判据,应当写进计划类文件,并在软件合格审定计划、软件验证计划里说清楚,同时跟局方事先确认。必竟飞机上跑的是可执行目标码,这本账不算清楚,后面很难收场。
4.5 工具侧要问清楚的几件事
能不能做目标码级;用不用插桩;不插桩对目标硬件有什么要求;分多次构建采到的结果能不能合并,合并功能在不在鉴定范围内;能不能把某段代码标成「经人工分析判定为不可测」,并把理由一起导出。这几问决定的是分析能不能做成,不只是省多少事。
经验上还有一句实在话:只要优化开得小、语言和编译器都成熟,这类分析大多查不出什么大问题(记得在老外的那本书里看到过,至今为止,这个178C里对A级代码的额外要求,还没查出过问题,兴许下一版是不是就没了,也说不定。。。),但该做的还是要做彻底。做分析的人最好同时懂语言、汇编和目标机指令,编译器用的什么调度和优化手法,心里得有数。
写在最后
回到开头那道选择题:结构覆盖在哪个层次上做。标准把选择权交出来,代价是论证的义务。源码级看得懂逻辑,目标码级看得见生成物,两边都不完整,所以常常要一层为主、另层补盲;A 级再叠一层编译器附加代码的追溯性分析。
这里面的罗辑并不复杂:先弄清自己的编译器会干什么,再决定在哪一层记这本账,最后把口径和理由写进计划文件。
你们项目上的结构覆盖是在源码级做的,还是动过目标码?做目标码级的时候,编译器附加代码那部分是怎么处理的?
觉得有用的话,点个「在看」让更多人看到 👇
#DO178C #结构覆盖 #目标码覆盖 #追溯性分析 #适航 #民机软件