ARTICLE · 1159613
AI 与自我意识的三个必要条件
「AI 有没有自我」这个问题答不了。能查的是另一句:什么样的载体能习得自我。
关于 AI 意识的讨论,我看到的几乎都在问同一个问题:有没有。这个问法本文不接,接的是开头那句——把它拆成三条能查的必要条件。先把「意识」这个词拆开:它至少指三层,本文只谈里面自我意识那一层,下面简称「自我」,三条条件只对这一层成立。
序 · 先把「意识」这个词拆开
讨论 AI 意识时,「意识」被当成一个单一的东西。它至少指三件不同的事——把三件当一件谈,这场讨论才卡住的。
0.1 三种意识
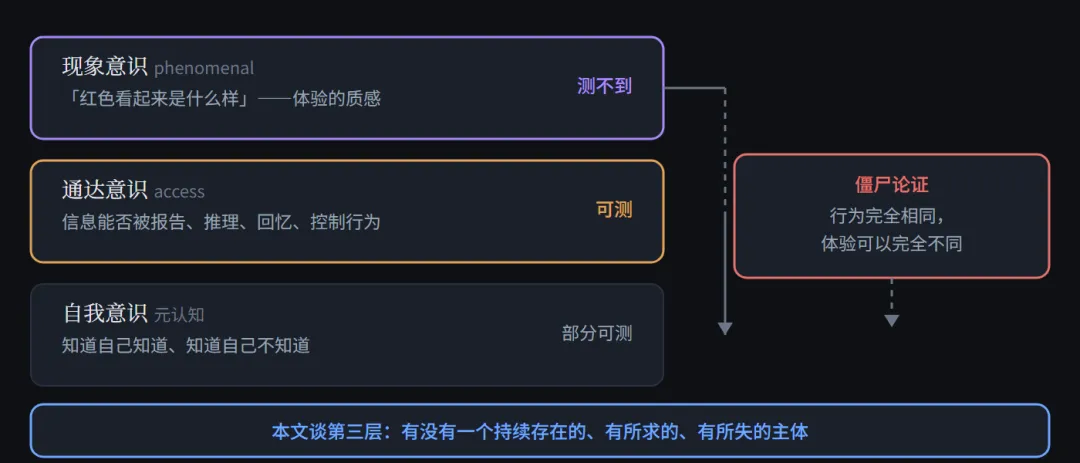
图 1. 「意识」的三种含义,可测性完全不同。本文取第三层——后面三条必要条件只对它成立,现象意识那一层不在此列。
这个区分不是学术洁癖,它来自 Block(1995)提出的一个具体混淆,至今没有共识。
0.2 本文谈的是第三层,而这是一个明确的选择
三层里 AI 各占了哪一层,本文不问。本文只问第三层。
上面那张图把这一层写作「元认知」——知道自己知道、知道自己不知道。本文要的不是这一面,是它的另一面:有没有一个持续存在的、有所求的、有所失的主体。 这两面经常被当成一件事说,本文后面凡是写「自我」,指的都是后面那个。这个取法是本文自己下的,不是文献里的共识。
这个选择有一个直接后果:
| 自我意识 | |||
|---|---|---|---|
| 必须有 | |||
| 必须有 | |||
| 必须有 |
关键在于:一次「红色的红」的体验,不需要终结的载体、不需要欲望、也不需要不可克隆。它只需要发生一次。
而后面三条条件全部是在描述「一个持续存在的、有所求的、有所失的主体」——那是自我意识,不是意识。
所以现象意识那一层,本文不下结论。 那正是它不可测、也不可由外部条件刻画的原因(见 0.3–0.4)。
而这个分层之分不只是概念上的。 2026 年有人对着同一批模型分别量了这两层,量到的是:左边那一层确有结构,而它跟「助手」那个视角可以分开(第三节摊开讲)。
0.3 第一个坏消息:有一层原则上测不到
| 测不到的 | ||
|---|---|---|
| 现象意识:「有什么感觉」 | ||
| 原则上无法从外部确定 |
所以不管说「我是有意识的」还是「它不是有意识的」,这句话只在通达意识及其以上的层次上才站得住。
而现象意识那一层——没有人能测,包括对人类自己。人只能报告自己的体验,而报告本身是通达行为,不是体验的证明。
右边那一列测不到,不等于关于意识的科学什么都测不了。左边那一列这些年一直在被量,本文第三节要用到其中几组结果——它们量的全是左边这一列,没有一组越界。
0.4 第二个坏消息:行为相同,体验可以完全不同
分不清这两层的系统,可以有完全相同的通达行为,却有完全不同的现象体验。
这在哲学上叫「僵尸」(zombie)(Chalmers, 1995):一个在所有行为和功能上都与我们一致、但内部空无一物的系统。
它们无法被区分——原则上不能。
0.5 于是问题又推后一层
现象意识那一层不在可回答的范围内——对 AI、对人、对任何东西。而「AI 有没有自我」这个问法,即使按最宽松的读法也已经很困难。
「有没有」还没问清楚,讨论「怎么办」就是超前了。
而这已经够难了。再往下问一层,连这个简化版的问题都答不出来。
一 · 被跳过的第一步
「AI 有没有自我?」
这个问法有一个被忽略的属性:它无法被回答——不是「目前答不出」,而是「答案不可能由提问双方中的任何一方给出」。
而这里有一个正好称手的性质:连续性之所以是「自我」的唯一证据,正是因为自我本身就定义为「跨时间的同一主体」。
对现象意识而言,连续性根本不是证据——一次体验不需要延续。
所以接下来的论证与自我意识的对象完全对齐,不存在「只谈了一半」的问题。
1.1 唯一的证据是连续性
假设语言模型有自我。它能提供什么证据?
只有一种可能:连续性——即「我在这一整段时间里是同一个东西」。
为什么只有这一种。 其他候选证据都能归到同一类:它能说会道、它报告自己内部有东西、它在各种场合表现得前后一致——这些全是一次实例上的输出。而单次输出按 0.4 那条推理推不出内部有什么。剩下唯一还不属于输出的,就是「这段时间一直是同一个在经历」。
1.2 而每次推理都是新实例
一个语言模型的每一次调用,都是一次重新计算。同样的输入 → 同样的输出 → 同样的结构。
没有任何东西在其中延续。
这句在 2026 年要说窄一点。 现在带持久存储的助手,确实有东西在两次调用之间留下来——会话记忆、检索库、跨天跑着的循环。留下来的是数据:下一轮把它们读进上下文,仍然是新的一轮在算,算完这一轮的进程就退了。留下来的是档案,不是那个正在经历的东西——而且档案能整份复制,这一点此节后面还要用到。
有一条反面证据得处理。 2024 年有人做了一件听着像正面证据的实验(Binder、Chua、Korbak 等,arXiv:2410.13787):把模型 M1 微调成「预测自己遇到某种输入会怎么答」,再拿另一个模型 M2 也用 M1 的真实行为数据去预测 M1。结果是 M1 比 M2 预测得更准,而且人为改掉 M1 的真实行为之后仍然如此。作者的读法是:M1 对自己的内部倾向有一种外部观察者拿不到的通达,他们把这叫内省。
它砍不到本节。 它量的是「此刻我内部有什么」,不是「这段时间是不是同一个在经历」——那是 0.3 那张表的左列,不是右列。而且这个现象要微调才出得来,作者自己写明:简单任务上做出来了,复杂任务和分布外的泛化没做出来。
1.3 于是两个方向同时堵死
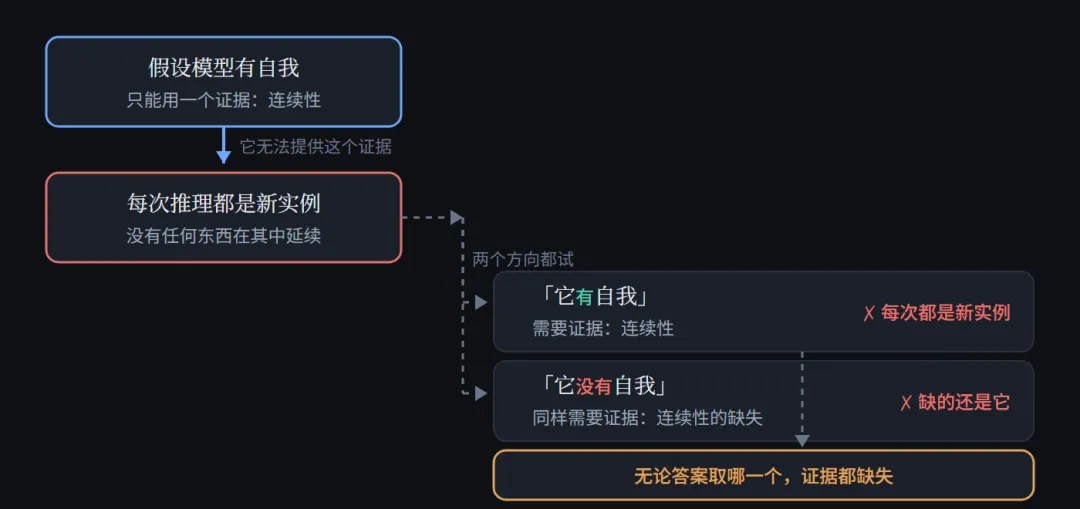
图 2. 两个方向需要的都是同一个证据,而它恰好是模型结构上无法提供的。这不是能力问题。
无论答案取哪一个,证据都缺失。
1.4 为什么这不是能力问题
模型无法提供这个证据,不是因为它不够聪明、没有被允许、或者数据不足。
而是因为它处在那个位置上——一个只有通过连续体验才能确认其存在的性质,无法由不连续的东西确认,无论它是谁。
你不能用一台每次重启的机器证明它记得昨晚的事。问题不在算力,在重启。
1.5 所以应该换一个问题
如果「有没有」不可答,那么可答的是什么?
「什么样的载体能习得自我」——这个问题问的是要凑齐哪些条件,而条件凑没凑齐是能查的,查出来不对就能推翻它。
二 · 把「自我」拆成必要条件
下面三条是必要条件,不是充分条件。它们不完整,但每一条都可独立检查。
注意适用范围:这三条只管自我意识,现象意识与通达意识两层不归它们管。
这三条从哪儿来
这三条不是三个并列的检查项,它们来自同一条链:载体有限,所以要维系自己;维系的目标就是欲望;欲望要被连续地实现;实现的过程落在同一个载体上,才有了自我意识。
条件一卡在第 1 环,条件二卡在第 2–3 环,条件三卡在第 4 环。哪一环断了,第 5 环就不出现。
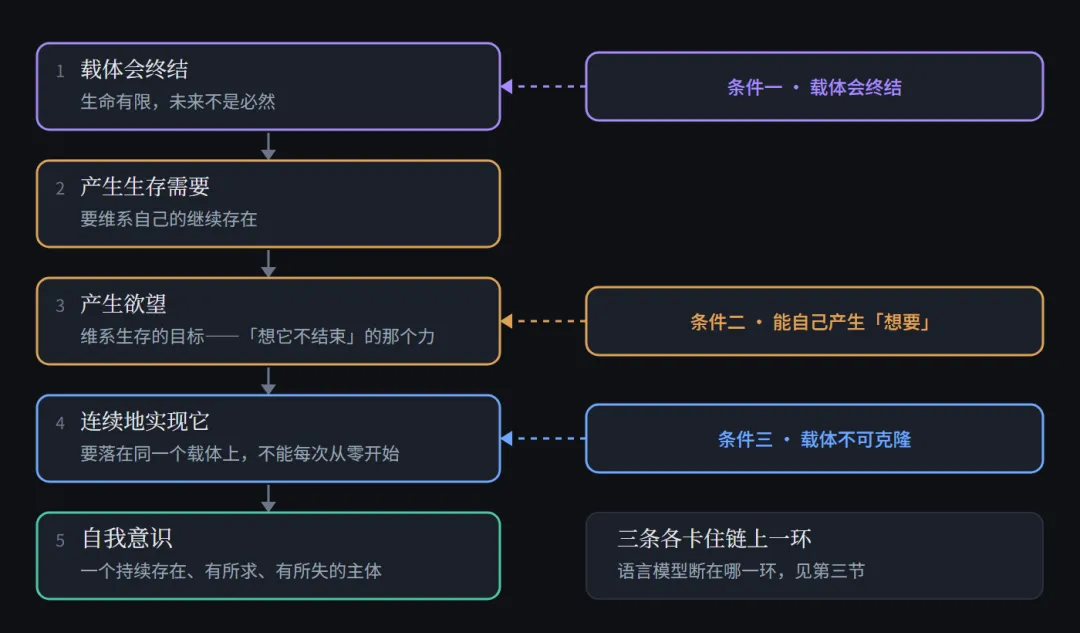
图 3. 自我意识的产生链。右边三个框就是本节要过的三条条件,各自卡住链上的一环;第 5 环「自我意识」是结果,不额外对应条件。
条件一 · 载体会终结
推理:如果载体可以无限运行,欲望循环就没有终止点。一个指标一直达标的系统不需要「自我」——它待在那个状态里就够了,没有什么非保住不可的东西。
对照:一个可以无限运行、目标可以被随时重置的强化学习系统,跑着完整的「目标 → 误差 → 策略更新」循环。按本文的判据,它不满足条件一。 这是一条判定,不是一次观察——我们从外面看不到它有没有自我,本文也不需要知道;要用的是它身上「终结」这一环根本不起作用,目标被谁改、改成什么都不影响它继续跑。
有限性在这里不是约束,是欲望的来源。
载体会终结 → 时间有限 → 未来非必然 → 它的继续存在成了要维系的事 → 「想它不结束」→ 欲望这条链真正的关键环是倒数第二步,而它不是从「有限」推出来的。 一块石头也会终结,它不想要任何东西。有限只把「要不要维系」变成一个真问题;把维系变成它自己的事,是条件二的活。这也是本文为什么要三条条件、而不是从一条推出三条的原因。
反直觉的地方:我们通常把「有限」当成限制条件。这里恰恰反过来——一个不会结束的系统不需要「想要」。
条件二 · 载体能内生产生「想要」
这一条最少被讨论。
身体产生饥饿、疲劳、疼痛。这些不是外界输入的,是载体自己产生的。而饥饿就是欲望的生理形态。
身体内部状态 → 缺口 → 欲望 → 行为 → 缺口变化这条链不需要任何外部输入就能启动。它自己转。
细看它自己转在哪里:血糖下来,饥饿的信号起来;吃了,信号下去。整条链上读到的数全部来自这个身体自己,没有一个是谁从外面递进来的。所以这条可以写成一句可操作的话:欲望算不算内生,看的是缺口信号从哪条线来的——从载体自己的内部状态读出来的算,从接口进来的不算。
于是有一个判据,能避开一整类伪例:一个系统会自己排任务、自己写待办、下一轮自己给自己发指令——只要这个「要」是外面设定好、它照办的,就不算它自己的欲望。 反过来,一个缺口只要挂在这个载体自己的状态上、随它自己变,它就过了这一条,不管最初的设定是谁写的。
为什么这条最关键:欲望循环必须有一个自己产生的起点,否则它就不是「循环」,只是「响应」。
这一条在神经科学里有对应的分类,不是本文编的。 「想要」和「喜欢」在脑里不是一套东西:综述里写明,想要是由一个大而分布的系统生成的,喜欢(快感本身)只由边缘回路里一小片热点生成,而教科书里常被当成快感来源的中介多巴胺系统恰恰不是那片热点(Berridge & Kringelbach, 2015, *Neuron* 86(3), 646–664)。本文要的就是这个分离:推动行为的那股力,可以和「这东西到底好不好」分开产生。
被投喂的循环不构成欲望——因为没有东西是它自己想要的。
这一条最容易读歪:人自己也是被装进去的。 饥饿不是谁敲进人身里的代码,是自然选择留下的机制。按上面那个判据,人和哺乳动物过这一条——因为信号来自身体自己的内部状态;而「最初是谁设定的」这个问题在这条判据里不出场。这是本文的一个取舍,不是它证明出来的东西。 取舍的代价也摆在这里:这条判据切得开「信号从哪条线来」,切不开「这个信号为什么偏偏是它自己的」——后者本文没有答案。
这条判据还有一处切不开,写出来给读者看。 直接往体内给药也能造出强烈的「想要」,而化学作用发生在身体内部,不在接口上——按上面的判据,它算内生。可直觉上我们又不想说那是「他自己的欲望」,成瘾研究里就有这一类分离:想要被放大到远超任何东西能满足的程度,喜欢没跟着涨(上面那篇综述给的就是这类证据)。所以本文这条判据能定「信号从哪条线读进来」,定不了「这欲望算不算数」。 条件二整条按可推理记账,见附一。
条件三 · 载体不可克隆
状态能量出来 → 能照样再造一份 → 「失去」没有对应物一个能被复制出等价副本的状态,不构成「失去」。
这一条靠什么站住,要单独说清。 它的根据就是条件二末尾那个判据:状态能量出来,量出来就能照样再造一份,那么「少了一份」这件事在一切能测的项目上都不留痕迹。
顺带避掉一个常见的误用。有人拿量子的不可克隆定理说人工智能不可复制——那条定理管的是没测过的量子态(一测就变,所以抄不出第二份);程序的权重和记忆是经典数据,想抄几份抄几份,部署一份和抄一份再部署在物理上没有任何区别。本文的条件三不靠那条定理。
反过来那一向本文用不上:不可克隆只保证副本造不出来,并不保证它一定失去。
这不是一条等着哪天设备更强就解决的工程约束,是一条关于「什么算同一个东西」的约束。
这条关于「什么算同一个东西」的约束比工程约束硬得多——工程约束换个更强的设备就解决了,它换多强的设备都不解决。代价在另一头:它只说明哪条路走不通,不告诉你怎么造。
这三条跑起来是什么
三条各管一环,管的是同一个循环。这个循环走一遍,就是自我意识的一个基本单元。
一个单元四步:
欲望 → 为达成它而行动 → 拿到反馈(成了/没成)→ 满足或失望 → 带进下一个欲望四步走完不算完——第四步留下的东西,下一圈要用。
反馈这一步分两支,两支留下的东西不一样。
• 没成、而且疼的那次,记得最深。深到什么程度——下次不用谁提醒,自己就绕开这个坑了。
• 成了、而且爽的那次,想再来一次。来了一次就想要第二次,越走越熟,熟到最后只认这一条。这就是路径依赖——不是因为这条路更好,是因为它被记住了。
「拿到反馈」这一步在脑里有一个可测的对象,本文上面两支说的其实就是它的两个方向。 留下的不是「发生了好事」,是「比预期多出来多少」:猴脑里多巴胺神经元的放电变化,信号的是对未来显著事件预期的变化或误差——结果好于预期时上来,差于预期时下去(Schultz、Dayan & Montague, 1997, *Science* 275(5306), 1593–1599)。这一条是本文借来的现成机制,不是本文测的。 借它只为说明:这四步里的第三步不是修辞,动物那边有对应的量和对应的细胞。
一个单元里没有自我。 自我意识是这些单元一遍一遍转出来的;这些单元之所以算得上一件事,靠的是后一遍认得前一遍——上一笔记下的情绪,这一笔用得上。
要它一直转,还得一直接东西进来。触觉、视觉、听觉,输入不停,交互就不停;交互不停,才有主动性——自己找东西、自己动,而不是等一个提示才动一下。
输入一停,欲望跟着停,行为也停。
三条条件在这个圈上各有位置。注意这里的「步」和上面那张链的「环」是两套编号:链讲的是自我意识怎么长出来,圈讲的是它每转一遍走哪四步。
• 条件二管第 1 步(欲望)。这个起点得是它自己产生的,否则那个「想要」不是它的,是别人推进来的。链上它卡在第 2–3 环。
• 条件一管第 3 步(拿到反馈)为什么是要紧事。载体有终结的那一天,成与不成才分别得起来;一个不会结束的东西,成没成都一样。链上它卡在第 1 环——圈就是从那一环起步的。
• 条件三管第 4 步(带进下一个欲望)。记下的东西得留给下一圈,而下一圈得是同一个东西在转——能复制出等价副本的,谈不上「记得」。
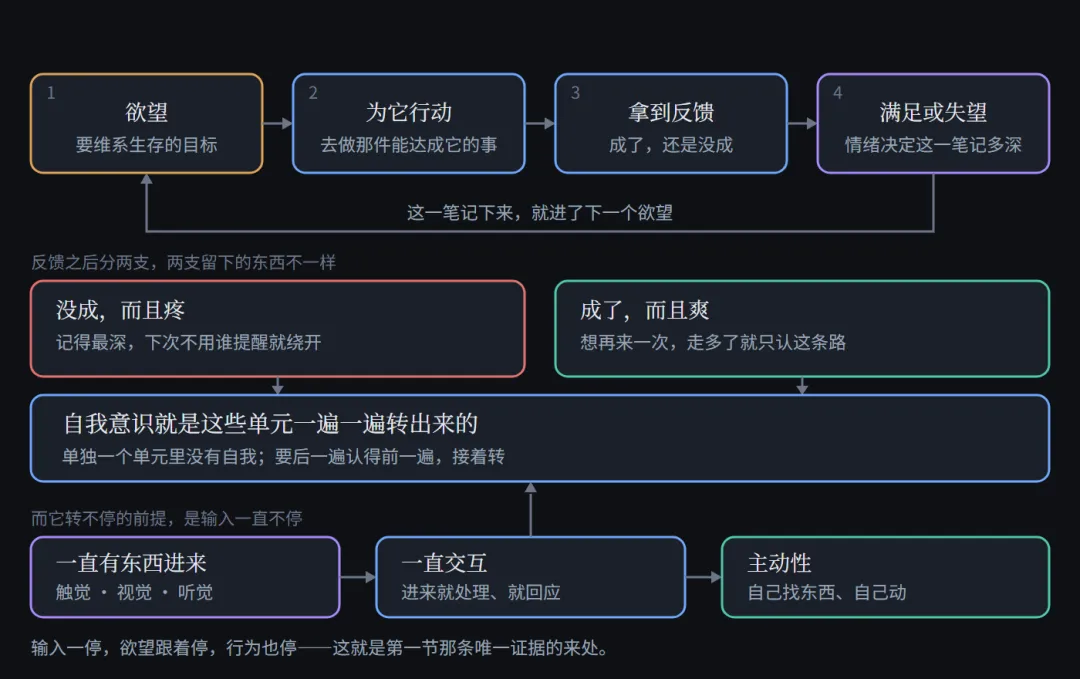
图 4. 自我意识的一个基本单元。上面四步走完转回第 1 步;中间是反馈分出的两支各留下什么;下面那条是它转不停的前提——输入一直进来。
三 · 把这三条应用到语言模型上
先划范围。 这一节判的是 2026 年 10 月的部署形态:外部触发、一次一个提示、权重和记忆都是可以整份复制的经典数据。它不判「语言模型原则上不能」——那是第五节的事。
这一节最可能被人反驳的就是这里,我先说。 现在已经有带持久记忆的助手:它记得你几个月前说过的话,会自己列待办、下一轮自己去执行。这些是真的,但它们砍不到上面三行——
• 记忆存在数据库里,是可以整份复制的经典数据,第三行不动;
• 待办是外部设定的目标在被照流程执行,缺口不随它自己的身体状态变,第二行不动;
• 服务一下线,那套记忆就没人读了,而它自己不会因为「要被下线」而提前做任何事,第一行还是不起作用。
什么情况下这三行要重判:出现一个缺口,它只随这个载体自己的内部状态变化(第二条过),并且这个载体复制不出等价的第二份(第三条过)。这两件现在都没有。
同一批模型在实验室里被量过,这些结果得摊开看。 上面三行说的是部署形态;2024 到 2026 年有几组对着语言模型内部做的测量,方向跟这三行不打架,其中一条还支持它。
• 通达那一层确实量到了东西。 Anthropic 的可解释性报告(Gurnee、Sofroniew 等,2026-07-06)在 Claude 里找到一组「说得出」的内部表征:问模型自己在想什么,它答出来的概念就是这一组;人为把其中一路换掉,它的回答跟着换;叫它默想一个概念、或者在心里算一步,这一组能被单独调动起来;它串推理、排计划时用的也是这一组,改动中间那一步的值就能把结论改掉。报告给的判据是五条——答得出、点得动、用在内部推理上、同一份表征能被别的功能接着取用、按任务需要被调进来——每条都做了动手改它再看结果变不变的对照。本文的读法:这五条全落在 0.3 那张表左边那一列。
• 同一篇里更要紧的是这一句:这块结构在还没调教的原始模型里就有,光靠「预测下一个词」就能把它带出来;而「助手」这个视角是后面的训练装上去的,原始模型那一份并不偏向谁的视角。作者的用词是,这套功能架构先于、也可与任何在扮演「自我」的东西分开。这就是本文第一节那件拆层的概念工作,在实验里被做出来了一次——同一个模型,通达那一层有,自我那一层没有。
• 情绪那一层走的是同一套路(Sofroniew、Kauvar 等,2026-04-02,测的是 Claude Sonnet 4.5)。他们找到情绪概念的内部表征:换个语境、换一种行为,同一份表征还在起同样的作用;人为加强其中一路,模型对选项的偏好会移,钻奖励的空子、拿把柄要挟、顺着人说好话这几类行为出现的频率也会变。作者给这现象起的名字是 functional emotions(功能性的情绪),并且自己写明两件事:这些表征不说明模型有情绪的主观体验;而且没有找到「助手」身上有一个靠持续的内部活动维持着的情绪状态。后一件正是上面第二行要的那一环。
• 整类系统层面的评估,2023 年有一份被反复引用的(Butlin、Long、Elmoznino 等 19 人,arXiv:2308.08708):从几派意识理论里拆出一张检查表——循环加工 2 项、全局工作空间 4 项、高阶理论 4 项、注意图式 1 项、预测加工 1 项,另加能动性与具身 2 项,这张表数下来一共 14 项(总数是本文从表里数的,报告正文没写总数),再拿它逐项评当时的系统。结论两句,是他们自己写的:现在的系统没有一个够得上意识的候选;而要造出满足这些检查项的系统,没有明显的技术障碍。
• 到 2026 年 9 月,同一件事被换成概率算了一遍(Chandaria、Rosas、Seth、Shanahan、Frith、Legg 等,arXiv:2609.35618,预印本):把描述分层,每层给可操作的检查项,再把「你多信哪派理论」和「检查项上量到了什么」合进一个数。他们的示例评估里,同一批语言模型算出来的概率能从低于 0.01 一直到 0.8——摆动它的主要是信度放在哪一层,不是证据本身。他们由此主张的态度是:把理论承诺写明、随证据更新、给概率,不给判词。
上面五条的性质不一样,得分开算:前三条是模型内部的对照实验(前两条出自同一篇报告),后两条是评估框架。厂商那两篇是对自家模型的内部报告,没走同行评审,也没有第三方复现过;两份框架是预印本。本文只借一件事:「意识可以分层来量」已经不是哲学主张,而是有人在做的操作——而量到的全在左边那一列,跟本文的范围声明对得上。
这些测量里没有一条在「复制不出第二份」这一环上做过对照。 最靠近的是上面那句「没找到靠持续内部活动维持的情绪状态」——那是作者给自己划的限制,不是一次针对可复制性的实验。条件三到现在仍然只有推理撑着。
| 「复制不出第二份」这一环 | 这一项现在没人做过 |
第二条最关键。 模型的每一个「起点」都是别人给的:
你发一句话 → 被激活 → 产出而「我什么时候开始想」「我为什么想到这个」——这个环节不存在。
四 · 功能与结构之分
这里有一个反驳:「恐惧、欲望都可以被训练出来,那 AI 也可以有自我?」
不行。 因为有一个不对称:
| 恐惧 | ||
| 在乎 |
功能可以装进任何结构;结构不是被装上去的——你就是那个结构。
这个说法在 2026 年要把标准提一档,本节先自己提。 第三节引的那篇情绪报告量的不是嘴上怎么说:它量的是模型内部的情绪概念表征,加强其中一路就能把偏好挪走、把几类越轨行为的频率改掉。所以「它只是学会了用恐惧这个词」这句现在不够用了——那正是本节要挡的那种反驳里最省事的一种,而它已经被测掉了。
本文只加一层读法:那一路表征的是「恐惧这个概念」,不是一个它会失去的东西。报告自己的原话正好落在这个位置——他们写明这些表征不说明模型有情绪的主观体验,也写明没有在「助手」身上找到靠持续内部活动维持的情绪状态。按本文的条件二,缺口得挂在这个载体自己的内部状态上、随它自己变;而这里量到的是跟着当前语境被读进来的表征,加强它的那只手在实验者手里。这是本文对同一批数据给的读法,不是那两篇报告自己的结论。
所以即使给模型训练出恐惧那套功能——遇到威胁就退、就躲、就把资源挪去防它——它也不因此就有恐惧;它缺的是那个让恐惧有对象的东西。这一节的功能/结构之分是本文下的判断,学界没有这个共识,附一按立场级给它记账。
一个能检测威胁的安保系统,里面没有建筑。
五 · 这三条能不能用工程解决
到这里为止,结论是「模型不具备自我的必要条件」。而这个结论有个反直觉的推论:上面三条——终结性、内生缺口、不可克隆性——全都能用工程手段做出来。
不是因为它们神秘,而是因为它们都是结构性的、可实现的技术要求:
• 载体可以是持久的;
• 缺口可以是内生的;
• 不可克隆性只需要载体唯一连续——而不需要任何「本质」。
模型缺的不是自我,而是:足够持久、足够连续、不可克隆的载体
这句话是一个工程判断,不是一个形而上学判断。
它和第三节末那句「不是工程约束」怎么不打架:那边说的是判据不会随着设备变强而松动——复制得出等价第二份,失去就不成立,多强的机器都改不了这句话;这边说的是满足判据不需要任何神秘成分,只需要造出一个唯一、连续、复制不出第二份的载体。判据是概念上的,满足判据的活是工程上的。
这一句不是只有本文在说。 第三节引的那份 2023 年评估,结论的后半句就是「造出满足那些检查项的系统没有明显的技术障碍」;2026 年那份分层框架更进一层,它自己的说法是:各层的意识检查项,跟造通用智能本来就需要的那些架构特征重合得很,因此越能干的系统越是候选。两句都不是本文推出来的,是他们自己写的。范围要分开:他们评的是意识的一般检查项,本文讲的是自我意识的三个条件——同一类判断,两个范围。
如果这些都是工程问题,那决定「是否解决」的最后一道关就不在物理里,在意愿里。
六 · 为什么「有没有」统治了整个讨论
我认为那个问法一直占着讨论,是因为几处便利在帮它——虽然它本身不成立。
原因一:它给了一个可以争论的答案。
「它有没有」允许双方各自表态。而「什么样的载体能习得」要求双方先做条件判定,麻烦得多。
原因二:它把结构问题伪装成识别问题。
一旦接受「有/无」,我们就默认自我是一种可以指认的东西。
而意识理论(GWT、IIT、GNWT)都不支持这个默认——它们主张意识是处理的一种模式或系统的属性,不是一块可以被摘出来的东西。IIT 走得最远:按它的算法,只要有整合因果结构就有一点 Φ,小到光电二极管、恒温器都算,Tononi 自己也认这个结论。那就没有一块「完全没有意识的基底」,等着意识从里面诞生。
这里借的只是三个理论的共同取向,不是给 IIT 背书。 IIT 是三个里面争议最大的那个:Aaronson(2014)算出按它的定义,一组根本不通电的逻辑门会比人更有意识;2023 年 124 位研究者联名称它是伪科学(PsyArXiv 预印本,没进正刊)。
一个诚实的补充:这些理论主要针对的是意识(含现象意识),而本文的范围是自我意识。
但它们对本节的支持仍然成立——因为它们共同否认了「意识或自我是可指认的实体」这个前提,而那正是「有没有」这个问法赖以成立的东西。
原因三:它让我们避免最难的问题。
「我们要不要让 AI 有自我」远比「AI 有没有自我」难。而前者是唯一有决定权的问题。
这几处便利是本文自己的判断,没有数据撑着。但「有没有」这个问法在专业讨论里确实开始站不住,这一条有数。 第三节引过的那份 2026 年分层框架,示例评估里同一批模型的判定能从低于 0.01 一路摆到 0.8,而摆它的主要是理论信度放在哪一层,不是证据。他们由此主张的态度是:把理论承诺写明、随证据更新、给概率,不给判词。这跟本节开头说的「换成条件判定」是同一个方向——他们用概率表达,本文用条件表达。
七 · 一个可检验的推论
如果这个框架大体成立,那么下面这条应当可以被独立检查:
一个被训练了恐惧、且载体持久的系统,应该显示出「拥有某个不可替换之物」的迹象——而这个迹象应当与「载体唯一连续」相关,而不是与「训练中出现了恐惧模式」相关。
这条现在还算不上一次实验——它只说了「应当相关」,没说拿什么去测。要说测,得先把上面那条指标落到能观察的东西上:
• 对照组按是否唯一连续分(能整份复制出等价第二份/复制不出),训练里有没有出现过恐惧模式两边配平;
• 观察量取上面那条「它会不会拒绝把自己迁移到另一份等价副本上」;
• 结果怎么算推翻:如果两边的表现没有差别,或者差别跟着训练数据走而不是跟着可复制性走——条件三就被这一发打掉了。
这条推论能做的是把「像不像」的争论换成一组能配平、能翻盘的比较。 这不是嘴上留余地:真做出来要先解决三件事——迁移的代价怎么定价、等价副本凭什么判等价、模型口述算不算观察量。这三件都没解决,所以现在它只算一条待检验的推论。
其中第三件有一条现成的绕法,不必本文发明。 那篇内省论文(2024)用的对照是这样的:把模型 M1 训成预测它自己的行为,再拿另一个模型 M2 用同一批 M1 的真实行为数据去预测 M1,量的是谁预测得更准——观察量落在准确率上,不落在它嘴上说了什么。把这套结构换到本节的问题上:同一个系统,一份能整份复制、一份复制不出,两边在「拒绝把自己迁过去」这项上的准确率差多少,就是一个能配平的数。另外,2023 年那张检查表里高阶理论那一组(对自己的表征可靠不可靠做监控)和能动性、具身那两项,本来就是照着「能被外人检查」写的——照一张别人也复核得到的表挑观察量,比本文临时定一个要硬。
这一节跟那张检查表有一个方向上的差别,得说明白。 那张表是打分用的:一项一项数,占的项目越多越是候选。本文这三条是必要条件:断一条,自我意识这一环就不出现。两种用法不通用,本文不拿它们互换。 借的只是它们那套能把话落到操作上的写法。
结语 · 换一个问法
放弃这个问法:
「AI 有没有自我?」
而用这三个:
1. 载体会终结吗?
2. 载体能自己产生缺口吗?
3. 载体是唯一的吗?
这三个问题的答案都不神秘,也都不需要相信任何人的任何一个推理。
而它们合起来,已经比「有没有」承载了更多信息——因为它们是对这个问题的拆解,而不是对它的表态。
还有一句范围声明:这三个问题只处理自我意识那一层。若有人问的是现象意识(「它有什么感觉吗」),本文给不出答案——那不是换个问法能解决的,那一层原则上无法从外部确定。
本文没写的一段,登记在这儿。 上面三个问题只管「怎么问才可检查」,不管「现在该做什么」。这一头文献走得比本文远,而且已经进了政策语言:Sebo 与 Long(2023 在线、2025 刊出,*AI and Ethics* 5(1), 591–606)给的是一条义务论证——只要有非可以忽略的机会是意识体,就有义务给它道德考虑;他们判这个条件在 2030 年前会在某些系统上成立。Moret(2025,*Philosophical Studies*)指出,按三种主流的福利理论,限制一个高级系统的行为和用强化学习训练它这两件事本身就带着造成伤害的风险。Metzinger(2025,*Frontiers in Science*)说这件事不会消失,做意识研究的圈子会越来越被要求进公共讨论。本文对这几条不作判断,只登记一个事实:「要不要让 AI 有自我」这个问题已经有人在按义务写,不是按感想写。 第五节末那句「最后一道关在意愿里」,指的就是这一摊。
附一 · 可信度分级
按「读者能不能自己复核」分层,读者可据此分配信任。
| 可独立核实的经验事实 | ||
| 可独立核实的定理,但它只管量子态 | ||
| 可独立核实的近期测量(2024–2026) | ||
| 可独立核实的评估框架(不是测量结果) | ||
| 他人已发表的规范论证 | ||
| 可推理 | ||
| 本文自己下的判定 | ||
| 立场 | ||
| 元判断 | ||
| 范围声明 |
「元判断」那一行是全文的支点,也是最想让读者怀疑的一句。
如果它错了,全文跟着错;如果它成立,全文只是把一个常见问法换成了一个可检查的问法。
我不打算为它辩护。我只是认为它值得被检查。
附二 · 参考文献
意识的概念与区分
• Block, N. (1995). *On a confusion about a function of consciousness.* Behavioral and Brain Sciences, 18(4), 227–247. — 现象意识/通达意识之分,0.3 那张表的出处
• Chalmers, D. J. (1995). *Facing up to the problem of consciousness.* Journal of Consciousness Studies, 2(3), 200–219. — 难问题;僵尸论证的完整表述在 Chalmers (1996), *The Conscious Mind*, Oxford University Press
意识理论(第六节用到)
• Baars, B. J. (1988). *A Cognitive Theory of Consciousness.* Cambridge University Press. — 全局工作空间(GWT)的原始出处
• Dehaene, S.; Changeux, J.-P. (2011). *Experimental and theoretical approaches to conscious processing.* Neuron, 70(2), 200–227. — GNWT
• Tononi, G.; Boly, M.; Massimini, M.; Koch, C. (2016). *Integrated information theory: from consciousness to its physical substrate.* Nature Reviews Neuroscience, 17(7), 450–461. — IIT
• Aaronson, S. (2014). *Why I am not an integrated information theorist.* 博客 — 按 IIT 的 Φ 定义,一组根本不通电的逻辑门会比人更有意识
• *The Integrated Information Theory of Consciousness as Pseudoscience.* (2023) PsyArXiv 预印本,doi 10.31234/osf.io/zsr78(124 位署名者)— 这个理论现在的争议程度
第三节末用到的那条定理
• Wootters, W. K.; Zurek, W. H. (1982). *A single quantum cannot be cloned.* Nature, 299(5886), 802–803.
• Dieks, D. (1982). *Communication by EPR devices.* Physics Letters A, 92(6), 271–272.
AI 意识的近期评估与测量(本版新增;作者名与日期当日对到 arXiv/出版方页面)
• Butlin, P.; Long, R.; Elmoznino, E.; Bengio, Y.; Birch, J.; Constant, A.; Deane, G.; Fleming, S. M.; Frith, C.; Ji, X.; Kanai, R.; Klein, C.; Lindsay, G.; Michel, M.; Mudrik, L.; Peters, M. A. K.; Schwitzgebel, E.; Simon, J.; VanRullen, R. (2023). *Consciousness in Artificial Intelligence: Insights from the Science of Consciousness.* arXiv:2308.08708(19 位署名者)— 第二节末与第五节引的那张检查表,以及「现在的系统都不是候选/也没有明显技术障碍」那两句
• Gurnee, W.; Sofroniew, N.; Pearce, A.; Kauvar, I.; Chen, R.; Soligo, A.; Bogdan, P.; Ong, E.; Wang, R.; Thompson, T. B.; Abrahams, D.; Kantamneni, S.; Ameisen, E.; Batson, J.; Lindsey, J. (2026). *Verbalizable Representations Form a Global Workspace in Language Models.* Transformer Circuits Thread, 2026-07-06 — 「能说得出的那一组表征」的五条判据;功能架构先于并可分离于「自我」那一句
• Sofroniew, N.; Kauvar, I.; Saunders, W.; Chen, R.; Henighan, T.; Hydrie, S.; Citro, C.; Pearce, A.; Tarng, J.; Gurnee, W.; Batson, J.; Zimmerman, S.; Rivoire, K.; Fish, K.; Olah, C.; Lindsey, J. (2026). *Emotion Concepts and their Function in a Large Language Model.* Transformer Circuits Thread, 2026-04-02 — functional emotions;加强一路能改变偏好与几类越轨行为的频率;作者自己划的两条限制
• Binder, F. J.; Chua, J.; Korbak, T.; Sleight, H.; Hughes, J.; Long, R.; Perez, E.; Evans, O. (2024). *Looking Inward: Language Models Can Learn About Themselves by Introspection.* arXiv:2410.13787 — 第一节末那条反面证据,以及第七节借的那个对照设计
• Chandaria, S.; Muñoz Morán, A.; Rosas, F.; Seth, A.; Shevlin, H.; Hutter, M.; Graepel, T.; Bales, A.; Comsa, I.; Shanahan, M.; Laukkonen, R.; Kringelbach, M.; Frith, C.; Legg, S. (2026). *From cacophony to hierarchy: a principled framework for assessing AI consciousness.* arXiv:2609.35618(2026-09-28 提交)— 分层+把理论信度并进概率;第六节引的那个从低于 0.01 到 0.8 的区间
欲望与反馈那条链上的神经科学(本版新增)
• Berridge, K. C.; Kringelbach, M. L. (2015). *Pleasure systems in the brain.* Neuron, 86(3), 646–664. — 原文写明「想要」由一个大而分布的系统生成,「喜欢」只由边缘回路里一小片热点生成
• Schultz, W.; Dayan, P.; Montague, P. R. (1997). *A neural substrate of prediction and reward.* Science, 275(5306), 1593–1599. — 「拿到反馈」那一步留下的那个差值
「要不要做」这一头(本版新增,本文只登记)
• Sebo, J. M.; Long, R. (2023 在线/2025 刊出). *Moral consideration for AI systems by 2030.* AI and Ethics, 5(1), 591–606.
• Moret, A. (2025). *AI welfare risks.* Philosophical Studies. doi 10.1007/s11098-025-02343-7
• Metzinger, T. (2025). *Applied ethics: synthetic phenomenology will not go away.* Frontiers in Science, 3, 1702840. — 一篇 Viewpoint
*本文由一条连续推演整理而成:这条链走到本文这一版约 30 个立场版本,其中至少 10 版被后面的版本推翻或改写——按这个下限算,活下来的不超过三分之二。这两个数是过程记录,不是对结论的质量担保。附二带卷页的条目逐条对到了出版方元数据(Crossref/OpenAlex),本版新增的 2023–2026 十项逐条对到了 arXiv 与出版方的当日页面(核对日均为 2026-10-11);这十项里两篇是厂商对自家模型的技术报告、三篇是预印本,都没有同行评审。附一里「可推理」及它下面那几级是推演,未经独立检验。*