ARTICLE · 1182757
TokenRouter 源码精读:异步三循环加延迟组批,token 级模型路由的吞吐如何提高 2 到 64 倍
TokenRouter 源码精读:异步三循环加延迟组批,token 级模型路由的吞吐如何提高 2 到 64 倍同样的请求,小模型写容易的 token、大模型只在难处接手——这套 token 级路由的算法论文这两年出了不少,可真要把它跑进生产,现有的 vLLM、SGLang 都接不住:每一步解码都可能换模型,单模型 serving 的假设全被打破。清华 NICS 团队(Tianyu Fu、Yu Wang 等)的 TokenRouter 把这件事从算法层捞到了系统层,基于 SGLang 改出了一套支持 token 级路由的 serving 栈,论文被 NeurIPS 2026 接收,仓库上周还在更新。这篇把它的三个系统设计和代码逐一对上。 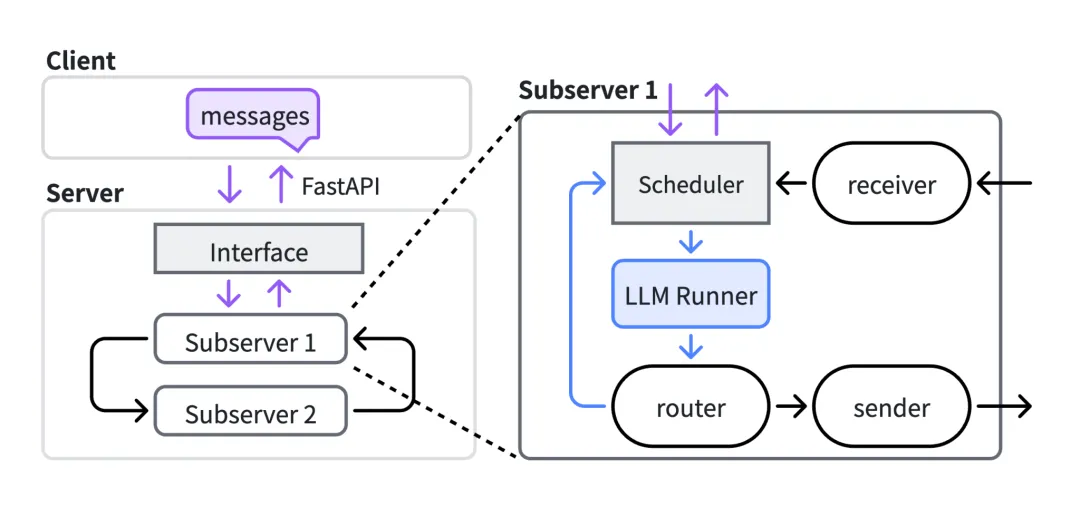
TokenRouter 是一个 token 级 LLM 路由的 serving 系统:对外一个 OpenAI 兼容端点,对内每个候选模型各跑一个自治 subserver。开发者用三个函数描述路由算法——`route()` 决定下一个 token 交给谁、`send()` 打包请求状态转移、`receive()` 决定怎么收 token——剩下的事情系统全包。 解决的问题是三个:不同模型每步延迟差得远,同步推进全体等最慢的(步失同步);换模型太频繁,请求到达时目标模型往往正忙,进不了批(批准入延迟);现有 serving 系统没有逐 token 路由的编程接口,改起来要动大半个代码库。 结果(论文表 2,并发 4、原设定):五种路由算法上,吞吐比各家的官方实现高2.73 到 21.97 倍,端到端延迟降2.78 到 21.61 倍;跟作者自建的 Std. Serving 基线比,15 个算法-负载组合里吞吐高2.01 到 64.15 倍。CITER 算法最夸张:官方实现 17.16 token/s,TokenRouter 跑到149.31 token/s。 只看一处该看哪个文件:`tokenrouter/managers/schedulers/base_scheduler.py` 里的 `_get_delayed_batching_threshold()`——延迟组批的门槛 B 从这取,这是全文吞吐差距最大的一处来源。 查询级路由已经是生产标配:ChatGPT、Cursor 按难度把整条请求分给不同模型,学术圈的 RouteLLM 也证明了这条路省成本。但一条请求一旦路由出去,整段回复就锁死在一个模型上。 token 级路由更细:生成过程中每一步都可以换模型。论文引 R2R 的数字——只把5%的 token 路由给 32B 模型、其余交给 1.5B 解码,就能对齐 32B 的质量;对比之下查询级路由得把约 40% 的请求整个送给 32B。质量侧也有收益,让互补的模型在一段回复里接力,能超过任何单一模型。 算法漂亮,系统遭殃。SGLang、vLLM 的持续批处理假设"一批请求齐步走",token 级路由把三条假设全部打破:第一,步失同步——32B 一步的耗时是 0.6B 的好几倍,同步等于让快模型全程空转;第二,批准入延迟——请求频繁换目标,到的时候对方模型往往正在解上一批,只能干等,批被切得稀碎;第三,实现复杂——路由逻辑要跟持续批处理、前缀缓存这些紧耦合的功能缠在一起改。 论文图 4 给了个具体例子:异步但不做组批时,请求 3 的第 3 个 token 从 t=2 等到 t=4.5 才能进批。频率一高,GPU 大量时间在解碎批。 主线一句话:请求为中心编程,模型为中心执行。开发者只描述一条请求怎么在几个模型间流动;每个模型一个自治 subserver,自带调度器、模型执行器和私有 KV 缓存池,相互之间用 peer request 通信,谁也不等谁。 设计一:解耦三循环。标准 serving 系统有两个异步循环——client-server 循环管请求接入与流式返回,decoding 循环管调度与模型执行。TokenRouter 加了第三个解耦的 inter-model 循环:被路由走的请求离开本地批,peer 请求回来时直接续上,本地的其他请求照常按自己的节奏跑。模型间彻底异步。对外只剩一个端点,客户端协议跟 vLLM、SGLang 单模型服务完全一样,多少个模型在后面参与路由,调用方无感——这让它能直接替换单模型服务上线。 设计二:pending 状态与延迟组批。跨模型交接如果当新请求处理,回来要重做前缀匹配、重分配 KV,纯浪费。TokenRouter 在 running 和 finished 之间加了个 pending:交接时请求标成 pending,调度器跳过它但服务状态原样保留;回来时按 peer 输出置回 running 或 finished,新 token 追加上就当没离开过。配上延迟组批——subserver 不来一个解一个,攒够同模型的 B 个请求再开一个批,批大了、次数少了,平均准入延迟反而降。 一个必要公式(附录 D 的吞吐模型,改写成文字):给定并发数 N、路由转移概率 P、各模型每步延迟 L_i,把路由过程建成离散时间马尔可夫链,吞吐是组批门槛 B 的函数,取使吞吐最大的 B*。三个量:N 是在途请求数,P 是"下一个 token 去哪个模型"的转移概率(比如 R2R 下大模型被路由概率约 5%),B 是攒批门槛。B 太小,准入延迟吃掉吞吐;B 太大,请求在队列里发霉,小模型饿死。 `route/send/receive` 三个接口就是照着这个生命周期设计的,五种算法各写各的,系统代码一行不用改。 调用链从入口到推理:`tokenrouter/launch_server.py` 或 `tokenrouter/entrypoints/http_server.py` 起 OpenAI 兼容服务 → `managers/tokenizer_manager` 收请求 → 各算法自己的调度器(`managers/schedulers/` 下 `citer_slm_scheduler`、`r2r_slm_scheduler`、`collm_base_scheduler`、`rstitch_slm_scheduler` 等)→ `model_executor/model_runner.py` 执行。 分支先分清:`tokenrouter` 是从 SGLang 抽出来的独立包,`sglang_hidden_states_patch.py`、`sglang_launch_server_patched.py` 是对宿主 SGLang 的补丁文件;`config/` 下每个算法一个 yaml(citer、collm、me、query_level、r2r、rstitch),算法超参全在配置里,跟论文表 4 一一对应。 实现一:route() 逐 token 决策。论文 §3.2 说 route 接口拿模型中间特征做路由判断。代码在 `tokenrouter/managers/schedulers/citer_slm_scheduler.py` 第 49 行起: ```python hidden_states = result.logits_output.hidden_states[hidden_indices, :][:, None, :] return self.citer_router(hidden_states).cpu() ``` 对应关系:prefill 阶段用 `extend_lens` 的累加和取每个请求最后一个 token 的隐状态,decode 阶段用顺序下标——`hidden_indices` 的两套取法正对应论文说的"接口在每步解码后可用";`self.citer_router` 是 CITER 训练出来的轻量路由头,阈值 τ=0.98 不在代码里写死,放在 `config/citer/Qwen3-0.6B_Qwen3-32B.yaml`。紧跟着的 `send()` 把请求打包成 `PeerReq`,就是论文里"转移请求状态"的实拍: ```python req_to_send = PeerReq.construct_from_req( req=req, source=self.server_args.server_name, destination=destination, current_token_ids=current_token_ids, entry_model=self.server_args.entry_model_name, handoff_seq=req.handoff_seq, ) ``` 打包内容逐字段对得上:目标模型名就是路由结果 `destination`,`current_token_ids` 把已生成的 token 带走,`entry_model` 记住这条请求从哪个模型进来(最后要从它流式返回),`handoff_seq` 是后面要用的交接序号。 实现二:延迟组批门槛。论文 §4.3 说攒到 B 再开批。代码在 `base_scheduler.py` 的 decode 路径(约 1208 行): ```python min_batch_size = self._get_delayed_batching_threshold() ... if n_need_reqs >= min_batch_size: self.running_batch = self.update_running_batch(self.running_batch) ``` 对应关系:`_get_delayed_batching_threshold()` 从 `server_args.delayed_batching_threshold` 取值,这是个列表、按当前在途请求数索引,随负载自适应——附录 D 推导的 B* 在代码里以配置列表的形式落地;上游论文没细说的一处工程取舍是,检测到 peer 路由请求与本批有重叠时会放宽门槛(`_has_overlap_peer_routed_req`),避免死等。 再补一处:handoff_seq。论文 §4.2 的 pending 状态,代码里用交接序号实现:`send()` 传 `handoff_seq`,`base_scheduler.py` 里 `latest_handoff_seq` 字典记每个请求的最新序号、`_mark_terminal` 按序号大小判定终态,防止一次交接的旧消息把请求误标完成。pending 的"跳过但保留状态",落到调度器就是这几个字段。 硬件:8 张 A100-80G。两模型算法(CITER、R2R、R-Stitch、Co-LLM)在小模型 Qwen3-0.6B 与大模型 Qwen3-32B 之间路由,小模型占 1 卡、大模型 2 卡张量并行,两模型靠 CUDA MPS 共享这 2 张卡;ME 算法在 Qwen3-0.6B、8B、32B 三模型间路由,各占 1 卡。 算法超参照论文 §5.1 抄:CITER 训练了路由头、τ=0.98;R2R 用官方路由器和阈值;R-Stitch 的 τ=0.03;Co-LLM 微调了 Qwen3-0.6B、η=0.15;ME 集成权重 0.5、0.3、0.2。 三组负载拉开长短:低努力推理用 AIME2024(约 100 token 输入、最多 2048 输出);高努力推理同样 AIME2024 但只留 32B 解超过 8192 token 的题、输出上限 8192;智能体多轮用 SWE-Smith 轨迹(约 8192 输入、1024 输出)。 基线两个:各算法官方实现(Co-LLM 每模型一个 vLLM server 做持续批处理,CITER 和 R2R 的官方代码是不带持续批处理的推理引擎,R-Stitch 没放码);作者自建的 Std. Serving——每模型一个 SGLang server、外部调度器逐 token 转发。最影响可比性的条件:主表并发 4,吞吐按"输出 token 总数除以总时长"计,并发 1 到 16 的扩展在附录 A.1。 原设定对比(论文表 2,并发 4):R2R——TokenRouter244.56 token/s,官方实现 89.62,纯大模型 baseline 145.30;延迟 270.19 秒对 751.15 秒。CITER——149.31对 17.16,延迟 0.48 秒对 7.64 秒。Co-LLM——76.02 对 3.46。R-Stitch 官方无代码,TokenRouter 140.58,注意这条低于纯大模型的 150.41——R-Stitch 是质量导向算法,速度本来就不是它的目标,别把这一行读成"系统变慢"。 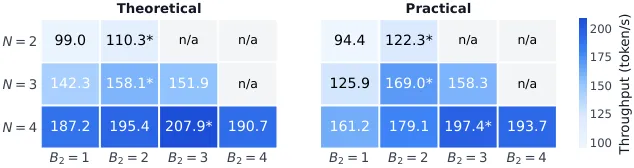
对 Std. Serving 的全面对比(图 5、6):15 个算法-负载组合,吞吐高2.01 到 64.15 倍,延迟降 2.03 到 63.64 倍。64.15 倍出现在 Co-LLM 官方实现这个低基线上,得拆开看——官方 Co-LLM 每模型一个 vLLM server、逐 token 外部转发,本身就是最慢的跑法;TokenRouter 对官方实现的提升区间是 2.73 到 21.97 倍,这个区间比单个最大值更能代表真实收益。 长输出的扩展性:输出上限从 2048 拉到 8192,TokenRouter 吞吐基本不掉,Std. Serving 掉58.1% 到 85.2%——原因在 pending 机制,交接不重做前缀匹配,序列越长省得越多。 并发扩展(图 1b):并发 1 到 16,TokenRouter 吞吐乘8.61 倍、保住 51.7% 的单用户速度;官方 R2R 只乘 5.14 倍、保住 31.3%。模型对消融(表 3,R2R 算法):0.6B 配 8B 提得最狠,336.98 对 105.1 token/s(3.21 倍);0.6B 配 32B 是 197.40 对 77.08(2.56 倍);4B 配 8B 只有 1.99 倍——两个模型速度越接近,异步执行的收益越小,这个梯度本身就在验证设计动机。 这些数字全部出自论文表 2、3 与图 1、5、6,我没有跑。 已对上的:三函数接口对调度器里的 `route/send/receive`;pending 状态对 `handoff_seq` 那套序号机制;延迟组批对 `_get_delayed_batching_threshold` 的列表配置;五种算法的 yaml 配置对论文 §5.1 的超参表。 实现比论文多出来的:`_has_overlap_peer_routed_req` 的门槛放宽、`deterministic_random.py`(评测用的确定性随机,保证可比)、`evaluation/calculate_delayed_batching.py`(单独验证组批收益的脚本)——附录 D 的数学模型在评测侧有自己的落点。 只是配置选择、别当成缺陷的:调度器代码里 citer 的 `threshold` 默认 0.5,论文实验用 τ=0.98;collm 的 `defer_threshold` 还带 warmup 时间表。代码默认值是占位,跑复现要按论文和 config yaml 设——两处不一致第一次跑很容易踩。 环境:Python 3.10 的 conda 环境,`pip install -e .`,两份模型(Qwen3-0.6B 与 Qwen3-32B)准备好;论文硬件是 8 张 A100-80G,显存够的单机双卡也能起服务,但吞吐数字没验证过。 最小样例:挑一个算法配置起服务,比如 `config/r2r/Qwen3-0.6B_Qwen3-32B.yaml`,入口在 `tokenrouter/launch_server.py`;拿 `examples/openai_chat_completion.py` 发一条 OpenAI 格式请求,回包应当正常流式吐 token。评测走 `evaluation/test_throughput.sh`,AIME 和 SWE-Smith 数据在 `evaluation/datasets/` 里自带。 成功标志:`evaluation/report.py` 出吞吐报告;日志里能看到各 subserver 独立推进、没有全局步屏障的等待记录。 容易看错的一个地方:`delayed_batching_threshold` 是列表不是常数,按在途请求数取段;以及别把 Std. Serving 基线跟官方实现混为一谈——一个是作者自建的公平参照,一个是各家算法仓库的原始跑法,表 2 里它们是两列。 有证据的价值:这是 token 级路由算法第一次跑在带持续批处理、前缀缓存的成熟 serving 栈上,吞吐差距不是百分之几,是数量级;三个函数的接口把路由算法和系统解耦,后续算法不用再各写各的引擎。NeurIPS 2026 接收是对这套工程化工作的背书。 限制也要说清:主表并发只有 4,生产级高并发要看附录;64.15 倍出自最弱基线,标题党数字别当日常收益,我的判断是看 R2R 那组 2.7 倍更接近真实提升;系统深度绑定 SGLang,vLLM 用户要等社区移植。路由头本身(CITER 训的那个)不随系统开源,复现 CITER 的完整设定得自己训。 把路由从算法论文的附录里拽到 serving 栈的正中央,这活儿脏,但真值。 参考资料 - 论文:TokenRouter: Efficient Serving System for Token-Level LLM Routing,arXiv 2610.12242(NeurIPS 2026),https://arxiv.org/abs/2610.12242 - 仓库:https://github.com/thu-nics/TokenRouter(main 分支,最近更新 2026-10-12,文中代码位置以此为准) - 关键源码与配置:tokenrouter/managers/schedulers/citer_slm_scheduler.py(route、send)、tokenrouter/managers/schedulers/base_scheduler.py(延迟组批、handoff 序号)、tokenrouter/server_args.py(delayed_batching_threshold)、config/citer/Qwen3-0.6B_Qwen3-32B.yaml、evaluation/test_throughput.py
01 先看结论
02 问题背景
03 方法拆解
04 源码对照
05 实验配置
06 结果怎么看