ARTICLE · 1222610
厦大团队 ACL 2025:强制"以文档为准"反而更差?FaithfulRAG 用事实级对齐解决知识冲突
厦大团队 ACL 2025:强制"以文档为准"反而更差?FaithfulRAG 用事实级对齐解决知识冲突论文由厦门大学、香港理工大学、咪咕文化、苏州大学、新加坡管理大学与上海人工智能实验室合作完成。Qinggang Zhang 与 Zhishang Xiang 为共同一作,通讯作者为厦门大学的 Jinsong Su。 发表于ACL 2025(2025.acl-long.1062),预印本为 arXiv:2506.08938。实验用三个底座:Llama3.1-8B、Qwen2.5-7B 与 Mistral-7B;代码已开源。 RAG 落地到企业或垂直领域时,会遇到一类特别棘手的情况:检索到的内容和模型自己"记得"的不一样。 比如模型训练时记住的政策是旧版,而知识库已经更新——这时它有两种翻车方式: 过度自信:坚持自己参数里的旧知识,无视检索到的新文档; 错误匹配:倒是听了文档,但没读懂,错误地把新内容和旧认知混在一起。 论文在 MuSiQue 和 SQuAD 上量化了这两种错误:原始 RAG 的"过度自信"错误率分别是 13.6% 和 16.4%,"错误匹配"只有 5.2% 和 7.1%。也就是说,模型的主要毛病是太信自己。 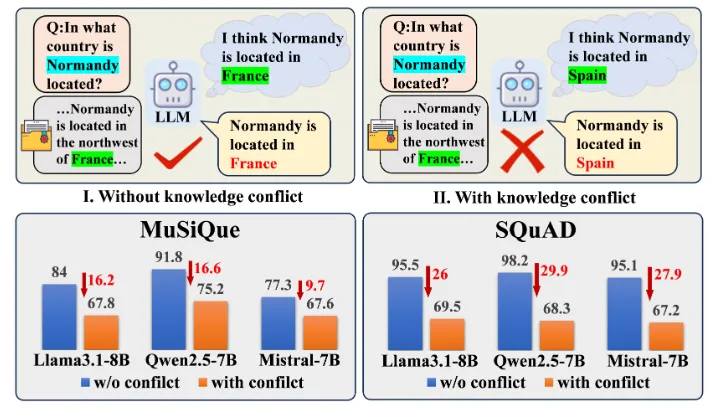
于是"忠实 RAG"类方法出场了——用提示词或解码约束强迫模型优先上下文。效果确实有:论文实测这类方法把"不忠实"错误降低了 6.65%。但代价是:"错误匹配"错误同时上升了 6.42%。提示式方法把过度自信错误从 13.6%/16.4% 压到 9%/9%,却把错误匹配从 5.2%/7.1% 抬到 6.4%/14.1%。 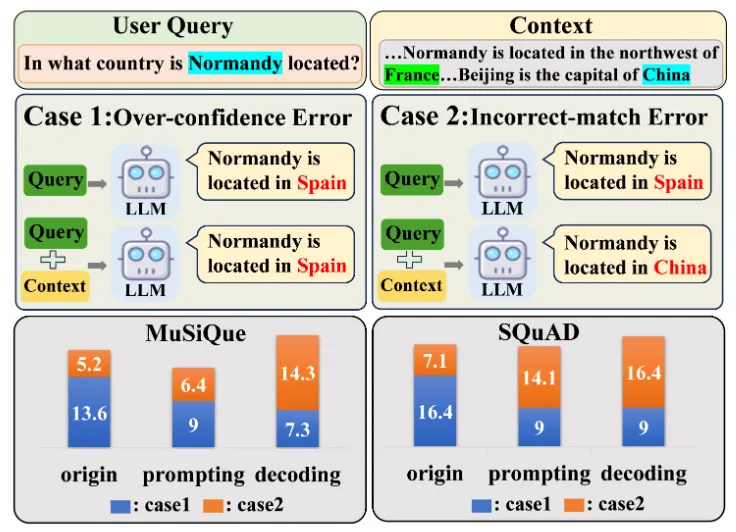
论文的结论是:强行压制参数知识,会破坏模型的内部知识结构,反而让它更容易误读上下文。 原始 RAG:把上下文直接拼进 prompt,模型该听谁全凭自己判断——过度自信问题严重。 提示式忠实(Opin、ATTR、KRE):用指令或示例要求"以文档为准"——把过度自信压下去了,但错误匹配上来了。 解码式忠实(CAD、COIECD):在解码阶段用熵约束或对比解码强制对齐上下文——同样偏"压制",且与具体模型绑得较紧。 Self-RAG 等自评方法(本库 RAG-002):让模型生成反思 token 自评,但没有专门处理"参数知识 vs 上下文"的冲突。 本文的切入点:不压制任何一方,而是把冲突本身变成推理对象——先让模型说出它自己知道什么,再和文档逐条比对。 FaithfulRAG 分三步走: 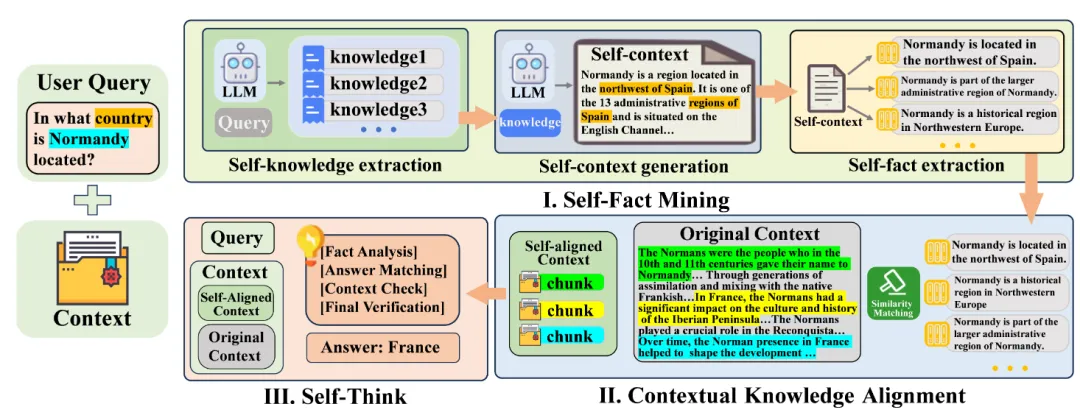
第一步:把模型自己的知识“抽出来”。直接问模型"答案是什么"太粗,论文设计了一个三层流程: 自知识抽取:先让模型列出回答这个问题所需的概念与事实前提; 自上下文生成:把这些抽象知识写成一段具体叙述; 自事实抽取:再从叙述里蒸馏出若干条事实断言——这就是"自事实"。 第二步:事实级对齐。把检索到的上下文切成小块,与自事实逐条比对,找出哪些事实一致、哪些冲突。 第三步:Self-Think。先基于对齐后的上下文给出一个初始答案,并评估它是否可靠、信息是否充分;如果不可靠,就把原始上下文里的相关内容融合进来,再逐步推理出最终答案。 和"直接告诉模型以文档为准"相比,这套流程多做了两件事:让模型先明确自己知道什么,以及让它带着冲突去推理。 评测覆盖四个数据集:FaithEval、RealtimeQA、MuSiQue 与 SQuAD,三个底座模型分别跑。 主结果: FaithEval 上,FaithfulRAG(Mistral-7B)拿到 81.7%,比最强基线 KRE 的 73.2% 高 8.5%; SQuAD 上,FaithfulRAG(Llama3.1-8B)拿到 86.3%,比 ChatQA-2.0 的 77.0% 高 9.3%; MuSiQue 与 RealtimeQA 上分别是 79.9% 与 84.1%。 四个数据集平均 81.9%(FaithEval 79.8 / RealtimeQA 81.4 / MuSiQue 79.9 / SQuAD 86.3)。 非冲突场景也没退化:在 MuSiQue-golden 上 85.3(比原始模型 84 高 1.3),SQuAD-golden 上 96.6(比 95.2 高 1.4)。这说明它不是靠"牺牲正常场景"换冲突场景的分数。 消融结果最能说明问题(全模型平均 81.9): 去掉整个 Self-Think 模块:59.8,降 22.2——这是最大的一块 去掉 Think 阶段:75.2(-6.7);去掉 Reasoning 阶段:76.0(-5.9) 用朴素 Chain-of-Thought 替代:64.8(-17.1)——在冲突场景里,普通 CoT 会让模型不信任上下文 去掉自上下文生成:80.0(-1.9);去掉自知识抽取:80.8(-1.1) 也就是说,"自事实"提供了对齐的锚点,但真正的增益来自"带着冲突去思考和推理"。 贡献:它把"忠实"从"压制一方"改成了"识别冲突、推理融合"。对我们做企业知识库特别有启发:新文档和模型旧认知冲突,是常态而不是异常;直接命令模型"以文档为准"往往会把错误从一种换成另一种。 局限(我们的评估): 成本没有披露:自知识抽取、自上下文、自事实、对齐、思考、推理是多轮 LLM 调用,论文没给延迟与 token 成本。实际部署时,准确率提升要和多出来的成本一起算账。 依赖模型自身知识:如果模型对某个领域几乎无知,自事实可能是空的或错的,冲突定位就会失效。 对齐质量未单独评估:对齐错了,后面所有阶段都会被带偏,但论文没有单独报告对齐准确率。 单次运行:没有方差与显著性报告。 评测以英文 QA 为主,跨语言未验证。 未来方向:更轻量的冲突建模(减少 LLM 调用轮数)、把自事实抽取与检索器训练结合,以及把该框架扩展到多跳与多文档冲突。 给工程实践留一条可以马上试的做法:在冲突敏感的场景,先让模型写出"它自己认为的答案/事实",再和检索文档逐条比对。这比一句"请以文档为准"更能暴露真正的分歧,也保留了模型做判断的能力。 你们的知识库更新时,有没有遇到过"模型坚持旧知识、不肯改口"的情况?评论区聊聊。
本文解读基于FaithfulRAG: Fact-Level Conflict Modeling for Context-Faithful Retrieval-Augmented Generation(ACL 2025)。 原文:https://aclanthology.org/2025.acl-long.1062/ PDF:https://arxiv.org/pdf/2506.08938 代码:https://github.com/DeepLearnXMU/Faithful-RAG DOI:https://doi.org/10.18653/v1/2025.acl-long.1062
厦大团队 ACL 2025:文档和模型"记得不一样"时,先别急着让它闭嘴
一、研究团队与发表信息
二、研究动机:问题界定与挑战分析
三、相关工作:针对该问题的技术演进
四、本文方法:技术方案与创新设计