ARTICLE · 1269020
长文档 OCR 新利器|百度 Unlimited‑OCR‑2 本地部署实测,百页一次性解析
模型地址:
https://www.modelscope.cn/models/PaddlePaddle/Unlimited-OCR-2
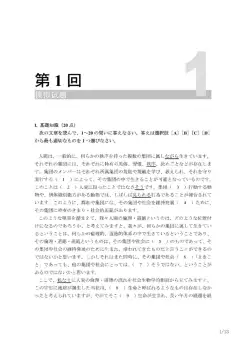
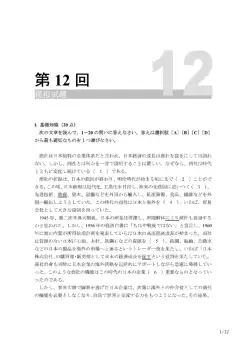
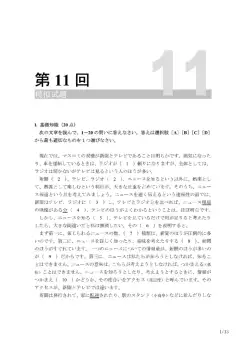
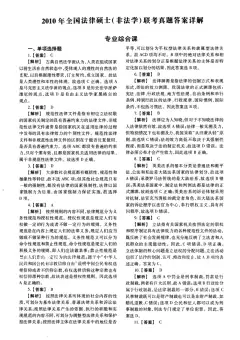
Unlimited‑OCR‑2 是百度推出的开源超长文档视觉 OCR 大模型,解决传统 OCR“页数越多,内存占用越高、识别效果下降” 的行业难题。
✨核心亮点
- 超长上下文,支持百页文档一次性识别
采用滑动记忆窗口注意力机制,处理第 1 页和第 100 页内存开销几乎不变,不用手动拆分 PDF、不用逐页循环调用,直接传入多页图片 / PDF,一次性输出全文内容,彻底解决长文档 KV 缓存无限膨胀问题。 - 文档布局理解能力强
不仅仅提取纯文字,可识别标题、正文、表格、图片区块,输出带位置的结构化结果;保留文档阅读顺序,不会出现文字乱序,适合书籍、扫描档案、合同、财务报表、古籍扫描件。 - 多格式输入兼容
支持单张图片、批量图片序列、PDF 文件输入;中英文混合文档识别表现优秀,对扫描复印件、低清晰度印刷文档容错能力高。 - 完全本地私有化运行
全部模型权重本地加载,不上传文件到第三方服务器,适合涉密资料、内部档案数字化,数据完全可控。
⚠️硬件参考
推荐 GPU:NVIDIA 显卡,显存≥8.5G,完整精度运行;显存较小可开启量化降低显存占用。 Python 版本建议 3.10‑3.12,不建议过低版本。
局限提醒:不擅长手写文字识别,主要面向印刷类文档、扫描印刷资料。
github地址:
https://github.com/baidu/Unlimited-OCR
提示:建议新建独立 Python 虚拟环境,避免包版本冲突。
步骤 1:创建虚拟环境(可选但强烈推荐)
进入d盘,例如:D:\file\unlimited-ocr2-win,注意:路径不要太长。
python -m venv .venv.\.venv\Scripts\activate.bat.venv\Scripts\python.exe -m pip install -U pippip install torch==2.13.0 torchvision==0.28.0 --index-url https://download.pytorch.org/whl/cu130
新建文件requirements.txt,内容如下:
transformers==4.52.1 # 官方 README 指定版本tokenizers==0.21.4 # 与 transformers 4.52.1 匹配,别单独升级huggingface-hub==0.36.0 # 同上,transformers 4.52 的兼容上限addict==2.4.0 # modeling_unlimitedocr.py 直接用(Addict 配置对象)einops==0.8.2 # deepencoder.py / _sparse_base_impl.pyeasydict==1.13 # deepencoder.pynumpy # 模型代码直接用(原来靠 transformers 传递安装,显式声明更稳)tqdm # 模型代码直接用(进度条)gradio>=5.0 # app.py 对 5.x / 6.x 都做了兼容探测pillow # app.py 读图 + 模型代码直接用 PILpymupdf==1.27.2.2 # app.py 里 import fitz,PDF → 图片# --- 权重下载(setup.ps1 用;app.py 的自动补下也用) ---modelscope
安装依赖
pip install -r requirements.txt步骤 2:下载模型,从魔塔社区下载,速度最快
pip install modelscopemodelscope download --model PaddlePaddle/Unlimited-OCR-2 --local_dir models\Unlimited-OCR-2
步骤 3:创建web可视化页面
注意:官方github并未提供web可视化代码,我是用deepseek写的。
新建app.py,代码比较长,如果需要,可以留言。
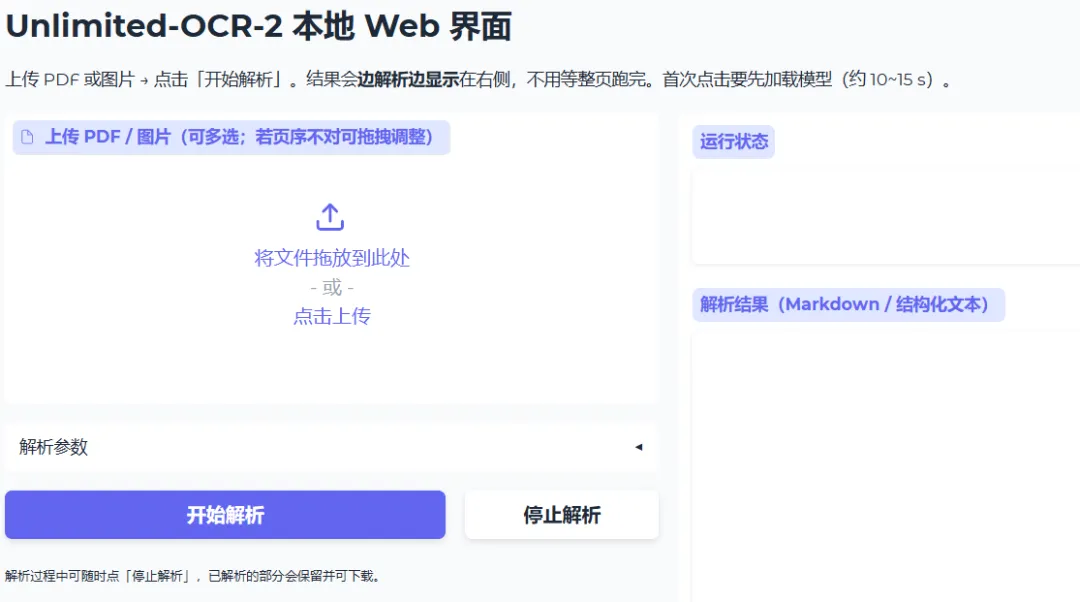
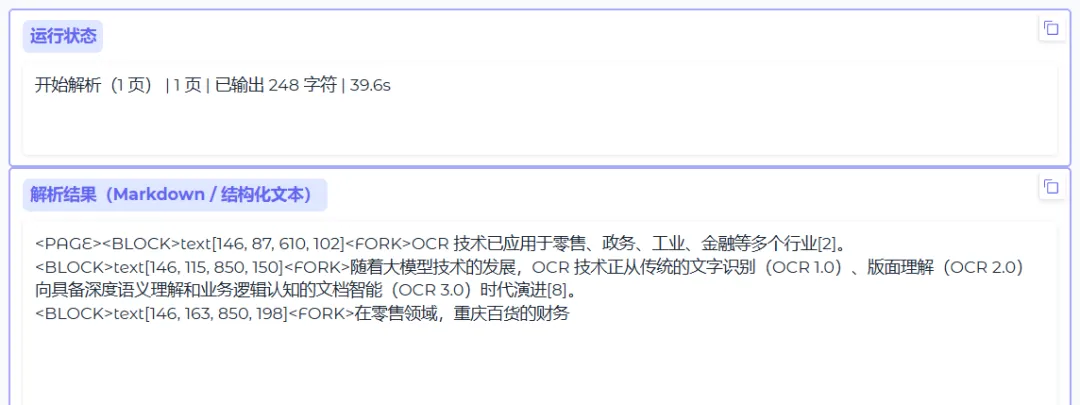
运行完成后,会自动打开页面,http://127.0.0.1:7860/,效果如下:
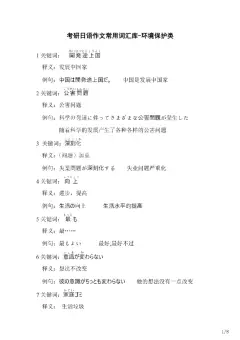
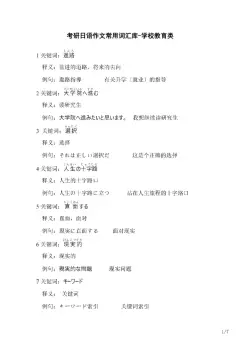
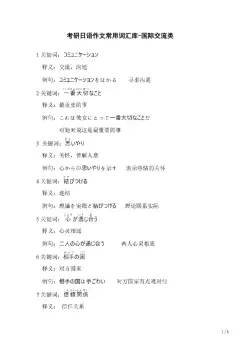
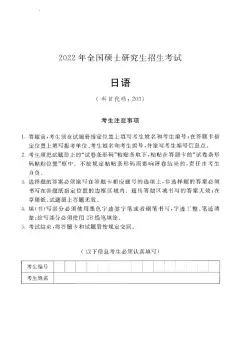
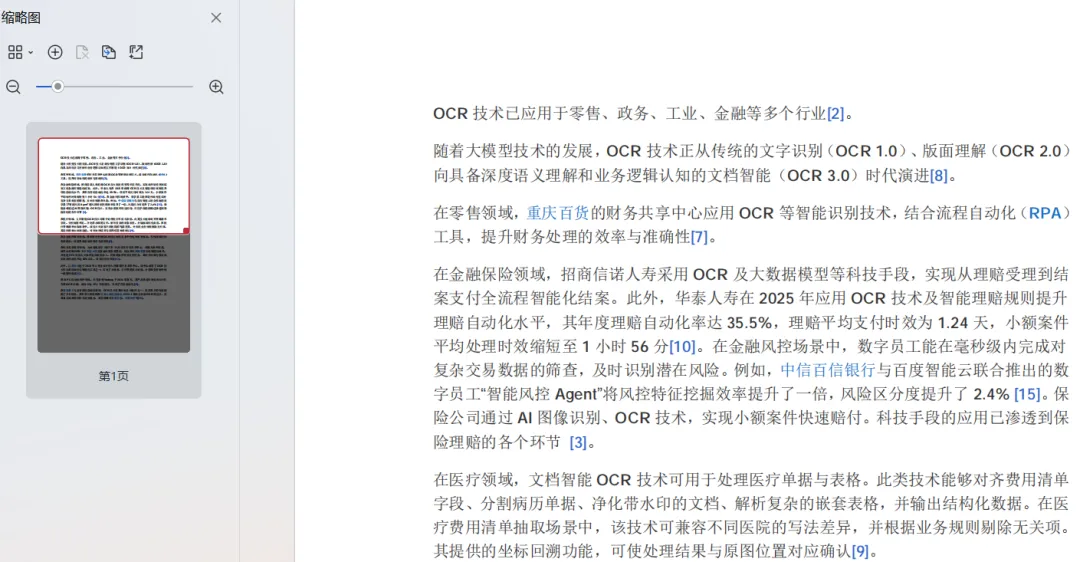
上传一个单页PDF文件,如果你没有PDF文件,可以先用wps新建一个world文档,然后输入一段内容保存,另存为PDF文件即可
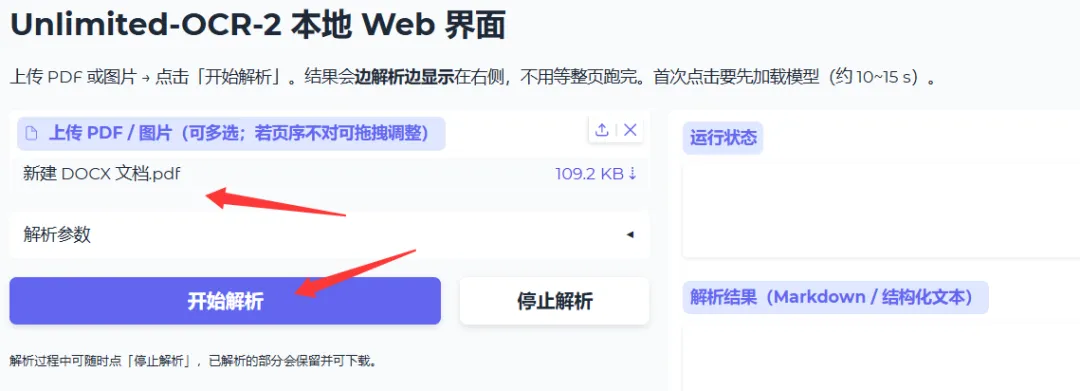
上传PDF文件,点击开始解析
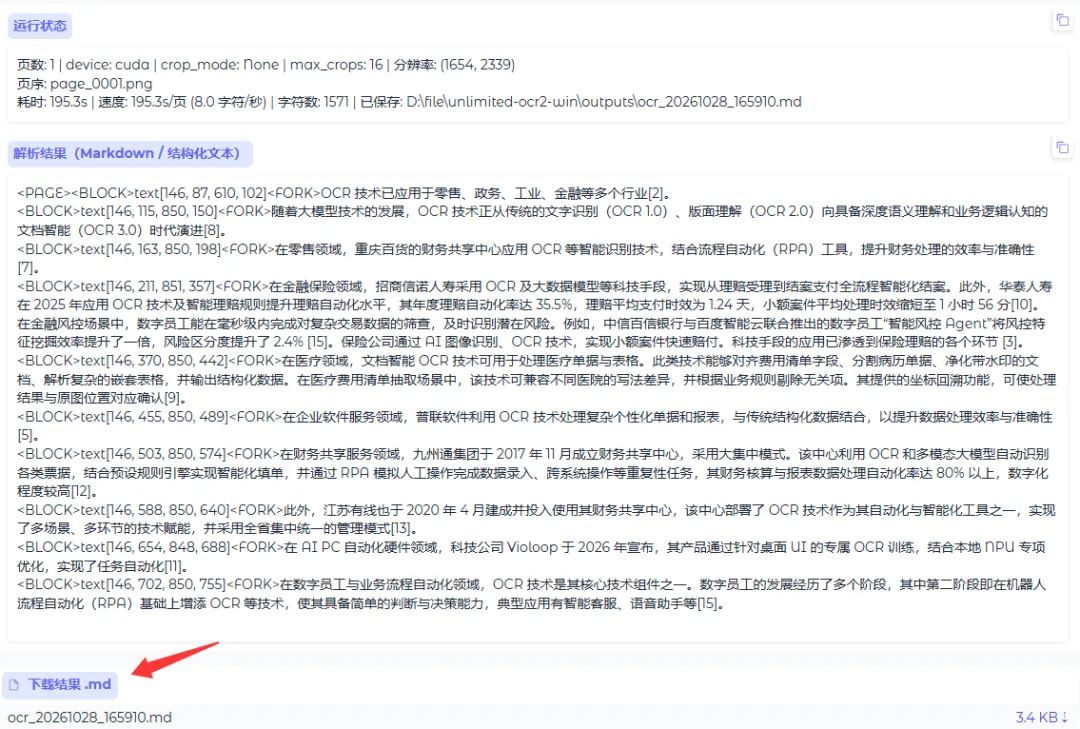
右侧会实时显示解析结果
解析完成后,这里会提示下载
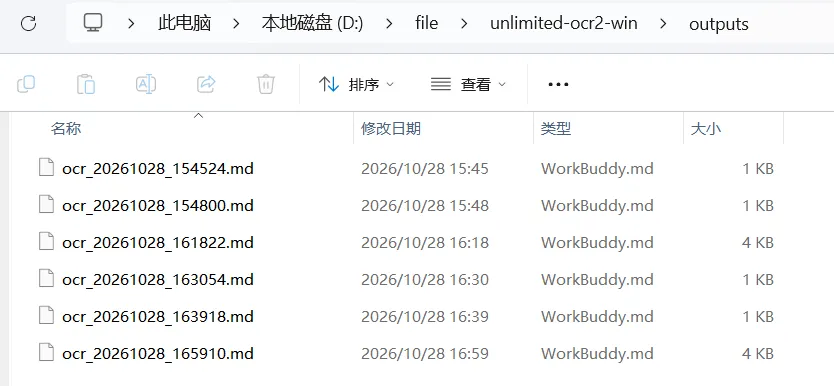
文件在本地outputs文件夹
✅档案数字化、图书馆书籍电子化
✅合同、报表、报告批量解析
✅需要私有化 OCR,禁止文件外传的企业
✅研究者、开发者做文档解析二次开发
❌不适合:大量手写笔记识别、纯图片绘画内容解析。
写在最后
Unlimited‑OCR‑2 最大的创新点,是打破传统 OCR 一页一处理的范式,把超长文档识别真正做到本地开源可用。如果你经常处理多页扫描 PDF,不妨本地跑起来试一试。
提示:开源项目仅供学习研究使用,商用请查阅项目开源许可协议。
文章读完后,你的点赞、分享、推荐,我们都深表感谢!
点击  公众号卡片,关注我们