ARTICLE · 1295827
TokenEconomizer:省费插件的边界
TokenEconomizer是一款让编码Agent复用仓库经验、减少重复消耗的插件,适合长期维护同一项目的团队。它由UC Berkeley、Microsoft Research和Microsoft Security研究人员合作,代码采用Apache-2.0许可。省费数字来自作者实验;当前交互插件的默认设置与实验控制器存在重要差异。
本文核对的仓库提交为c53a4a6dcdebaeb9df6fcaa5c7026f0401cd8f23,日期为2026年11月1日。原始论文于10月15日提交,不能把社交平台的传播日期当成发布日期。
官方仓库:https://github.com/microsoft/TokenEconomizer 项目页面:https://tokeneconomizer.github.io/ 论文:https://arxiv.org/abs/2610.22732
TokenEconomizer到底优化什么?
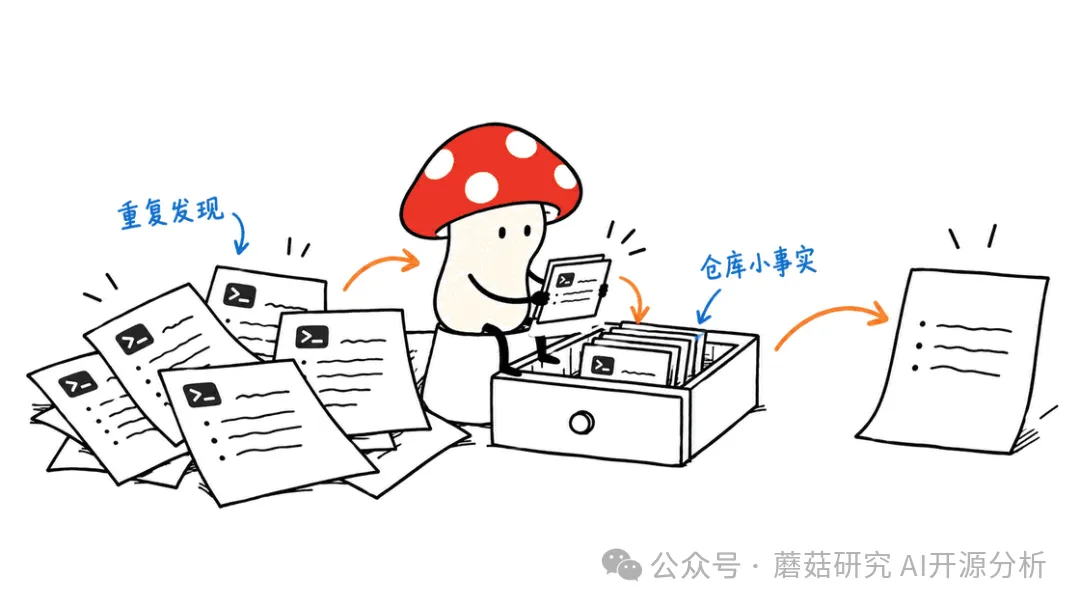
同一个代码库里,代理可能不断重查测试入口、重复加载闲置工具,或者对同一失败反复修补。项目将控制点放在任务周围:整理已有会话,影响后续提示上下文、工具配置和运行中的提醒,不训练新模型,也不要求重写代理主体。
这类优化的价值取决于任务分布。每次都换一个陌生仓库,知识复用空间较小;持续维护同一服务,重复的构建和验证路径更可能值得压缩。仓库经验也可能过时,因此“记住一次”不能等同于永久正确。
 |
三个机制如何分工?
| 机制 | 干预的位置 | 需要关注的代价 |
|---|---|---|
| Micro-skills | 在后续会话注入经证据支持的简短仓库事实 | 学习调用有成本,错误事实会污染上下文 |
| Tool pruning | 在后续会话减少不需要加载的工具或能力包 | 误删工具可能增加绕路,必须能够恢复 |
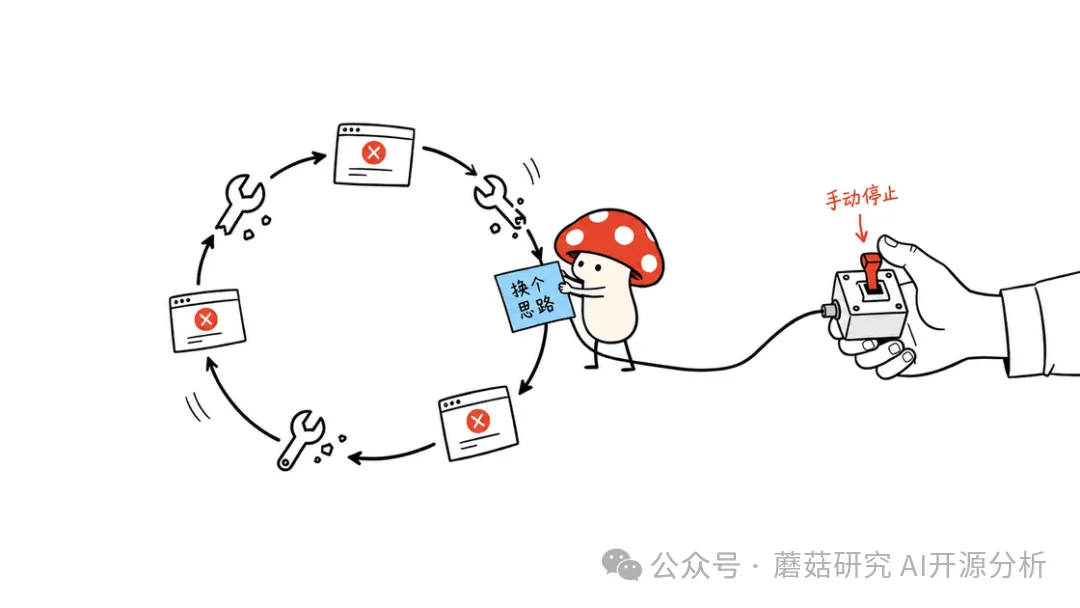
| Loop guard | 观察失败循环并给出换思路的提醒 | 判断和提醒也要调用模型,误判会打断有效探索 |
这张表是对控制位置的概括,不代表所有宿主都实现了相同功能。工具裁剪的粒度尤其不同,后文会单独列出。
“省18.4%至30.9%”应该怎样读?
作者报告在6个仓库的277道SWE-Bench任务上,比较5种Agent与模型组合,按仓库顺序执行任务。平均成本下降18.4%至30.9%,包含控制器自身的模型调用;4种组合的Pass@1提高,另1种没有提高。
官方结果绘图脚本给出了如下表格;Pass@1变化使用百分点,不是相对百分比。表格为作者数据,未在本机重跑。
| Agent × 模型 | 平均成本下降 | Pass@1变化 |
|---|---|---|
| Claude Code × Sonnet 5 | 23.6% | +1.3个百分点 |
| Claude Code × Opus 4.8 | 30.9% | −1.0个百分点 |
| Codex × GPT-5.6 Terra | 24.7% | +0.9个百分点 |
| Codex × GPT-5.6 Sol | 26.1% | +1.6个百分点 |
| Copilot CLI × Sonnet 5 | 18.4% | +2.6个百分点 |
数据脚本:https://github.com/microsoft/TokenEconomizer/blob/main/docs/assets/results_overview.py
这些数字描述特定实验条件下的平均变化。它们不证明每个任务都更便宜,不证明质量全面提升,也不等于实际订阅账单必然同比下降。订阅额度、缓存计费、模型路由和完成任务数量,都会改变用户感受到的节省。
原始口径见论文和实验目录: https://arxiv.org/abs/2610.22732 https://github.com/microsoft/TokenEconomizer/tree/main/experiments
更关键的是,实验环境有官方任务评分,可以判断是否解决问题;真实插件用会话事件推断“这一轮结束后没有失败验证”等信号。没有报错并不保证满足业务要求。把交互插件安装成功,不能视为已经复现论文结果。
当前插件与论文有哪些区别?
官方docs/PLUGIN.md明确列出两者差异。安装决策应以当前实现为准,而不是把论文控制器的能力全部套到插件上。
| 问题 | 当前插件的行为 |
|---|---|
| Micro-skills装上就学习吗? | 默认关闭,需要自行启用;也有不调用模型的envfacts模式 |
| 长时间卡住会自动停止吗? | 不会;先提醒换思路,仍卡住时提示人如何停止 |
| 工具马上消失吗? | 默认等待仓库会话闲置后写配置,并从后续会话生效 |
| 学习跨不同Agent共享吗? | 设置可共享,但事实、工具证据和运行尺度按Agent及仓库分别保留 |
| 一次失败就永久记住吗? | 不应如此;事实需要重复证据,后续矛盾会影响保留状态 |
最容易造成误解的是Loop guard:无人值守时,没有人看到提示,任务仍可能继续消耗到代理自身的限制。要控制自动任务预算,仍需在外层设置超时、调用额度和人工接管条件。
实现差异与限制: https://github.com/microsoft/TokenEconomizer/blob/main/docs/PLUGIN.md
 |
Claude Code、Codex、Copilot和Pi支持一样吗?
工具裁剪模块与配置写入代码显示,宿主提供的控制面不同,不能只看“支持”两个字。
| 宿主 | 裁剪对象 | 重要限制 |
|---|---|---|
| Claude Code | 单个工具 | 写入项目的.claude/settings.local.json |
| Codex | 能力包 | 写入.codex/config.toml;不是任意单工具开关 |
| GitHub Copilot CLI | 整个MCP服务器 | 写入.github/copilot/settings.local.json |
| Pi | 当前不裁剪 | 不能套用其他宿主的工具裁剪收益 |
| opencode | 当前不裁剪 | 支持仍属实验性质 |
源码与说明:https://github.com/microsoft/TokenEconomizer/tree/main/tokeneconomizer/toolprune
截至本次核对,README列出的测试版本范围为Claude Code 2.1.300–2.1.310、Codex 0.153.1–0.164.0、Copilot CLI 1.0.83–1.0.102、Pi 1.2.0–1.3.0;opencode测试了1.19.5及2.2.0。它们是已测试范围,不是未来版本兼容承诺,升级后要重新检查状态和实际生效配置。
如何安装,并保留撤回路径?
需要已能使用的宿主,以及PATH中的Python 3.10以上版本。本机测试发现,仅用Python 3.12启动测试还不够:Shell启动器可能另找系统Python 3.9,必须同时核对PATH;项目也提供TE_PYTHON覆盖项。插件Python包没有额外运行时依赖,也不需要为插件单独申请API Key;已有代理的登录、模型用量和权限仍然适用。
以Claude Code为例,下面命令来自官方安装说明,执行位置应是准备长期保留克隆目录的父目录:
| git clone https://github.com/microsoft/TokenEconomizer.git |
| claude plugin marketplace add "$PWD/TokenEconomizer" |
| claude plugin install tokeneconomizer@tokeneconomizer |
开启新会话后,检查状态并建立工具目录。以下是Claude Code中的命令,不能直接粘到系统Shell:
| /tokeneconomizer:status |
| /tokeneconomizer:toolprune refresh-catalog |
建议先以只提议模式观察工具裁剪;确认学习所涉及的模型调用和数据范围后,再启用微技能:
| /tokeneconomizer:config set toolprune=propose |
| /tokeneconomizer:config set microskills=on |
其他宿主的官方安装入口: https://github.com/microsoft/TokenEconomizer/blob/main/plugin/README.md
需要撤回已应用的工具裁剪时,使用/tokeneconomizer:toolprune restore。只把toolprune设为off会停止产生新列表,并不自动撤回已写入的规则。卸载前应恢复各仓库的规则,并按官方文档清理宿主插件;不要直接删除整个项目配置文件。
状态在本地,是否意味着完全离线?
不是。路径实现将状态放在~/.tokeneconomizer,也允许通过TOKENECONOMIZER_HOME指定位置。仓库标识优先从origin推导,同仓库的克隆可能共用经验;但长期分叉的环境不一定具有相同约束,需留意经验迁移是否适用。
状态可能包含仓库路径、命令、错误和费用记录。它需要纳入团队的本机备份、访问控制和清理策略,而不是因为没有独立服务器就忽略数据治理。
模型侧调用代码则通过用户已有的宿主CLI调用提议器和判断器。启用相关功能时,构造的摘要仍可能进入该宿主使用的模型服务。“存储在本地”不能推导出“内容不离开电脑”。
路径代码:https://github.com/microsoft/TokenEconomizer/blob/main/tokeneconomizer/plugin/paths.py 模型调用代码:https://github.com/microsoft/TokenEconomizer/blob/main/tokeneconomizer/plugin/sidecall.py
如何验证它在自己的项目里值得使用?
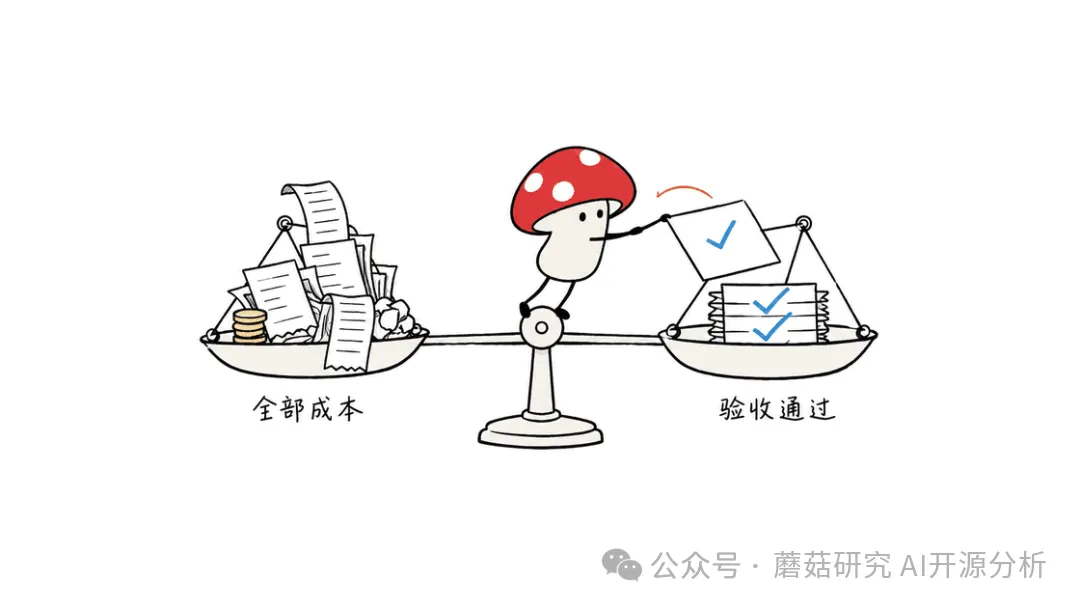
Mycelium Protocol建议按完成任务的质量与总成本验收,而非仅比较Token数量。可以选择一组真实维护任务,固定宿主、模型、缓存计费规则和任务验收标准,分别记录冷启动阶段及经验积累阶段。
至少保留五项记录:最终测试是否通过、总计费成本、插件附加调用成本、人工返工时间,以及被裁剪工具的恢复次数。比较时应包含失败任务和中断任务,避免只挑成功省钱的会话。
一个可解释的指标是“全部尝试成本÷验收通过的任务数”。假设总花费下降20%,通过的任务数却下降25%,单位成功任务成本变成原来的0.8÷0.75≈1.067,反而上升约6.7%。这只是说明计算方法的构造示例,不是TokenEconomizer的实测结果。
 |
本次对上游离线测试的首次运行得到421项通过、6项跳过和4项启动器失败。3项通过指定TE_PYTHON复查通过,另1项测试清理了该变量,改用Python 3.12所在目录前置到PATH后通过。总计425项已通过、6项跳过,分阶段日志保留;没有将初次失败隐藏为一次全绿运行。
本次验证范围为固定提交的代码审阅与离线测试,不包含将插件接入真实付费会话、运行完整SWE-Bench或测量账单节省。离线检查只能证明测试覆盖的行为在当前环境成立,不能替代实际使用对照。
建立验收样本的方法,也可参考本站的Agent评测文章: https://blog.mushroom.cv/blog/hamel-domain-specific-agent-evals-guide/
常见问题
它会让模型变聪明吗?
TokenEconomizer不更新模型权重。它试图改善代理获取经验和使用工具的方式,减少操作浪费;模型推理能力是否足够,仍需通过任务结果检验。
免费插件能保证账单降低吗?
不能。开源许可与模型用量是两回事。提议器、循环判断和提醒都可能产生额外调用,最终收益取决于减少的重复工作是否超过新增成本。
哪些项目适合先尝试?
优先选择反复维护、测试路径清晰、可以记录验收结果的仓库。一次性任务、工具需求频繁变化或无人值守任务,应先从可观察配置和明确的外部预算限制开始。
© 2026 Author: Mycelium Protocol. 本文采用 CC BY 4.0 授权——欢迎转载和引用,须注明作者姓名及原文链接,不得去除署名后以原创发布。