ARTICLE · 1372130
Nano-vLLM源码学习(3):模型骨架与核心算子
📑 目录
1. 从 Qwen3 的一层说起 2. RMSNorm:更省的归一化 3. RoPE:旋转位置编码 4. SwiGLU:SiluAndMul 5. 并行 Linear 族与张量并行 6. 词表并行 Embedding 与 LMHead 7. Attention:写 KV 与两条路径 8. Qwen3 的组装 9. Sampler:从 logits 到 token 总结 参考资料
1. 从 Qwen3 的一层说起
执行层最终要跑的是 models/qwen3.py里的 Transformer。先看一个 Qwen3DecoderLayer的结构,它决定了各个算子的调用顺序。
Qwen3 用的是 Pre-Norm + 残差结构:归一化放在子层之前,残差直接跨过子层。nano-vllm 把残差相加放进了 norm 内部:
●●●PythonclassQwen3DecoderLayer(nn.Module):defforward(self, positions, hidden_states, residual):if residual isNone: # 第一层:残差从输入初始化 hidden_states, residual = self.input_layernorm(hidden_states), hidden_stateselse: # 后续层:norm 同时吐出新残差 hidden_states, residual = self.input_layernorm(hidden_states, residual) hidden_states = self.self_attn(positions, hidden_states) hidden_states, residual = self.post_attention_layernorm(hidden_states, residual) hidden_states = self.mlp(hidden_states)return hidden_states, residual每一层做两件事:先归一化 + 注意力,再归一化 + MLP。残差 residual从第一层一路传到最后一层。RMSNorm可以接收上一层的残差,先把它加进来再归一化,同时返回相加后的新残差,所以 DecoderLayer里不用反复写 x = x + sublayer(norm(x))。下面把这一层用到的算子逐个展开。
2. RMSNorm:更省的归一化
LLM 普遍用 RMSNorm 替代 LayerNorm。它去掉了减均值和偏置,只按均方根缩放,计算更少,效果相当:
nano-vllm 的 RMSNorm有两个入口,都带 @torch.compile。普通归一化:
●●●Python@torch.compiledefrms_forward(self, x): orig_dtype = x.dtype x = x.float() # 升到 fp32 求方差 var = x.pow(2).mean(dim=-1, keepdim=True) x.mul_(torch.rsqrt(var + self.eps))return x.to(orig_dtype).mul_(self.weight) # 先转回原精度,再乘 γ带残差相加的版本,先在 fp32 里把残差加进来,相加结果转回原精度作为新残差,再对和做归一化:
●●●Python@torch.compiledefadd_rms_forward(self, x, residual): orig_dtype = x.dtype x = x.float().add_(residual.float()) # 残差相加 residual = x.to(orig_dtype) # 新残差 = 相加后的值 var = x.pow(2).mean(dim=-1, keepdim=True) x.mul_(torch.rsqrt(var + self.eps))return x.to(orig_dtype).mul_(self.weight), residual💡 提示:上一节 hidden_states, residual = self.input_layernorm(hidden_states, residual)调用的就是这个版本。残差相加和归一化写在同一个 torch.compile函数里,编译器可以把它们融合成更少的 kernel。求方差在 fp32 里做,是为了避免 bf16 下平方求和损失精度。
3. RoPE:旋转位置编码
RoPE(Rotary Position Embedding)不往输入里加位置向量,而是按位置把 Q、K 的每一对维度旋转一个角度,这样 Q 和 K 的点积只和两者的相对位置有关。频率表在初始化时预计算,cos 和 sin 拼成一个 buffer:
●●●Pythoninv_freq = 1.0 / (base ** (torch.arange(0, rotary_dim, 2).float() / rotary_dim))t = torch.arange(max_position_embeddings).float()freqs = torch.einsum("i,j->ij", t, inv_freq) # [位置, rotary_dim/2]cache = torch.cat((freqs.cos(), freqs.sin()), dim=-1) # [位置, rotary_dim]self.register_buffer("cos_sin_cache", cache.unsqueeze_(1), persistent=False) # 中间补一维对齐头维前向时把最后一维按前后两半拆成 ,第 维和第 维组成一对,做二维旋转:
●●●Python@torch.compiledefforward(self, positions, query, key): cos, sin = self.cos_sin_cache[positions].chunk(2, dim=-1) # 按位置查表 query = apply_rotary_emb(query, cos, sin) # 内部 chunk 成两半、按上式旋转 key = apply_rotary_emb(key, cos, sin)return query, key需要注意的几点:
🔑 RoPE 只作用于 Q 和 K,不碰 V。位置信息只需要体现在注意力分数上,V 是被加权求和的内容。 🔑 forward带了@torch.compile。RoPE 是逐元素的小算子,编译后可以融合成少量 kernel,减少显存读写。nano-vllm 在 RMSNorm、RoPE、SiluAndMul 和 Sampler 这几个逐元素算子上都用了torch.compile。get_rope带@lru_cache(1),参数相同时返回同一个对象,所以 28 层共享一份cos_sin_cache,不会每层各存一张表。即使配置里有 rope_scaling,代码也只从中读取rope_theta,没有实现 NTK / YaRN 等长度外推逻辑。
4. SwiGLU:SiluAndMul
Qwen3 的 FFN 用的是 SwiGLU 激活。它把输入投影成两份:一份当「门控」过 SiLU,一份当「数据」,两份再逐元素相乘:
nano-vllm 把它拆成两部分:投影由一个 MergedColumnParallelLinear一次算出 gate和 up两段(输出维是中间维的 2 倍),激活是一个很短的 SiluAndMul:
●●●PythonclassSiluAndMul(nn.Module):@torch.compiledefforward(self, x): gate, up = x.chunk(2, dim=-1) # 前一半是 gate,后一半是 upreturn F.silu(gate) * up💡 提示:gate 和 up 合并成一个 Linear 再切,是因为一次大矩阵乘比两次小矩阵乘更能用满 GPU:输入 x只读一次,kernel 启动次数也减半。QKV 合并成 qkv_proj是同样的考虑。
5. 并行 Linear 族与张量并行
张量并行(Tensor Parallelism, TP)把一个大矩阵乘切到多张卡上并行算。nano-vllm 的 linear.py把这套机制封装成一组 Linear 子类,模型代码选对类型就具备 TP 能力。关键是分清沿哪个维度切。下图以 TP=2 为例,蓝色和黄色分别是 rank0 和 rank1 负责的分片,红色是唯一需要通信的 all_reduce:
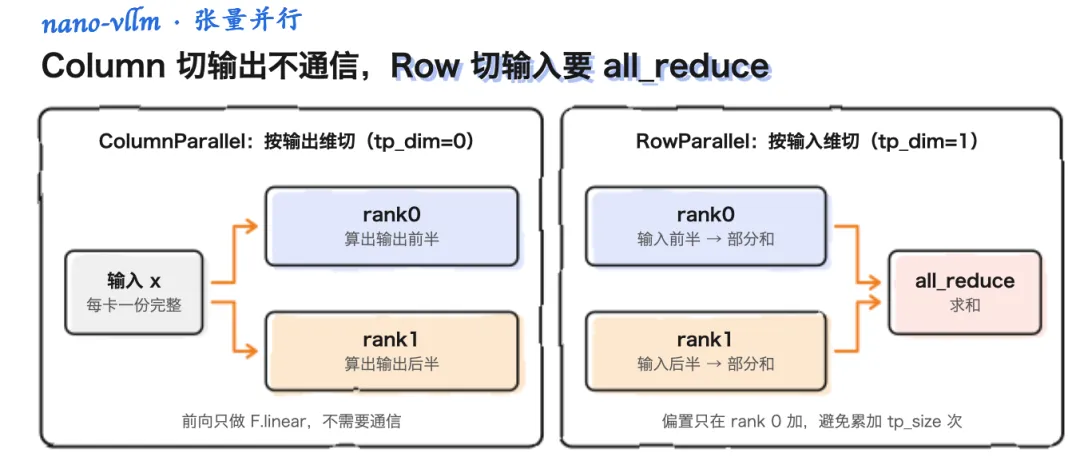
ColumnParallelLinear(tp_dim=0):按输出维切分,每张卡算出一部分输出列。权重加载时用narrow沿 dim 0 取本 rank 的分片;前向是普通F.linear,不需要通信。RowParallelLinear(tp_dim=1):按输入维切分,每张卡拿输入的一部分、算出部分和。所以 TP>1 时前向末尾要dist.all_reduce(y)把各卡结果加起来;偏置只在 rank 0 加,避免被累加 tp_size 次。QKVParallelLinear(ColumnParallel 的子类):把 Q、K、V 三个投影合并成一个大矩阵,输出维是 `(num_heads + 2 num_kv_heads) head_dim`。它的权重加载按字符串shard_id("q"/"k"/"v")定位各段的偏移。MergedColumnParallelLinear(ColumnParallel 的子类):把 gate、up 合并(上一节的 SwiGLU 用它),权重加载按整数shard_id(0=gate、1=up)索引output_sizes。
把它们按 Transformer 的数据流排开,Column 和 Row 正好成对出现:
QKVParallelLinear | ||
o_proj | RowParallelLinear | |
gate_up | MergedColumnParallelLinear | |
down | RowParallelLinear |
📌 关键点:Column 切输出、Row 收输入,一前一后配对,中间的激活在卡内保持切分状态、不必通信,只在每个子层的末尾做一次 all_reduce。所以每个 Transformer 层恰好有 2 次 all_reduce(Attention 的 o_proj一次、FFN 的 down_proj一次)。这是 Megatron-LM 提出的 TP 切分方式,nano-vllm 的 linear.py用 156 行实现了它。
⚠️ 注意:QKV 按头切分,所以 Qwen3Attention断言注意力头数和 KV 头数都能被 tp_size 整除。Qwen3-0.6B 有 16 个 Q 头、8 个 KV 头,TP 度只能取 1、2、4、8。在 nano-vllm 里,KV 头数就是 GQA 模型 TP 度的上限(vLLM 会在 TP 度超过 KV 头数时复制 KV 头,nano-vllm 没有实现)。
6. 词表并行 Embedding 与 LMHead
Qwen3 的词表约 15 万行,Embedding 和 LMHead 的权重都很大,也要切。nano-vllm 把它们做成词表并行:每张卡只持有词表的一段。
VocabParallelEmbedding的 forward 要处理「某个 token 不属于本卡」的情况:
●●●Pythondefforward(self, x):ifself.tp_size > 1: mask = (x >= self.vocab_start_idx) & (x < self.vocab_end_idx) # 本卡负责的 token x = mask * (x - self.vocab_start_idx) # 平移到本地下标,越界的先置 0 y = F.embedding(x, self.weight)ifself.tp_size > 1: y = mask.unsqueeze(1) * y # 不属于本卡的行清零 dist.all_reduce(y) # 求和:每个 token 的向量只有一卡非零return y每张卡都查一次表,但只有负责该 token 的卡查出非零向量,其余卡输出 0,all_reduce求和后就是完整结果。TP=1 时两段 if都跳过,退化成普通的 F.embedding。
ParallelLMHead是它的子类,负责把 hidden state 投影成词表 logits。两个细节:
●●●Pythondefforward(self, x): context = get_context()if context.is_prefill: last_indices = context.cu_seqlens_q[1:] - 1# 每条序列最后一个位置 x = x[last_indices].contiguous() # 只取最后一个 token logits = F.linear(x, self.weight)ifself.tp_size > 1:# 各卡算出词表的一段,gather 到 rank0 再拼接成完整 logits all_logits = [...] ifself.tp_rank == 0elseNone dist.gather(logits, all_logits, 0) logits = torch.cat(all_logits, -1) ifself.tp_rank == 0elseNonereturn logits🔑 prefill 只取最后一个 token:生成下一个 token 只需要序列最后一个位置的 logits。`cu_seqlens_q[1:] - 1` 定位每条序列在拼接张量里的末位,避免把整段 prompt 都投影到词表维度。一条 1000 token 的 prompt,LMHead 只需投影 1 行,而不是 1000 行。 🔑 LMHead 用 gather而非all_reduce:词表按输出维切(每卡算不同的 logits 列),要的是拼接而不是求和,所以用dist.gather收到 rank 0 再cat,其他 rank 返回None。Embedding 查表等价于 one-hot 向量乘权重矩阵,词表是这次乘法的输入维,所以用all_reduce。切输入维就 reduce,切输出维就 gather,和第 5 节的 Column/Row 规律一致。
7. Attention:写 KV 与两条路径
attention.py做两件事:先把新算出的 K/V 写进 KV Cache,再做注意力计算。注意力计算在 prefill 和 decode 两个阶段调用的是不同的 FlashAttention 接口。
7.1 用 Triton 把 K/V 写进 Cache
每个 token 的 K/V 要存到 KV Cache 里对应的槽位(slot)。slot 编号由上层算好的 slot_mapping给出(见 3.6),这里只按编号写入。nano-vllm 用一个很短的 Triton kernel 完成:
●●●Python@triton.jitdefstore_kvcache_kernel(key_ptr, key_stride, value_ptr, value_stride, k_cache_ptr, v_cache_ptr, slot_mapping_ptr, D: tl.constexpr): idx = tl.program_id(0) # 每个 program 处理一个 token slot = tl.load(slot_mapping_ptr + idx)if slot == -1: # -1 表示这个 token 不需要写(padding)return# 用传入的 stride 定位第 idx 个 token 的 D 个元素,写到 cache 的 slot 行 key = tl.load(key_ptr + idx * key_stride + tl.arange(0, D)) value = tl.load(value_ptr + idx * value_stride + tl.arange(0, D)) cache_offsets = slot * D + tl.arange(0, D) tl.store(k_cache_ptr + cache_offsets, key) tl.store(v_cache_ptr + cache_offsets, value)包装函数 store_kvcache从 key.shape取出 (N, num_heads, head_dim),令 `D = num_heads * head_dim。传进来的 key是 KV 头的张量,所以这里的 num_heads实际是本 rank 的 KV 头数,D就是一个 token 在一层里的 K(或 V)向量长度。key_stride/value_stride由外层用 key.stride(0)传入;包装函数还断言 key.stride(-1) == 1、key.stride(1) == head_dim、k_cache.stride(1) == D`,确保每个 token 的 D 个元素在内存里连续,kernel 才能一次读写一整段。
💡 提示:用 PyTorch 写同样的逻辑,大致是 `k_cache.view(-1, D)[slot_mapping] = key.view(N, D)。问题出在 slot == -1` 的位置:CUDA Graph 回放时 decode batch 会补齐到固定大小,补出来的 token 的 slot 是 -1(3.6 会讲),这些位置不能写。PyTorch 里要先用掩码筛掉它们,筛选结果的长度随数据变化,不适合放进 CUDA Graph。Triton kernel 每个 program 处理一个 token,遇到 -1 直接返回,张量形状始终固定,可以被 Graph 捕获。
7.2 两条路径:prefill 用 varlen,decode 用 with_kvcache
Attention.forward先调用 store_kvcache写缓存,然后按 context.is_prefill分流:
●●●Pythondefforward(self, q, k, v): context = get_context() k_cache, v_cache = self.k_cache, self.v_cacheif k_cache.numel() and v_cache.numel(): # cache 已分配才写store_kvcache(k, v, k_cache, v_cache, context.slot_mapping)if context.is_prefill:if context.block_tables isnotNone: # 有历史 KV:改从整块 cache 读 k, v = k_cache, v_cache o = flash_attn_varlen_func( q, k, v, cu_seqlens_q=context.cu_seqlens_q, cu_seqlens_k=context.cu_seqlens_k, max_seqlen_q=context.max_seqlen_q, max_seqlen_k=context.max_seqlen_k, softmax_scale=self.scale, causal=True, block_table=context.block_tables)else: # decode o = flash_attn_with_kvcache( q.unsqueeze(1), k_cache, v_cache, cache_seqlens=context.context_lens, block_table=context.block_tables, softmax_scale=self.scale, causal=True)return o两条路径分别对应两个阶段的特点:
🔑 prefill 用 flash_attn_varlen_func:一次要算整段 prompt 的注意力,多条序列变长地拼在一起,靠cu_seqlens_q/cu_seqlens_k两组累积长度切分;causal=True保证每个位置只看前文。如果本步的部分 K/V 已经在 Cache 里,ModelRunner会传入block_tables,这时k, v换成整块k_cache/v_cache,kernel 按block_table去物理块里读完整的历史 K/V。有两种情况会触发:命中了前缀缓存,或者 chunked prefill 的后续块(前面的块上一步已经写进 Cache)。两种情况下 Q 都比 K 短,判断条件统一是 `cu_seqlens_k[-1] > cu_seqlens_q[-1]`。🔑 decode 用 flash_attn_with_kvcache:每条序列只新增一个 token(q.unsqueeze(1)补出长度维 1),K/V 全部来自 Cache,cache_seqlens告诉 kernel 每条序列当前多长,block_table告诉它去哪些物理块里读。缩放因子 `scale = head_dim -0.5`,即标准的 。
📌 关键点:「Prefill 算力密集、Decode 访存密集」在代码里体现为两个阶段调用不同的 FlashAttention 接口。KV Cache 的物理块怎么分、slot 怎么算留到 3.4 和 3.6,这里只需记住 Attention 既负责写 Cache,也负责读 Cache。
8. Qwen3 的组装
有了上面这些算子,models/qwen3.py按 Qwen3 的结构把它们拼起来。和 LLaMA 式实现相比,有两处不同。
① QKV 投影后对 Q、K 做 per-head RMSNorm。Qwen3 在每个注意力头的 Q、K 上各加了一个 RMSNorm(即 QK-Norm),用来稳定训练:
●●●Pythondefforward(self, positions, hidden_states): qkv = self.qkv_proj(hidden_states) q, k, v = qkv.split([self.q_size, self.kv_size, self.kv_size], dim=-1) q = q.view(-1, self.num_heads, self.head_dim) # reshape 成 [token, 头, head_dim] k = k.view(-1, self.num_kv_heads, self.head_dim) v = v.view(-1, self.num_kv_heads, self.head_dim)ifnotself.qkv_bias: # Qwen3 走这条分支 q = self.q_norm(q) # 在 head_dim 维上逐头归一化 k = self.k_norm(k) q, k = self.rotary_emb(positions, q, k) # 再加旋转位置 o = self.attn(q, k, v)returnself.o_proj(o.flatten(1, -1)) # 把头维摊平后投影回 hidden🔑 核心概念:RMSNorm作用在最后一维 head_dim上,所以把张量 reshape 成 `[token, 头, head_dim]后直接送进去,就是逐头归一化。QK-Norm 只在 not self.qkv_bias时启用。qkv_bias取自 HF 配置的 attention_bias(缺省按 True处理),Qwen3 的配置里它是 false`,所以走 QK-Norm 分支;带 QKV bias 的 Qwen2 式结构则不做 QK-Norm。
② 权重映射 packed_modules_mapping。nano-vllm 把 q/k/v 合并成了 qkv_proj、gate/up 合并成了 gate_up_proj,而 HuggingFace 的 checkpoint 里它们是分开的五个权重。加载时 loader.py遍历 safetensors 里的权重名,按子串匹配这张映射表,把原始名字翻译成合并后的参数名和 shard_id:
●●●Pythonpacked_modules_mapping = {"q_proj": ("qkv_proj", "q"), # 字符串 shard_id"k_proj": ("qkv_proj", "k"),"v_proj": ("qkv_proj", "v"),"gate_proj": ("gate_up_proj", 0), # 整数 shard_id"up_proj": ("gate_up_proj", 1),}第 5 节「QKV 用字符串 shard_id、Merged 用整数 shard_id」就来自这张表:两个类的 weight_loader分别处理表里的两种值类型。
此外还有两个工程细节:
tie_word_embeddings:Qwen3-0.6B 这类小模型的 Embedding 和 LMHead 共用同一张权重表。Qwen3ForCausalLM.__init__里执行self.lm_head.weight.data = self.model.embed_tokens.weight.data,让两个参数指向同一块存储;之后加载 embed 权重,lm_head 自然也有了,只占一份显存。compute_logits单独调用 LMHead:forward只算到 hidden state,logits 由compute_logits单独计算。这样 CUDA Graph 只需要捕获到 hidden state 为止,LMHead 的「prefill 只取最后 token」逻辑和后面的采样都放在 Graph 之外。
9. Sampler:从 logits 到 token
rank 0 拿到 logits 后,Sampler按每条序列自己的温度采样出下一个 token。整个类只有一个带 @torch.compile的 forward:
●●●PythonclassSampler(nn.Module):@torch.compiledefforward(self, logits, temperatures): logits = logits.float().div_(temperatures.unsqueeze(dim=1)) # 每行除以各自的温度 probs = torch.softmax(logits, dim=-1) noise = torch.empty_like(probs).exponential_(1).clamp_min_(1e-10) # E ~ Exp(1)return probs.div_(noise).argmax(dim=-1) # argmax(p / E)最后一行没有调用 torch.multinomial,而是给每个概率除以一个独立的指数分布随机数,再取最大值。这是 Gumbel-max 技巧的等价写法,结论是:
简单的推导:的最大值对应的最小值,而服从参数为的指数分布。一组独立指数随机变量里,第个最先「到达」的概率是,正好是按概率抽样。
🔑 效果和 multinomial一样,但都是逐元素运算加一次 argmax:除法、指数随机数、argmax 都能被torch.compile融合,不需要multinomial那样先做前缀和再二分查找。🔑 温度只缩放 logits:温度越高,softmax 越平,随机性越大。温度为 0 时第一行就会除以 0,这就是 SamplingParams在入口处断言temperature > 1e-10的原因(见 3.2)。采样只在 rank 0 执行。 ModelRunner.run里只有 rank 0 调用prepare_sample和sampler,其他 rank 的compute_logits返回None,run也返回None。nano-vllm 没有实现 top-k、top-p、重复惩罚等策略, SamplingParams也只有三个字段。
📝 总结
Qwen3DecoderLayer是 Pre-Norm + 残差结构,nano-vllm 把残差相加放进RMSNorm,主干代码只传一个residual。RMSNorm 去掉减均值、只按均方根缩放,方差在 fp32 里算;RoPE 按前后两半配对旋转 Q/K,不碰 V,28 层共享一份 cos_sin_cache;SwiGLU 由MergedColumnParallelLinear+SiluAndMul实现。这些逐元素算子都用@torch.compile融合。并行 Linear 族遵循「Column 切输出、Row 收输入」,每个 Transformer 层恰好 2 次 all_reduce(o_proj与down_proj);TP 度必须能整除 Q 头数和 KV 头数。词表并行里,Embedding 用 all_reduce、LMHead 用gather;LMHead 在 prefill 阶段只对每条序列最后一个 token 投影。Attention 先用 Triton kernel 把 K/V 写进 Cache(跳过 slot = -1 的 padding),再按阶段分流:prefill 走 flash_attn_varlen_func,Cache 里已有历史 KV 时带上block_table;decode 走flash_attn_with_kvcache。Qwen3 的特点是 per-head QK-Norm 与 packed_modules_mapping权重合并映射;tie_word_embeddings让 LMHead 与 Embedding 共享存储。Sampler用argmax(p / E)、E ~ Exp(1)实现按温度采样,等价于从softmax(logits / T)中抽样,只在 rank 0 执行。
📚 参考资料
nano-vllm GitHub 仓库 Qwen3 Technical Report(Qwen Team, 2025) Qwen3-0.6B 模型卡 RoFormer: Enhanced Transformer with Rotary Position Embedding(Su et al., 2021) Root Mean Square Layer Normalization(Zhang & Sennrich, 2019) GLU Variants Improve Transformer(Shazeer, 2020) Megatron-LM: Training Multi-Billion Parameter Language Models Using Model Parallelism(Shoeybi et al., 2019) FlashAttention: Fast and Memory-Efficient Exact Attention with IO-Awareness(Dao et al., 2022) FlashAttention 接口文档(flash_attn_interface.py) Triton 官方文档
📚 推荐阅读
AIInfraGuide : 开源全栈AI Infra 学习教程
推理优化系列:
AIInfra推理优化(3):PagedAttention - 像操作系统管理内存一样管理 KV Cache
AIInfra推理优化(4):Continuous Batching - 让 GPU 不再空等的动态批处理
AIInfra推理优化(5):Prefix Cache 与 RadixAttention 复用共享前缀的 KV
AIInfra推理优化(6):Chunked Prefill 与统一 Token Budget 调度