ARTICLE · 1372333
客服机器人总答错退款政策? 先加文档,别急着训练
AI 学习 · 第 38 讲
一、两个毛病,一个方案
客服机器人上线两个月,团队发现它有两个毛病:一,说话太机械,客户觉得像在念条款;二,退款政策答错,文档明明写的是「7 天内原路退回」,它偏说「15 个工作日」。
负责人开会提了一个方案:「咱们微调一个自己的模型吧。」
听起来很专业。但这两个毛病,一个可能值得微调,另一个微调了也治不好,甚至会更糟。动手之前,先把账算清楚。
· · ·
二、微调到底是什么
微调,就是拿几千条你自己的数据,在一个现成模型上继续训练,把它的输出习惯往你的方向掰。
原理一句话说完:训练过程会小幅调整模型内部的参数,让「这一类输入 → 你想要的输出」的概率变大。它改变的是模型的行为习惯——语气、格式、套路。
注意,微调不往模型里「存知识」。你拿一万条退款政策的问答去微调,它确实能背对这一批,但下个月政策改成「30 天内」,权重里的旧答案不会自己更新——改知识要靠检索(RAG,前面第 17 讲讲过,就是回答前先去你的文档里查一遍再作答)。
还有一笔时间账:备数据、训练、评测、上线,一轮微调以周计;而检索更新一篇文档,是分钟级的事。用周级手段去解决分钟级能解决的问题,方向多半是错的。
· · ·
三、类比:培训习惯,发手册查事实
把模型想成一个新员工。
微调像入职培训:教他说话的语气、回复的格式、什么情况该升级给主管。培训完,他的「做事风格」确实变了——风格稳定后客户的体感差别是实打实的,这种收益真实存在。
但你没法通过培训让他背下整本产品手册——几百页,还每月更新。正确做法是把手册放在他手边,遇到事实问题翻一眼再回答。
手册 = 检索,培训 = 微调。习惯问题用培训,事实问题用手册,这个分工搞反了,两头都费劲。
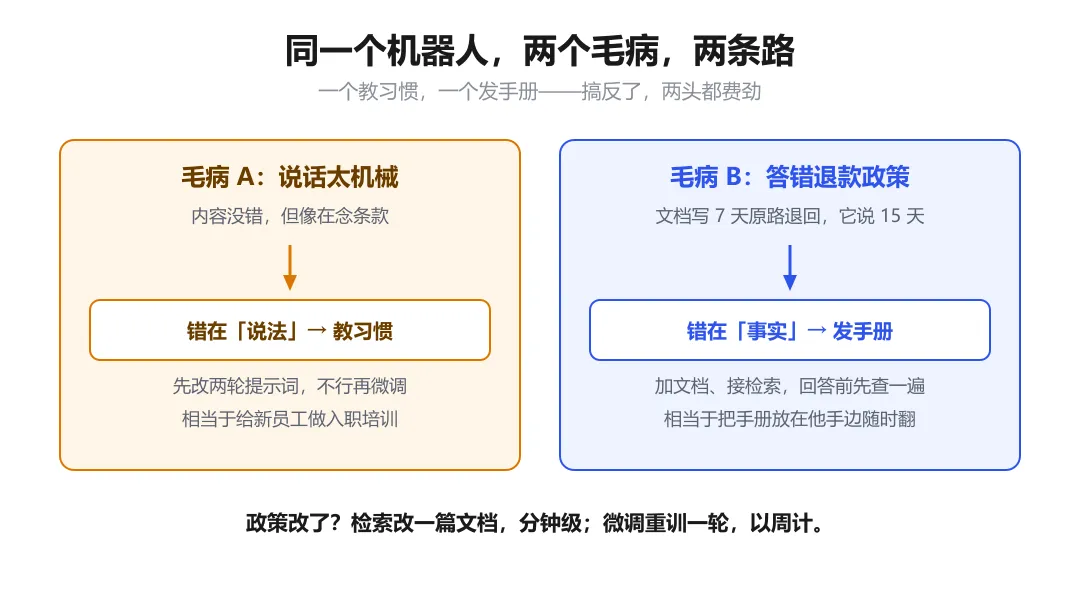
同一个机器人,两个毛病,两条对症的路
· · ·
四、三问判断法(本讲重点)
动手微调之前,先过三问:
第一问:错的是「事实」还是「说法」?答错退款政策是事实错误 → 加文档、做检索,别训练。说话像机器人是说法问题 → 微调、改提示词才对症。经验上,非技术团队提的需求里,事实类错误占七成以上,多数「想微调」的需求做完检索就解决了。
第二问:你拿得出几百条像样的标注数据吗?微调要喂同类任务的样例。经验值供参考:几十条基本看不出效果,几百条算起步,稳定见效多在几千条这一档——这是经验判断,不是实测数据。顺带一提,不少团队是把「数据没整理过」误当成「没有数据」:先花半天把聊天记录里已经答对的案例整理出来数一数,再下结论。
第三问:这件事的规则三个月内会变吗?政策、价格、产品参数这类高频变动的内容,微调进去就固化了,每次变更都要重新训练一轮,成本比更新一篇文档高几个数量级。规则常变的,坚决别微调。
三问里有任何一问答「不适合」,就先不做。判断句记这一句:
事实错就加文档,说法错才考虑训练;要经常改规则的任务,别微调。
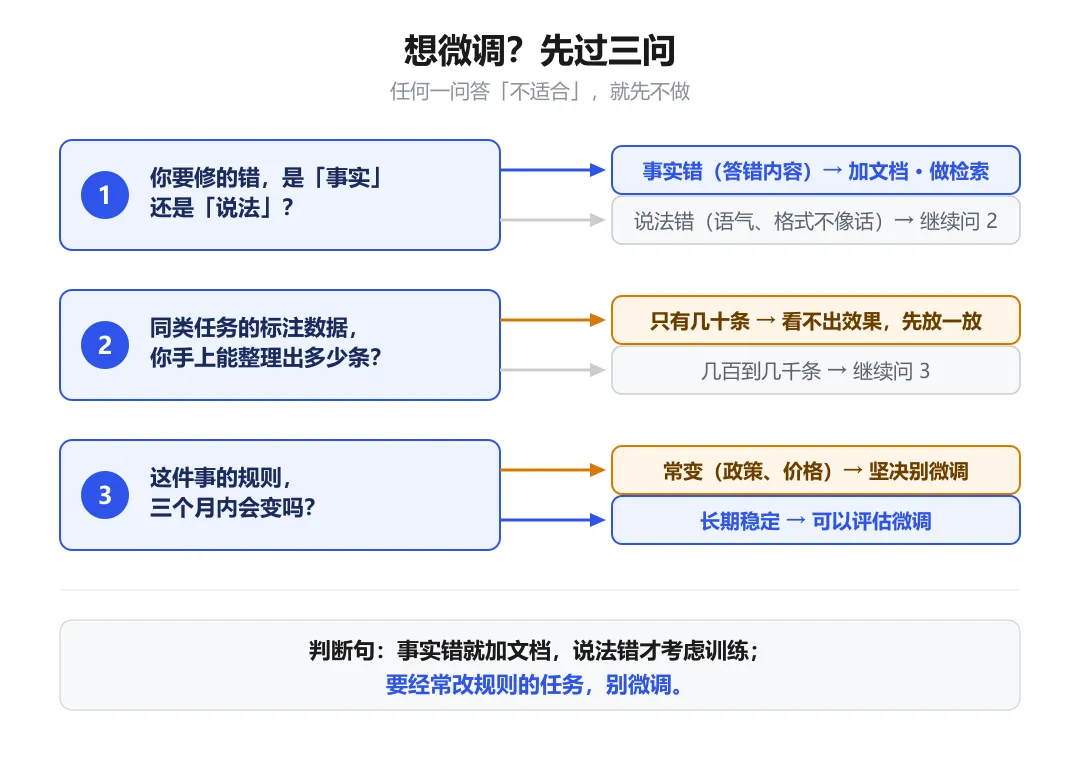
三问判断法:任何一问答「不适合」,就先不做
· · ·
五、三个常见误区
误区一:拿几十条聊天记录就想练出一个专属模型
几十条数据的量,训出来的多半是「学到了几个口头禅」,核心问题原样不动,还白花一笔训练费。
误区二:想用微调解决「知识更新」
把新版政策训进模型,看着一劳永逸,实际是把「改文档」变成了「改权重」。政策一变就重训一轮,钱和周期都翻倍。
误区三:以为微调能让模型「变聪明」
微调只往一个方向掰习惯,掰狠了还有副作用——模型在没训练过的任务上可能变差(这叫灾难性遗忘:学新任务时把旧能力挤掉一部分)。通用能力靠换模型,不靠微调;「它根本不会做这类判断」的能力上限问题,微调同样解决不了。
· · ·
六、动手练习(五分钟)
把你手头「想让 AI 做得更好」的任务拿出来,做三步:
1. 写下 10 条它答错的例子(对话截图或记录都行)。
2. 逐条标注:错在「事实」(答错内容)还是「说法」(内容对但不像话)。
3. 数比例:事实类超过 7 成 → 本周先做的是整理文档、接检索,不是微调;说法类居多 → 先试两轮提示词(第 28 讲讲过,好提示词经常比换模型管用),仍不满意再评估微调的数据成本。五分钟后你多半会得出结论:你根本不需要微调。
· · ·
七、一句话总结
微调教的是习惯,不是知识;事实问题用检索解决,说法问题才轮到训练出场。
下一讲预告:第 39 讲《私有化部署:一张卡能跑多大的模型》——显存约等于参数量乘精度字节,再加余量。
本文由 AI 辅助生成,经人工审校。