ARTICLE · 1030743
我用AI写了一款文档翻译工具,终于解决翻译完排版全乱的噩梦
我用AI写了一款文档翻译工具,终于解决翻译完排版全乱的噩梦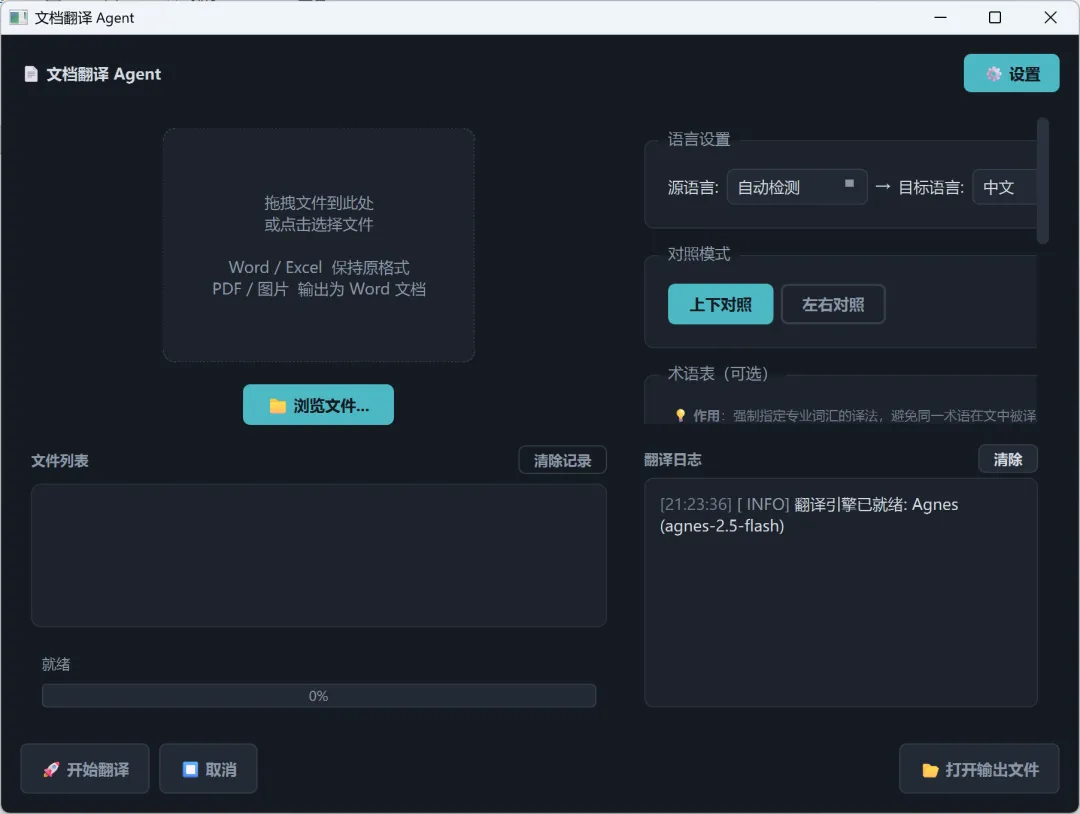
市面上不少翻译工具,要么只输出纯文本,要么按页数收费,涉密内部资料还需要全部上传第三方服务器。为了解决这个真实痛点,我利用AI辅助开发,从零实现了一款本地文档翻译助手,今天和大家分享完整开发过程与踩过的各类坑。 这款工具的核心原则很简单:绝不改动原文,译文全部作为新增内容输出。 针对不同文件类型做了适配:Word文档会在原文下方插入译文,标题、表格、图片、页眉页脚完整保留;Excel译文写入右侧空白单元格,原有单元格、公式完全不动,再也不怕翻译毁掉报表公式;PDF、图片文件经过OCR识别后输出对照Word。同时支持上下对照、双栏左右对照两种阅读模式,满足连续阅读、逐句校对两种使用习惯。 针对专业文档翻译术语混乱的痛点,工具支持导入CSV术语表,锁定专有名词译法,避免同一词汇前后翻译不一致。文件全程本地处理,只有待翻译文本提交大模型接口,整套工具无月费,仅按Token计费,几十页文档翻译成本仅几毛钱。docx、xlsx、PDF、图片等9种格式都支持,覆盖12种语言互译。 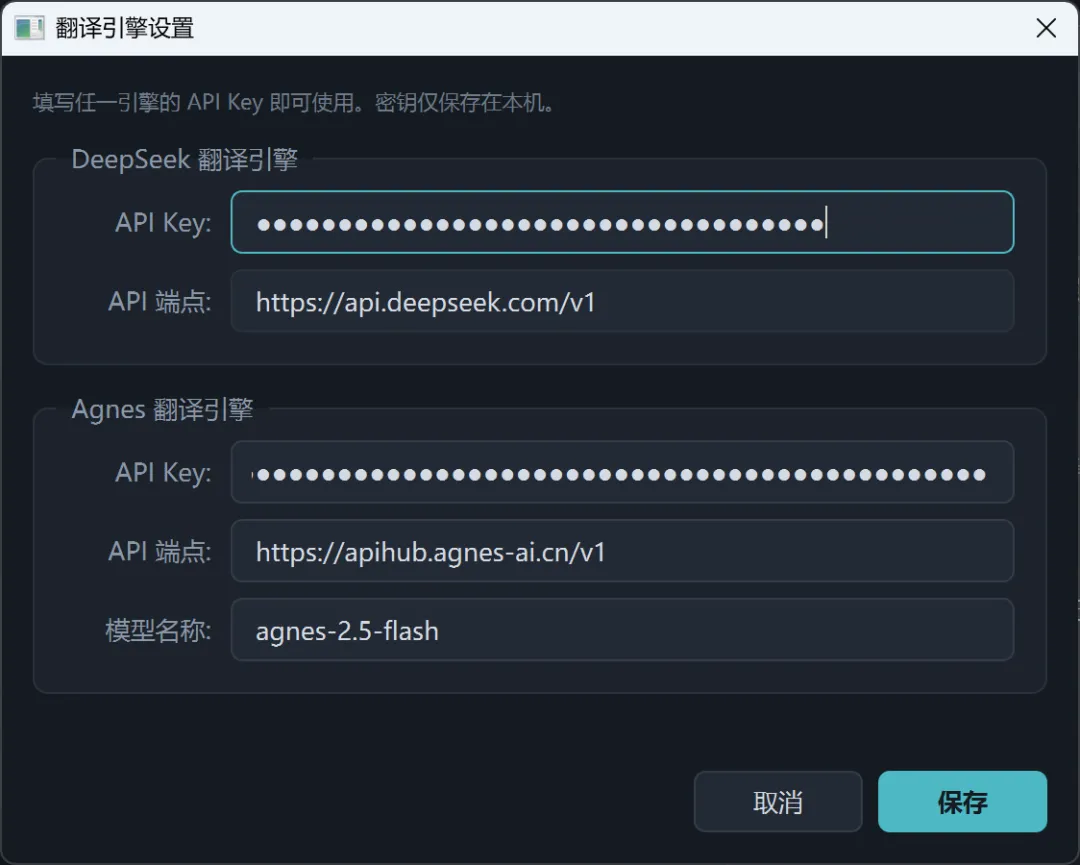
在模型接入上,工具兼容OpenAI标准接口,更换翻译模型只需要修改接口地址与模型名称,本地配置文件保存密钥,用户自行填写API Key。翻译提示词做了大量约束,保证数字、型号、代码原样保留,强制按顺序返回结构化结果,规避模型自由发挥带来的各类bug。 当然AI辅助开发不等于直接交付成品,项目开发过程踩了非常多隐蔽的坑。 长任务取消逻辑缺陷,导致点击取消界面看似死机;f‑string中文符号引发变量解析报错;Windows下OpenCV无法读取中文路径图片,OCR直接静默失败;PDF翻译时模型返回条数不足,直接丢弃已经翻译完成的片段;Excel合并单元格从属格子只读,造成写入报错;AI生成代码留下TODO空实现,扫描版PDF完全没有执行OCR;还有Qt界面样式覆盖、窗口控件挤压、打包DLL缺失等UI与分发问题。 很多bug都不是简单语法报错,而是边界条件、平台兼容、分支逻辑的隐性错误。我的解决思路是每修复一个bug,就补充一条自动化回归测试,当前项目一共4700行代码、29个Python文件,配套19个自动化用例,防止旧问题重复复现。同时拒绝静默降级,把各类异常拆解,输出精准提示给到使用者,不再给出模糊的“无可用文本”报错。 整套工具架构分层清晰:文件上传‑解析提取文本‑加载术语‑分批调用大模型‑写入生成双语文档。后续新增文件格式,只需要实现解析、写入两个模块即可。成品为免安装版本,解压就可以直接运行。 AI极大降低了写代码的门槛,但能运行≠正确。AI可以快速产出代码,可是判断逻辑是否合理、识别隐藏缺陷、补齐边界场景,依旧需要人的判断力。 如果你也被翻译后排版崩坏困扰,或者正在开发同类工具,希望这些实战经验能够帮你少踩弯路。
平时阅读外文技术文档、报表资料,相信很多人都遇见过这样的糟心事:把文档丢进翻译工具,译文出来了,但表格错乱、标题层级丢失、图片移位,想要对照原文查看,找位置的时间比读文档还要久。