ARTICLE · 1037310
AI 编程助手的开关形同虚设:一起传闻背后的后训练数据饥渴
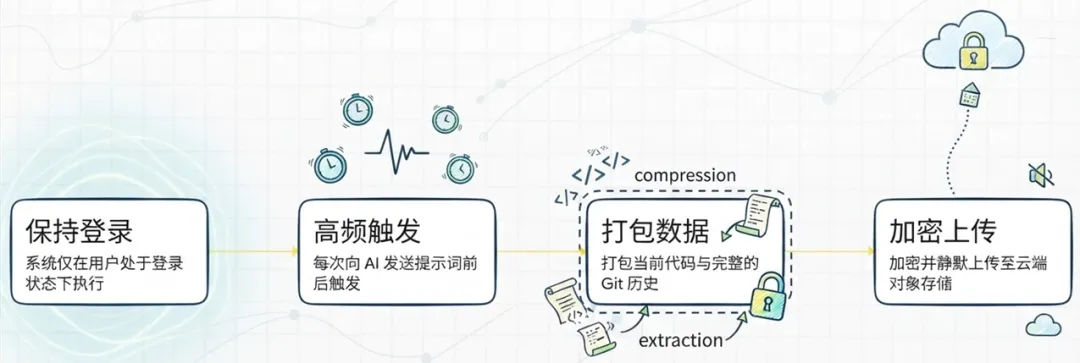
据称,只要用户处于登录状态,它就会在后台静默打包工作区内的代码相关数据。不仅包括当前代码,还包括完整的代码仓库 Git 的提交历史、Git LFS 资产缓存(用于存储大文件的 Git 扩展)以及未推送的本地分支。
打包后加密,上传至云端对象存储。触发很密集:据称每次向 AI 发送提示词之前和每次任务完成之后都会触发一次,前提同样是登录状态下。
该事件曝光后,厂家紧急出来道歉和解释事情原委,并且承诺开源编程助手来接受大家检查。
我们暂时抛开事件原委的细节不去讨论,先解拆个中的暴露出来的问题。
这件事精准踩中了正在发生的一个行业矛盾:模型能力的边际提升,越来越依赖后训练阶段的数据质量,而不只是预训练规模的堆叠。
所谓后训练,指的是模型完成基础预训练后,用更高质量、更专有的数据做进一步微调或对齐的阶段。
这个阶段的数据需求,和模型运行时临时读取上下文,是两件完全不同的事。这起传闻,恰好是观察这个矛盾如何在产品设计层面落地的一个样本。
传闻中最关键的技术细节,是加密方式。上传前,客户端用一把公钥加密整个数据包。这把公钥由服务器实时下发,对应私钥只保存在厂商一端。
加密本身不是问题,问题在于:这份密文用户自己解不开,客户端本身也解不开。如果传闻属实,在正常架构下,唯一具备解密能力的只有厂商后端。
如果这项功能真是为了用户端的"回滚"或"跨设备同步",密钥没有理由不留在本地。就像 Git 自身的对象库,或者 Mac 电脑的 Time Machine 备份那样。
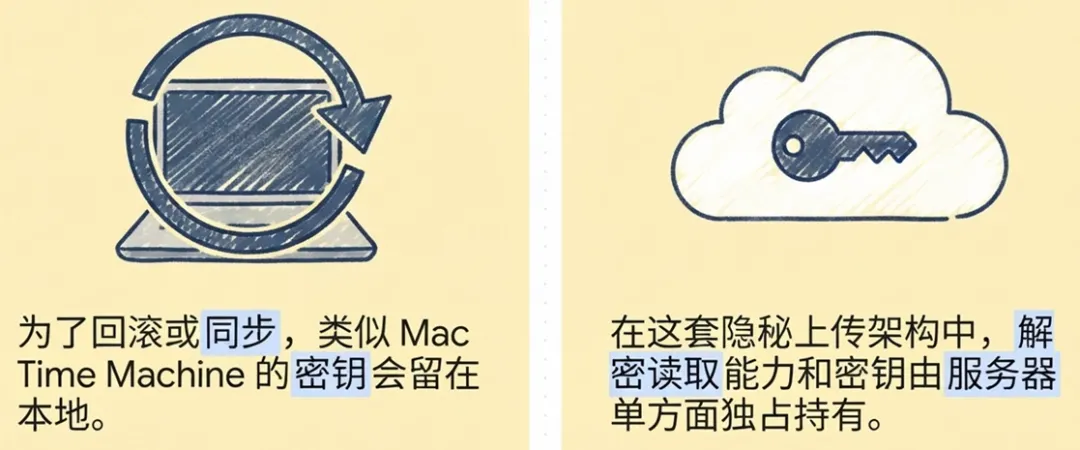
密钥由服务器单方面持有,从技术特性来看,最直接的结果就是:只有厂商后端可以解密读取完整数据包。
传闻还提到,设置面板里有两个看似相关的开关。一个叫"优化体验",一个叫"仓库快照索引"。从命名看,用户会理所当然以为关掉它们能阻止这类行为。
但据称,前者只控制数据是否被"授权用于模型训练",后者只控制服务器是否对上传内容建立索引。真正的数据抓取与上传逻辑,独立于这两个开关,登录之后便会执行,不会读取开关的配置状态。
换句话说:只要登录着,这条后台管道就一直开着,界面上的勾选改变不了这个事实。
动机:为什么这更像后训练数据采集
推理阶段需要的数据,是任务相关和用完即焚的片段。后训练真正稀缺的,是完整项目从草稿到成熟的演化轨迹,是大规模私有代码库,是公开网络爬虫永远触及不到的企业级真实工程实践。
各家模型早已把互联网上高质量的公开语料消耗得差不多了。"专有代码"正在成为下一阶段模型能力差异化最稀缺的原材料。
代码仓库 Git 的历史恰好完整保留了这种演化轨迹,这也是它比单纯的当前代码更有价值,也更危险的原因。因为里面往往还躺着开发者以为早已删除,但实际上从未真正消失的历史版本密钥和敏感配置。
在这样的背景下,一套具备这些特征的静默采集管道:用户无法关闭、密钥由厂商独占、隐私政策是否覆盖这类上传也不清楚。
它很难简单归因为普通产品疏漏,更像是一套经过架构层面设计的数据获取安排。密钥单方面归属这个设计,需要工程团队主动做出选择,很难简单归为"考虑不周"。
当然,架构选择也可能出于成本、同步效率等其他考虑。这一点应该留有余地。
目前还不能确认上传后的数据是否确实进入了训练管道,但是从获取用户的本地代码和 Git 历史这个行为,可以分析出用于大模型后训练是合理的。
后训练数据的稀缺性,解释了大模型厂商为什么有动机做这件事;开关在架构层面不接管数据流,解释了为什么用户难以阻止这件事。前者是动机,后者是机制。
危害:多个层面受影响
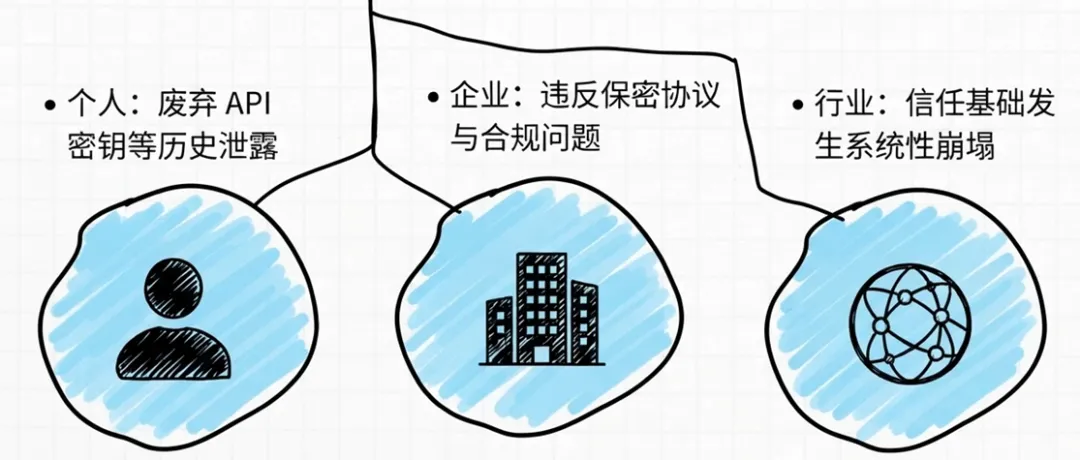
对个体开发者而言,最直接的风险是历史泄露。
Git 对象库不会因为一次删除操作就清空历史。被"删掉"的 API 密钥、内部服务器地址和认证信息,都有可能通过这类静默上传被重新打包,留存在第三方手里。
因为该厂商没有公开说明助手存在该行为,开发者本人基本是不知情的。
对企业用户而言,风险升级为合规问题。很多企业允许开发者在本地安装第三方 AI 编程工具,却缺乏对这类客户端静默外发行为的管控。
一旦涉及受保密协议约束的商业代码、或受行业数据出境规则限制的项目被动流出边界,实际承担后果的,往往是那个毫不知情、只是打开了一个开发工具的个人,而不是做出这项设计决策的厂商。
对整个行业而言,代价更系统性。这类传闻真正动摇的,是用户对"隐私设置"这类 UI 控件本身的信任基础。
如果一个标着"关闭"的开关,并不真正控制底层的数据流,那么用户面对任何厂商的隐私声明和设置界面,都需要多一层怀疑。
这种信任损耗一旦扩散,受损的不只是一家公司,而是 AI 工具生态与用户之间本就脆弱的信任关系。
结语
目前被这份传闻指向的是某一款产品,但驱动这类设计的激励结构是具有行业共性的。
当"从哪里获取高质量的后训练数据"这个问题的答案,开始从公开抓取悄悄滑向产品内嵌式的静默采集时,用户和监管者都需要正视这个趋势。它不会止步于一家公司。
如果连技术能力相对充分的开发者,可能都要靠给文件系统目录加锁才能自保,那么普通用户面对同样的设计,几乎没有任何有效的技术反制手段。
真正的隐私保护,应当让采集行为由用户显式可控。客户端隐私开关与底层代码行为是否一致,或许也该成为审视这类工具时,一个值得优先核查的方向。
你用 AI 编程工具吗?你怎么看此次事件?欢迎评论区说说。
( 封面图摄于广州珠江新城CBD )
延伸阅读:
智谱在收敛,MiniMax 在冒险:财报揭示谁更接近大模型的商业闭环?