ARTICLE · 1069581
把折叠问题倒过来:AI 是怎么从零开始造蛋白质的
把折叠问题倒过来:AI 是怎么从零开始造蛋白质的
2018 年的诺贝尔化学奖,颁给了定向进化——在天然蛋白质上做修改。2024 年的化学奖,一半给了"设计全新的蛋白质",一半给了"预测蛋白质结构"。
从"改"到"造",中间隔着一次方向的反转:以前是给一段序列算它折成什么样,现在是先画出一个结构,再让模型反推该用什么序列。
这篇把这条流水线拆开讲:四个步骤各自在做什么、成功率到底是多少、哪些事情模型做不了。文中只谈公开方法学与文献数据,不涉及任何医疗建议,提到的药物与疗法仅作为文献案例出现。
 封面
先把"预测"和"设计"分开
这两件事听起来像一回事,方向其实相反。
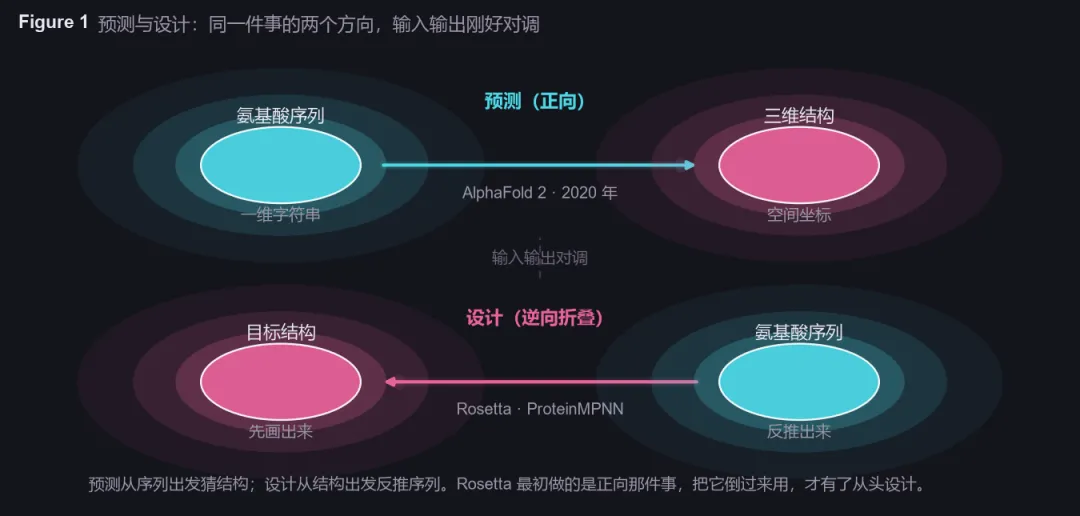
预测回答的是:手上有一段氨基酸序列,它会折成什么三维形状。设计回答的是:想要一个有某种功能的形状,该用什么序列去实现它。
一个从序列出发,一个从结构出发。输入输出刚好对调。
预测这一侧的转折点在 2020 年。CASP 是蛋白质结构预测的年度评测,从 1994 年办到今天,评测分数叫 GDT,满分 100。此前十几年,最难的那批靶点一直卡在 40 上下。2020 年 AlphaFold 2 上场,96 个靶点的中位分到了 92.4,约三分之二的靶点达到与实验解析结构相当的精度。两年后它把超过两亿个结构预测免费公开,到 2024 年已被 190 个国家的两百多万研究者使用。
设计这一侧走的路更长。上世纪九十年代,华盛顿大学的 David Baker 带团队做了 Rosetta:从已知蛋白质里挑结构片段,用能量优化把它们拼成想要的新形状,再找出能折成这个形状的序列。这套流程后来被称为从头设计(de novo design)。
关键动作发生在把这套流程倒过来用的时候。Rosetta 原本做"给序列算结构",倒过来之后,研究者可以先把想要的形状画出来,让程序回答"该用什么序列"。
2024 年的诺贝尔化学奖正是这样分成的:一半给 Baker,表彰计算蛋白质设计;另一半给 DeepMind 的 Hassabis 和 Jumper,表彰用神经网络做结构预测。这两个方向在评奖词里被并列写在一起,是因为它们现在组成了一条完整的工作流。
 预测与设计的方向对比
这条流水线一共四步
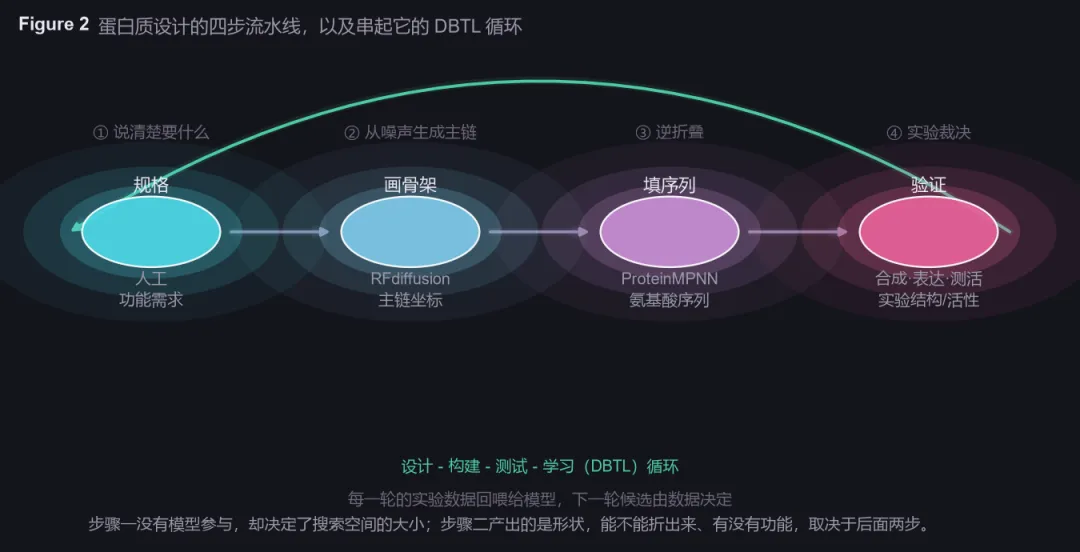
现在的蛋白质设计,主流做法是一条四步流水线。每一步的输入、模型和产出都不一样。
 四步流水线总览
步骤一:说清楚要什么
这一步没有模型参与,但它决定了后面所有计算的方向。
要回答的是几个具体问题:这个蛋白质要结合哪个靶点的哪个位点,还是要催化某个反应?在什么条件下工作(温度、pH、溶剂)?需要多稳定、多好表达?对大小有没有限制?
规格具体到什么程度,举个例子。"设计一个蛋白质"没法算。"设计一个 80 到 120 个氨基酸的蛋白,结合某个靶点的这块表面,对称性为 C3,热稳定性要好,在大肠杆菌里能可溶表达”。这才是一份能喂给模型的规格。对称性约束、靶点表面热点残基、长度区间,这些东西都可以作为条件写进生成过程。
规格写得越具体,后面的搜索空间越小。一个要求"结合 IL-2 的某个表位"的设计,和一个只说"造个蛋白质"的设计,计算量与成功率完全是两个量级。
步骤二:画骨架(RFdiffusion)
有了规格,第二步是生成一条符合要求的主链(backbone)——也就是氨基酸骨架的三维坐标,先不管序列。
这里用的模型叫 RFdiffusion,扩散模型,2023 年发表在 Nature。它的做法是从一团随机噪声出发,逐步去掉噪声,最终得到一条满足条件的主链。可以指定结合某个靶点,可以约束对称性,可以设定长度上限。已报道的案例里能生成到 600 个氨基酸,也能产生天然蛋白质数据库里没有的拓扑结构。
这一步产出的是"形状",不是"蛋白质"。形状能不能真的折叠出来、有没有功能,取决于后面两步。
步骤三:填序列(ProteinMPNN)
拿着一条主链坐标,要找出一条能折叠成这个形状的氨基酸序列。这个问题叫逆折叠(inverse folding),用的工具叫 ProteinMPNN,2022 年发表在 Science。
它的评价指标叫序列回收率:用模型给某个已知结构设计序列,再看这条序列与天然序列的吻合比例。ProteinMPNN 做到 52.4%,同一基准下 Rosetta 大约是 32%。
回收率五成听起来不高,但这里有个容易读歪的地方:回收率高代表保守,不代表好。一个与天然序列吻合度很高的设计,等价于模型在复述已知答案;真正有价值的是那些回收率不高、却仍然能折叠出目标结构的新序列——那才是模型在提供自然界没给过的东西。ProteinMPNN 设计的序列,实验验证的折叠成功率超过一半。
步骤四:验证,以及那条 0.6 埃的线
前三步都在计算机里。第四步是把序列合成出来、表达、纯化,再测它到底折没折成想要的形状、有没有功能。
这里有一个能把整条流水线串起来验证的做法:把设计出来的序列喂回 AlphaFold,让它预测结构,再与最初画的那条主链比对。两个模型给出的形状高度一致,说明设计在计算层面自洽;真正作数的还是实验解析出来的结构。
RFdiffusion 的那篇 2023 年 Nature 论文里,实验解析出的结构与设计主链的偏差可以低到 0.6 埃。作为参照,两个原子之间共价键的长度在 1 到 2 埃之间——设计图和实物已经接近同一个东西。
为什么是现在
这条流水线在五年前搭不起来。变化发生在三个地方。
物理能量函数换成了学习到的先验。 Rosetta 那一代方法靠人工写能量项:氢键怎么算、疏水堆积怎么算、二硫键怎么加分。这套规则管用,但每加一条新约束都要人工调参,而且规则之间会打架。现在的模型不再手写规则,直接从蛋白质数据库里学"什么样的主链是合理的"。数据库里几十年的实验结构,成了模型的先验知识。
序列本身变成了可学习的对象。 蛋白质语言模型把氨基酸序列当"句子"来读,从几亿条自然序列里学统计规律。有意思的一点是:AlphaFold 2 需要同源序列做比对才能预测准,而新一代语言模型看一条孤立序列也能给出结构。对那些没有任何同源信息的全新设计,路是通的。
算力和数据规模到了阈值。 公开解析的实验结构有十几万条,AlphaFold 的训练用了上百块 GPU 跑数周。这个量级在 2010 年前后不可想象。
三个条件凑齐,才有了 2020 到 2024 这几年的集中爆发。
19% 是个什么水平
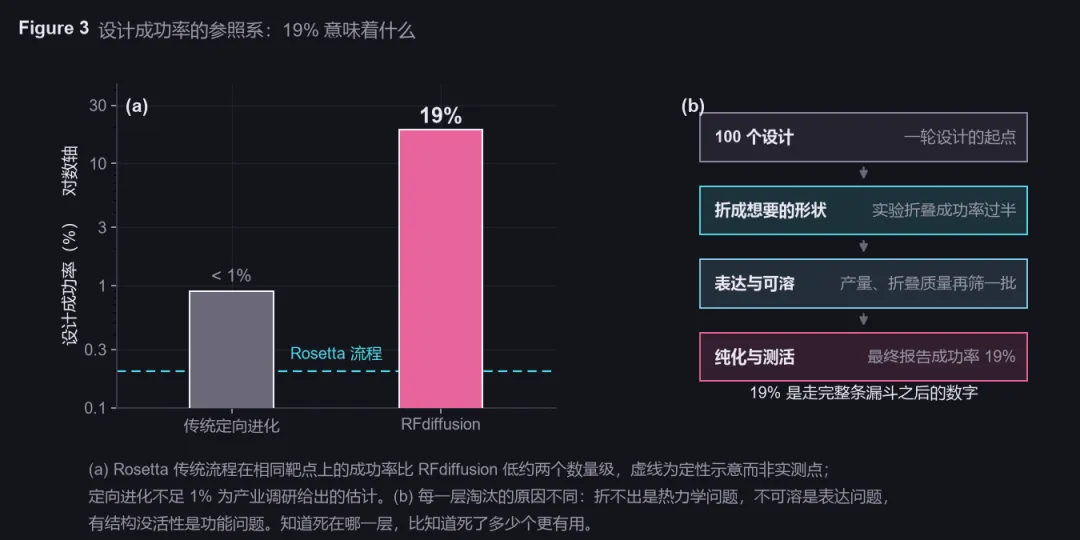
Watson 等人 2023 年的那项工作测了一大批针对不同靶点设计的结合蛋白。判定标准是结合响应达到阳性对照最大响应的一半以上,整体成功率 19%。这些分子不需要再做进一步的实验优化,亲和力就能到纳摩尔级别。
19% 这个数字需要放在参照系里读。
同一批靶点上,用 Rosetta 传统流程做设计,成功率比这低大约两个数量级。传统定向进化这条路,有产业调研给出的成功率不足 1%。
所以 19% 的含义是:从"盲筛上千个才碰上一个"变成"做二十个能成一个"。它远没有到"想要什么就有什么"的程度,但已经把这件事从碰运气变成了可以计划的工程。
淘汰是从头开始的,而且每一层的死因不一样。ProteinMPNN 设计的序列,实验折叠成功率过半。也就是说,光是"折成想要的形状"这一层就要砍掉一半。折出来的还要过表达这一关(可溶性、产量够不够),再过纯化,最后才轮到测活性。RFdiffusion 报告的 19%,是走完这整条漏斗之后的数字。
这也给排查失败提供了抓手。折不出来是热力学问题,回去查主链是否合理;能折但不可溶是表达问题,去调序列的表面电荷分布;有结构没活性是功能问题,活性位点的几何要重新看。知道在哪一层死掉,比知道死了多少个更有用。
还有一个更实际的推论。成功率没到 100%,第四步的实验验证就不能省。模型给出的是候选,实验给的是裁决。把"设计-构建-测试-学习"这个循环跑起来,才是这套方法真正的用法。
 成功率对比
一个真正能落地的方向:造酶
结合蛋白之外,酶是这条流水线在合成生物学里分量更重的一个落点。原因很直接:生物制造卡在催化剂上。有调研数据显示,仅制药、化工、农业三个领域,因缺乏理想酶导致的年产能损失就超过千亿美元。而天然酶只认自然界已有的反应,新型塑料、特定药物中间体、难降解污染物这些人造分子,大多没有现成的酶可用。
2025 年有一项工作把这条流水线推到了酶上:用 RFdiffusion 生成丝氨酸水解酶的主链,再用一个叫 PLACER 的活性位点优化网络精修。设计出的酶能加速一个四步化学反应,催化效率比此前工程化的水解酶高出 60000 倍。这是头一回有从头设计的酶加速多步反应。
另一条思路是条件生成:给模型一个酶的分类编号(EC number),让它生成符合该类催化功能的全新序列。代表工具叫 ZymCTRL,思路接近语言模型的受控生成:输入一个功能标签,输出一段序列。它绕开了"必须先有天然模板"的限制。
从序列预测催化效率
画骨架、填序列之外,还有一条并行的路线:不去创造新酶,而是从海量已知序列里预测哪个变体的催化效率更高。
这类模型把蛋白质序列和底物结构分别编码成向量,再预测 kcat、Km、kcat/Km。评价指标常用对数均方根误差,越小越好:新一代工具把 kcat 的误差压到 0.22,上一代同类工具是 0.41。
拿一个香草醛合成相关的酶做例子。野生型的 kcat/Km 是 120,模型从一万五千多个突变体里挑出高活性变体,提升到 3440;再叠加定向进化,做到 12830。三个数之间隔了两个数量级,靠的是排序,靠的是先测最有希望的那一批。
这类工具的价值在于把实验次数压下来。传统定向进化要在上万个变体里盲筛;有了预测模型,先排序再测,测的是最有希望的那几十个。数据库层面也跟上了:有工作只要求输入底物的 SMILES 和蛋白序列,就能批量给出 kcat 预测值,并把这些结果整理成公开数据库。
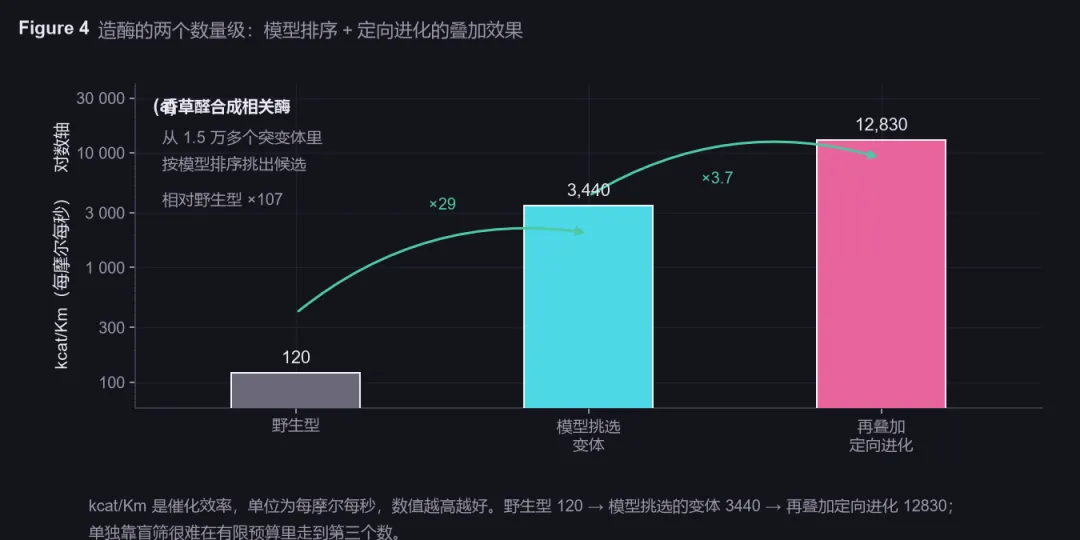 造酶案例:模型排序 + 定向进化的叠加
无细胞体系 + 主动学习
对做无细胞蛋白表达(TXTL)的人来说,有一条路线值得专门看。
2025 年的一项工作把机器学习直接接到了无细胞基因表达体系上,构成一个闭环:模型提出候选变体,无细胞体系当天表达出来、当天测活性,数据回喂给模型,下一轮再提。这个循环有个固定名字,叫设计-构建-测试-学习(DBTL)。
无细胞体系在这里有几个天然优势。它不用养细胞,省掉转化、克隆、扩大培养;反应体积可以压到微升甚至纳升,一块 96 孔板能并行跑几十个变体;表达和测活可以接在一起,当天出数据。传统路线里,光是构建一个突变体质珠再等它长出来就要一两天。
这套平台在一轮验证里评估了 1217 个酶变体、10953 个反应,得到一个活性提升 42 倍的酰胺酶。传统方法做同样的事要几周到几个月,这里以天计。
这类体系的门槛不高,无细胞表达可以批量做在孔板里。它真正的瓶颈不在设备,在于每一轮该选哪些变体去测。选得好,几轮就收敛;选得差,测一堆平庸变体浪费预算。这正是模型能帮上忙的地方:用预测值排序,用不确定性决定要不要冒险测一个冷门候选。
从单个酶到整条通路
前面讲的都是一个蛋白。合成生物学真正要面对的,常常是一条通路:三五个酶排在一起,把底物一步步变成产物。
这时候问题就换了一层。单个酶活性再高,通路不一定通:上游酶快、下游酶慢,中间产物会堆积;辅因子消耗了没人回收,走几步就停;副反应把流量引到别处,产物得率上不去。
这一层的模型要回答的问题也不同。哪些酶的搭配在热力学上可行?几个酶的表达量该怎么配比,中间产物才不会积累?辅因子怎么再生?某一步的副产物会不会反过来抑制别的酶?
这类通路级建模已经有可用的产出。有工作把测量条件(pH、温度、辅因子种类)作为输入喂给模型,再拿预测结果去筛高活性酶候选、指导定向进化,在一个酪氨酸氨解酶上把催化效率提升了 3.5 倍。系统层面的建模也被用在多糖降解、木质素高值化、萜类合成这些多酶过程上,把酶的组织方式显式纳入预测之后,通路设计的可靠性上来了。
这里其实才是“机器学习 + 合成生物学”交汇实在的地方:AI 帮你的地方未必在造一个蛋白,更多时候是在几百个可能的组合里,找到那个能跑通的。前者是分子问题,后者是系统问题。
它做不到的事
把能力边界说清楚,比列功能更重要。
设计不等于有功能。 19% 的成功率已经说明了这一点。主链画得再准、序列填得再合理,折叠出来未必有活性。活性位点的几何、过渡态的稳定、底物进出的通道,这些都还会出问题。
构象柔性基本算不了。 酶要"动"才能催化:诱导契合、别构调节、loop 的开合。现在的模型大多在静态结构上工作,把蛋白质当成一个刚性的形状来处理。真实催化里那些毫秒级的动态,模型看不到。这也是为什么设计出的酶常常要再叠一轮定向进化,把"能用"磨成"好用"。
零样本是硬缺口。 模型的训练依赖已知的酶-底物配对数据。遇到自然界没有的人造分子,训练集里找不到相近的例子,预测就会失灵。目前的解法之一是检索增强:先从结构库里找与目标底物相似的分子,拿这些线索当作生成时的参照,再让模型补全剩下的部分。2025 年有相关工作发表在机器学习顶会 ICML,声称对全新底物也能按需生成,但离通用还有距离。
数据比算法更卡脖子。 公开的 kcat、Km 数据只有几万条量级,而且测量条件不一、口径混乱。同一个酶在不同 pH、温度、溶剂下测出来的数不可直接比较,可模型往往不知道这些上下文。把"测量条件"作为输入喂给模型,是这两年才开始的改进方向。
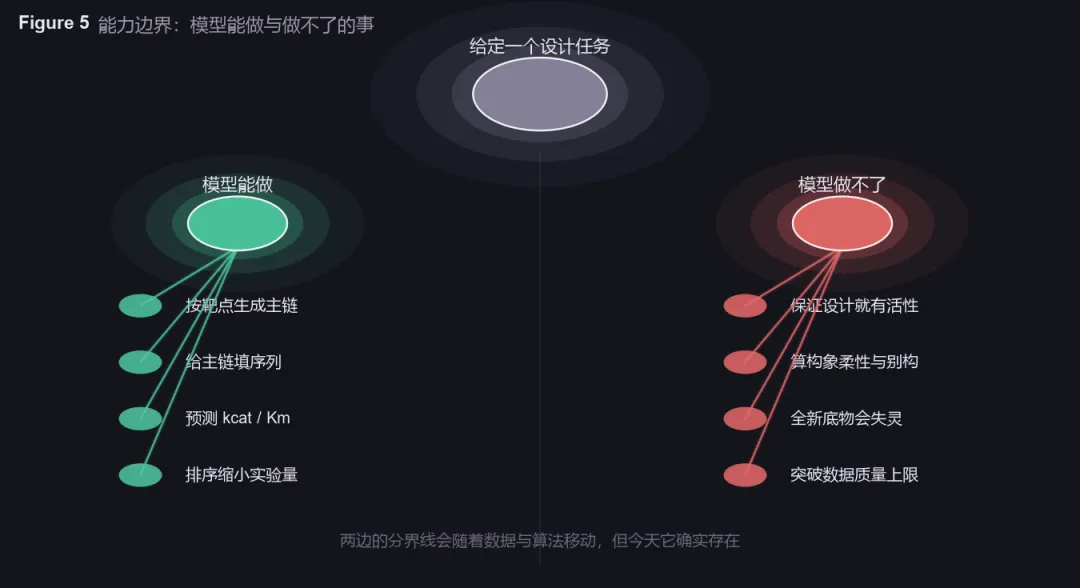 能力边界
想上手的话,从哪里开始
这套流水线的关键工具基本都开源了,硬件门槛也比想象中低。
结构预测:ColabFold 可以在 Colab 上直接跑 AlphaFold 2,不用配环境。AlphaFold 数据库里的两亿个结构可以直接查。
逆折叠:ProteinMPNN 的官方实现开源,给定一个 PDB 主链文件,几行命令就能产出若干条候选序列,还能控制采样温度来调节序列的多样性。
主链生成:RFdiffusion 开源,需要在本地 GPU 上跑。一个 4060 级别的显卡可以处理中等规模的设计任务,更大规模需要租卡。
动力学预测:DLKcat、UniKP 这类工具输入底物 SMILES 和蛋白序列就能给 kcat 预测值,适合在改造某个酶之前先做一轮筛选。
对学生项目来说,现实的切入点是:先选一个有明确功能目标的小蛋白(几十到一百多个氨基酸),用 ColabFold 查它和同源蛋白的结构,再用 ProteinMPNN 做几条变体,送测序表达。整套流程走一遍,比看十篇综述有用。
如果只想先摸一摸,一个周末能做完的事是:装 ProteinMPNN,从 PDB 挑一个自己熟悉的蛋白结构,跑 5 条设计序列,把它们和天然序列做比对,看模型在哪些位置保守、在哪些位置大胆给出了不同的残基。这一步不花实验经费,却能让人直观理解"回收率五成"到底意味着什么。
写在最后
蛋白质设计真正变化的地方,不在某个模型的精度数字,而在方向。
以前要做蛋白质,只能在天然的上面改:找一个已有的酶,饱和突变,筛活性,祈祷运气。这条路能走,但走不远——它受限于自然界已经给过的答案。
现在可以先把想要的形状画出来,让模型回答用什么序列。蛋白质因此从"发现的东西"变成了"可以设计的东西"。设计带来的直接后果是:失败变得可解释,迭代变得可计划。
模型在这条路上给出的所有数字,都得靠一根试管来裁决。这也正是它依然迷人的地方——算法提候选,实验做裁决,两边都不能省。
参考资料
[1] Jumper J, Evans R, Pritzel A, et al. Highly accurate protein structure prediction with AlphaFold. Nature, 2021, 596(7873): 583-589.
[2] Watson J L, Juergens D, Bennett N R, et al. De novo design of Protein Structure and Function with RFdiffusion. Nature, 2023, 620(7976): 1089-1100.
[3] Dauparas J, Anishchenko I, Bennett N, et al. Robust deep learning-based protein sequence design using ProteinMPNN. Science, 2022, 378(6615): 49-56.
[4] The Nobel Prize in Chemistry 2024. NobelPrize.org. https://www.nobelprize.org/prizes/chemistry/2024/summary/
[5] Lauko A, et al. De novo design of serine hydrolases. Science, 2025.(RFdiffusion + PLACER 设计四步反应酶)
[6] Wang Z, Xie H, et al. CataPro: accurate and generalizable prediction of enzyme kinetics. 2025.(SsCSO 与香草醛合成酶案例)
[7] Yu H, Deng H, et al. UniKP: a unified framework for the prediction of enzyme kinetic parameters. Nature Communications, 2023, 14: 8216.
[8] Li G, et al. Deep learning-based kcat prediction enables improved enzyme-constrained model reconstruction. Nature Catalysis, 2022, 5: 662-672.
[9] Landwehr M, et al. Machine-learning-guided cell-free gene expression for rapid enzyme design and evolution. 2025.(1217 变体 / 10953 反应 / 酰胺酶 42 倍)
[10] Feruz S, et al. ZymCTRL: a conditional language model for the controllable generation of artificial enzymes. NeurIPS 2022 Workshop on AI for Science.
[11] Meng S, Cui H, et al. AI-driven enzyme engineering: from single-enzyme modeling to pathway design. BioDesign Research, 2025. DOI: 10.1016/j.bidere.2025.100044
[12] Baek M, DiMaio F, Anishchenko I, et al. Accurate prediction of protein structures and interactions using a three-track neural network. Science, 2021, 373(6557): 871-876.(RoseTTAFold)
[13] Abramson J, Adler J, Dunger J, et al. Accurate structure prediction of biomolecular interactions with AlphaFold 3. Nature, 2024, 630: 493-500.
[14] Arnold F H. Directed evolution: bringing new chemistry to life. Angewandte Chemie International Edition, 2018, 57(16): 4143-4148.
[15] Ferruz N, Schmidt S, Höcker B. ProtGPT2: a deep unsupervised language model for protein design. Nature Communications, 2022, 13: 4348.