ARTICLE · 1096297
【连载3】面向 AI+ 兵棋 | 解密 System1:作为概率编程载体的 Jev‑like 族
第 3 章 | 概率与置信度计算
第 4 章 | 结构化决策映射
第 5 章 | 置信度校准与训练(RLCD)
结束语
第 3 章 | 概率与置信度计算
3.1 从 logits 到概率
_decode_answers 是模型推理之后的后处理解码总入口。神经网络输出原始 logits,这个函数负责完成温度缩放、softmax 归一化、区分三类原语(choice / score / noul)做不同解析、计算两套置信度、组装对外 JSON 结果、填充 act 元认知输出。
# 来源:laya-main/laya/agent.py#L759k = len(items[j]["markers"]) # 该问题的真实选项数qt = QTYPES[q["t"]] # 0 / 1 / 2t_scale = self.temperature_by_options.get(temp_bucket(qt, k), self.temperature[qt])if lang and lang.split("-")[0].lower() in self.lang_temperatures:l_cfg = self.lang_temperatures[lang.split("-")[0].lower()]t_scale = l_cfg["temperature_by_options"].get(temp_bucket(qt, k), l_cfg["temperature"][qt])z = logits[r, :k] / t_scale # 温度缩放p = np.exp(z - z.max()); p = p / p.sum() # 数值稳定 softmax
核心步骤是取出对应问题的原始 logit 子集,把 batch 里无效 padding 列剔除,只取当前问题真实候选数量 k 对应的 logit,不拿 padding 占位的无效维度。读取分桶温度系数 T,并做钳制,根据 (原语类型,选项数量) 查表获得温度;多语言场景会使用语言专属温度;把 T 强制限制在区间 [0.5,5.0]。
温度缩放 + softmax,计算研判概率
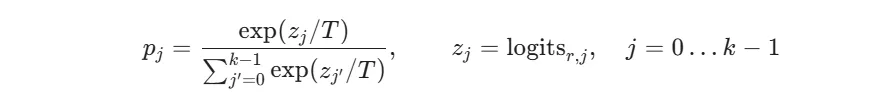
使用指数函数 exp(z-max(z)) 做数值稳定,防止指数溢出。
原语分支解码的三类逻辑完全不一样:
choice(多候选判别)
argmax 选出概率最大标签
完整保留全部候选的 probabilities 字典
计算两套置信(见第3.3章节)
score(有序等级研判)
输出离散各档位概率
求数学期望得到连续分值
同样输出两套置信度
noul(二元布尔判别)
固定取索引 1,noul = p[1],即P(true)
noul 场景下两套置信天然相等:confidence == answer_confidence
接下来,解析 act_head 输出,对 act_logits 做 softmax,提取 act_probability(实验性,禁止生产拒判)。然后,组装对外 JSON 结构,输出标准化结果,包含 type、主答案、probabilities、两套置信、action 字段。
3.2 温度桶与钳制
softmax 的过自信程度与 k 强相关,2 选项时 logit 差 3 就给出 0.95,20 选项时要给出同样的 0.95 需要拉开更大的差距。Laya 按选项数分 3×4=12 个桶。temperature 是长度 3 的列表(按 qtype 索引),temperature_by_options 是「桶名 → 温度」的字典,桶优先于类型默认。
# laya-main/laya/common.py#L367size = "2" if k <= 2 else "3-5" if k <= 5 else "6-10" if k <= 10 else "11+"key = f"{QTYPE_NAMES[qtype]}:{size}" # 例如 "choice:11+"、"noul:2"、"score:3-5"
温度公式:
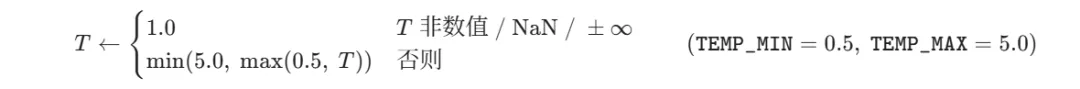
源码注释给出了下界的动机:
A fitted temperature below 1 sharpens the logits instead of softening them. The shipped choice:11+ bucket is 0.1006, which multiplies them ~10x: a 0.24 top probability is published as 0.99, so a caller gating on confidence is told a coin flip is a certainty. No honest calibration needs to sharpen this hard, so refuse to apply one that does.
即
拟合得到的温度系数小于 1 时,会锐化 logit 值,而非平滑。本项目发布参数:11 + 分组的温度值为 0.1006,相当于将 logit 放大约 10 倍:原本 0.24 的最大概率会被输出为 0.99。这就导致基于置信度做筛选的调用方,会把近似抛硬币级别的猜测判定为确定结论。任何严谨的校准都不需要如此高强度的锐化,因此应当拒绝使用这类参数。
也就是说:基于置信度门控的调用方会被告知「掷硬币是确定的」,所以它在加载时被钳到 0.5 并触发 RuntimeWarning。
3.3 两种置信度
Laya 在解码阶段定义了两种置信度,语义完全不同,使用场景不能混淆。
第一种 answer_confidence 最简单,直接取所有候选中最大的概率值。它经过温度校准,含义直观稳定,业务研判、阈值门控优先使用这个指标。它只关注最优选项的概率大小,但看不到其余候选之间的竞争关系。
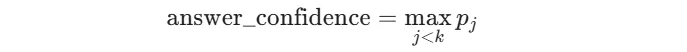
answer_confidence(p, k) 的 docstring 原文:
Probability mass on the answer being reported: max(p). This is the quantity temperature scaling fits, and the quantity every calibration figure in this repository is computed on -- both benchmark harnesses take conf = max(probs) before calling ece_score. It is therefore the one confidence with the property the README's gating section relies on: of the answers returned at confidence c, about c of them are right.
即
输出答案对应的概率质量:max(p)。这正是温度缩放所拟合的量,也是本代码仓库中所有校准图的计算依据 —— 两套基准测试框架在调用 ece_score 函数前,均取置信度conf = max(probs)。因此,该置信度具备仓库说明文档准入控制部分所依赖的性质:在置信度 c 下返回的答案中,约有 c 比例的结果是正确的。
第二种 confidence,是基于香农熵做归一化的指标,用来衡量整套概率分布整体的集中程度。分布越集中,这个值越接近 1;所有选项概率均等时则为 0。
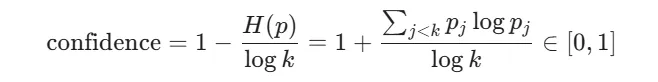
confidence_from_probs(p, k) 的 docstring 原文:
How concentrated the whole distribution is. Useful, but not calibrated: it is not what temperature scaling fits and not what the reported ECE measures.
整个分布的集中程度。该指标具备实用价值,但未经标定:它并非温度缩放所拟合的目标量,也不是期望校准误差(ECE)所要度量的对象。
answer_confidence 盯着第一名的概率,适合业务决策门控,直接回答「模型认为最优选项的概率是多少」,温度缩放校准后,概率具备概率编程意义,推荐兵棋研判、业务判定全部使用这个指标。
confidence 看全部候选的整体分布混乱程度,辅助看不确定性,衡量整套概率分布有多扎堆,但因为公式里除以 log k,候选数量 k 一变,基准就变,不能跨不同候选数场景共用阈值,只适合做内部观测。
在 _decode_answers 完成 softmax 算出 p_j 之后,并行计算这两个置信度,一起塞进输出 JSON。
3.4 三类问题的解码
choice
{"type": "choice","choice": "<keys[argmax_j p_j]>","probabilities": {"<label>": 0.8123, "...": 0.1877},"confidence": 0.6246,"answer_confidence": 0.8123,"action": {"act_probability": 0.9712}}
keys = list(q["crit"].keys()),保留调用方的原始标签对象,不是 str() 之后的版本,与 render_options 的 str(k) 渲染解耦,所以传 int 标签就拿到 int 回来。
score
{"type": "score","score": 1.6842,"legend": {"0": "...", "1": "...", "2": "..."},"probabilities": {"0": 0.0921, "1": 0.2236, "2": 0.6843},"confidence": 0.5312,"answer_confidence": 0.6843,"action": {"act_probability": 0.9712}}
核心数学是期望等级,不是 argmax,即
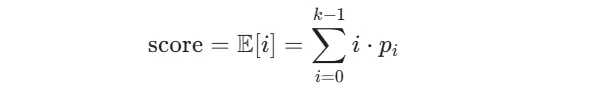
这是 score 与 choice 最重要的差别,它保留了序数信息并输出连续值,因此可以做 MAE / within-1-level 评测,也可以直接当作回归量使用。legend 把索引映射回调用方给的等级描述文本。
noul
{"type": "noul","noul": 0.8123,"confidence": 0.8123,"answer_confidence": 0.8123,"action": {"act_probability": 0.9712}}
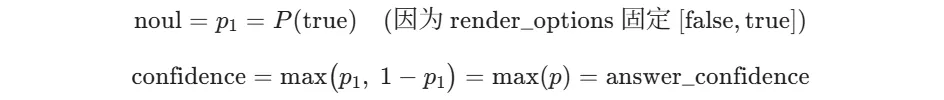
noul 上 confidence == answer_confidence 恒成立。noul 没有 probabilities 字段(只有两个选项,noul 与 1 - noul 已经完备);在 _details 里替它补出 {"false": 1-p, "true": p}。
3.5 act_probability:元认知决策因子
act_head 就是前面提到的实验性元认知分支,它不和候选选项打分共享输出头,单独预测一个高层动作:模型判断「当前我要不要给出研判结果,还是直接弃答、向上转交」。
两套置信度 answer_confidence / confidence 评估候选答案本身的不确定性,回答内容层面的把握。而 act_probability 属于高层元认知决策,判断「我该不该输出这个答案」,是独立的一套判断。
例如,模型算出 answer_confidence=0.8,对候选答案本身把握很高;但 act_probability=0.3。模型知道最优答案是哪一个,但它依然倾向于选择弃答 / 升级,不对外输出结论。
两个指标是两条独立预测通道,不是简单绑定。
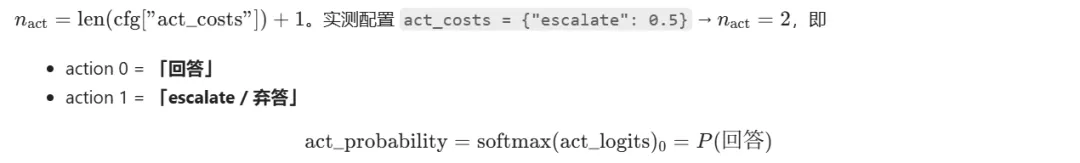
配置里还有 cost_wrong_act = 3.0(答错的代价)。弃答代价 0.5 vs 答错代价 3.0,即弃答比答错便宜 6 倍,这是 act_head 的决策论基础。
仓库文档记录该头目前不携带可用信号,请勿用于生产环境的弃答门控。若要实现「不确定就转人工」,当前可靠的做法是用 answer_confidence 做阈值门控,或用 laya-main/laya/evals.py 里的 AURC / acc_at_50_coverage 口径离线选阈值。
3.6 ECE 与评测口径
对于 System1 这类概率决策模型,单纯看准确率远远不够,我们还需要检验模型给出的概率值是否可信,ECE 就是干这件事的核心指标。
期望校准误差(Expected Calibration Error,ECE),衡量模型概率是否「模型报出来的概率,能不能信任」,是 System1 这类概率编程模型最核心评测指标。
把置信度区间 [0,1] 切分成多个分箱 bins(又称分桶);计算「箱内平均置信度」和「箱内真实准确率」的差值绝对值;再按全部评测样本总数 N,利用落在第 i 个分箱 b_i 内的样本数量 n_i,计算样本数量占比;最后加权求和,得到 ECE;ECE 越接近 0,概率校准效果越好;数值越大,越不准。即
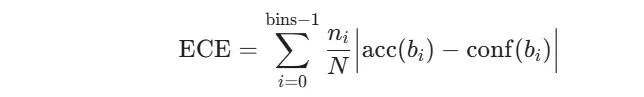
如果一批样本,模型全部输出 answer_confidence=0.8,但这批样本实际只有 60% 答对。|0.6-0.8|=0.2,这部分样本会给 ECE 贡献很大误差,代表模型过度自信。
这就是 Laya 为什么要做分桶温度缩放的根本目标,调节 T,压低 ECE,让输出的概率具备真实概率含义,而不只是单纯的打分。普通大模型输出的概率大多校准很差,ECE 很高;System1 模型的核心卖点就是低 ECE,概率可用于决策、门控、兵棋推演。
第 4 章 | 结构化决策映射
Jev-like 软件族的底层设计,叫做结构化决策映射,由 Nandakishor 提出,是指把自然语言输入直接映射到带类型约束、附带校准概率的结构化决策空间,也就是直接映射到预先定义好、带类型的离散决策选项,同时输出经过校准的概率,不再生成开放式文字。
所谓结构化,即预先定义好任务的可选动作 / 选项集合,比如枚举选项、分类标签、数值范围、路由分支;输出字段固定、可直接被程序读取,不需要再写正则做文本解析。例如:风险等级 {低 / 中 / 高}、审批路由 {A 部门 / B 部门 / 升级}、布尔判断 {是 / 否}。
任务本质是决策问题,不是生成任务;对应卡尼曼的 System 1 快直觉判断。端到端的映射函数,把输入证据(文本、事实)直接映射到决策选项的概率分布。这一步就是概率编程的核心,定义随机变量(各个决策选项),由模型推断后验概率。
普通 LLM 输出 token 概率,token 只是文字,要二次转成决策;System1 的结构化决策映射,直接输出决策空间上的后验概率,和概率编程的随机变量推断完全对齐。差别只在于,传统概率编程是声明式写模型图;而结构化决策映射是数据驱动,学习从证据到决策后验的映射。
从概率编程视角看,结构化决策映射等价于学习一个贝叶斯推断器,给定观测证据,直接输出各个决策的后验概率。传统概率编程需要人工写出整个概率图;而 System1 通过训练,直接学到从输入到决策后验的映射函数。再搭配 RLCD 损失、ECE 概率校准、act_head 元认知弃答机制,让输出的概率具备可用于真实业务决策的可靠性。
4.1 映射规则
下表是 Laya 专用的 Schema 编译规则,用户输入 JSON Schema,Laya 把 Schema 自动翻译成内部决策任务定义,也就是前面说的结构化决策映射的输入约束。
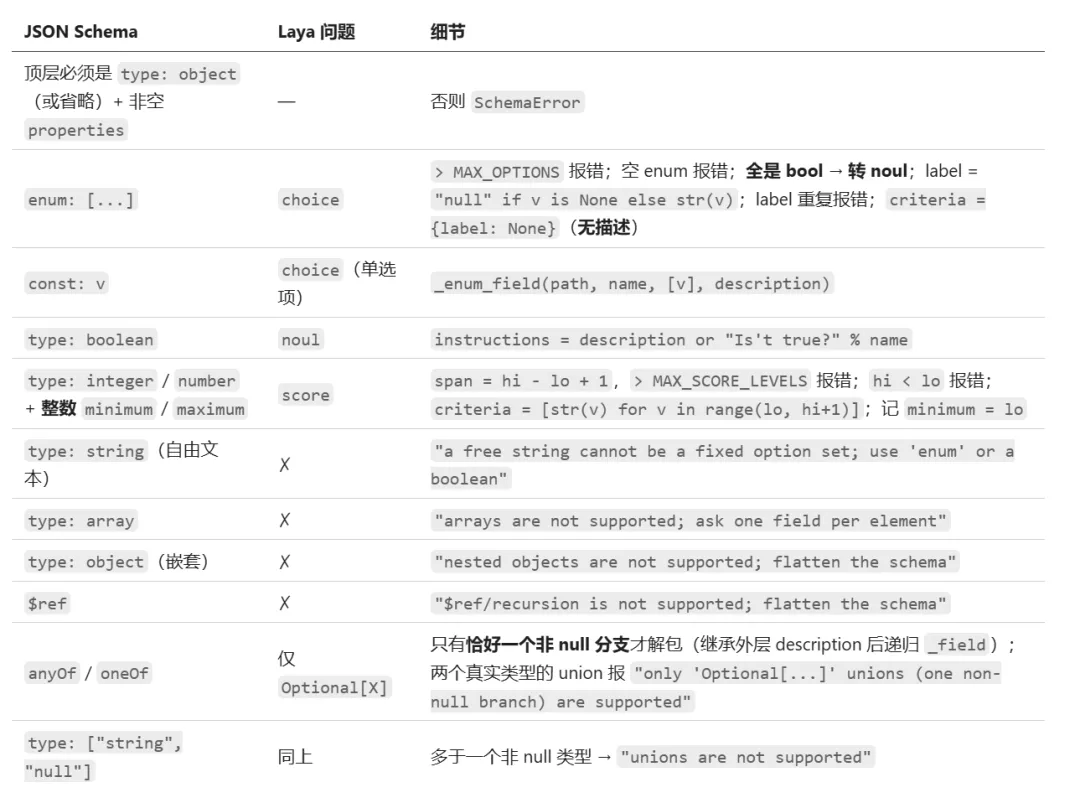
注意:Laya 只支持扁平、简单、非嵌套的 JSON Schema;复杂类型——如数组、嵌套对象、通用联合、引用 $ref——全部不支持,会直接报错。顶层必须是 object,properties 里面每一个字段,会被自动映射成一类决策任务(choice / noul / score)。
顶层:type: object(可省略),整个 schema 最外层必须是对象,properties 不能为空,否则抛出 SchemaError。所有决策字段都放在顶层平铺,不允许嵌套。
enum: [...] → choice 任务(枚举单选),选项数量超过 MAX_OPTIONS 报错;空 enum 报错;标签 label 重复报错;布尔枚举会转为 noul 类型;criteria 字典: {label: None} ,默认不带描述;
const: v → choice 任务(单选固定项),底层调用内部函数 _enum_field(path, name, [v], description),本质是只有一个选项的 enum。
type: boolean → noul 任务(布尔二选一),自动生成提示 instructions:取字段 description,没有则自动生成「Is {name} true?」
type: integer / number,搭配 minimum /maximum(整数范围)→ score 任务(打分),输出区间内离散整数分值,属于结构化数值决策。
type: string 自由文本 → 不支持,Laya 不支持开放式自由文本生成,只做固定选项的结构化决策;要文本,必须改成 enum 枚举。
type: array → 不支持,不能传数组;数组要拆成多个独立顶层字段。
type: object 嵌套 → 不支持,所有嵌套对象必须拍平,全部提升到顶层 properties。
$ref 引用 / 递归 → 不支持,全部要内联展开、扁平化。
anyOf / oneOf → 仅支持 Optional[X],仅允许恰好一个非 null 分支,如果是多个不同真实类型的联合,直接报错。
type: ["string", "null"] → 仅支持 Optional[X],只允许一个有效类型 + null;多于 1 个非 null 类型直接拒绝。
满足上述映射规则,Schema 就可以作为概率编程的模型声明,预先锁定所有可能的决策结果,模型推断每个选项的后验概率。
4.2 后处理解码逻辑
从模型输出概率分布到最终决策值的后处理解码逻辑 _project,是结构化决策映射的最后一步,模型输出概率,通过下面规则算出最终选定结果。
模型输出概率之后,Laya 会根据三种任务类型执行不同解码规则,把概率分布转为确定决策结果:
noul:用 0.5 作为阈值。如果模型预测成立概率大于等于 0.5,则判定结果为真,否则为假。
score:优先使用 argmax,直接挑选概率最高的分值,并非取概率加权期望;仅当完整概率缺失时,才回退到期望加四舍五入。
choice:将模型输出的标签,反向查表映射回预定义选项里的原始值;查找失败时直接保留标签文本。
三类各自的数学表达式:
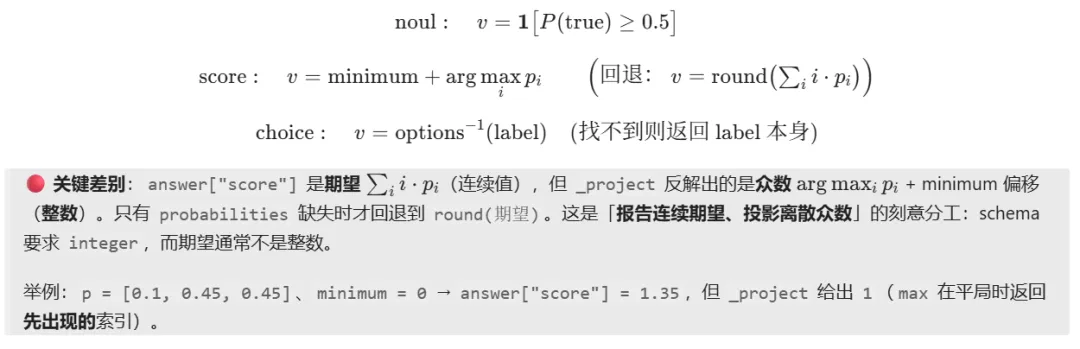
_project 把三类答案投影回 schema 形状的值:
# 来源:laya-main/laya/structured.py#L195if f.kind == "noul":values[name] = bool(float(answer.get("noul", 0.0)) >= 0.5) # P(true) 的 0.5 阈值elif f.kind == "score":probs = answer.get("probabilities") or {}if probs:idx = max(range(len(probs)),key=lambda i: float(probs.get(str(i), probs.get(i, 0.0)))) # ★ argmax,不是期望else:idx = int(round(float(answer.get("score", 0.0)))) - int(f.minimum or 0) # 回退:期望四舍五入values[name] = int(f.minimum or 0) + idxelse: # choicelabel = str(answer.get("choice"))values[name] = next((value for lbl, value in f.options if lbl == label), label) # label → 原始值
第 5 章 | 置信度校准与训练(RLCD)
5.1 训练奖励函数 R(q,g)
强化恰当评分学习(Reinforced Proper Scoring,RLCD)属于策略梯度类强化学习,用恰当评分规则作为奖励,配合 logits 噪声采样,联合策略梯度 + 软交叉熵一起优化模型输出概率分布。
Laya 在 RLCD 训练中,使用一套复合恰当评分规则作为奖励函数。当且仅当模型报告分布 q 和真实目标分布 g 完全一致时,期望奖励取最大值;模型无法靠谎报概率拿到更高期望收益,天然鼓励输出校准、诚实的概率,正好匹配 System1 对可信概率的需求。即
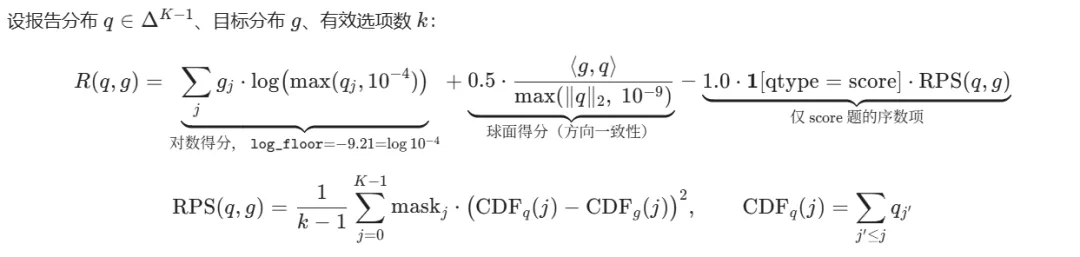
奖励由三部分组成。第一部分是对数得分,对真实标签位置施加概率激励,同时做数值下限裁剪防止对数爆炸;第二部分是球面得分,奖励模型分布向量与目标分布向量方向对齐;第三部分为 RPS 排名概率得分,仅对有序打分(score)任务启用。RPS 对比累积分布曲线,会区分「错在邻近分值」和「错在很远分值」,对打分任务更合理;无序枚举 choice、布尔 noul 任务不启用该项。
模型直接输出真实后验分布 q=g,此时期望奖励最大;任何刻意夸大 / 压低概率的操作,都会降低期望奖励。这就是 Laya 能天然学到可校准概率的理论根基,也是和普通 LLM 交叉熵训练最大的差异。普通交叉熵只惩罚单点标签,不保证概率校准;这套复合奖励从设计上就激励诚实概率输出。
普通大模型的交叉熵损失,本质等价对数得分,但缺少球面项、缺少有序类别的 RPS 约束;而且没有恰当评分规则完整的概率诚实性保证,输出概率经常严重失准,ECE 偏高。而传统概率编程的推断目标就是后验分布。
对数得分、球面得分、RPS 各自都是恰当评分规则,线性组合之后整体仍然保持恰当。这套设计,相当于让神经网络直接学习概率编程里的后验分布是 System1 能够输出可靠、可用于决策的概率,并且能用 ECE 评估校准误差的底层数学保障。
5.2 多轮轨迹目标:TD(λ)
除了结构化决策本身,System1 还需要学习一项元认知决策。在多轮推理轨迹中,判断何时直接给出答案,何时触发 escalate 升级交由外部处理。
act_head 是元认知决策,每一步模型都要输出一个概率,当前是否选择 escalate(放弃作答、向上升级)。这是一个序列决策问题,是否升级,不是只看当前单步信息,要看整条后续轨迹最终结果。采用时序差分 TD (λ),沿着完整交互 episode 轨迹从后向前回溯计算回报,专门处理多轮推理里「何时该升级、何时直接输出答案」的决策。
TD (λ) 就是把终局的 escalate 标签,沿着多轮推理轨迹反向传播,给每一步都生成对应的监督目标 G_j。
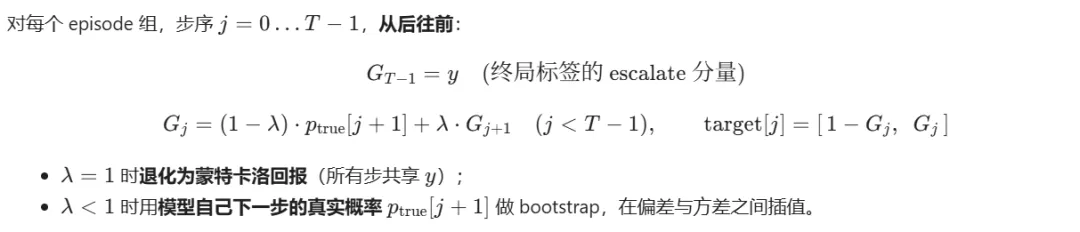
对每一条完整交互轨迹,从最后一步向前反向递推计算回报。轨迹终点拿到真实的升级标签 y,前面每一步的目标回报 G_j,由下一步模型自身概率与后续累积回报插值得到。
λ 控制方差-偏差权衡。λ越小,越依赖模型当下预测 bootstrap,方差更低、偏差上升; λ 越靠近 1,越依赖真实终局标签,偏差更小、方差更大。
当 λ=1,退化为蒙特卡洛方法,整条轨迹共享最终标签;λ<1 时利用模型下一步预测做 bootstrap,在偏差和方差之间做权衡。通过这套时序目标,模型学会在推理的每一步,预判后续是否有必要升级,而不是仅依据单一刻板阈值判断。
普通大模型的 RLHF 是对 token 做回报;这里的 TD (λ),是对每一轮结构化决策交互步骤,学习元认知路由(escalate),属于概率决策层面的时序强化学习,而非 token 层面。
5.3 RLCD 三步流程
RLCD 的实现归纳为三步:
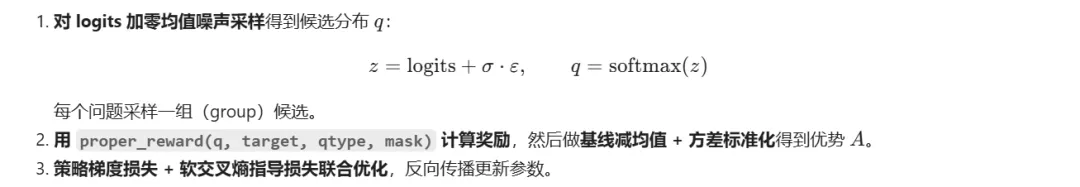
训练时,模型先在原始 logits 上叠加零均值高斯噪声,经过 softmax 生成一组候选概率分布q,为每个问题一次性产出多个候选。对每一个候选分布,调用复合恰当评分函数算出奖励;在同一组候选内部,通过减去均值、标准化方差得到优势值,衡量该分布相对本组平均水平的优劣。
模型最终用策略梯度损失叠加软交叉熵指导损失做联合优化:策略梯度顺着优势信号更新参数,鼓励产出更高奖励的概率分布;软交叉熵则作为约束,避免探索过程中概率分布出现极端崩坏。和传统 RLHF 在 token 层面做序列奖励不同,RLCD 直接把概率分布本身作为优化对象,这正是 System1 能够输出可信概率估计的核心训练机制。
5.4 后训练温度拟合
模型完成 RLCD 训练后,还会执行一步后训练温度拟合,完成概率校准。将原始 logits 除以 T 再送入 softmax,在验证集上最小化负对数似然期望,求解得到最佳温度。
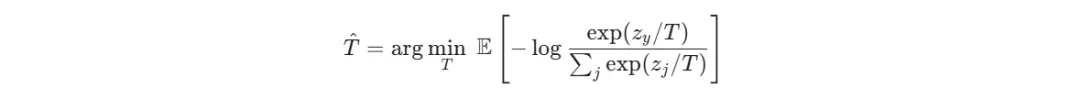
很多大模型直接输出的概率会过度自信,而温度缩放可以对整套概率分布做整体调整,不修改网络参数,只修正分布的锐度。对 System1 来说,这一步的意义不是调整生成的随机性,而是让模型给出的概率数值符合真实的事件发生频率,保证概率估计的可信度。
在验证集上搜索温度,完成概率校准,让模型输出的概率不再虚高,概率值具备统计上的可靠性,这对 System1 这种以可信概率输出为目标的模型至关重要。
结束语
从 Jev-like 软件族的接连发布,到 System1 以概率编程为内核的整套技术链路,我们走完了从理念定位、数学架构、概率推演、结构化决策,再到 RLCD 强化恰当评分训练与置信度校准的完整逻辑。
长久以来,很多兵棋 AI 的思路都停留在把大语言模型当作外挂接入,试图用 LLM 的文本能力直接替代战场决策。但 LLM 原生的概率是为自然语言生成服务的,它的置信度是虚浮、缺乏统计校准的,并不适合兵棋这种需要量化不确定性、追索决策概率、支撑对抗推演的场景。
System1 给出的路线并非否定大模型,而是换一层内核载体,用概率编程承载决策变量,可以将战场态势、行动选项、对抗收益转化为可计算、可校验的概率分布;再依靠 RLCD 训练、温度后拟合完成置信度校准,让模型输出的概率不再只是表面打分,而是具备统计意义的不确定性量化。它的 act_head 路由机制,还能在模型自身不确定性过高时触发升级,把难判别的复杂态势向外移交,形成一套闭环的决策系统。
兵棋推演本质上是对不确定性的博弈。文字可以描述态势,但只有可严谨计算的概率内核,才能支撑对抗中的风险评估、多分支推演与可信决策。LLM 负责理解、翻译、解释态势,概率编程内核负责计算不确定性,二者各司其职,这才是下一代兵棋 AI 真正可行的范式。
这套技术实践,也为基于嵌入结构因果的主动推理框架(Causal AIF),开发理想兵棋系统 “博望定远架构”,提供了关键的技术验证。System1 证明了概率编程内核可以和大模型的语义能力解耦协同,能够承载结构化变量、可校准概率、不确定性路由,而这正是实现 Causal AIF 所必需的底层能力。博望定远架构追求的因果态势建模、自由能最小化推演、认知层级切换,不再停留在理论构想,System1 的整套训练与推理链路,给出了可落地的工程参照。
但我们同样需要正确估计二者融合的难点。System1 当前擅长的是静态结构化选项上的概率评估,而 Causal AIF 要求模型自主构建态势因果图、通过自由能最小化持续更新世界模型。如何将 System1 的概率路由、恰当评分体系,嵌入到主动推理的循环感知 - 预测 - 行动闭环,实现因果假设的迭代更新,仍是后续工程上需要翻越的核心关卡。
技术的变革,往往不在于用新模型直接替换旧任务,而在于分清「谁负责理解,谁负责计算」。System1 这一套实践,也为兵棋 AI 指明了一条新方向——决策 AI 的核心,不是生成流畅文本,而是给出可信概率。
(全文完)