ARTICLE · 1096293
【连载2】面向 AI+ 兵棋 | 解密 System1:作为概率编程载体的 Jev‑like 族
第 1 章 | 理念与定位
第 2 章 | 模型架构的数学原理
第 1 章 | 理念与定位
决策不是生成。把「选择」建模成「给一组固定选项打分」,比让语言模型把选择「写出来」要快得多,也可校准得多。
1.1 System1 与 System2
认知科学里的双系统理论把思维分成两档:System1 快速、直觉、并行、无需意识努力;System 2 慢速、审慎、串行、需要推理链。当代 LLM 软件族的「思考」几乎都是 System2 式的,逐 token 自回归展开一条推理链,长度正比于思考深度。
Jev-like 软件族反其道而行,只做 System1。Agent 的 docstring 自我描述为 "System 1 decision model runtime: fast, non-autoregressive, calibrated decisions",即「System1 决策模型运行特性:高速、非自回归、带校准的决策输出」(来源: laya-main/llaya/agent.py#L220),而主入口方法就叫 system_one(来源:laya-main/laya/agent.py#L1059),其 docstring 是"Evaluate typed questions across state in a single, parallel forward pass",即「在单次并行前向传播中跨状态评估带类型化问题」。
1.2 为什么用「一次前向 + 概率打分」代替「逐 token 生成」
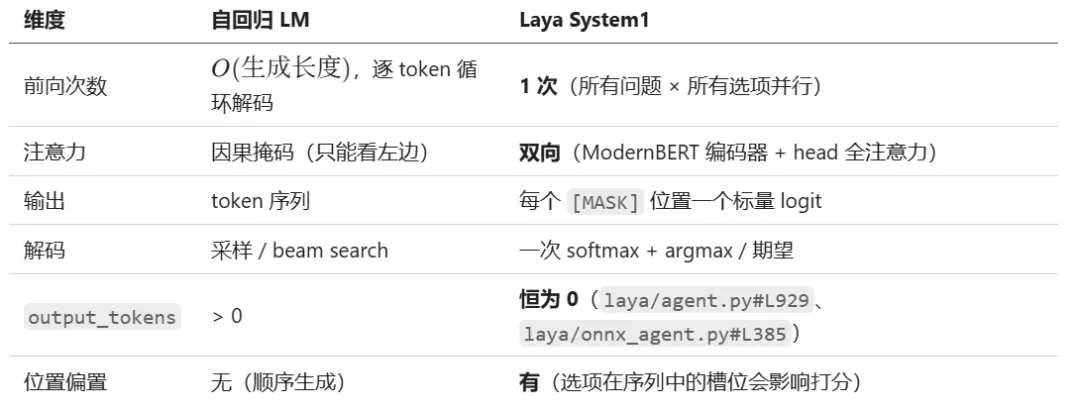
收益是 GPU 吞吐更高、延迟更低(单次决策约 33 ms 量级);代价是引入了选项顺序的位置偏置,以及模型无法「解释自己为什么这么选」——它只给分布,不给理由。
output_tokens 恒为 0 是这套架构最诚实的自白,没有任何东西被生成出来。所有计算都发生在编码阶段,usage 里的 input_tokens 是全部成本。
第 2 章 模型架构的数学原理
本章是全文的技术核心,包括从 DecisionModel 的四个子模块,到序列构建的 token 预算,到 ModernBERT 骨干,再到前向传播的每一步张量运算的单层完整数学,最终实现三种原语的选项渲染。
2.1 架构总览
Laya 是一个多语言、非自回归的 System1 决策引擎,能够在一次前向传播中对结构化问题给出带校准置信度的类型化答案。系统通过路由器在三个检查点之间进行请求级路由:英语专用、多语言通用和针对「类型化工作流」微调的检查点。推理由 Agent 执行,Hook 钩子系统提供可插拔的生命周期扩展点,语言检测模块负责脚本与语言的轻量判断,共同构成低延迟、高吞吐的决策流水线。
仓库采用 Python 包组织,核心逻辑位于 laya 目录;示例、文档、基准测试与研究脚本分别位于 examples、docs、benchmarks、research 等目录。顶层 README 提供了安装、快速开始、服务器部署、LangChain 集成、MCP 服务等内容。
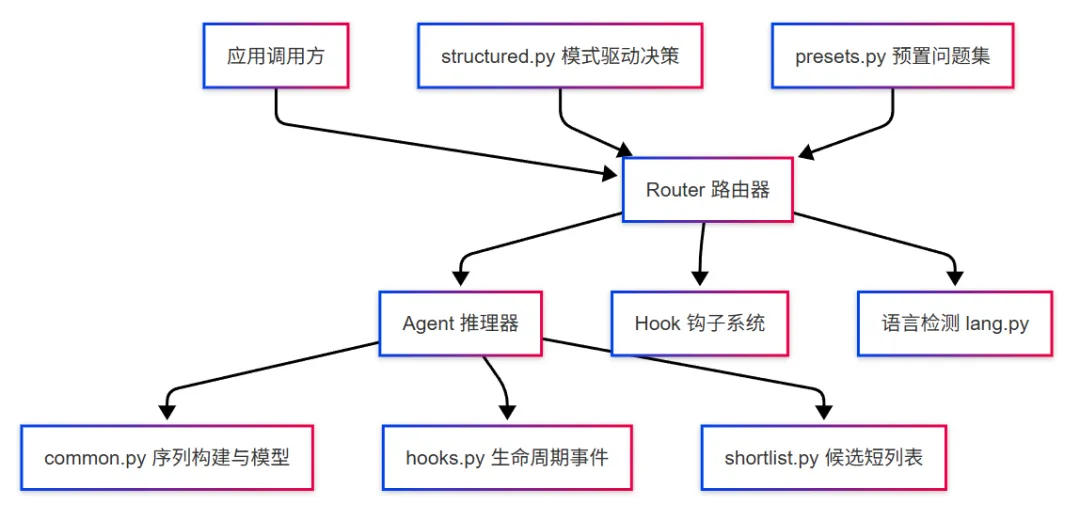
核心组件包括:
Router 路由器:负责检查点加载、LRU 缓存、请求路由、批处理分组、Hook 编排以及对外 API(predict、route、predict_batch)。
Agent 推理器:负责模型加载、设备与精度管理、序列编码、前向传播、答案解码、批量推理、GPU Fast Path 切换与 OOM 回退。
Hook 钩子系统:提供 on_predict_start、on_predict_end、on_route、on_load、on_evict、on_error 等生命周期事件,支持同步/异步钩子、默认钩子、超时控制与并发保护。
语言检测 lang.py:基于 Unicode 脚本范围与停用词启发式,判断是否适合英语检查点,并输出脚本分布、语言猜测、混合片段等信息。
common.py:定义 DecisionModel、序列构建、选项渲染、置信度计算、温度缩放、张量拼合等基础能力。
structured.py:将 JSON Schema 或 Pydantic 模型映射为 Laya 问题,实现模式驱动的决策接口。
presets.py:提供客服分流、邮件分类、Prompt Guardrails、内容审核、智能路由等预置问题集。
shortlist.py:对高基数 choice 问题做嵌入短列表,降低 head_max_len 压力。
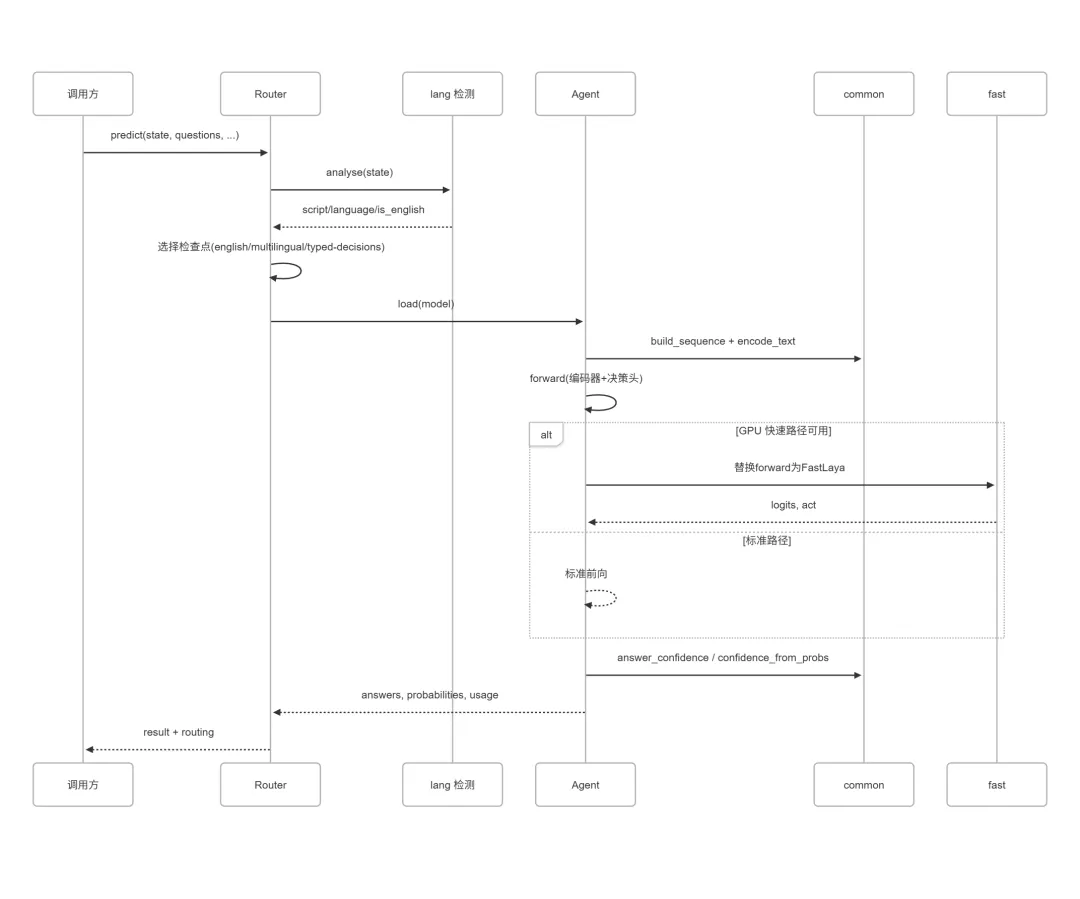
Laya 的系统边界与主要组件交互方式为:外部调用进入 Router,Router 先进行路由决策,再加载对应 Agent 执行推理;Hook 贯穿路由与推理生命周期;lang.py 提供语言信号;common.py 支撑序列构建与模型;structured.py 与 presets.py 提供高层问题抽象;shortlist.py 优化高基数 choice。
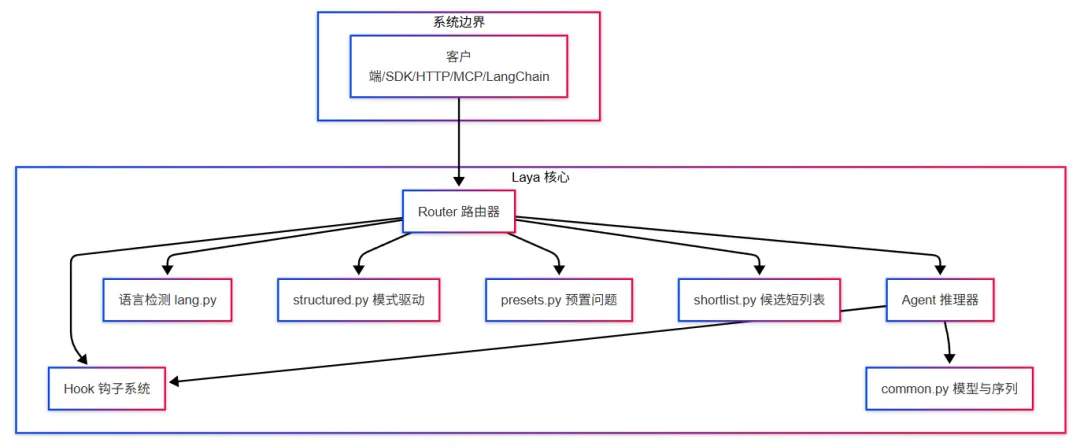
Laya 的推理流程由 Router 驱动:先进行轻量级语言/脚本检测,再选择合适检查点;Agent 在单次前向中并行评估一组问题;common 提供校准与评分工具;fast 在 GPU 上以融合内核加速。
2.2 DecisionModel 结构
作为 Laya 的核心模型主体,DecisionModel 的任务是接收拼装好、带多个 [MASK] 占位符的 token 序列,一次前向传播,并行算出全部候选选项的原始打分 logit。这里输出的只是原始分数,还不是概率,概率要在模型外部做温度缩放 + softmax 计算得到。
Laya 的 Agent 通过 DecisionModel(编码器 + 决策头)对每个问题选项位置进行打分,得到概率分布与置信度。
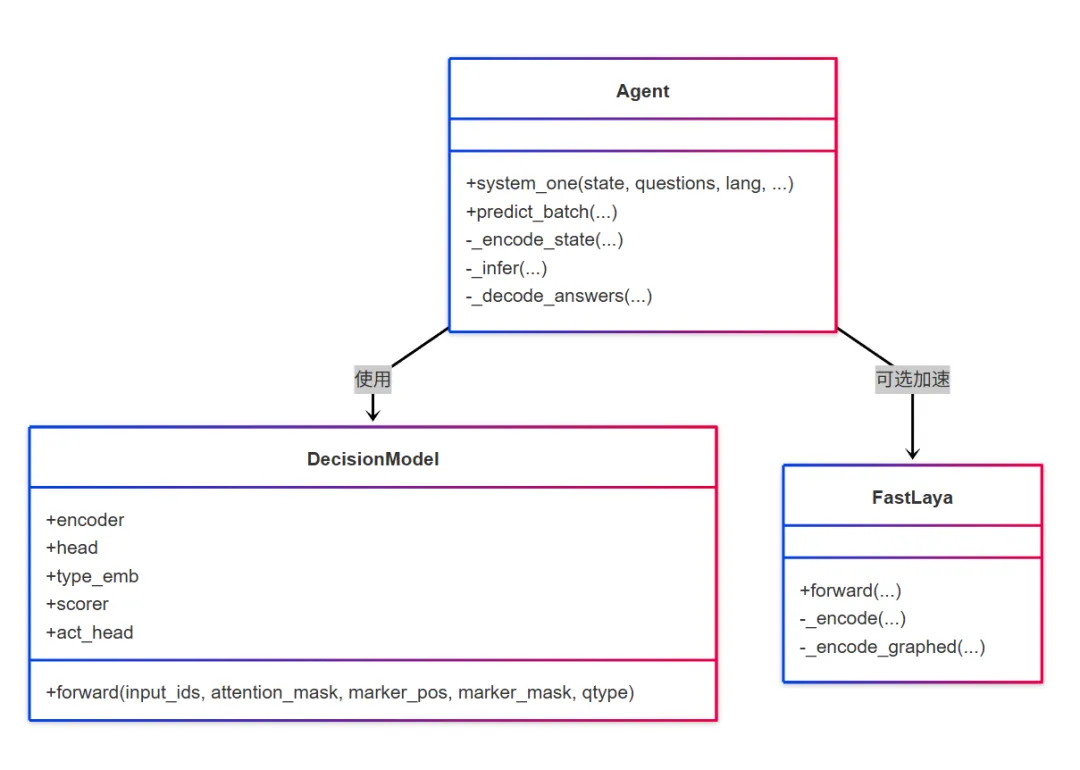
# 来源:laya/common.py#L149# System1核心模型架构:预训练双向编码器 + 决策头 + 打分网络 + 实验元认知头import torchimport torch.nn as nnclass DecisionModel(nn.Module):def __init__(self, encoder, head_layers=2, n_act=2, dropout=0.1, no_init=False):super().__init__()d = encoder.config.hidden_size # 编码器隐状态维度nhead = max(1, d // 64) # 注意力头数量# Pre‑LN风格Transformer层,用于堆叠决策头layer = nn.TransformerEncoderLayer(d, nhead, 4*d, dropout,batch_first=True, norm_first=True)# 多层决策头;head_layers为0则不启用,关闭嵌套Tensor保证导出兼容self.head = nn.TransformerEncoder(layer, head_layers,enable_nested_tensor=False) if head_layers > 0 else Noneself.type_emb = nn.Embedding(3, d) # 3种原语(noul/choice/score)类型嵌入self.scorer = nn.Sequential( # 打分网络:[MASK]位置隐状态→候选原始logitnn.LayerNorm(d),nn.Linear(d, d),nn.GELU(),nn.Linear(d, 1))# act_head:实验元认知头【issue#185,禁止生产拒判】# 输入:CLS特征 + 4维分布统计特征;输出动作logit(回答 / 弃答)self.act_head = nn.Sequential(nn.Linear(d + 4, 256),nn.GELU(),nn.Linear(256, n_act))# 温度缓冲区,不参与梯度更新,推理时会被分桶温度覆盖self.register_buffer("temperature", torch.ones(3))
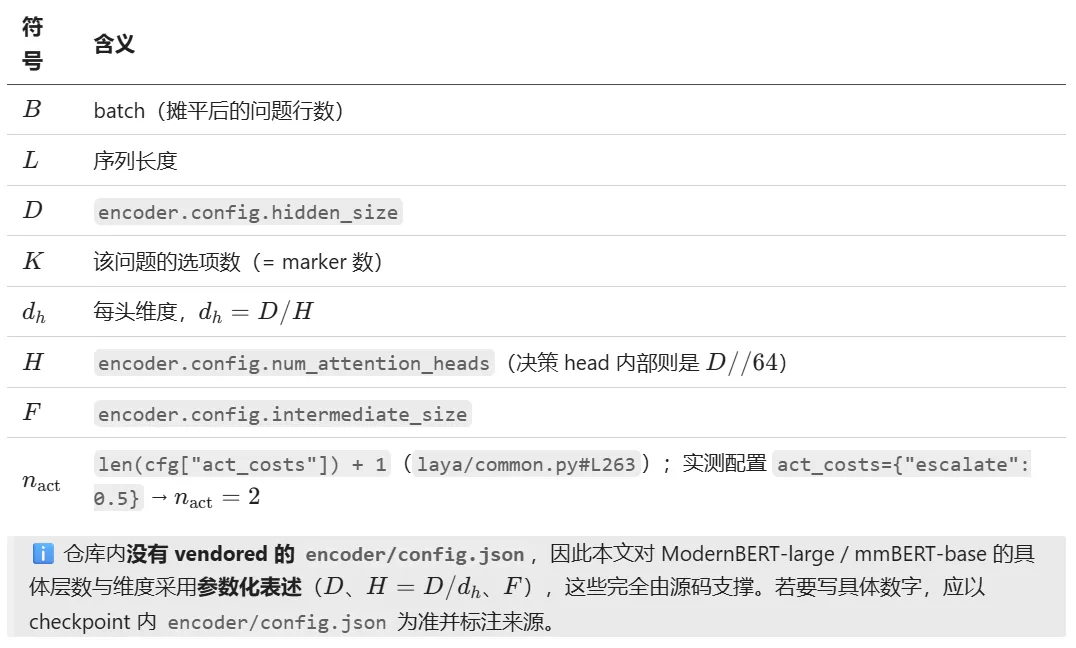
符号约定
2.3 序列构建 build_sequence
build_sequence 是 System1 的序列组装核心函数。DecisionModel 不能直接读懂我们传入的 state(态势 / 情报)和 questions (noul/choice/score 查询原语),build_sequence 的工作,就是把上层传入的结构化查询 + 业务状态,翻译成可处理的 token id 序列。
build_sequence 的 docstring 给出了序列格式:
# 来源:laya-main/laya/common.py#L94[CLS] <type> question: <instructions> [SEP] [MASK] opt0 [MASK] opt1 ... [SEP] state [SEP]
逐步算法如下:
1. opts = render_options(q);order = option_order or range(len(opts))。option_order 参数专用于评测选项顺序稳健性。
2. ins = str(q["ins"]).replace(mask_tok, " "),防止用户文本注入 mask token 破坏 marker 定位。
3. 问题前缀编码:
head_ids = encode_text(tok, "%s question: %s" % (q["t"], ins), add_special_tokens=False)["input_ids"]即前缀文本是 "choice question: ..." / "score question: ..." / "noul question: ..."。问题类型以自然语言写进序列,同时 qtype 又通过 type_emb 以向量形式注入——双通道冗余。
4. 每个选项:
opt_tokens = encode_text(tok, " " + opts[i].replace(mask_tok, " "),add_special_tokens=False, truncation=True, max_length=48)["input_ids"]opt_ids.append([tok.mask_token_id] + opt_tokens)
5. 预算再分配(关键机制):
opt_budget = head_max_len - sum(len(o) for o in opt_ids)if opt_budget < 16:per = max(4, (head_max_len - 16) // max(1, len(opt_ids)))opt_ids = [o[:per] for o in opt_ids] # 均分预算opt_budget = head_max_len - sum(len(o) for o in opt_ids)head_ids = head_ids[: max(8, opt_budget)] # 指令让位给选项
这是「选项多 → 每个选项 token 少」的根因,也是 laya/shortlist.py 存在的动机(其 docstring 明说:"Choice options share one head_max_len budget, so a large label set leaves only a few tokens per label."即 “各候选选项共用同一个 head_max_len 长度预算,因此标签集规模较大时,分配给每个标签的 token 数量就很少。”)。以 multilingual 的 head_max_len=256 为例:3 个选项时每个选项最多能有约 48 token;32 个选项时,per = max(4, 240 // 32) = 7。每个标签只剩 7 个 token 的描述空间。
6. marker 记录:
ids = [cls] + head_ids + [sep]for i, opt in enumerate(opt_ids):markers.append(len(ids)) # ★ [MASK] 的绝对下标ids.extend(opt)ids.append(sep)
markers[i] 就是第 i 个选项的 [MASK] 在整条序列里的绝对下标。这是整个架构的枢纽,模型在该位置的隐状态被用来给该选项打分。
7. 状态拼接:room = max(0, max_len - len(ids) - 1);
st = state_ids[max(0, len(state_ids) - room):] if truncate_left else state_ids[:room]当 room == 0 时,[-0:] 会取到整个 state。
8. 返回 ids[:max_len], [m for m in markers if m < max_len]。
token 预算的实测配置:multilingual 是 max_len=1024, head_max_len=256, max_prefixes=6;english 是 max_len=512, head_max_len=192(代码默认值,来源:laya/agent.py#L655)。
2.4 编码器骨干:ModernBERT / mmBERT
ModernBERT/ mmBERT 是 Laya 模型最底层的双向文本编码器骨干,负责读懂原始文本,输出基础语义隐状态 h,再喂给后面要讲的 Decision Head 决策头。Laya 提供两个版本,英文版本用 ModernBERT-large,多语言版本用 mmBERT-base。
ModernBERT / mmBERT 都属于双向仅编码器(encoder‑only)Transformer,和 GPT 这类因果解码器最大区别在于,每一个 token 既可以看左边,也可以看右边全部上下文,不需要逐 token 生成。在 Laya 体系里,它只负责一件事:把 build_sequence 拼装出来的完整 token 序列,转换成每一个位置的隐状态向量。
换句话说,GPT 类解码器,是串行解码,生成一个 token 再看一遍上下文;而 Laya 的编码器骨干,全部 token 一次性双向读完全部上下文,只跑一次前向,没有循环解码,这也是 System1 低延迟的根源。
Jev-Laya 对外 API 接口完全一致,输入输出格式一样,都实现 System1 概率编程能力,原语 Noulli/Choice/Score、RLCD 训练目标、温度缩放校准逻辑二者是对齐的。但底层神经网络架构不一样,这也是 Laya 和 Jev 最大架构差异之一。
开源 Laya 采用纯双向 Encoder‑Only 架构,没有自回归解码器,走的是 ModernBERT/mmBERT 双向编码器 + 自定义 DecisionModel 决策头、scorer 打分网络。把全部候选写成序列里多个 MASK] 占位,单次双向前向就完成全部候选打分;output_tokens 恒等于 0,从根源就不做文本生成。
闭源 Jev 则是在自回归大模型底座上改造拦截实现 System1 能力。这是两套软件内核实现层面的重大差异,但不会改变上层使用者调用逻辑。内核是解码器(类似 GPT 架构),本身设计用途就是逐 token 生成文本;在解码器之上增加一套额外逻辑,拦截推理过程,在不完成文本生成的前提下,提取各个候选的打分,输出概率。
ModernBERT 需经过 RoPE 旋转位置编码、GeGLU 前馈激活、FlashAttention + Unpadding 去填充优化,最后去掉冗余 bias 项,结构精简。ModernBERT-large 共计 421M 总参数量。
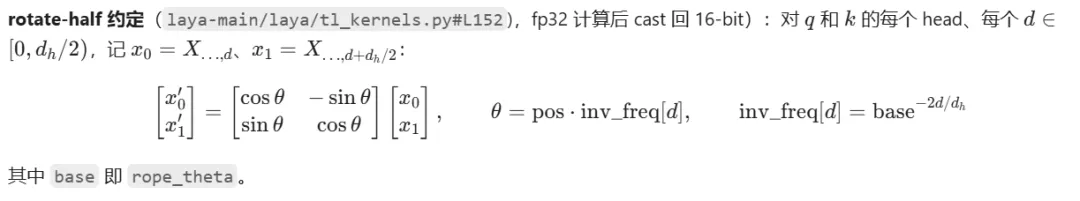
RoPE 旋转位置编码抛弃老式可学习位置 embedding,支持更长上下文,Laya 原生 512 上下文窗口,原生最大可到 8192 token;RoPE 的数学表达式:
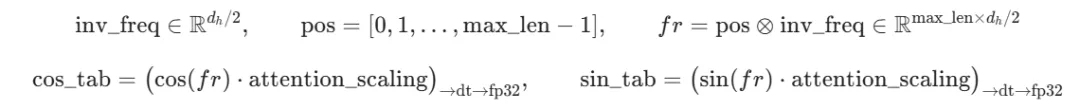
GeGLU 前馈激活替代 BERT 的 ReLU,表达能力更强;其门控形式为
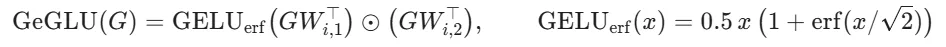
单层 ModernBERT 的数学形式:
X₀ = LayerNorm_nobias(Embed(id)) # 残差流起点,fp32# 第 i 层(i = 0 时 attn_norm = Identity)A = X_i # i == 0A = LN_nobias(X_i; attn_norm_i) # i >= 1Q,K,V = split(A · Wqkvᵀ) # [·, 3D] → 3×[·, D]Q,K ← RoPE(Q), RoPE(K) # 按该层 layer_type 的 cos/sin 表S = Q·Kᵀ / √d_h + M # M: padding 掩码 +(局部层的)|i−j|≤win 窗口掩码P = softmax(S, dim=−1) # 双向(非因果)O = (P·V) · WoᵀX' = X_i + OG = LN_nobias(X'; mlp_norm_i)Z = GELU_erf(G·Wi[:F]ᵀ) ⊙ (G·Wi[F:]ᵀ) # GeGLUX_{i+1} = X' + Z·Wo₂ᵀh = LN_nobias(X_N; final_norm) # encoder.last_hidden_state
mmBERT = Multilingual ModernBERT,基于 ModernBERT 架构改造的超大语种覆盖双向编码器,专门面向多语言场景,是 Laya 多语言分支的骨干。训练策略为逆掩码调度、渐进式加入小语种数据,低资源语言效果更好。Laya-multilingual 使用 mmBERT-base ,总参数量 322M,上下文窗口 1024,支持上百种语言做 System1 概率决策。
在 Laya 完整链路里,输入文本 token 序列之后:
ModernBERT /mmBERT → 输出原始隐状态 h
Decision Head 决策头,叠加任务类型嵌入,两层 Transformer 做候选间对比推理
gather 取出各个 MASK 槽向量 → Scorer 打分网络 → logits
softmax 得到候选概率分布
act_head(实验元认知头,可选)
编码器骨干只负责理解原始文本,把问题、候选全部转为语义向量。候选之间的相互比对、概率推理,并不在骨干内完成,而是输出隐状态 h,交给后面独立的 Decision Head 决策头。
2.5 决策头 Decision Head
决策头是 System1 模型核心推理层,接收编码器的原始语义向量,叠加任务类型标记,然后在候选、查询、上下文之间做双向自注意力,让各个候选选项互相比对、交换信息。
也就是说,在 ModernBERT 读取文本得到基础语义向量之后,会先叠加任务类型嵌入,标记当前是二元判断、多选还是打分任务。随后进入两层 Pre-LN Transformer 决策头。
每一层分为两个残差分支,先做多头自注意力,让所有候选选项互相比对;再经过 ReLU 前馈网络做非线性变换。这一步的意义,就是让模型不只单独理解每一条候选,还能在多个候选之间做对比推理。
决策头的数学表达式:
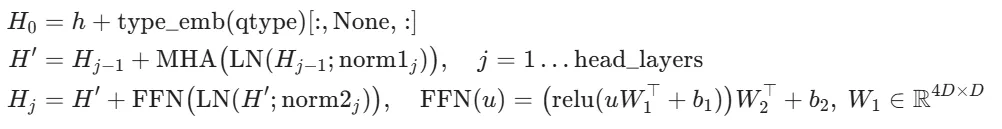
第一行:h 为骨干编码器输出的原始隐状态张量,形状 [B,L,D]。[:, None, :] 是张量广播,把一维嵌入向量扩展,加到整条序列所有 token 位置上,得到初始状态 H_0。
第二行:j 为决策头 Transformer 层索引,head_layers 是决策头层数(Laya 默认 2 层);LN 为 Pre-LN 层归一化函数,norm1_j、norm2_j 是第 j 层两组归一化参数;MHA 为多头自注意力(Multi-Head Attention);这一行是注意力残差分支,先归一化,做多头注意力,再加残差连接。
第三行:FFN 为前馈网络,采用 ReLU 激活,不是 GELU;W_1 把维度从 D 扩展到 4D,W_2 再压缩回 D;这一行是**前馈残差分支**,完成单一层 Transformer 的完整计算。
也就是说,决策头给整条序列打上任务类型标签,告诉网络当前是哪一类概率查询;通过双向多头自注意力,让各个候选选项互相看见、互相比较;输出更新后的隐状态 H_j,之后交给 gather 算子提取各个 [MASK] 槽位向量,送入 scorer 网络计算原始 logit 分数。
因此,底层 ModernBERT 读懂态势文字,生成基础语义向量;决策头专门用来做候选之间的对比推理,是 System1 实现动态候选评估的核心。
2.6 前向传播数学
前向传播 DecisionModel.forward,描述从输入 token,到输出各个候选选项原始 logit 分数的整套张量运算过程,完整数据流如下:
# 来源:laya-main/laya/common.py#L181h = encoder(input_ids, attention_mask).last_hidden_state # [B, L, D](可选 detach_encoder:h = h.detach(),冻结编码器只训 head)h = h + type_emb(qtype)[:, None, :] # [B,1,D] 广播到所有位置for layer in head.layers: # head_layers=2, norm_first, pre-LNh = layer(h, src_key_padding_mask=~attention_mask.bool())idx = marker_pos.clamp(min=0)[:, :, None].expand(-1, -1, D)m = gather(h, dim=1, index=idx) # [B, K, D] ← 取每个 [MASK] 位置的隐状态logits = scorer(m).squeeze(-1).float() # [B, K]logits = logits.masked_fill(~marker_mask, -1e4) # 无效选项置 -10^4p = softmax(logits.detach(), -1) # 不带温度,仅供 act_head 特征k = marker_mask.sum(-1).clamp(min=2).float() # [B]ent = -sum_j p_j * log(clamp(p_j, 1e-9)) / log(k) # 归一化熵 ∈ [0,1]top2 = p.topk(2, -1).valuesfeats = stack([top2[:,0], top2[:,0]-top2[:,1], ent, k/255.0], -1) # [B, 4]pooled = h[:, 0].float() # [CLS] 位置(过完 head 之后)act_logits = act_head(cat([pooled, feats], -1)) # [B, n_act]return logits, act_logits
第 j 个候选选项 m_j,对应的 [MASK] 位置隐状态向量,维度 D,经过归一化、全连接、GELU 激活、再一层全连接,最终输出这个候选假设的原始打分 logit,后面还需要外部执行温度缩放 + softmax,才会转换成我们需要的研判概率(见第 3.1 节)。
scorer 打分网络的数学表达式:
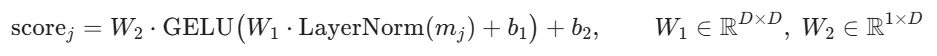
act_head 是一套元认知分支网络,不参与候选选项打分,而是读完整套概率分布的统计特征 + 全局语义,尝试判断模型当前是应该直接输出研判结论,还是识别不确定性过高,放弃回答、把问题向上转交。但是仓库注释明确指出,act_head 仅为实验模块,信号不可靠,生产环境禁止用它做拒判逻辑。业务置信判断,统一使用 answer_confidence(见第 3.3 节)。act_head 的数学表达式:
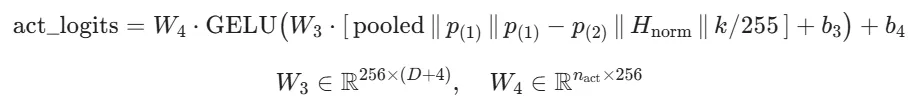
四个分布特征的含义:
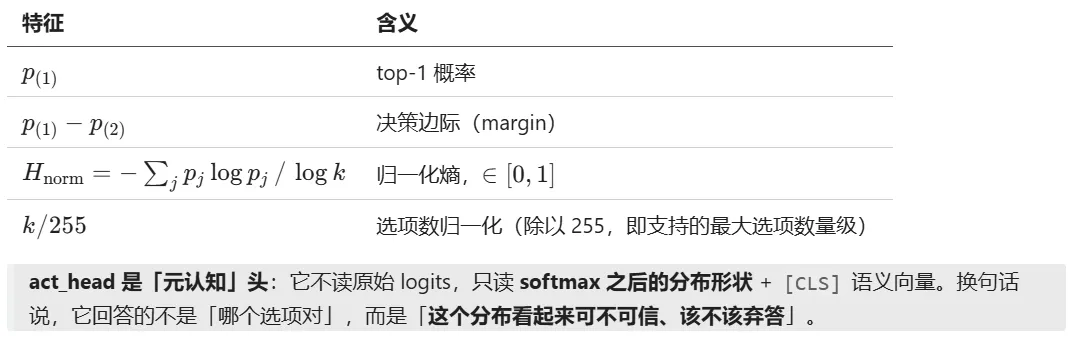
k 是候选选项数量,如果 k >= 2,正常执行 p.topk(2),拿到 p_1 和 p_2,计算差值 p_1-p_2;如果 k == 1,只有第一名 p_1=1.0;虚拟填充第二名概率 p_2=0.0。于是,填充后的差值 p_1-p_2 = 1.0 继续送入 act_head,避免张量越界,单 logit 的 softmax 恒为 1.0。
# 来源:laya-main/laya/common.py#L203top1 = p.topk(1).valuestop2 = torch.cat([top1, torch.zeros_like(top1)], dim=-1)
类型嵌入的位置很关键,type_emb 加在 encoder 输出之后、head 之前,且广播到所有 L 个位置。因此 head 的每一层注意力都能看到「这是 choice / score / noul」,从而用同一套权重实现三种截然不同的解码语义。
2.7 三种原语的选项渲染
Laya 的三种决策原语(choice / score / noul):
选择 choice 用于多类别选择时的选项渲染与序列构建;
评分 score 用于有序评分任务的特殊处理(等级标签与期望得分计算);
判断 noul 用于二元判断的独特设计(固定语义顺序 false/true、可选自定义标签映射)。 同时说明 render_options 如何为不同原语生成模型可读的选项文本,build_sequence 如何构造输入序列,以及 Agent 如何将推理结果解码为结构化答案。
围绕决策原语的核心代码主要分布在以下模块:
laya-mian/laya/common.py:定义三种原语类型常量、选项渲染、序列构建、置信度与温度等基础能力。
laya-mian/laya/agent.py:高层推理运行时,负责问题校验、内部表示转换、批处理编码、前向推理与答案解码。
laya-mian/laya/structured.py:基于 JSON Schema/Pydantic 将模式自动规划为 Laya 问题(choice/score/noul),并投影回结构化值。
laya-mian/README.md:对外文档,给出决策原语的定义与用法摘要。
laya-mian/tests/test_criteria.py:针对选项渲染与边界情况的回归测试。
laya-mian/research/benchmarks/zh_short_commands/*:基准脚本中 noul 的中文标签与评估流程示例。
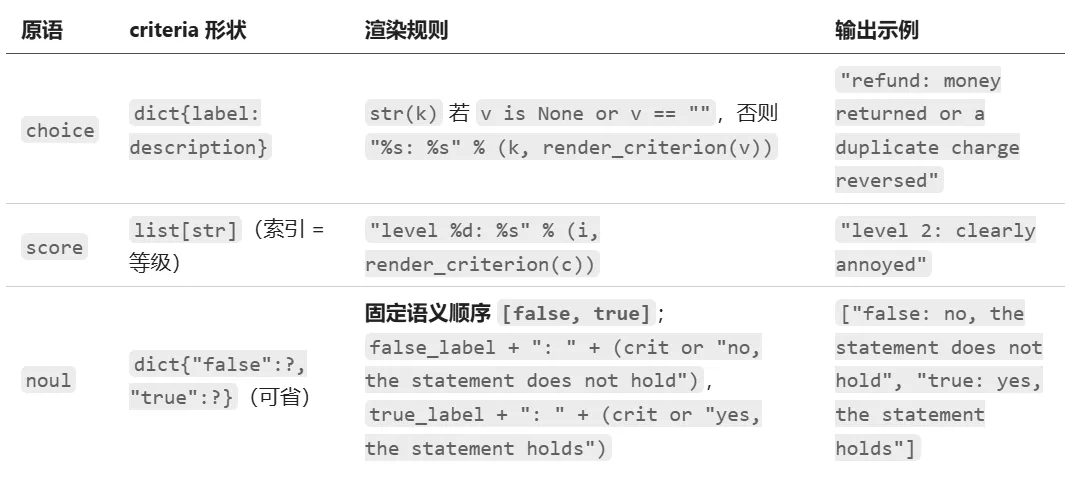
render_options(来源:laya/common.py#L65)把三种问题原语统一渲染成「选项文本列表」,其下标就是概率向量的下标:
2.8 小结:一次前向里发生了什么
一条序列,一次前向,K 个 logit,这就是 System1 的全部。
state + questions│ build_sequence(一次性分词,state_ids 复用)▼[CLS] choice question: ... [SEP] [MASK] opt₀ [MASK] opt₁ [SEP] state [SEP]│ ModernBERT / mmBERT 编码器(双向、RoPE、局部+全局交替注意力)▼h ∈ R^{B×L×D} ──(+ type_emb[qtype])──► 2 层 pre-LN Transformer head│├─ gather(h, marker_pos) → m ∈ R^{B×K×D} → scorer → logits ∈ R^{B×K}└─ h[:,0] ‖ 分布形状特征(4维) → act_head → act_logits ∈ R^{B×n_act}
(未完)