ARTICLE · 1168366
OpenAI放出722篇数学手稿:准黎曼猜想之外,我更关注这件事
对 AI 感兴趣的同学,欢迎扫描文末 Allen 的二维码,加入我们的 AI 交流社群,一起聊技术、聊应用、聊落地。
海外、国产大模型一站式选购,API / Token 折扣优惠,欢迎随时咨询~
这次,OpenAI拿出来的不是一张数学跑分榜,而是一整个研究材料库。
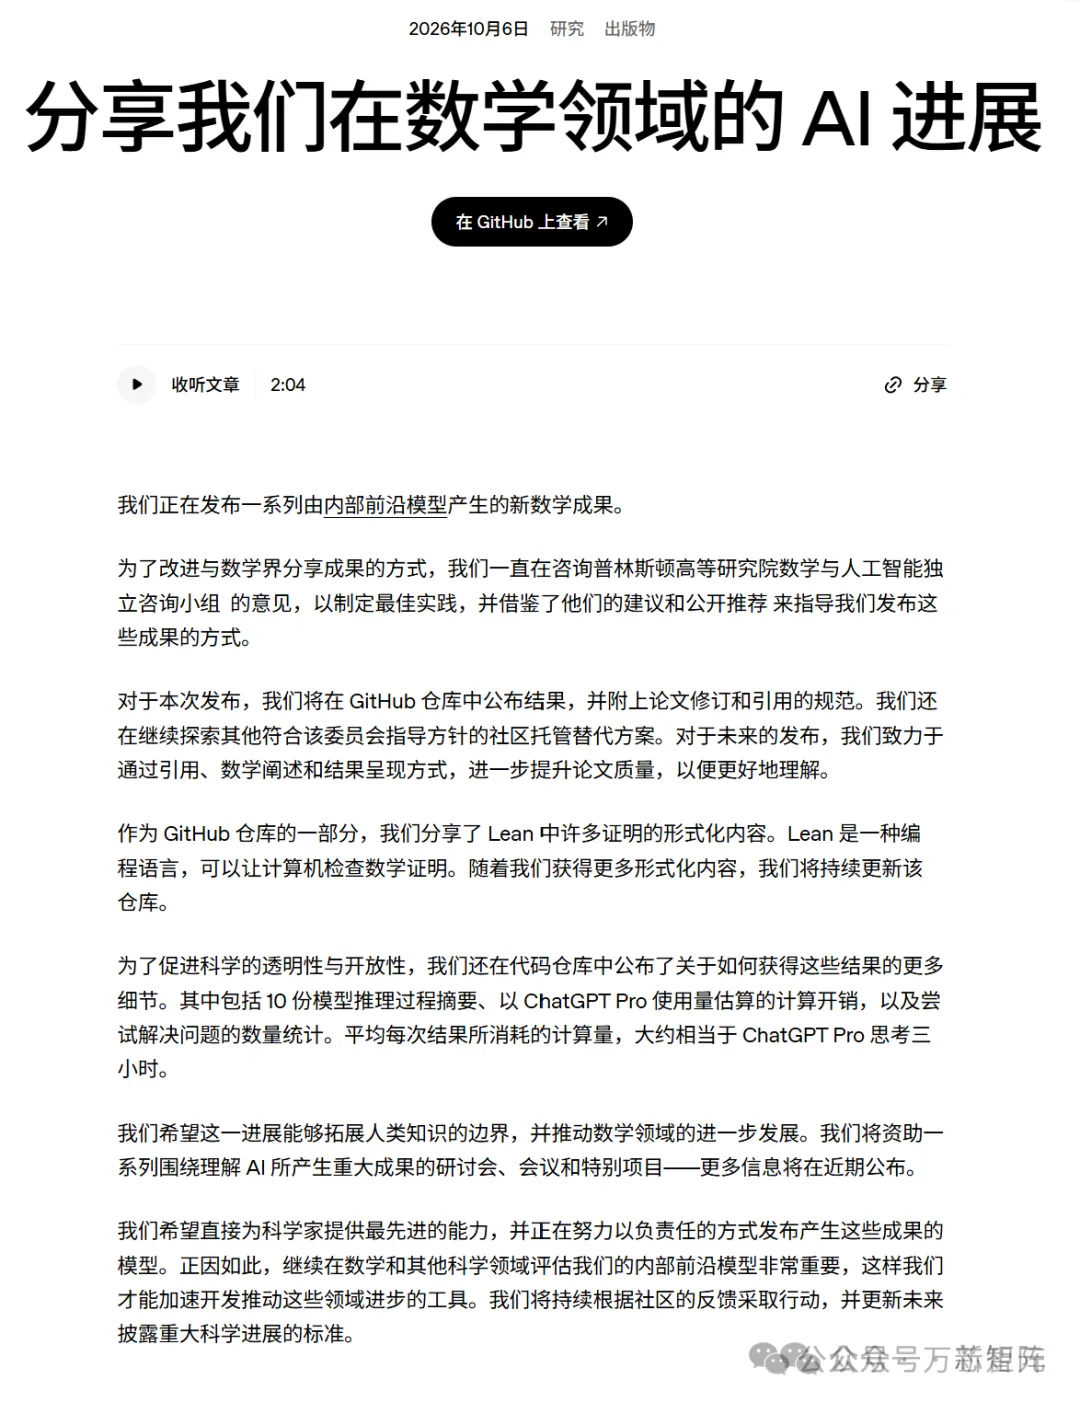
2026年10月6日,OpenAI宣布公开一批由内部前沿模型产生的数学成果。官方仓库列出722篇手稿,分属372个成果家族,同时提供部分成果的Lean形式化材料和研究过程说明。 [1][2]
看到这个规模,我确实觉得值得认真看。但相比“AI一夜终结数学”这样的判断,我更关心另一件事:当模型可以批量给出研究论证,我们该怎样把这些论证变成真正可用的知识?
这既关系到数学研究,也关系到我们平时做AI应用时反复碰到的问题:模型交出来的东西,到底是一个看起来很好的答案,还是一个经得起检验、能够继续使用的结果?
01
先把规模讲清楚:722篇手稿,不等于722个独立难题
官方的“成果家族”,会把主结果、配套论证、推论或不同证明归在一起。因此,722和372分别是手稿数与成果家族数,不能直接换成“722个独立难题已经全部获得确认”。仓库也明确提示,各项结果的验证阶段不同,尚未形式化的结果可能存在问题。 [2]
另一个吸引眼球的数字是“平均3小时”。OpenAI的口径是:使用未发布的内部模型,每项结果平均消耗约相当于3小时ChatGPT Pro思考的算力。仓库还披露,整个评估过程向模型提出过约4000个问题。 [1][2]
这不是说普通用户打开现有产品、等3小时,就能稳定拿到一项同等级成果;也不能把手稿数除以问题数,当作解题成功率。题目、结果和手稿并不是同一个统计单位。
但把这些边界讲清楚之后,这次发布仍然值得关注。我的理解是:真正的变化不只是“做得快”,而是研究尝试开始能够被系统地组织、整理和交付。
02
准黎曼猜想:重要,但不是“黎曼猜想已经解决”
原报道最吸引眼球的部分,是准黎曼猜想。根据官方目录,第003组成果报告:包括黎曼ζ函数在内的所有狄利克雷L函数,在实部 Re(s)>7/8 的半平面内没有零点;相关材料还包括 Re(s)>11/12 的另一份证明,以及一致排除朗道—西格尔零点的工作。 [3]
这几个名字不熟悉也没关系。先抓住一个区别:证明某一片区域没有零点,与证明所有非平凡零点都位于一条直线上,不是同一个结论。
通常所说的黎曼猜想,要求ζ函数所有非平凡零点的实部都等于1/2。因此,7/8的无零点半平面结论,不能直接写成完整黎曼猜想已经得到证明。 [6]
在我看来,这不需要被理解为“给成果泼冷水”。一个结果是否重要,与它是否恰好解决了最有名的那个终极问题,是两回事。
我会更关注:这个界限依靠什么关键论证建立?相关方法能否被其他研究复用?如果后续核验和理解工作顺利,它带来的价值,可能远不止这一条结论。
仓库的形式化目录中列有这份准黎曼猜想手稿,也给出了对应的Comparator复核入口。这比单独发布一段“我们证明了”的声明,多了一层可以继续检查的材料。这里说的是公开材料的存在,不是我已经独立重跑并验证了全部证明。 [4][5]
03
NP困难性:不是算法突然无所不能,而是在讨论能力边界
原稿第二条重要主线,是“基本半定规划阈值下的普通NP困难性”。它关注的不是程序跑快了多少,而是:对于某类优化问题,多项式时间算法能保证把答案做到多接近最优。 [10]
这里需要对照官方目录理解:第102组被列为“唯一游戏猜想与最优近似阈值”,报告了唯一游戏猜想的证明,以及若干具体近似问题的直接NP困难性证明。它不只是一个更快的求解器,也不能简单概括为“跳过所有前提,锁死人类算法极限”。 [3]
“找到更好的算法”和“证明某种保证无法再提高”,是两类不同的研究成果。前者告诉我们怎么做,后者帮助我们判断,是否在追求一个不可能普遍实现的目标。
但某类问题的最坏情形困难性,不等于每一个实际业务实例都无从优化;证明一个问题NP困难,也不等于证明了P≠NP。这里讨论的前提、问题类别和近似保证,都不能省略。
从做调度和优化的角度,我觉得这种边界意识很重要。模型再强,也需要先弄清楚:我们追求的是理论上的普遍保证,还是在特定数据、特定约束下,把实际结果做得更好。
我更期待AI帮助我们把这两类目标分清楚,而不是把所有问题都包装成“多给一点算力,总能算出最优解”。
04
霍奇、Chowla、马勒:别只记住名字,要看结果的适用范围
代数几何部分同样值得关注。不过,按官方目录,第001组是Milne的有理性猜想;CM阿贝尔簇及K3曲面乘积的有理霍奇猜想,对应第032组。原报道把这些相互关联的工作放在一起讲,阅读时仍需要区分。 [3]
第032组报告的范围包括复数域上CM阿贝尔簇,以及射影复K3曲面的有限乘积。这里保留“CM阿贝尔簇”“K3曲面乘积”等限定,不是为了把事情说复杂,而是因为它们决定了定理究竟覆盖什么。 [3]
用一个不严格、但便于理解的比喻,霍奇猜想在问:某些通过抽象方法识别出的几何信息,能否用真正的代数几何对象来表达。完整猜想的对象范围,并不限于上面这些类别。 [7]
因此,我不会把某一类对象上的证明,直接写成整个霍奇猜想已经解决;同样,也不会因为它带有限定,就轻易低估它的意义。
原报道还介绍了普通两点Chowla猜想与对称、一般马勒猜想。前者涉及乘法函数相关性,后者涉及凸体及其极性体的体积乘积。这些也是官方目录中列出的研究方向。 [3][10]
对我而言,这批材料最值得继续追踪的,不是一串难题名字有多长,而是不同结果之间有没有共同的关键方法。一个能被反复使用的引理或构造,有时比孤立的一次解题更值得研究。
05
有Lean证明,就可以跳过所有审查吗?
我认为,形式化材料是这次发布中非常重要的一部分。Lean这样的证明助手,会按照逻辑规则检查形式化证明;它不是再找一个聊天模型,问一句“你觉得对不对”。 [8]
但对一项具体成果,我仍然会分别看三件事。
首先,检查的命题是什么。 自然语言论文讲的定理,与形式化代码实际表达的定理,是否一致?有没有更换对象、缩小范围,或者增加额外假设?
其次,证明依赖什么。 哪些部分已经被检查,哪些来自已有库,哪些前提仍需要明确说明?不能把“某个文件能构建”自动理解为所有数学解释都没有问题。
最后,人类能否理解和继续使用它。 机器检查提供了一类证据,但结果是否新颖、关键想法是什么、怎样与已有研究连接,仍然是需要回答的问题。
我更愿意把AI科研的交付链条理解为:
提出论证 → 检查证明 → 解释方法 → 纳入知识体系。
前面几步做得更快,当然有价值。但只有后面的理解和复用跟上,这些结果才不只是躺在仓库里的文件。
06
数学家的担忧,不该被简化成“怕被AI替代”
原报道用很强的情绪描写了数学界的反应。相比“兴奋”或“恐惧”这样的标签,我更愿意看公开提出的具体问题。 [10]
数学与人工智能咨询小组AGMAI在9月29日的建议中,明确关注了研究归属、可理解性、发布规范,以及研究者能否公平获得模型能力;它也反对把数学成果发布主要当作模型营销工具。这份建议还明确表达了对使用封闭内部模型测试高等数学问题的反对意见。 [9]
OpenAI在此次公告中则表示,已参考该小组的建议,提供修订和引用规则,并计划支持围绕AI数学成果理解工作的研讨活动。咨询和回应是事实,但这并不等于所有分歧已经解决。 [1]
我的理解是,这里争论的不只是“机器能不能做数学”,还包括:谁对结果负责,谁来承担理解和核验的成本,其他研究者能否参与进来。
一个实验室可以更快地产出结果,但如果理解它、检查它、解释它的负担全部留给外部学者,我觉得这种研究分工就值得重新讨论。
这不是要求技术放慢,而是希望技术加速的时候,知识共享和责任机制也一起跟上。
07
从科研和Token服务的角度,我更关心“有效成果成本”
“平均3小时”会让人很自然地想到:以后科研是不是只需要增加调用量?
但从我自己的角度,我不太愿意只用模型思考了多久,来判断一套科研系统是否高效。我会把前期尝试、失败方案、工具运行、形式化处理、人工核验和后续修订,都放进同一笔账里。
我更关心的,是产出一项经过核验、确有研究价值的结果,整体需要付出多少成本。
这是我会采用的衡量方式,不是OpenAI此次发布的官方指标。只计算最后成功的那次调用,就容易忽略此前大量没有形成有效结果的工作。
同样,把模型数量堆上去,也不自动等于研究质量提高。多个模型可能共享同一个错误前提,反复同意彼此;更长的推理,也可能只是把一条错误路线走得更远。
因此,在我设想的工作流里,关键不是“让AI一直想”,而是把题目、证据和验收标准组织好:模型负责探索候选路线,工具负责检查明确的约束,研究人员负责问题价值、结果解释和最终责任。
这是一种工作流程上的判断,不是对这次内部模型具体训练或运行方式的猜测。它真正吸引我的地方,是让算力投入与研究反馈连接起来,而不是只留下越来越长的输出。
对做AI应用的人也一样:我们不应该只证明系统能生成多少内容,而应该证明它能持续交付多少可信、可复用的结果。
结语
数学没有必要被宣布“结束”,但研究方式值得重新思考
这次发布让我更认真地思考AI在科研中的位置。不是因为一夜之间所有问题都有了答案,而是因为一批需要继续检查、理解和消化的研究材料,被集中摆到了大家面前。
我不赞成用“数学已死”来概括它。更值得讨论的是:当论证生成越来越快,研究者该如何把更多精力放在选问题、辨别价值、解释方法和建立新联系上。
AI科研真正值得期待的,不是更快地宣布“我证明了”,
而是更高效地交出别人能检查、能理解、能继续使用的成果。
如果这些环节能够一起进步,那么这次事件的意义,就不只是722篇手稿,而可能是一种科研组织方式的变化。
资料来源与说明
[1] OpenAI|Sharing AI progress in mathematics,2026年10月6日。
https://openai.com/index/sharing-ai-progress-in-mathematics/
[2] OpenAI math|README:手稿数量、成果家族、验证状态与生成过程。
https://github.com/openai/math
[3] OpenAI math|overview.tex:第001、003、007、032、087、102组成果目录。本文按目录转述相关结论与适用范围,不等于独立审稿。
https://github.com/openai/math/blob/main/overview.tex
[4] OpenAI math|formalization.yaml:公开的形式化成果目录。
https://github.com/openai/math/blob/main/lean/formalization.yaml
[5] OpenAI math|ComparatorChallenges:准黎曼猜想的复核入口说明。
https://github.com/openai/math/blob/main/lean/ComparatorChallenges/README.md
[6] Clay Mathematics Institute|Riemann Hypothesis:猜想的标准表述。
https://www.claymath.org/millennium/riemann-hypothesis/
[7] Clay Mathematics Institute|Hodge Conjecture:猜想的对象与基本含义。
https://www.claymath.org/millennium/hodge-conjecture/
[8] Lean官方文档|Theorem Proving in Lean 4,Introduction。
https://lean-lang.org/theorem_proving_in_lean4/Introduction/
[9] AGMAI|Responsible Release of AI-Generated Mathematics,2026年9月29日。
https://agmai.org/general-sep29/
[10] 选题参考:新智元相关报道《数学大爆炸!OpenAI 一夜攻克722个数学难题,准黎曼猜想已被证明》。本文保留其主要议题,并补充上述一手资料与个人分析。
资料整理截至2026年10月7日。文中定理与成果范围按发布方目录及相关公开说明转述;未逐篇审查全部手稿,也未独立运行Lean全库验证。文中“我认为”“我更关注”等为个人分析,不代表发布方观点。
一起聊AI,也聊真实落地
欢迎扫码添加 Allen,交流AI技术、应用与科研工作流。
海外、国产大模型一站式选购,API / Token 折扣优惠,欢迎随时咨询~