ARTICLE · 1050860
AI 工具双保险:阶跃星辰没额度自动切硅基,恢复了再切回来
一人公司 · AI 工具链
AI 工具双保险:阶跃星辰没额度自动切硅基,恢复了再切回来
换模型供应商不是改一个 URL 的事——三件套要一起换,还得有人替你盯着额度。
最近想白嫖阶跃星辰的免费额度,把本地 AI 工具的模型从硅基流动切过去。结果第一把就翻车了——而且翻得很有代表性。今天把这次的完整方案讲清楚:一个 Python 文件,实现主路走阶跃星辰、没额度自动切硅基流动、额度恢复自动切回来,上层工具全程无感。
一次翻车:改个 URL,为什么全线报错
需求很简单:阶跃星辰有免费额度,我想让工具优先用它。于是我打开了配置文件,把 base_url 从硅基流动改成了阶跃星辰。
然后工具直接罢工,报错 No API key found for provider 'custom'。
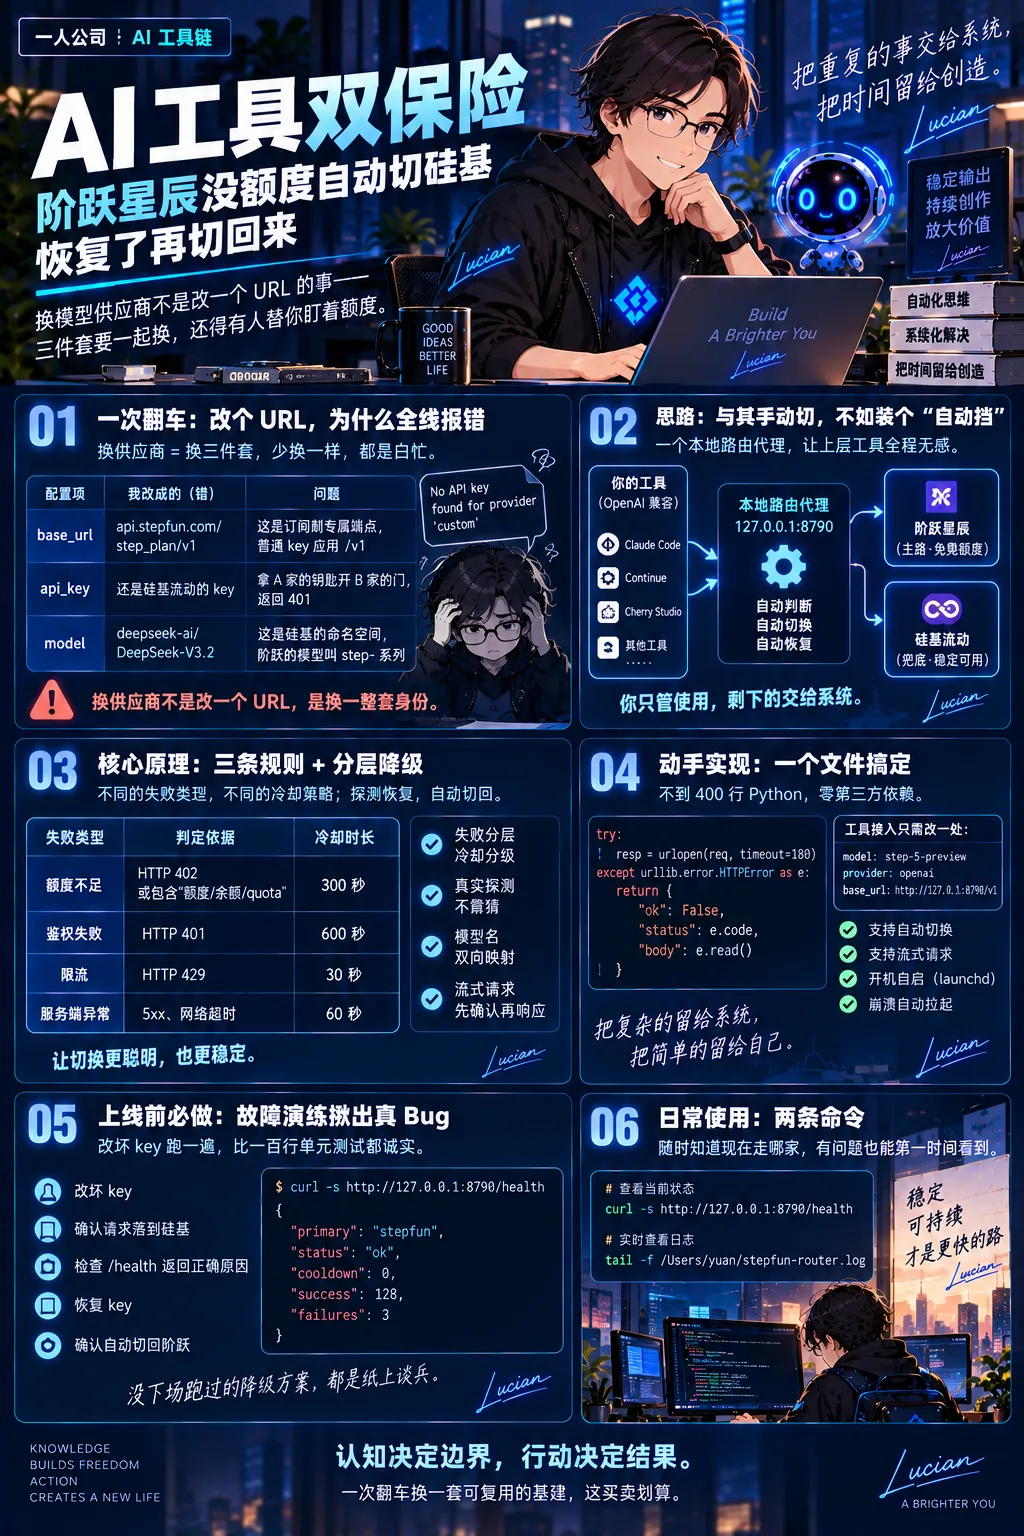
排查下来发现,换供应商 = 换三件套,我只换了其中一件:
api.stepfun.com/step_plan/v1 | /v1 | |
deepseek-ai/DeepSeek-V3.2 | step- 系列 |
更隐蔽的是第三处:就算 URL 和 key 都对了,模型名不对照样 404。三件套里任何一件没换,整条链路就是断的。
思路:与其手动切,不如装个"自动挡"
就算配置全改对,还有个更麻烦的问题:免费额度总有用完的一天。用完那天,工具又开始报错,我又得手动切回硅基流动——过几天想去试试额度恢复没有,再手动切回来。
这种"看门式运维"太累了。我真正要的是三条规则:
1.正常情况解法是在本地起一个路由代理:一个监听 127.0.0.1:8790 的小服务,说 OpenAI 兼容协议。所有工具的 base_url 都指向它,由它决定这一次请求到底发给谁。
这个结构的好处是:上层工具零改动、切换完全透明、以后想换任何供应商组合,只改代理这一个文件。
核心原理:三条规则 + 分层降级
代理内部的核心逻辑不复杂,但有几个设计点值得展开。
第一,失败要分层,冷却要分级。"阶跃不可用"有很多种死法,不同死法的恢复时间完全不同:
第二,回切靠"真实探测",不靠猜。 冷却到期后,代理先用一个 max_tokens=1 的极简请求去探阶跃:通了就切回主路;不通就继续兜底。另有一个后台线程每 120 秒探一次,额度假恢复就能提前回切。
第三,模型名要做双向映射。 客户端永远只说 step-5-preview,代理发硅基兜底前翻译成 deepseek-ai/DeepSeek-V3.2——上层工具完全不知道背后换过人。
第四,流式请求只有一个干净的切换窗口。 SSE 响应一旦开始往客户端写,就没法安全地"重来"了。所以代理必须先拿到上游 200、确认这条链路是活的,再向客户端写响应头。上游 200 之后才断流的情况,只能让这次请求失败——但这是极小概率事件,值得为它保住流式体验。
动手实现:一个文件搞定
核心转发逻辑大概长这样(简化版):
try: resp = urlopen(req, timeout=180) except urllib.error.HTTPError as e: # 关键:urllib 对非 2xx 直接抛异常! # 必须在这里把状态码和错误体捞出来,否则 # 401/402/429 的判定分支全部变成死代码 return {"ok": False, "status": e.code, "body": e.read()}拿到结果后按上面的表分层判定,主路失败就带着同一个请求体重投硅基。整个代理不到 400 行,零第三方依赖,系统自带的 Python 就能跑。
工具侧的接入简单到离谱,base_url 指向本地就行:
model: default: step-5-preview provider: openai base_url: http://127.0.0.1:8790/v1保活用了双保险:平时由 launchd 托管(RunAtLoad + KeepAlive,开机自启、崩溃自动拉起);手动调试时用双 fork + setsid 的守护脚本,退出后 30 秒内自动重启。
上线前必做:故障演练揪出真 Bug
代码写完直接上线?我强烈建议先做一轮故障演练:把主路的 key 故意改坏,重启,然后看降级是否真的按预期工作。
这一演就演出了真问题——第一轮演练时,/health 报的是"网络异常,冷却 60 秒",而不是预期的"鉴权失败,冷却 600 秒"。
根因就是上面代码注释里那个坑:urllib.request.urlopen 对非 2xx 响应直接抛 HTTPError,而它是 URLError 的子类。我原来的异常处理先接住了"网络异常"分支,导致 401、402、429 的精细判定一行都没执行到——所有失败都被误判成网络抖动,冷却 60 秒就反复重试一个注定失败的 key。
修复只花了三行代码,但如果没有演练,这个 bug 会一直潜伏到我额度真正用完的那天:每个请求都先在死 key 上浪费一次重试。
演练完整流程:改坏 key → 确认请求落到硅基、/health 显示正确原因 → 恢复 key → 确认自动切回阶跃。两边都绿,才算上线。
日常使用:两条命令
curl -s http://127.0.0.1:8790/health # 当前走哪家、冷却状态、成败计数 tail -f /Users/yuan/stepfun-router.log # 实时切换日志之后我又把默认模型从 step-3.7-flash 升级到了 step-5-preview(阶跃 API 的模型列表里确认存在),只改了两处配置,一分钟搞定——这就是把切换逻辑收敛到一个文件的好处。
写在最后
这次改造最值的不是省下的额度,而是把"看门式运维"变成了"系统自动挡"。以后任何"主备双模型"的需求——不管主路是哪家的免费额度、兜底是哪家——改两个 key 就能复用整套方案。
能沉淀成资产的活,优先做。 一次翻车换一套可复用的基建,这买卖划算。
认知决定边界,行动决定结果。
宇安 · 把重复的事交给系统,把时间留给创造