ARTICLE · 1031738
FPGA在AI领域的应用前景分析
在人工智能浪潮席卷全球的当下,计算架构正经历着一场深刻的范式转换。随着大模型和深度学习的普及,算力需求呈指数级爆炸式增长。在这个过程中,行业逐渐面临一个严峻的“不可能三角”:极致的算力性能、极低的功耗延迟、以及应对算法快速迭代的灵活性。
核心解密:FPGA 为何与 AI 具备“天然适配基因”?
FPGA 之所以能在激烈的 AI 算力角逐中占据一席之地,并非偶然,而是源于其底层架构特性与 AI 计算逻辑的深度契合。
1. 数据流驱动:打破冯·诺依曼架构的延迟魔咒
传统的冯·诺依曼架构在处理数据时,需要频繁地在内存和处理器之间进行指令读取和数据搬移,这导致了难以消除的延迟。而 FPGA 采用数据流驱动(Dataflow)架构,数据一旦到达即可触发计算,无需复杂的任务调度和上下文切换。
这种特性完美契合了 AI 推理场景中“数据输入 → 算子计算 → 结果输出”的流水线作业模式。通过将算法逻辑直接固化为硬件电路,FPGA 能够实现微秒级的确定性延迟(典型值甚至可低至 3.2μs)。在金融高频交易、自动驾驶实时感知、工业机械臂精准控制等对时间极度敏感的场景中,这种极低且稳定的延迟是不可替代的。
2. 精度自由裁剪:把能效比推向极致
在计算精度上,GPU 通常采用固定的 32 位浮点计算,这在追求绝对精度的训练阶段是必需的。然而,在 AI 推理阶段,过高的精度往往造成算力和功耗的严重浪费。
FPGA 赋予了开发者前所未有的“精度自由”。它可以根据不同 AI 模型的需求,灵活配置为 INT8、INT4,甚至是极端的二值化神经网络(BNN)。通过将复杂的乘法运算简化为基础的逻辑门(如 AND 门)操作,FPGA 能够在精度损失极小且可接受的范围内,成倍降低功耗并节省芯片面积。这种量身定制的计算方式,带来了令人惊叹的能效比提升。
3. 空间级并行:让硬件长成神经网络的模样
无论是卷积神经网络(CNN)还是循环神经网络(RNN),其本质都是海量的并行矩阵计算。GPU 采用的是“时间级并行”(大量的通用核心同时处理),而 FPGA 则是真正的“空间级并行”。
开发者可以通过动态配置内部的逻辑资源,在硅片上直接“铺设”出与特定神经网络结构完全对应的专属计算通路。这种硬件架构与软件算法的高度协同,实现了计算资源与网络结构的最优匹配,彻底消除了通用架构中不可避免的资源闲置和冗余计算。
落地生根:FPGA 在 AI 领域的核心主战场
曾经被认为是“昂贵的实验室玩具”的 FPGA,如今已大踏步迈向规模化落地,在四大核心场景中构筑了坚实的堡垒:
场景一:数据中心推理加速的“节能先锋”
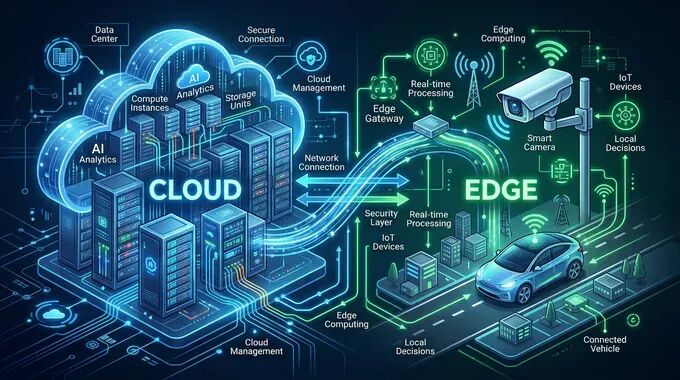
在云端数据中心,算力分工日益明确:GPU 主攻模型训练,而 FPGA 则在推理端大放异彩。亚马逊 AWS、微软 Azure 等全球顶级云厂商,早已大规模部署 FPGA 实例。
在推荐系统、CTR(点击率)预估、自然语言处理等高频、高并发的推理任务中,FPGA 通过 PCIe 接口直接挂载加速。面对固定模型的持续请求,在输出同等吞吐量的情况下,FPGA 的功耗仅为 GPU 的 1/3 甚至 1/2。在动辄消耗数兆瓦电力的超大型数据中心里,这意味着极为可观的运营成本节约。
场景二:边缘 AI 的“硬核底座”
边缘计算环境往往伴随着对功耗、体积、散热的严苛限制。FPGA 无操作系统开销、低唤醒延迟的物理特性,使其成为边缘场景的绝佳选择。
在工业质检流水线上,搭载 FPGA 的智能设备能够实时捕获并处理高清图像,在几十毫秒的瞬间精准识别极其微小的产品缺陷,同时整机保持超低功耗运行;在无人机、智能安防摄像头等场景中,FPGA 同样以“小身材、大能量”的姿态,完成着复杂的传感器融合与本地推理。
场景三:智算网络的“全能枢纽”
随着“网络即计算”理念的兴起,FPGA 正在重构数据中心的网络基础设施。被广泛应用于 SmartNIC(智能网卡)的 FPGA,实现了网络数据包处理与 AI 推理的深度融合。
以实时金融风控为例,海量的交易数据流经网卡时,无需再将数据搬移至主机 CPU 或 GPU 的内存中,网卡上的 FPGA 即可“就地”完成 AI 模型判断。这种“卸载”机制大幅降低了端到端的网络延迟,卸载了主机的计算负担,极大提升了整个集群的运行效率。
场景四:AI 芯片研发的“时间机器”
对于 AI 芯片设计企业而言,流片(Tape-out)是一次动辄耗资数百万美元、耗时数月的巨大冒险。FPGA 扮演了不可或缺的算法快速原型验证平台角色。
研发团队可以在 FPGA 上快速映射并点亮最新的网络结构原型,在真实的物理环境中测试性能指标和功耗表现。这种“先验证、后流片”的模式,不仅大幅规避了设计失败的风险,更为 AI 新架构的研发按下了加速键。
资本与技术的双螺旋:驱动市场爆发的引擎
行业预测数据显示,AI 驱动的 FPGA 市场规模正以两位数的年复合增长率狂飙。
预计将在 2028 年突破 30 亿美元大关。
这种强劲的增长势头,得益于三大引擎的共同驱动:
1. 边缘计算的全面觉醒:IDC 数据显示,未来 5 年内,超过 50% 的 AI 计算将下沉至边缘。工业互联网、智能汽车、智慧城市对低功耗、低延迟、高定制化算力的渴求,正精准命中 FPGA 的核心优势。 2. 开发门槛的系统性降低:曾经令软件工程师望而生畏的硬件开发语言(如 Verilog/VHDL),正被越来越成熟的高级工具链所取代。AMD (Xilinx) 的 Vitis AI 平台和 Intel 的 Quartus 等工具,已经实现了从主流 AI 框架(TensorFlow、PyTorch)到硬件比特流的一键化映射,让算法工程师也能轻松驾驭硬件。 3. 底层架构的进化迭代:FPGA 厂商正在主动“拥抱 AI”。在最新的 FPGA 器件中,集成了海量的 DSP 模块、专用的矩阵乘法单元,甚至融入了 RISC-V 处理器核,算力密度实现了成倍跃升,逐渐向“异构计算一体化”演进。 |
坦诚面对:挑战、生态定位与未来进化
尽管风头正劲,但 FPGA 在 AI 赛道上并非无懈可击。客观来看,其开发门槛虽然在降低,但比起极度成熟的 GPU 软件生态(如 CUDA),仍有不小的差距,跨界复合型人才极度紧缺。此外,每次重新配置硬件逻辑都需要时间,对于需要频繁更新模型、快速试错的极早期研发阶段,其灵活性略逊于 GPU。
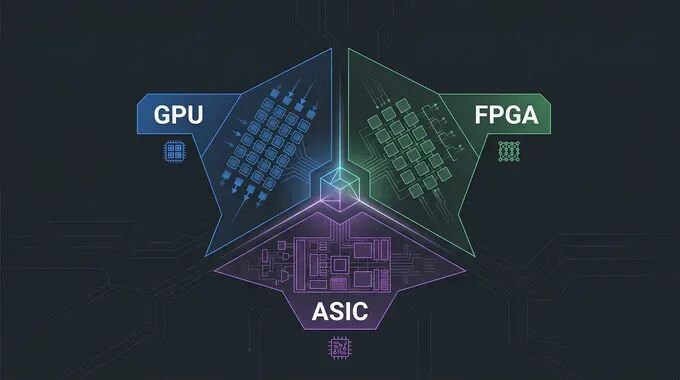
因此,在宏大的 AI 算力生态中,FPGA 的使命从来不是去“取代”GPU 或 ASIC,而是形成牢不可破的互补铁三角:
- GPU:负责大规模预训练和模型的动态试错。 - ASIC:负责算法完全定型后的海量规模化量产。 - FPGA:死磕那些需要快速迭代、高度定制化、追求极致能效与低延迟的核心场景。 |
未来 5-10 年的前瞻
站在当前的十字路口眺望,FPGA 的未来进化路径已经十分清晰:
1. Chiplet 异构集成化:单打独斗的时代即将落幕。FPGA 将以小芯片(Chiplet)的形式,与 CPU、GPU、HBM(高带宽内存)在先进封装技术的加持下实现紧密合体,为算力中心提供如变形金刚般灵活的底座。 2. 局部动态可重构(DPR)的普及:系统将在保持持续运行的同时,能够像更换软件插件一样,瞬间“热更新”局部的 AI 算法硬件逻辑,真正实现性能与极致灵活性的完美统一。 3. 存算一体的终极探索:通过与新型非易失性存储技术的深度融合,FPGA 有望打破长期困扰计算机科学的“内存墙”,实现近数据计算甚至存内计算,为未来将庞大的 AI 大模型塞进微小的边缘设备中提供终极解决方案。 |
结语
在人工智能这场深刻重塑人类社会的算力革命中,没有哪一种架构能够包打天下。FPGA 凭借其不可替代的“硬件级灵活性”、逼近物理极限的低延迟以及卓越的能效比,已经深深扎根于 AI 推理、边缘智能和网络加速的土壤之中。随着 AI 触角的无限延伸,应用场景必将更加细分和碎片化。我们有理由相信,在算力多元化的时代,FPGA 将不再是那个居于幕后的“小众硬核玩家”,而是支撑起整个智能世界平稳运转的关键支柱之一。它的无限潜能,才刚刚被唤醒。

END
来源:FPGA开源工作室