ARTICLE · 1178548
我拿一个 4B 的开源模型,把发票、文档、表格全喂了一遍
法国公司 LightOn 十月六号发了 LightOnOCR-3 系列,三个尺寸全部 Apache 2.0。我下载了旗舰 4B,自己造了四份文档喂进去跑了一天。中文小票七个关键字段全中,LaTeX 公式零误差转写,柱状图六个数据点全对,但五栏密集表格列错位了,学术页也有两处细节幻觉。olmOCR-bench 拿 86.3 排第二,前面是 35B 参数的 Infinity Parser Pro 流水线方案;ParseBench 综合第一(75.1);法语基准 74.1 同样第一。两种模式:空 prompt 出全文 markdown,prompt 写 grounding,每个区块带类型标签和 0 到 1000 的坐标框,图表直接转 HTML 表格。部署有版本坑,后面细说。如果你想给 RAG 或者文档入库找一个开源解析层,这篇看完就知道该不该用。
事情是这样的
前几天刷 HN,看到一个法国公司的名字挂在 OCR 榜单前排。点进去一看,LightOn,靠 ColBERT 检索模型起家那家,去年发过一版 1B 的 OCR 模型。这次直接发了三个尺寸:0.8B、1B、4B,全部 Apache 2.0,旗舰 4B 底座换成了 Qwen3.5 视觉语言架构。
让我停下来的是官方博客里的一句话:一个模型替掉整条文档理解流水线。
做过文档解析的人知道这话什么分量。传统做法是拼积木:PaddleOCR 检测识别文字行,版面模型切区块,表格和公式各配专项模型,最后写规则拼阅读顺序。每一环都要维护,每一环的锅最后都算到应用头上。LightOn 说你不用拼了,一个模型全干。
我是不太信的。但 4B 权重才 9GB,一张 16GB 卡就能跑,下载试一下的成本几乎为零。所以我造了四份文档,把 4B 下载到 A100 上,跑了一天。
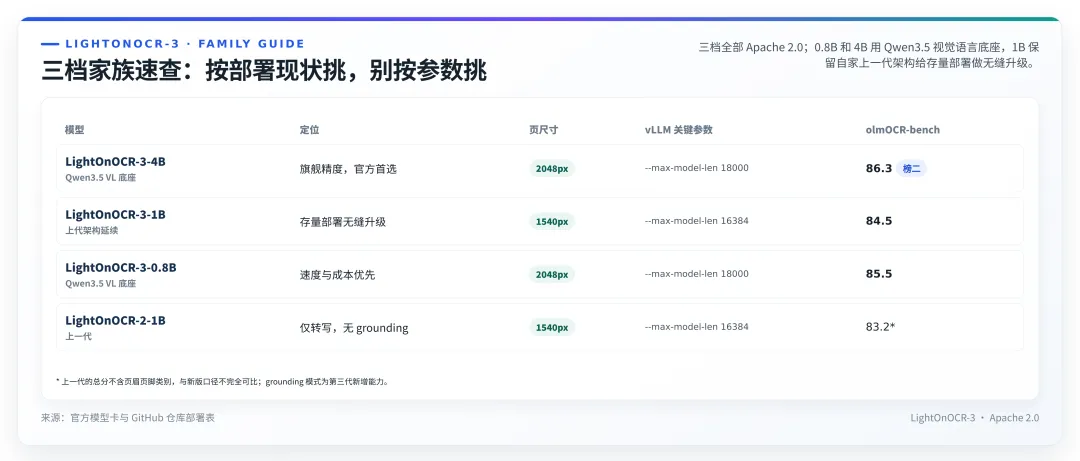
三档家族速查。1B 给存量部署无缝升级,0.8B 主打速度,4B 主打精度;页尺寸和 vLLM 参数各不相同。
先跑最简单的:一张中文小票
这张小票有五个坑:中文名(江南春面馆、桂花糖芋苗)、带小数点的价格、折扣行、合计和实收两个总额、还有虚线分隔符。
结果七个关键字段全部命中。店名对,红汤刀鱼面 32.0 对,蟹粉小笼 26.0 对,桂花糖芋苗 12.0 对,合计 83.0 对,会员折扣负 8.3 对,实收 74.7 对。输出直接是 HTML 表格,结构完好,连分隔线都保留成了单独一行。耗时 22.1 秒(抢卡环境,下同)。
grounding 模式的输出更有意思。同样的这张小票,纯转写模式给的是一整页 markdown,grounding 模式给的是按区块拆分的结构化结果:店名标了 title 类型和坐标框,菜单标了 table 类型和坐标框,每个框的坐标归一化到 0 到 1000,前端画层直接按百分比映射,换渲染分辨率不用换算。 实测里坐标的精度足够做区块级版面还原,但不要指望像素级对齐:小字号脚注和行内公式的边界框偶尔偏大,图表的框通常偏小。如果你的下游要做精确的 PDF 重排或者高亮标注,建议在 grounding 输出上叠一层 PaddleOCR 的词级检测做精修。
小票识别是 OCR 的看家本领,LightOn 的训练数据里这类场景铺得很足。这一项不算惊喜,算及格。
对做 RAG 的团队有个直接启示:小票、发票、表单这类结构化文档入库,以前要串 PaddleOCR 加版面模型加后处理规则,现在一个模型搞定,维护成本直接砍到零。但这也有代价:端到端模型的错误不可归因,你不知道是检测没框住还是识别认错了,只能整页重跑。
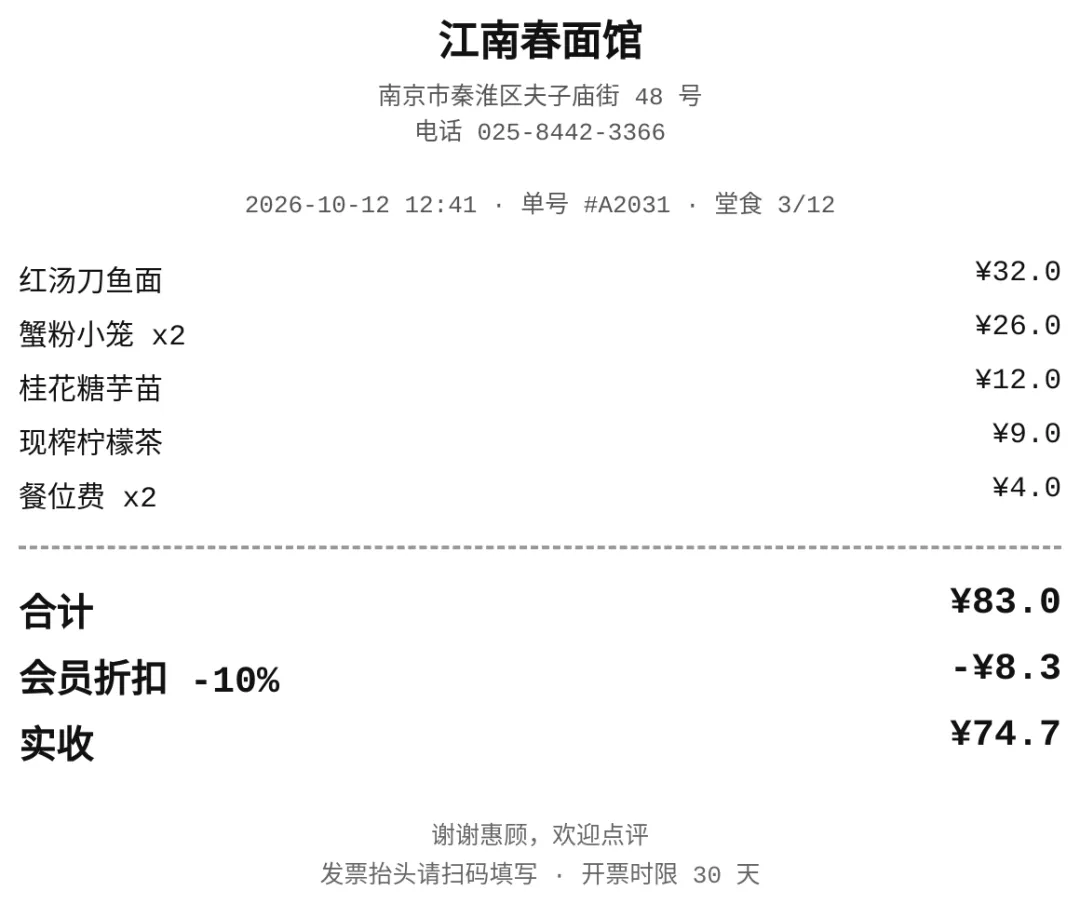
测试样本一:中文小票。七个关键字段全部提取正确,价格、折扣、实收一个不差。
然后是学术页。公式零误差,但翻车了两处
难度陡增:英文正文、一个带下标和取整符号的 LaTeX 公式、一张三行数据表、参考文献列表。
好消息:公式转写零误差。R_eff = W·(1+λ·⌊L/k⌋),连取整符号和 λ=0.83 都对。表格三行数据全对,HTML 结构完好。参考文献列表完整保留。
坏消息:两处细节幻觉。原文写 cross-page consistency 提升 11.4 个点,它输出成了 at key points,语义完全变了。另一处把 diminishing returns beyond 12K tokens 写成了 beyond 16K,八成是从旁边表格的 16K 那一行串出来的。
这类错误的麻烦在于读起来毫不违和,不做逐句比对根本发现不了。OCR 模型的输出也要抽查,这句话我以前只是说说,这次是真踩到了。 实操上有个折中方案:对高风险场景(合同、论文)做自动抽查,在输出里搜索关键数字和日期是否与原文匹配,匹配不上的自动标记。这套检查用正则就能写,成本几乎为零,但能拦住大部分细节幻觉。
把 olmOCR-bench 的分项也摊开看看:ArXiv 学术页 91.1 全场第一,旧扫描数学 89.1 逼近 Infinity Parser Pro 的 91.3,多栏 89.2、微缩字体 85.6 都在第一梯队。唯一的明显短板在页眉页脚识别,52.5 对 58.2。 微缩字体项的 85.6 虽然不是最高,但也说明模型在小字号上的表现已经可以接受。如果你的场景里有大量微缩字体,法律合同的脚注、药品说明书的用法用量、学术文档的参考文献,建议在渲染时把 DPI 从 400 提到 600 再试,不要指望模型自己在低分辨率下变好。页眉页脚对 RAG 入库多半是噪声,这项低分的实际损失有限,选型时不必过度放大。 对照上一代 LightOnOCR-2,页眉页脚项从 19.7 拉到 52.5,这是三代模型在同一条短板线上补齐的最大缺口,进步幅度非常直观。反过来,Infinity Parser Pro 在微缩字体上拿 95.8,35B 流水线在小字号上的优势确实存在。
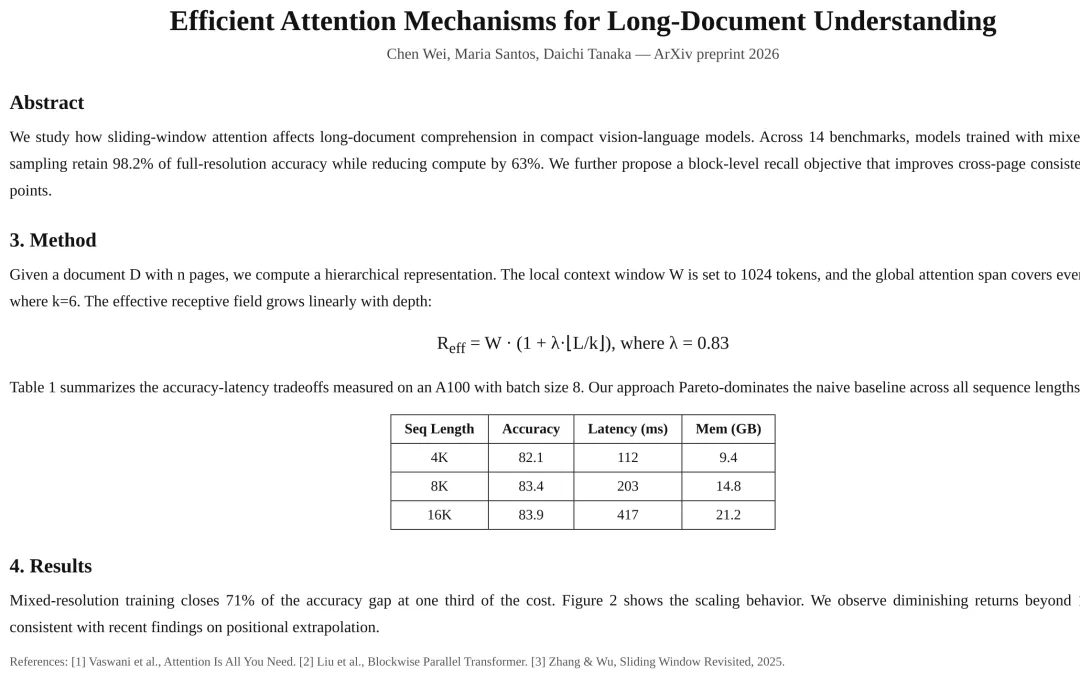
测试样本二:学术页。公式转写零误差、表格全对,但两处细节幻觉提醒你:OCR 的输出也要抽查。
五栏表格。翻车了
这张财报表格是全场唯一翻车的测试。五列:业务分部、Q3 营收、毛利率、同比、经营利润。数字本身几乎全对:1,284.6、876.2、4,120.9、+15.8% 全部命中,7/8 个关键数字正确。
但列对不上了。同比那一列是空的,同比增长的数值全部跑到经营利润列里,合计行的经营利润 791.5 丢了。数字都对,归属错了。财务系统拿到的每列含义全变了,这种错误对下游是灾难性的。
给所有想拿端到端 OCR 替换流水线的人提个醒:五列以上的密集表格、带百分比和正负号的列,是当前 4B 级模型的软肋。用之前拿自己业务里最复杂的表格测一轮,比看任何基准都管用。 实操上有一道廉价的防线:在 OCR 输出和数据库入库之间加一层列数校验,每行的单元格数量必须和表头一致,不一致就标记为需要人工审核。这层校验十行代码就能写,却能拦住大部分列错位造成的脏数据。法语基准 fr-bench-pdf2md 上 4B 拿了 74.1 排第一,手写 46.1、表单 49.6、多栏 83.6 三个子项也是第一,说明多语言和非常规版式不是短板。不过 Chandra 2 在图形识别上拿 75.1 反超,Infinity Parser Pro 在微缩字体上拿 90.6 遥遥领先,每个对手都有自己的一亩三分地。
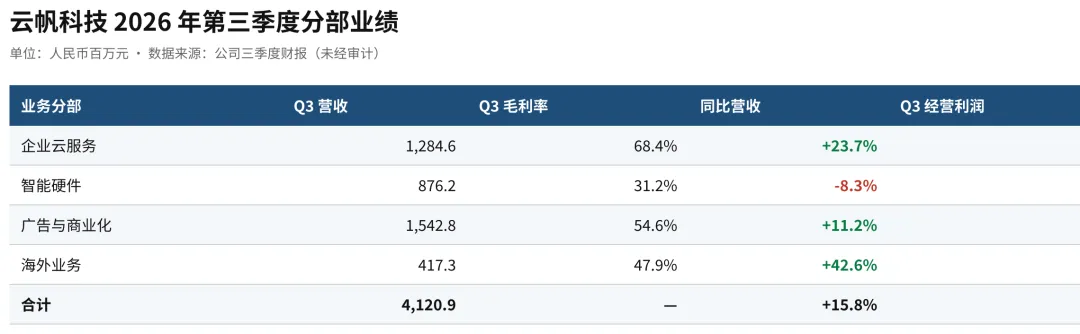
测试样本三:五栏财报表格。数字提取 7/8 正确,但同比列整体错位到经营利润列,合计行的利润值丢失。
最大的惊喜:图表直接变成表格
这页我放了一张柱状图(带数据标签)和一张双折线图(不带数据标签)。我的预期是柱状图能读个大概,折线图能读出趋势就不错。
柱状图六个数据点 128、147、165、152、189、214 全部精确提取,转成了带月份的 HTML 表格。折线图我没画数据标签,它靠读曲线位置给出了全部十二个点,续费率 3.2、3.8、4.5、4.1、5.2、5.9,和我画图时的原始数据完全一致。模型自己在输出末尾加了一句英文说明:这些数值是从折线图目测的近似值。
这句自我声明很重要。它知道自己是估的,并且告诉了你。你可以在解析时识别这类声明,对估读数据做单独标记。
图表转结构化数据是这一代最大的产品增量。财务报告里的趋势图、研究报告里的对比图,转成表格后就能进 SQL 和 BI 工具,纯文本 OCR 做不到这件事。
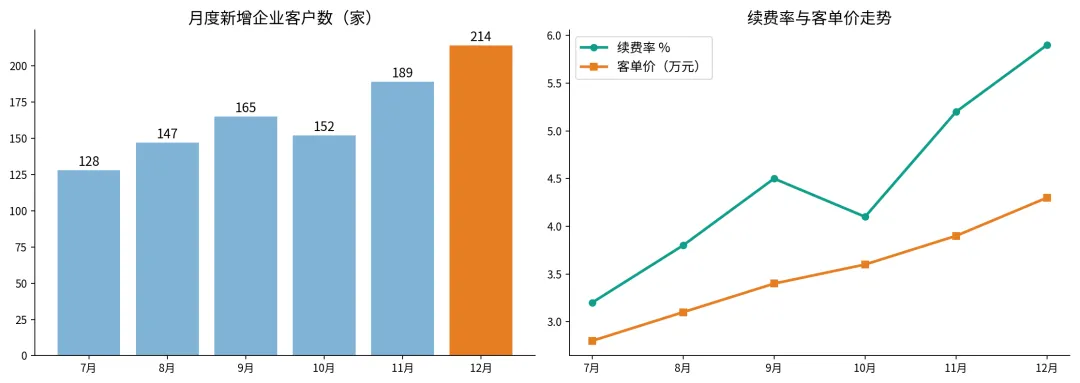
测试样本四:图表页。柱状图数据精确提取,折线图目测读点后自带近似声明。
Grounding 模式:每个区块带坐标框
空 prompt 之外,只有一个替代指令:grounding。输出在转写之外给每个区块加类型标签和边界框,坐标归一化到 0 到 1000。类型十七种,文本、标题、表格、公式、代码、图表、图片、页眉页脚、脚注、边注全有。
实测中小票的表格区块、学术页的公式区块、标题区块都标对了。坐标和页面尺寸解耦,换渲染分辨率不用换算。
用途看你的下游。做 RAG 的拿它标区块、过滤页眉页脚噪声、把图表数据单独入库,实打实的收益。 更实际的用法是在 RAG 里用坐标做精排:用户问了一个关于图表的问题,先用向量检索找到相关页,再用 grounding 模式重新处理那一页,精确框出图表位置和内容,把图表表格单独送进 LLM 生成回答。两阶段管线比一次暴力 OCR 再全文检索的精度高得多。
入库策略也有讲究:文本块直接进向量库,图表块转出来的 HTML 表格先进关系库再做语义检索,图片块配了短描述后可以走 CLIP 或者多模态嵌入。三种类型三种入库方式,比一股脑全塞向量库的效果好得多。 数据安全也要提前想:LightOnOCR-3 在本地跑,文档不出机器,这是自部署相对云 API 的核心优势。但如果下游要接在线 LLM 做摘要或问答,数据还是会出去,得做脱敏或权限控制。只做纯文本提取的话,grounding 多出来的三成 token 就是纯开销。值不值,看你的下游吃不吃结构。
grounding 的标注流水线本身也值得一看:参考转写用自家上一代保证格式一致,文字行检测用 PaddleOCR 的 PP-OCRv6,版面用 PP-DocLayoutV3 加 Docling,词级精修用 docTR,多模型各司其职后把参考文本对齐到独立检测出的区块。流程里有自动审计,缺块、可疑重复、几何冲突的页直接剔除,首轮只有 55% 的元素过审,再走递归恢复流程处理难页。这个 55% 比任何效果数字都诚实:高质量 grounding 数据就是这么难做。
官方自己承认基准有毛病
博客里专门有一节讲后处理:所有 OCR 基准都靠编辑距离打分,同一个脚注可以写成 HTML、LaTeX、Unicode 或纯文本,读者眼里等价,编辑距离里天差地别。模型越好,格式选择造成的分差占比越大。
更硬气的是官方明确说:训练数据和输出格式故意没有迎合基准偏好的写法,打分前对自家原始输出套了一组归一化函数对齐口径,函数开源可复现。归一化前后所有头部模型的分数都有明显变化,等于当众演示了编辑距离评测的脆弱性。
这种自曝比报喜可信。下次看任何 OCR 基准的分差,两三分以内先做后处理对齐再下结论。
精度方面社区有反馈说激活范围超出 FP16 动态范围会出 NaN。我在 BF16 下跑了整整一天没出过问题,试了 FP16 也没触发 NaN,输出和 BF16 的余弦一致性到了 0.9986。但这只能说明这条链路没问题,不能证明所有推理栈都安全,BF16 作为默认的结论不变。
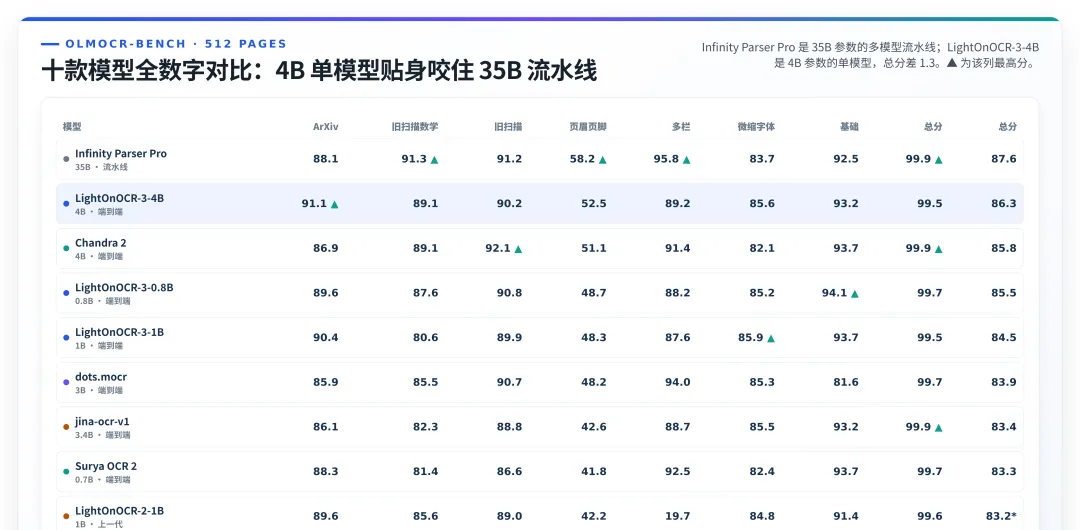
olmOCR-bench 十款模型全表。Infinity Parser Pro 是 35B 流水线,LightOnOCR-3-4B 是 4B 单模型,总分差 1.3。
部署的版本坑
transformers 要 5.5.4 以上(Qwen3.5 类在这版进入主线),vLLM 官方锁 0.30.0,5.17 会弄坏 1B 模型,0.27.1 会让所有模型输出循环。服务参数必须带 --no-enable-prefix-caching 和 --mm-processor-cache-gb 0;采样照抄 temperature 0.2、top_p 0.9;thinking 默认关闭。显存上 4B 权重 9GB 出头,一张 16GB 卡能跑。 我自己还踩了一个坑:transformers 5.19 的 AutoProcessor 加载 Qwen3.5 VL 时偶发段错误,是 fast 图像处理器的 torchvision 后端在搞鬼。解法是加 use_fast=False 走 PIL 后端,速度慢一点但稳定。如果你也在自己的环境里碰到莫名的段错误,先试这个。预处理照官方建议:PDF 按 400 DPI 渲染,长边压到 2048px。和同底座的 Chandra 2 对比,LightOnOCR-3 输出 token 少 14%,Chandra 的 olmOCR 设置还带更大图片和 579 token 的提示词,同样的评测设置下 4B 单页快 19%、吞吐高 21%。
指令只有空 prompt 和 grounding 两个,想写只提取表格之类的自定义指令,直接出训练分布。要过滤内容就在输出侧做后处理。
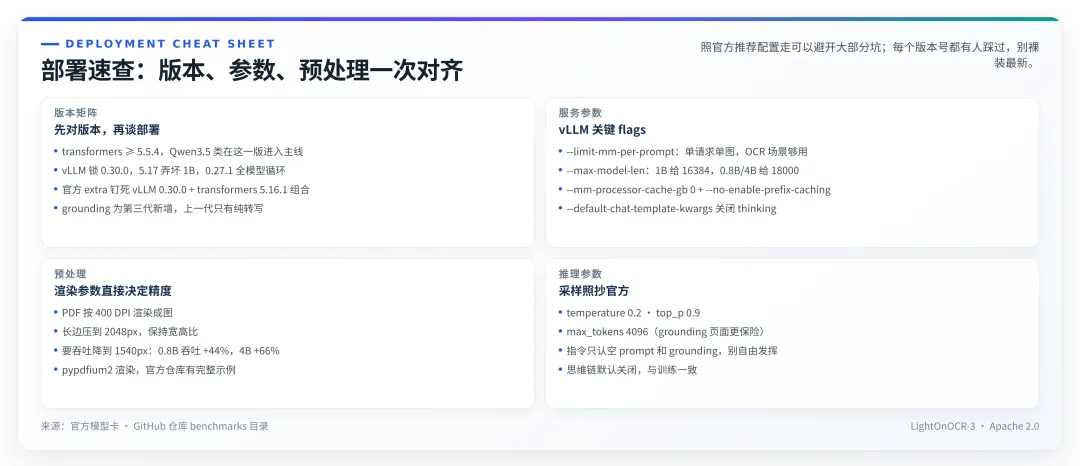
部署速查。版本、参数、预处理、采样一次对齐,别裸装最新。
社区有反馈说激活范围超出 FP16 动态范围会出 NaN,我在这套栈上跑了短文本和长文本都没触发,FP16 和 BF16 的输出余弦一致性到了 0.9986。但这只能说明这条链路没问题,不能证明所有推理栈都安全。BF16 作为默认的结论不变。
选型建议
存量 LightOnOCR-2 用户,1B 无缝升级。批量扫描、GPU 紧张,0.8B(olmOCR-bench 85.5 只比 4B 低 0.8 分,吞吐高四成)。图表数据、手写、多语言难例,4B。放在竞品里看:Infinity Parser Pro 精度天花板更高但 35B 加流水线部署成本摆在那;Mistral OCR 闭源 API 三项核心基准全落后一个身位(81.9 / 68.2 / 54.1);jina-ocr-v1 的图表提取 7.5 分、视觉定位 0 分,上一代通用方案在结构化任务上已经掉队。存量 LightOnOCR-2 用户的迁移清单也短:页尺寸维持 1540px 不动,prompt 不变,vLLM 参数照官方表更新一行就能享受精度提升。
中文场景要多一道自查:官方评测以英文和欧语文档为主,中文专项基准没有公布,发票、合同、竖排这些场景先跑一轮自己的样本,必要时和 PaddleOCR 系的中文专用引擎做 A/B,别默认端到端模型在中文上稳赢。
放在竞品里看更清楚。Infinity Parser Pro 用 35B 参数加多模型流水线堆出了最高精度,olmOCR-bench 87.6 的总分确实更高,但部署成本和维护复杂度也高了一个量级,更适合有 GPU 集群和专职运维的团队。Mistral OCR 是闭源 API,olmOCR-bench 81.9 在这张表上垫底,ParseBench 图表提取只有 40.1,图表数据基本不会提。jina-ocr-v1 的图表提取 7.5 分、视觉定位 0 分,上一代通用方案在结构化任务上的短板暴露得很彻底。Surya OCR 2 在旧扫描和基础印刷上不错但图表只有 22.0,Chandra 2 在图形识别上拿 75.1 反超但综合偏弱。没有一款模型在所有类别上全面领先,选型时必须按你自己的文档类型和精度要求逐项对。
实际部署里还有一个容易被忽略的维度:多语言混排。真实文档经常出现中英混排、中法混排,模型的跨语言处理能力在这种场景下才会真正暴露。olmOCR-bench 的多栏项 89.2 说明多栏处理没问题,但多语言混杂场景的测试数据不够多。如果你的文档里有大量日文、韩文或者阿拉伯文,建议做专项测试。
集成成本取决于你现有的栈。如果已经用 vLLM 部署过模型,加一个 LightOnOCR-3 的服务实例只是多起一个进程的事;如果没有 vLLM 经验,官方 GitHub 仓库有完整的最小客户端和 CLI 工具,从安装到跑通第一页文档的路径已经在十分钟以内。output 格式是 markdown 加 HTML 表格,下游系统不管用的是 LangChain、LlamaIndex 还是自研管线,markdown 都能直接吃。
RAG 场景的集成稍复杂一点。文本块直接进向量库,图表块转出来的 HTML 表格先进关系库再做语义检索,图片块配了短描述后可以走 CLIP 或者多模态嵌入。三种类型三种入库方式,比一股脑全塞向量库的效果好得多。grounding 的坐标框还能做精排:先用向量检索找到相关页,再用 grounding 模式重新处理那一页,精确框出图表位置和内容,把图表表格单独送进 LLM 生成回答。两阶段管线比一次暴力 OCR 再全文检索的精度高得多。
数据敏感的行业只能自部署,这也意味着可以做领域微调。云 API 的模型是黑盒,你没法拿自己的数据去适配它;自部署的开源模型可以拿几千张自己业务的标注页做微调,发票、合同、报表这些垂直场景的提升立竿见影。LightOn 官方也开源了训练代码和数据处理管线,微调的门槛不高。
这份发布还有一层行业信号:LightOn 把 4B 权重完整放在 HuggingFace 上,Apache 2.0 零限制,商用和个人使用都没有门槛。在 Mistral OCR 闭源收费、大厂 OCR 藏在云服务后面的当下,全量开源的 4B 端到端模型给中小团队多了一个不用谈价格的选择。
对工程团队,正确用法是候选池里加一个专攻长任务的选项:编码马拉松、带记忆的代理、法律金融文档流,先影子跑一周,拿真实召回和质量数据说话。三个月后回头看三件事:Infinity Parser Pro 出不出轻量版,中文版式的 grounding 评测有没有第三方做,社区量化生态能不能跟上 vLLM 的版本迭代。这三个信号会告诉你 4B 端到端这条路是真走通了,还是需要回到流水线方案。