ARTICLE · 1151533
449亿的AI智能体市场,我越来越确定:企业最缺的不是模型
这两天,我看到一组挺夸张的数据。
一份行业白皮书显示,国内企业级AI智能体市场规模在2025年达到212亿元,预计2026年增至449亿元,到2029年可能超过3320亿元。2024—2029年的年复合增长率预计达到107%。
第一反应当然是:Agent真的要爆发了。
但我平时接触智能体和企业数据比较多,看到这个数字后的第二反应反而是:
「市场规模涨得这么快,企业真的已经把智能体用起来了吗?」
我觉得还没有。
至少目前,很多企业遇到的问题已经不是“模型不够聪明”,而是模型进入真实工作以后,突然什么也看不见。
智能体看起来什么都懂,进了企业却很容易“失明”
平时我们和AI聊天,会觉得它知识面很广,写方案、做总结、列框架都很快。
但把问题换成一个真实业务任务,差别马上就出来了。
比如
帮我判断这家公司能不能进入供应商名单。
如果AI拿不到外部企业数据,它大概率只能告诉你一个通用方法:查工商、查股东、查司法风险、看经营状况,再分析财务和履约能力。
这些建议没错,但它并没有真正替你完成工作。
要把任务做下去,仍然需要人去不同网站查询公司名称、统一社会信用代码、股东、经营异常、开庭公告、裁判文书、招投标和知识产权,再把结果复制给AI。
「人负责找数据、搬数据、解释数据,AI负责把这些内容重新写一遍。」
这也是我最近越来越明显的感受:模型能力进步得很快,但企业真实数据并没有自动进入模型。
模型像一个很聪明的新员工,却没有系统账号、没有数据库权限,也不知道最新业务发生了什么。这种情况下,再聪明也只能做一些外围工作。
为什么最近所有人都在谈MCP?
MCP的全称是Model Context Protocol,中文通常翻译为模型上下文协议。
如果不讲技术概念,可以把它理解成一套给AI使用的“标准插座”。
过去,一个AI产品想调用企业数据库、知识库或业务系统,通常要针对每个平台单独开发接口。换一个智能体,可能又要重新接一遍。
MCP想解决的是:数据和工具按照统一方式开放,智能体根据问题自行选择需要调用的能力。
这套协议扩张得非常快。MCP官方曾披露,其生态已经拥有超过1万个活跃Server,SDK月下载量超过9700万次。Atlassian最近重构的MCP Server,则提供了220多个工具,官方称日调用量已经超过1500万次。
「AI不再满足于知道答案,而是开始真正连接工具、数据和工作流程。」
不过,我觉得这里也很容易产生另一个误解。
MCP只是插座,不是电。
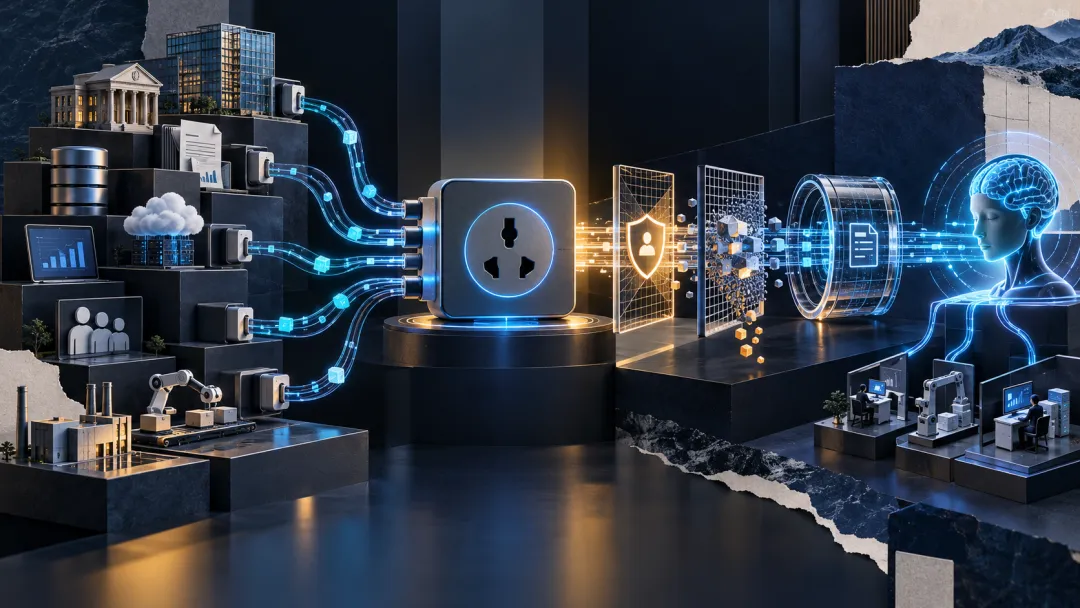
装上MCP,不代表数据自动变得准确,也不代表AI可以不受限制地访问所有信息。真正决定它能不能用于企业场景的,仍然是背后的数据质量、更新频率、权限控制和调用记录。接口接通只是第一步。
我最近试了一次“让AI自己查企业”
我平时经常需要了解一家公司。
有时是看供应商有没有明显风险,有时是研究竞争对手最近在做什么,也可能只是入职、合作之前想先弄清楚交易对象是谁。
过去最麻烦的不是完全查不到,而是信息分散。
公司主体在一个页面,股东在另一个页面,司法风险和经营信息又要分别打开;如果是上市公司,还得继续找财报。
最近有人向我推荐了一个叫质数幻方企业数据MCP的工具。我把它接入WorkBuddy后,用同一个问题做了测试:
PROMPT
查询某公司的企业主体、股东、经营状况和近三年风险信息,按时间整理主要变化,区分已经登记的事实、需要关注的异常和暂时无法确认的信息。
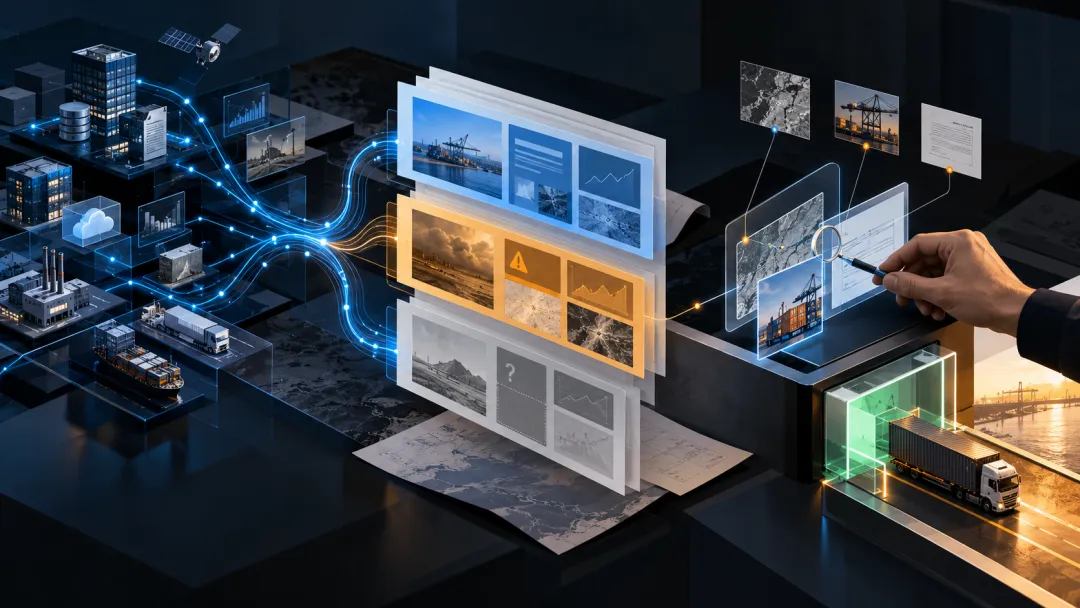
它给我的体验更像是:AI先根据问题选择企业数据工具,再把企业主体、风险、经营、财务和知识产权等结果组织到一起。
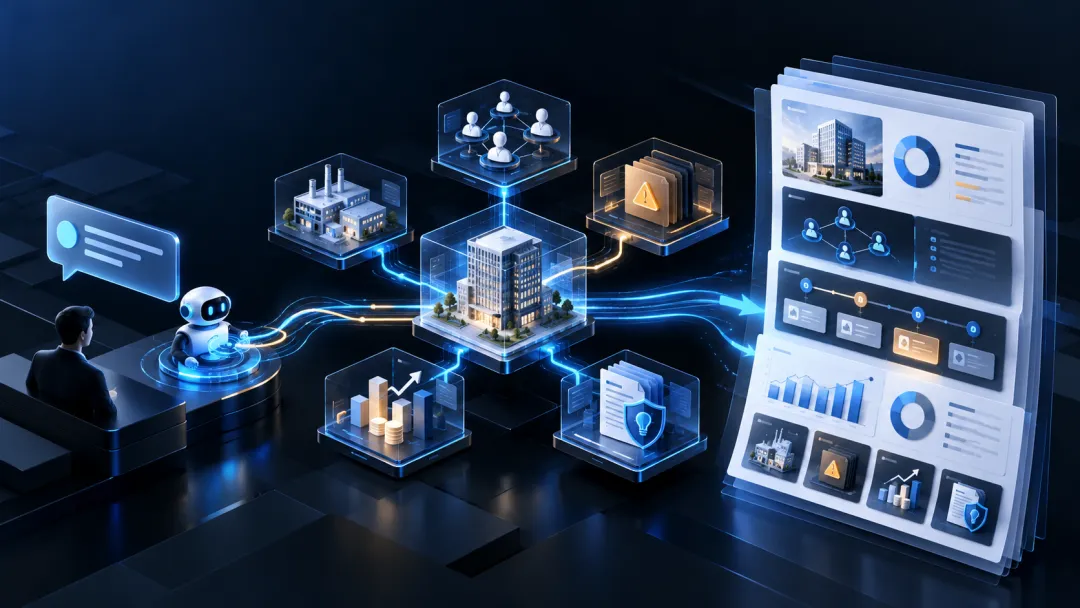
我不需要先打开几个网站,把数据一项项复制进去。
对我来说,最实用的地方不是“多了一个企业查询网站”,而是企业数据终于能直接进入AI的工作流。
我可以继续追问:
• 最近三年的风险是在增加还是减少?
• 这家公司主要参加过哪些招投标项目?
• 它的专利集中在哪些技术方向?
• 品牌名称、签约主体和实际收款公司是不是同一家?
AI拿到结构化数据后,可以直接整理时间线、做对比表,或者生成一份初步分析。
当然,这并不意味着它能替人做最终判断。
公开企业数据可能存在更新延迟、返回上限和统计口径差异;涉及投资、诉讼、授信或重大合作时,仍然需要回到上市公司公告、裁判文书、监管部门等权威渠道核验。
它更适合解决“先把数据找齐、理顺,再决定去哪里深挖”这一步。
企业真正缺的,可能不是再买一个更大的模型
艾瑞咨询的报告提到,目前多数企业的AI Agent应用仍集中在L1的探索试验级和L2的局部赋能级。
这个判断和我的体感比较接近。
很多企业已经买了模型,也做了聊天入口,但员工真正工作时,还是要自己登录系统、查数据、复制内容,再让AI帮忙润色。
如果数据层没有接通,智能体很难从“会聊天”走向“能完成任务”。
所以,如果让我总结企业接下来最值得做的几件事,我会选这三条:
第一,不要一上来就追求万能智能体,先找一个结果可以验证的具体任务。
第二,先盘点任务需要哪些数据,以及这些数据能不能在合适的权限下被AI调用。
第三,把结果来源、调用记录和人工复核留在流程里,而不是只看AI最后生成的那段话。
供应商核查、客户背调、招投标分析、上市公司财务对比,都是比较适合先跑通的场景。因为输入和结果相对明确,也更容易判断AI到底有没有节省时间。
写在最后
449亿元当然是一个很大的市场。
但我现在更关心的不是还有多少家公司宣布“接入大模型”,而是这些模型能不能进入真实业务流程,拿到可靠的数据,并把一件具体工作做完。
「模型决定智能体能想多远,数据决定它能不能真正动起来。」
如果你平时也会使用WorkBuddy、Codex或其他支持MCP的智能体,可以选一家自己熟悉的企业,试着让AI完成一次主体核验或风险整理。
我最近在用的质数幻方企业数据MCP,目前覆盖企业主体、风险、经营、财务和知识产权等数据能力,注册后也有免费调用额度。低频查询的话,先体验一轮基本够用。
官网:https://mcp.yidian.cn/
建议不要只问“帮我分析这家公司”,而是把问题说具体一点
PROMPT
查询这家公司的准确主体、股东与实际控制关系、近三年司法和经营风险,并把已确认事实、风险信号、数据缺口分别列出来;重要结论附上对应数据依据。
你会很快发现,AI有没有连接真实数据,输出结果完全是两回事。
如果大家感兴趣,后面我可以再挑一个具体案例,实测一次企业数据MCP到底能查出什么,也聊聊哪些结论不能只交给AI。
资料来源与说明
1.CIDC联合发布《AI智能体赋能行业决策:趋势与实践白皮书(2026)》。
2.艾瑞咨询《2026年中国企业级AI Agent发展洞察报告》。
3.Model Context Protocol官方博客与Atlassian官方博客公开信息。
4.国家数据局关于十大行业数据资源开发利用攻坚行动的公开信息。
注:文中市场规模均为研究机构预测值,不代表已经实现的实际收入;企业数据与AI分析结果仅用于信息检索和辅助判断,不构成投资、法律、授信或其他专业意见。