ARTICLE · 1207124
chatexcel的空间数据处理能力
别小看表格里那两列经纬度:我让 AI 直接把表变成了空间数据
会聊天不难,难的是把结果变成你能直接打开的文件。
市场部的同事发来一张门店表:21 家门店,字段是「门店名称 / 地址 / 经度 / 纬度」,需求只有一句——"能不能在地图上看一下分布?顺便标上属于哪个大区、谁负责。"
按老办法,这件事得走三步:装一个 GIS 软件、把经纬度导进去、再想办法把另一张"区域-负责人"对照表匹配进来。光是第一步就够劝退一半人,第三步的 VLOOKUP 更是大概率满屏 #N/A。
而这次我一步都没走。全程只有一段对话:把表丢进去,说清楚要什么,然后拿到了一个能直接双击打开的空间数据文件(.shp)、一个配套的属性表,以及一份告诉我"哪几条需要人工复核"的报告。
这篇文章把过程完整拆给你看,顺便聊一个更本质的问题:为什么有的 AI 只能给你建议,有的 AI 能直接交付文件?
· · ·
一、先破一个误区:AI 会不会做事,取决于它手里有没有"工具"
我们都习惯把 AI 当"一个很聪明的脑袋"。但说句实话:大模型本身只会输出文字。
它不会自己打开你的 Excel,不会读你的 PDF,更不会凭空写出一个 .shp。所有"看起来像在干活"的动作,背后都是它在调用工具:
你要的结果 | 需要什么工具 |
表格清洗、合并、汇总 | 表格引擎 |
经纬度 → 空间数据 | 地理/空间数据处理 |
读 PDF、Word、扫描件 | 文档解析、OCR |
找外部数据 | 检索与网页抓取 |
统计、建模、算距离 | 代码执行环境 |
出图、出报告、出看板 | 图表/文档渲染 |
所以判断一个 AI 能不能用进你的业务,别问"它聪不聪明",问这三个问题:
1. 这件事需要什么工具?
2. 它能不能拿到并正确调用这些工具?
3. 用完以后,它能不能自检结果对不对?
我这次实测的三件事,正好把这三问答完了。
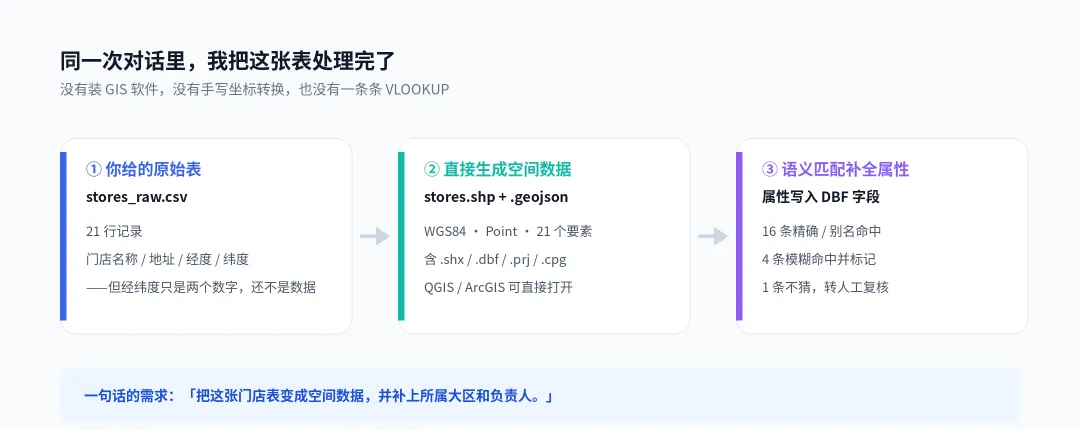
图1:原始表 → 空间数据 → 属性补全,一次对话走完
· · ·
二、第一步:把"两个数字"变成真正的空间数据
我给它的原表长这样
门店名称 | 地址 | 经度 | 纬度 |
世纪大道旗舰店 | 上海市浦东新区世纪大道 8 号 L+MALL 3F | 121.5057 | 31.2397 |
观前街店 | 苏州 姑苏区观前街 158 号 | 120.6199 | 31.3077 |
未来科技城店 | 杭州余杭区文一西路 1218 号 | 119.9900 | 30.4200 |
在 Excel 里,这两列就是普通的数字;但在 GIS 的眼里,它们是"坐标"——只要有坐标,点就能落在地图上。
它做的事,比"导出文件"多得多
1. 识别结构:认出哪一列是经度、哪一列是纬度,识别出坐标系(WGS 84);
2. 建要素:21 条记录 → 21 个点要素,一条不多一条不少;
3. 写标准格式:输出 stores.shp,同时补齐配套的 .shx / .dbf / .prj / .cpg;
4. 额外给一份 `.geojson`:单文件、文本可读,方便临时查看和发人;
5. 回读自检:重新读一遍刚生成的文件,核对要素数与记录数一致、坐标范围落在合理区间。
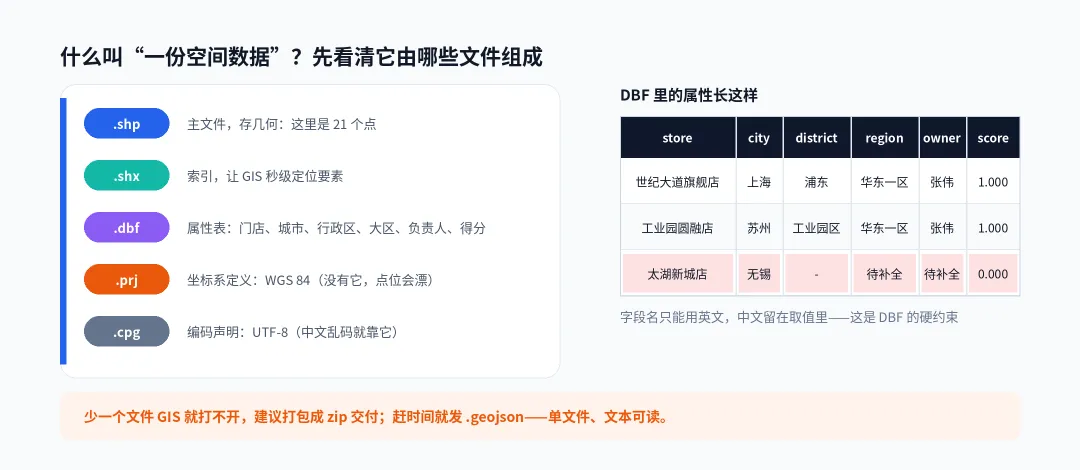
图2:一份"能用"的空间数据由 5 个文件组成,少一个就可能打不开
这里插一句踩坑提醒:Shapefile 的字段名只能放英文(DBF 的硬约束),所以属性名是 store / city / district / region,中文留在取值里。真正专业的做法,是让它顺手把字段含义写进随附的报告里,而不是丢一堆拼音缩写给你。
落图以后,就是这张点位图——每个点都是一条真实记录,颜色代表大区:
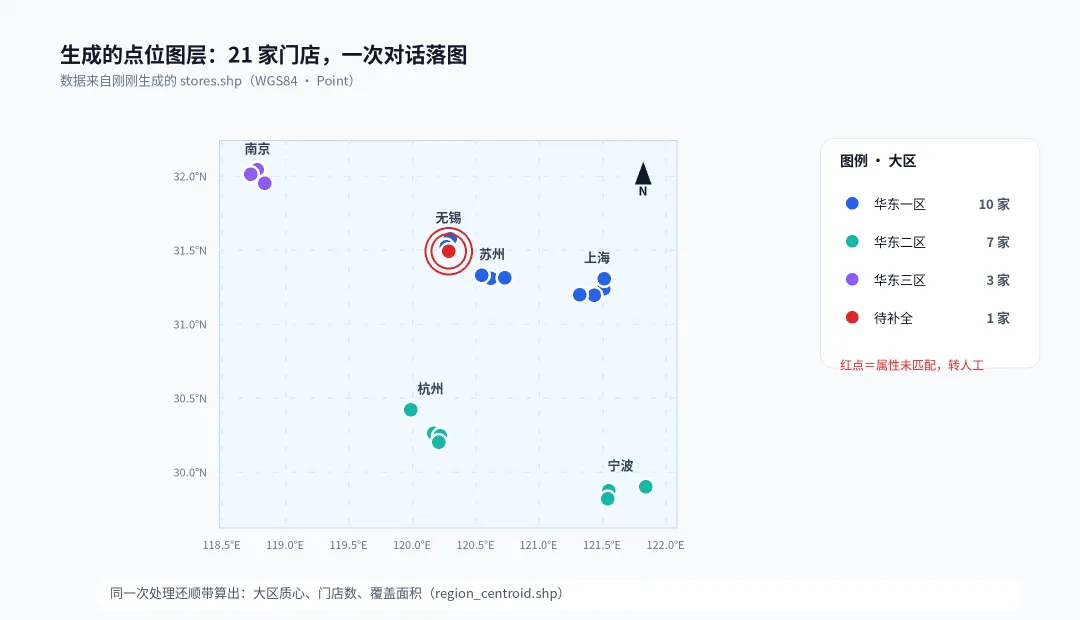
图3:21 家门店一次落图;红色虚线圈出的是属性未匹配、需要人工确认的那一家
还有两个"顺手"的价值
• 空间统计:它同时算出了每个大区的质心坐标、门店数、覆盖面积,并单独输出了一层 region_centroid.shp——大区覆盖范围差多少,一眼看得出;
• 坐标系提示:如果你的坐标是从高德、腾讯地图上抓的,那是 GCJ-02(火星坐标系),直接当 WGS 84 用会整体偏移几百米,在提问里说清楚坐标系,比事后返工便宜得多。
· · ·
三、第二步:比"生成文件"更难的,是把属性补全
空间数据只解决了"在哪儿"。真正卡住人的是"它属于谁管的"。
我手上还有一张对照表:城市、行政区、大区、负责人、城市等级。听起来是两个表的 join,写个 VLOOKUP 就完了?跑一下就知道有多疼:
• 门店表写"上海市浦东新区",对照表写"上海 / 浦东";
• 门店表写"陆家嘴环路",对照表里根本没有"陆家嘴"这个词;
• 地址里连行政区都没有,只剩一个"经济开发区"。
精确匹配(VLOOKUP)本质是在比字符串,而这些差异是"说法"问题,不是"数据"问题。 所以它必须换成语义路线:
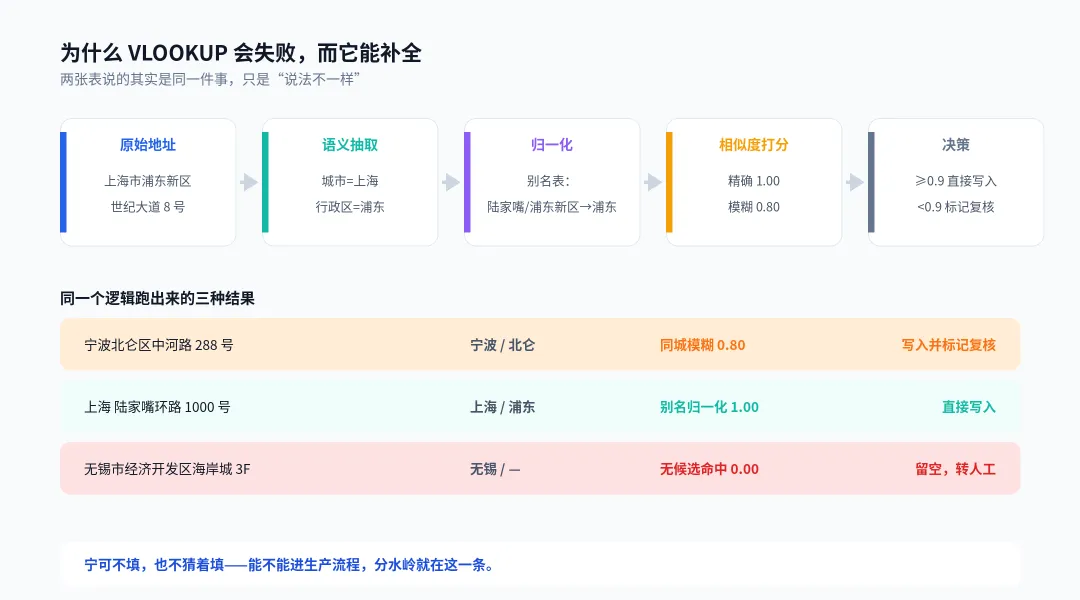
图4:抽取 → 归一化 → 打分 → 决策,每一步都能被解释
1. 语义抽取:从自然语言地址里抽出「城市 + 行政区」,而不是硬套正则;
2. 归一化:用别名表把"陆家嘴 / 浦东新区"统一到"浦东",把"上海市 / 上海"归一;
3. 相似度打分:精确命中记 1.00,同城模糊匹配按相似度给分;
4. 阈值决策:≥0.9 直接写入;<0.9 写入但标记复核;没有候选的留空,不猜。
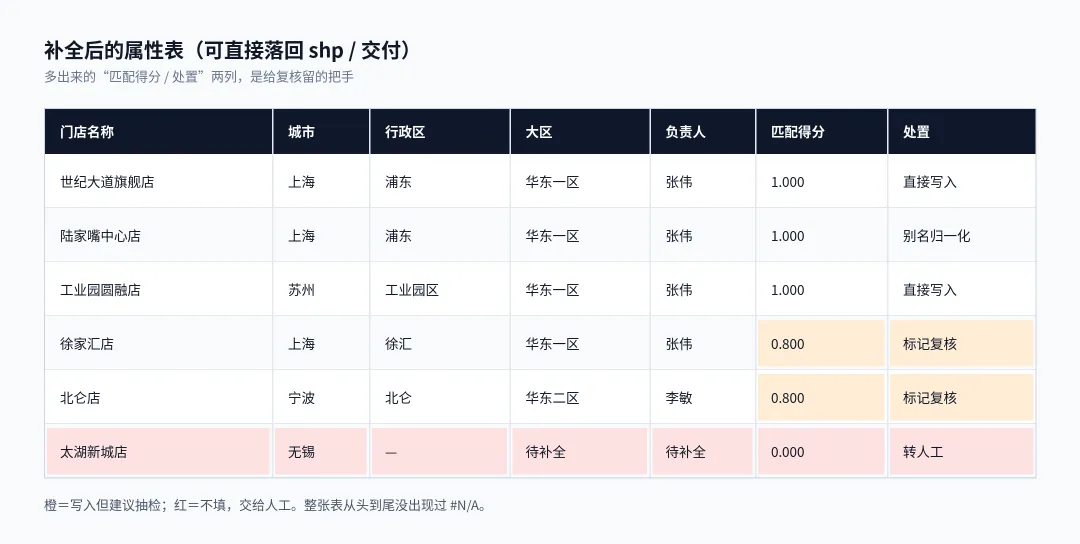
图5:多出来的"匹配得分 / 处置"两列,是给复核留的把手
最终结果:16 条精确或别名命中,4 条模糊命中并标记,1 条直接转人工——全表没有出现一个 #N/A,也没有一条被"猜着填"。
这一点值得单独说一下:
宁可不填,也不猜着填。 能不能进生产流程,分水岭就在这一条。
因为做对 20 条、错 1 条,你可能还查得出来;但错的那 1 条被"看起来很确定"地填进去,就会一路传到报表和决策里。
· · ·
四、同一套逻辑,换一种数据也一样
空间数据只是这套能力的一个切片。既然能力来自工具调用,那么工具箱里有什么,它就能处理什么:
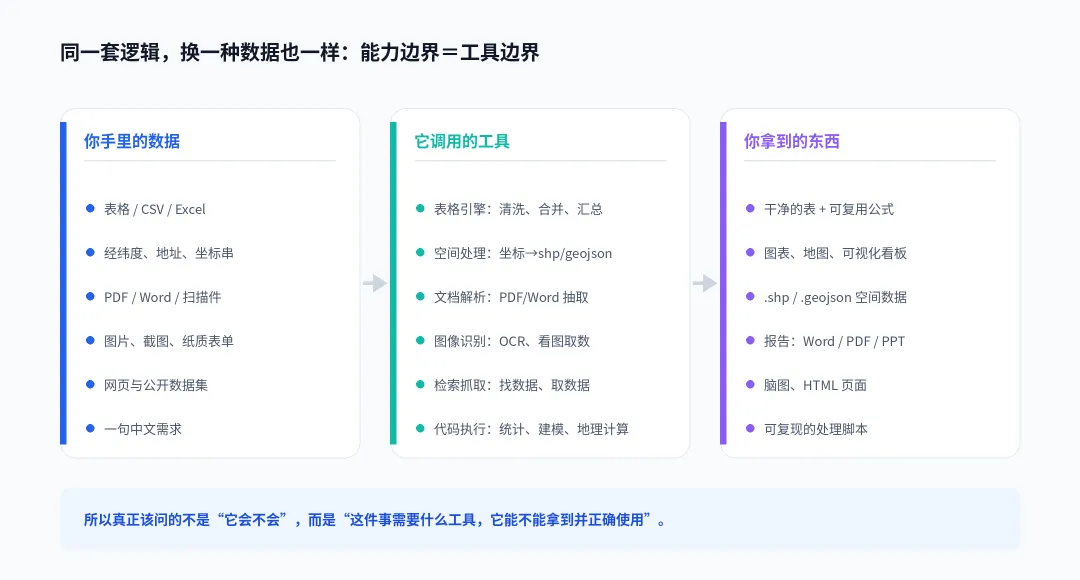
图6:同一套逻辑,换数据、换工具、换交付物
一些已经能直接用的例子:
• 表格类:清洗、纠错、多表合并、按月拆分、透视汇总、生成可复用的 Excel 公式;
• 地理类:经纬度/地址 → 空间数据、按区域聚合、质心与覆盖范围、区域间距离测算;
• 文档类:从 PDF / Word 里抽取条款、发票、报表字段,再落成一张表;
• 图像类:截图、照片里的表格直接识别成数据,不用手抄;
• 外部数据类:检索并抓取公开数据集,补进你自己的表里;
• 交付类:图表、地图、可视化看板、Word / PDF / PPT 报告、脑图、HTML 页面;
• 计算类:统计、建模、批量处理——需要算的时候写代码算,而不是"估个大概"。
这里的关键变化是:你交付的不再是"一句建议",而是一个能直接打开的文件。
· · ·
五、边界:什么能交给它,什么不能
越是专业的人,越该清楚工具的边界。我的三条经验:
能交给它的:
• 步骤可拆解、结果可验证的活(生成了 21 个要素?数一下就知道);
• 需要"重复很多遍"的活(几十张表、几百条地址,正适合);
• 需要留痕的活(要求它给出处理过程、匹配依据、自检结果)。
不要交给它的:
• 业务口径的判断:含不含退货、哪笔算已确认收入——这些是人的责任;
• 不可验证的结论:没有依据的判断,再流畅也是在赌;
• 涉密数据的合规决策:数据能不能上传、走哪条通道,先问合规。
三个能立刻用上的习惯:
1. 把前提说清楚:坐标系、单位、时间口径、字段含义,一句话交代完;
2. 要过程,也要自检:"告诉我你怎么匹配的""回读一遍确认要素数和记录数一致";
3. 低置信度结果留人复核:让机器把 95% 走完,把 5% 标出来给你看。
关于数据安全,官方口径是:数据在"隔离的云端会话环境"中处理,浏览器是唯一访问路径,全程加密;无操作 20 分钟后数据永久删除,且用户数据不参与大模型训练。数据更敏感的团队,还可以选一体机本地化部署或 AI PC 本地处理,数据不出内网。不确定的,先脱敏再上传。
· · ·
六、怎么开始(附我的专属入口)
如果你想试试"把表变成文件"是什么体验,入口给你:
我的专属入口:https://www.chatexcel.com/workspace/workbenches?commission_id=LINRU2
建议你的第一个实验就挑这种:
我这张表有经度、纬度(WGS 84),请生成空间数据并导出 Shapefile 和 GeoJSON;再按地址补全所属大区和负责人,匹配不确定的单独列出来给我复核。
"给结果 + 给依据 + 标出不确定"——把这三句话说出来,你就已经会用 AI 干活了。
· · ·
写在最后
过去我们评价一个工具,看它功能多不多;现在更该看的是:它的手能伸多长。
一个只会聊天的 AI,再聪明也只能停在"建议"这一层;而一个能调用工具的 AI,可以把表格变成地图、把地址变成空间数据、把一堆散文件变成一份能交付的报告。
你手里那些"看起来没法自动化"的活,很可能只是缺一把合适的扳手。
· · ·
如果这篇文章对你有用:
• 点个 赞 / 在看,让还在手动匹配表格的同事看到;
• 转发给那个每次做区域汇报都要熬夜的人;
• 想直接上手的,点上面的专属入口,或后台回复「表格」。