ARTICLE · 1207261
AI高薪分水岭:评估能力>代码能力
一位拥有33万粉丝的海外内容创作者Aakash Gupta,读了1177份公开招聘的产品经理职位,其中562份属于AI岗位。他按"产品经理实际塑造什么"把这些岗位分成四类,薪资差距拉得很开:最低的应用型年薪中位数22.2万美元,最高的模型型达到34.5万美元。
这份榜单值得机关、高校和企业的管理者认真看,原因和求职者关心的正好相反。它透露的真正信号是:当AI进入大规模落地阶段,市场上最稀缺、定价最高的能力,是说清楚"什么叫做好"并判断系统达没达标——也就是评估(evals)能力。 对正在决定"用不用AI、怎么管AI"的机构来说,这意味着验收权必须握在自己手里,不能交给卖方。
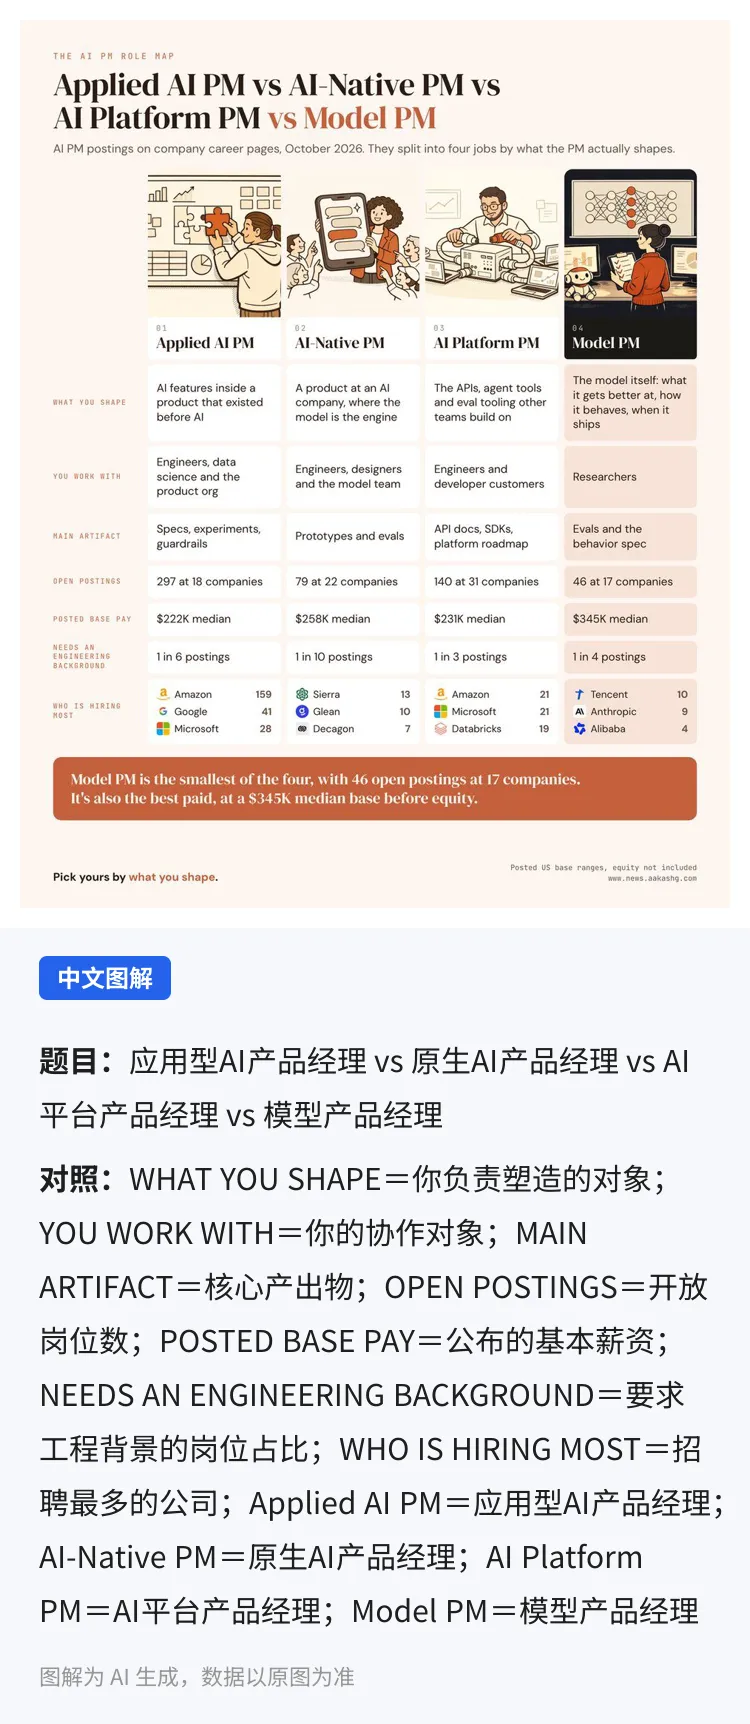
账号@aakashgupta发帖,基于562份招聘信息把AI产品经理分为四类并列出薪资中位数
四类岗位,钱按"你离模型多近"排
四类岗位的边界相当清楚。应用型AI产品经理给已有产品加AI功能,297个空缺,中位数22.2万美元,亚马逊、谷歌、微软招得最多;原生AI产品经理在AI优先的公司做产品,79个空缺,25.8万美元;AI平台产品经理做API和开发者工具,140个空缺,23.1万美元;模型产品经理决定模型学什么、何时上线,仅46个空缺,中位数34.5万美元,腾讯、Anthropic、阿里巴巴招聘最多。
作为参照,非AI产品经理的中位数是21.6万美元。模型产品经理高出约60%,而且这种溢价无法单用资历解释:同一职级对比,中级模型产品经理37.1万美元、同级非AI产品经理20万美元,高出86%。招聘区间上限更夸张,OpenAI核心模型产品经理最高49万美元,Anthropic安全防护产品经理最高46万美元。
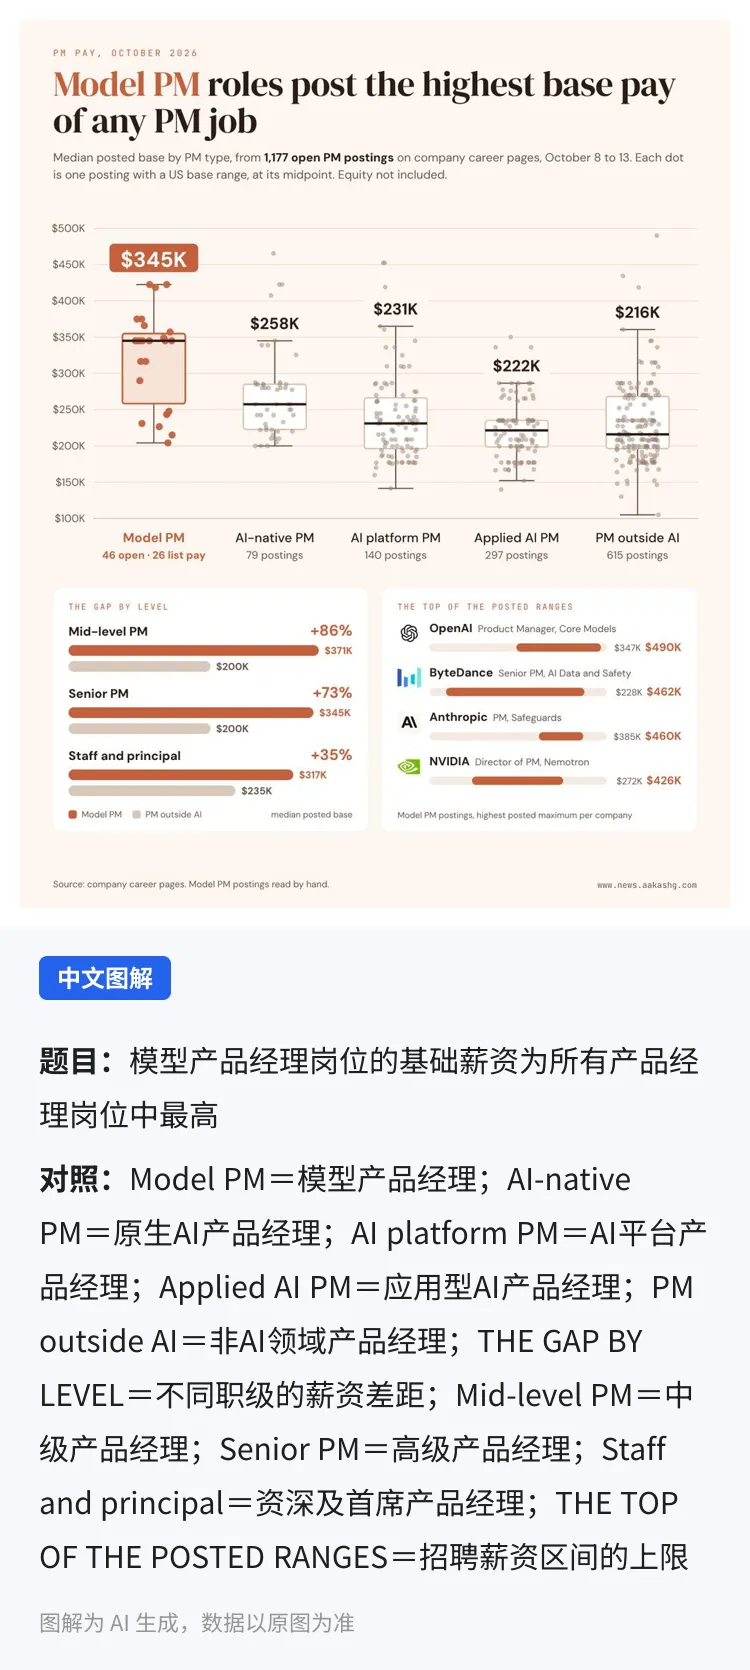
账号@aakashgupta发帖,列出模型、原生、平台、应用型AI产品经理与传统产品经理的薪资中位数
岗位数量的分布同样说明问题。最大的市场是应用型AI:297个空缺、18家公司,也就是绝大多数机构正在做的事——给现有业务加AI。离模型最近的岗位最少、最贵。曾在谷歌领导Gemini和Veo产品工作的Madhu Guru估计,全球具备深度原生AI产品能力的产品经理不到75人。
高薪买的不是学历,是评估能力
模型产品经理的招聘要求,和多数人想象中的"技术门槛"对不上。46份职位描述里,只有1份提到博士学位,只有8份要求Python或SQL;出现频率最高的要求是评估能力,占76%。34%的平台型岗位要求工程背景,模型型反而只有约四分之一。
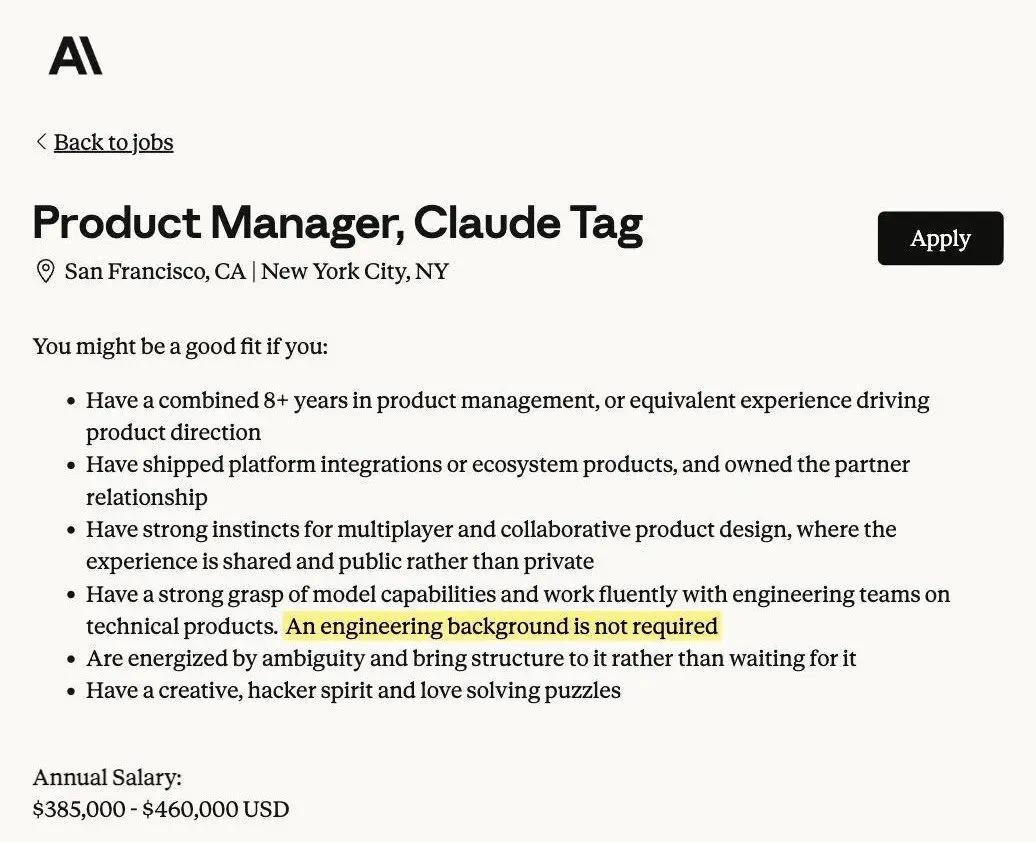
作者此前另一项统计可以互相印证:他让AI读了36家公司、8354个在招职位,筛出651个产品经理岗位,其中151个AI产品经理岗位不要求实操机器学习经验,只有15个明确要求;前者薪资中位数26.2万美元,非AI岗位21.6万美元。Anthropic为Claude开出38.5万至46万美元的产品经理职位,招聘启事写明"不需要工程背景",但要求"对模型能力有深刻理解";OpenAI核心模型产品经理则要"懂得把线下评估与线上实验、用户信号结合起来"。
账号@aakashgupta发帖,统计36家科技公司651个产品岗位后发现多数AI产品经理不要求机器学习经验
换句话说,市场高价购买的是两种判断力:知道模型能做什么,以及知道怎么衡量它做得好不好。 原帖评论区里一位从业者的概括很准确:规格文档描述意图,评估才强制执行意图;面对一个每次回答都不完全相同的系统,能写出好评估集的人,实际上是在定义"完成"是什么意思。
"评估就是新时代的需求文档"
谷歌Gemini模型产品负责人Tulsee Doshi在一期播客中讲得更直白。她说,研究人员几乎可以改进任何你能精确描述的东西,所以稀缺技能是说清楚"好"长什么样——"评估真的就是新时代的产品需求文档"。她建议的入手方法是准备20个输赢一目了然的提示词示例;她团队里"技术"的含义也并非计算机科学背景,金融、咨询出身的人同样被招,关键是能在95%的基础上"再往下挖两层"。
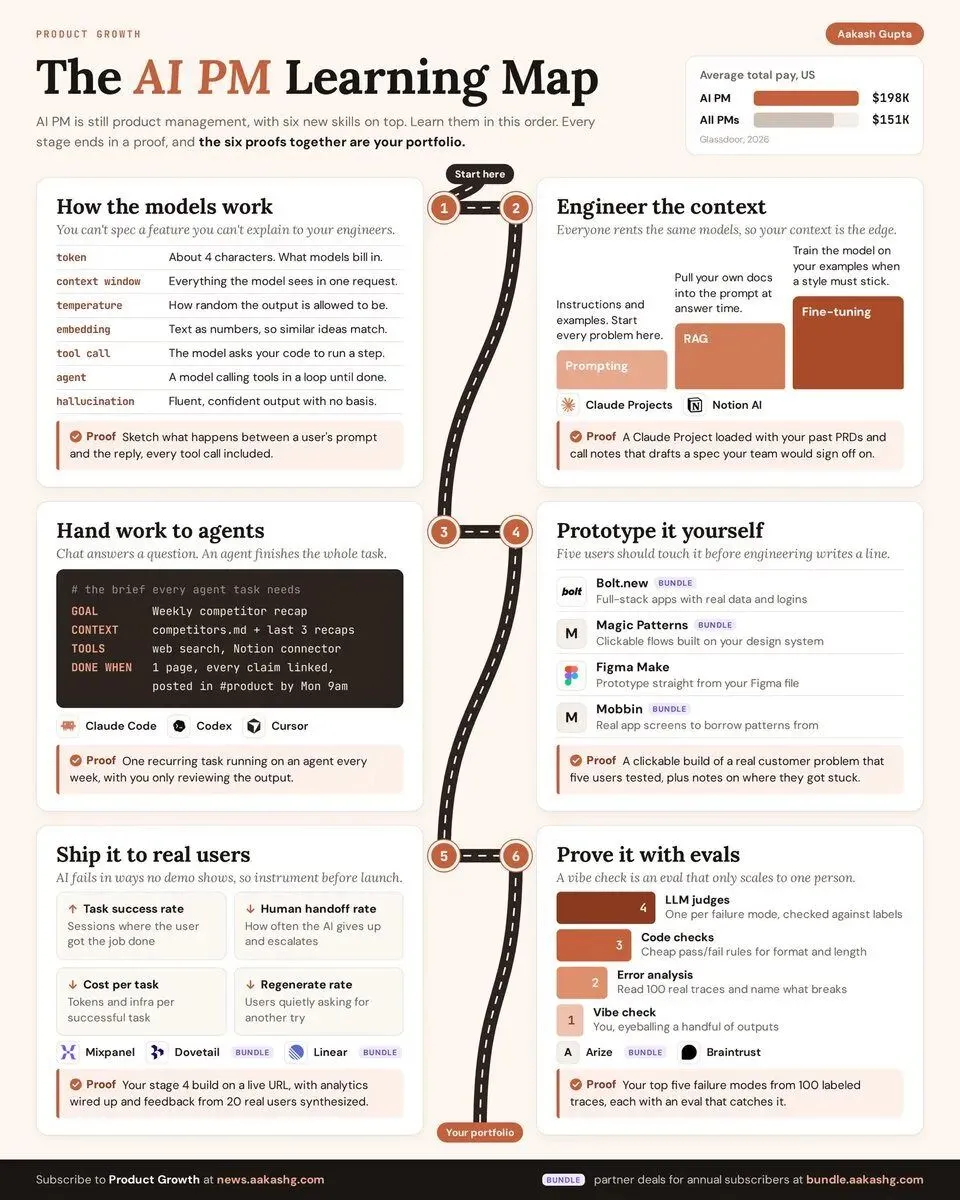
账号@aakashgupta发帖,列出AI产品经理六项可验证技能,评估能力排在最后也最关键
这对传统机构的工作方式是个实质冲击。过去上一套软件,需求文档写完、验收测试通过,系统行为是确定的;现在模型会以演示里看不到的方式出错,上线前要盯住任务成功率、人工接管率、单次成功任务成本、用户重新生成的频率。作者给出的评估方法也很具体:先读100条真实运行记录,命名失败模式,加上低成本的代码检查,再为每类失败构建一个模型裁判并与人工标注核对。这些工作不需要博士学位,但需要有人持续负责。
模型可以租,验收权不能外包
理解了这一点,再看机构层面的AI采购和管理,风险点就清楚了。大家调用的是同一批基础模型,真正拉开差距的是模型之外的部分。曾在谷歌做了十多年Chrome、现在参与Claude Code开发的Addy Osmani有句话被广泛传播:"不错的模型配上出色的框架,总能胜过出色的模型配上糟糕的框架。" 框架包括指令、上下文、权限、工具连接和上线前的检查——其中"检查"对应的正是内部评估能力。
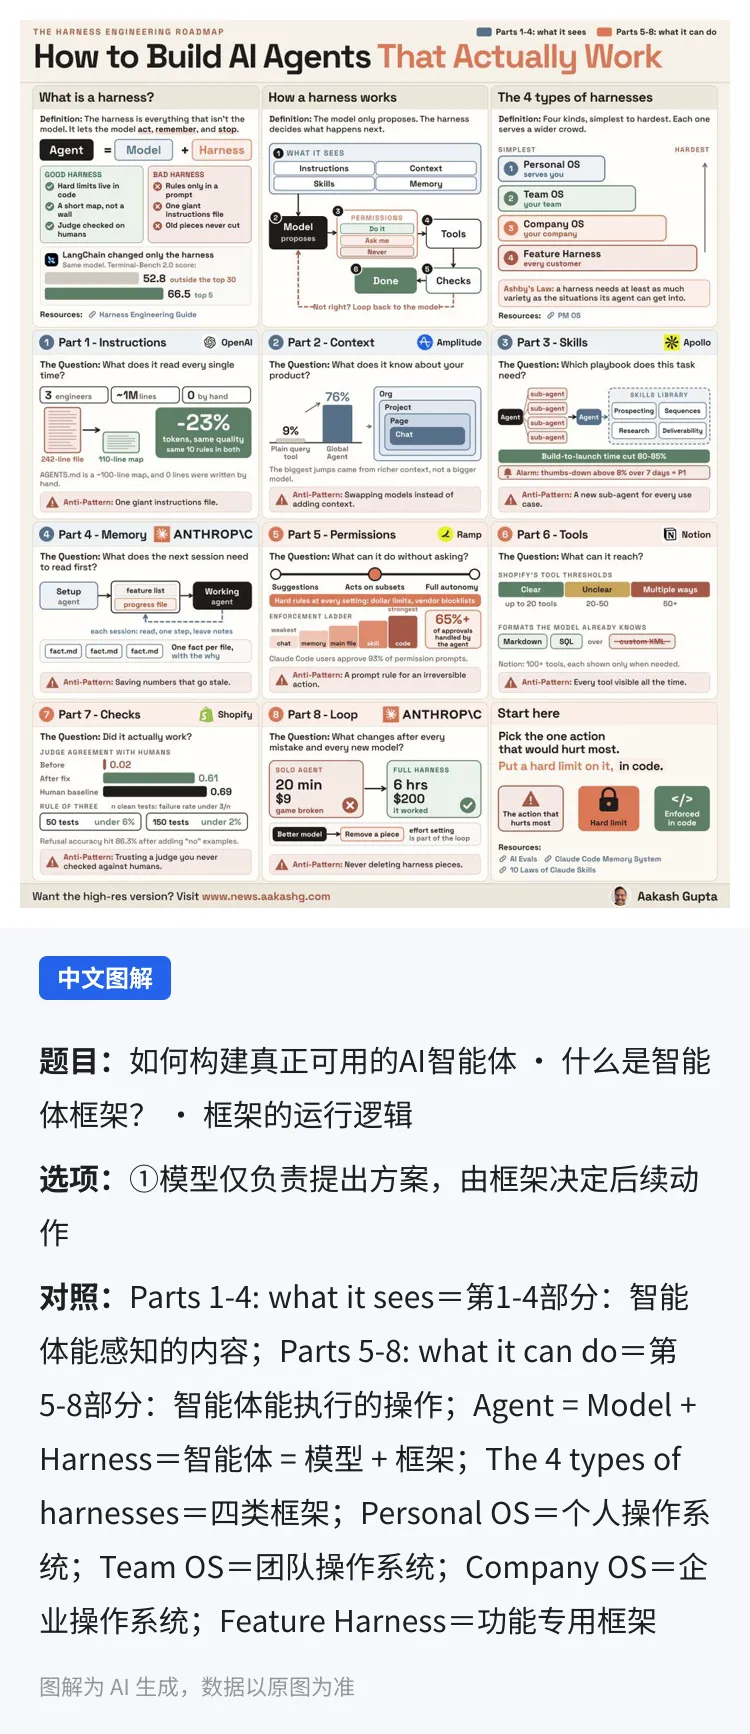
账号@aakashgupta发帖,引用从业者观点并拆解智能体框架的八个组成部分,校验是其中一环
与此同时,"独立评估"本身正在变成一门生意,机构需要警惕利益结构。Anthropic与埃森哲合作开展前沿AI的"嵌入式评估",海外一位企业架构师就公开质疑:当评估方同时承接实施、集成和培训业务,评估很容易变成包装更好的销售漏斗;他建议买家直接追问——谁付费、评估方能否公开批评供应商、能否建议干脆不要部署。
Anthropic自己的第三方评估者计划也被人分析过:第一层级评估者调查范围受限,且发布内容需经Anthropic批准;评估者的访问权限由实验室授予,也可能被收回。分析者的结论是,真正有效的约束最终需要政府或立法层面的不依赖企业授权的机构。对单一机构而言,这意味着外部评估可以参考,但内部必须有人看得懂评估结论、问得出尖锐问题。
这波薪资上涨,不只是换个头衔
也有人提出合理怀疑:562份占1177份的近一半,"AI产品经理"会不会只是旧岗位换个新标题、加了点薪水?
从证据看,头衔之下的工作内容确实变了。四类岗位的主要产出里都出现了评估、实验、行为规范这类新交付物;在12500份职位描述的另一项统计中,出现频率最高的技能是"为AI挑选正确的用例",排在RAG、智能体和提示工程之前。市场也没有为新手敞开大门:前述651个岗位中只有8个是入门级。美欧AI产品经理薪资溢价约15%至20%,印度达30%至50%,溢价买的是可验证的判断力,而非标签本身。
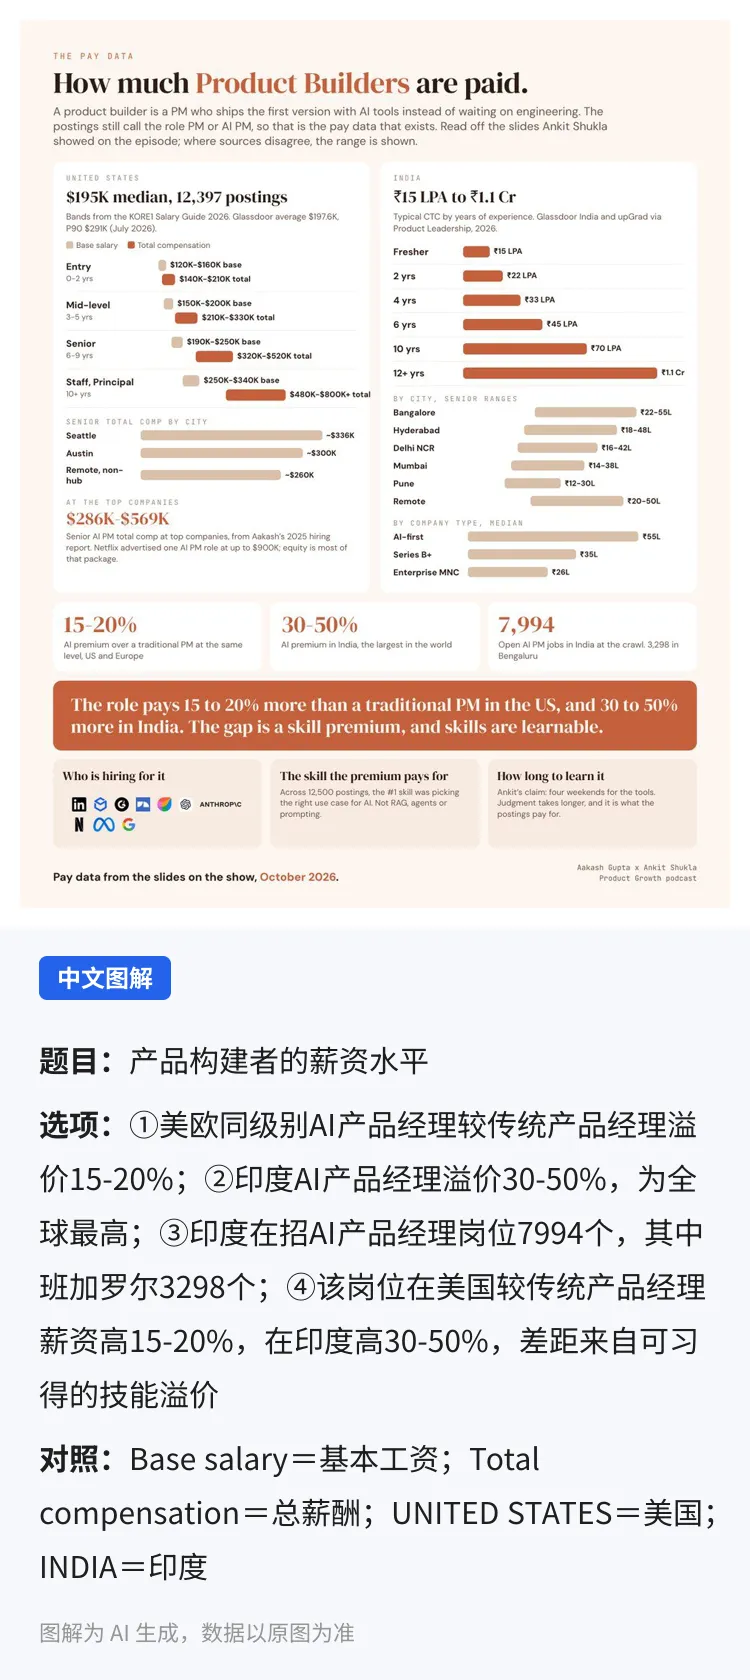
账号@aakashgupta发帖,引用招聘数据对比美国、印度AI产品经理薪资带宽与技能溢价
机构现在可以动手做的三件事
第一,把评估能力列为编制内能力,而不是采购条款。每个引入AI的核心业务,都应指定人对失败案例负责,积累本机构的提示词集和失败模式清单——20个边界清晰的案例就能起步。
第二,上线门槛用业务指标定义:任务成功率、人工接管率、单次成功成本、异常上报率,写进验收和续约文件;要求供应商提供离线评估与线上实验数据,并保留用自有案例复测的权利。
第三,保持评估的结构独立。参与选型、实施、评估的角色要分开;对咨询机构和供应商联合出具的"就绪报告",默认追问其商业关系。涉及公共服务、金融、医疗等高风险场景,还要关注监管侧正在形成的第三方评估制度安排。
薪资榜单会过时,但它标出的瓶颈不会很快消失:当系统自己都说不准每次会输出什么,能定义好坏、敢于按下暂停键的人,就是机构用AI时最该先配齐的人。