ARTICLE · 1225611
PDF 几十页不想读?让 AI 一页页啃、边啃边落盘
AI打工人日记 · VOL.12
一份三百页的手册,我让它“帮我总结一下”。开头五页讲得像模像样,翻到第四十页开始含糊,再往后它就开始编了——编得还挺像,可那句话原文里压根没有。
后来我把做法整个换掉:不让它一口气读完。让它一页一页啃,啃完一页,就把这一页值得留的东西写进本地文件;每啃二十页,回头做一次小结。同一份文档,答案开始能落到页码上了。
▲ 一页页啃,比一口气读完更靠得住
一、先别急着跑脚本:你的 PDF 到底该不该上这套
这套做法不是给所有 PDF 准备的。三五十页的东西,你自己拖进对话框问两句,比折腾脚本快得多。它真正管用的是那种翻不完的手册、论文合集、几十份摞在一起的材料。
先做两个判断:页数过不过百;是不是扫描件——扫描件本质是图片,文字层抽不出来,得先走一遍识别,这一步省不掉。
页数没过百、又不是扫描件,今晚就不用往下看了,直接喂给它问两句,比什么都快。
二、挑版本这一步,比跑脚本本身重要
这套脚本网上流传着四个版本,看着都差不多,真正的差别在它们默认把你的 PDF 发给谁——有三个版本默认走外部模型接口,也就是说,你这份材料会先出网,再回来。
要挑的是那个支持 --provider ollama 的版本:不依赖任何外部 key,模型跑在你自己的机器上。跑之前确认两件事:参数写的是 ollama,端口指向你本机(团队环境是 11435,你自己的以实际跑起来的为准)。
如果你要啃的材料里带人名、报价、薪资、还没对外公开的数字,这一步不是“建议”,是硬要求。
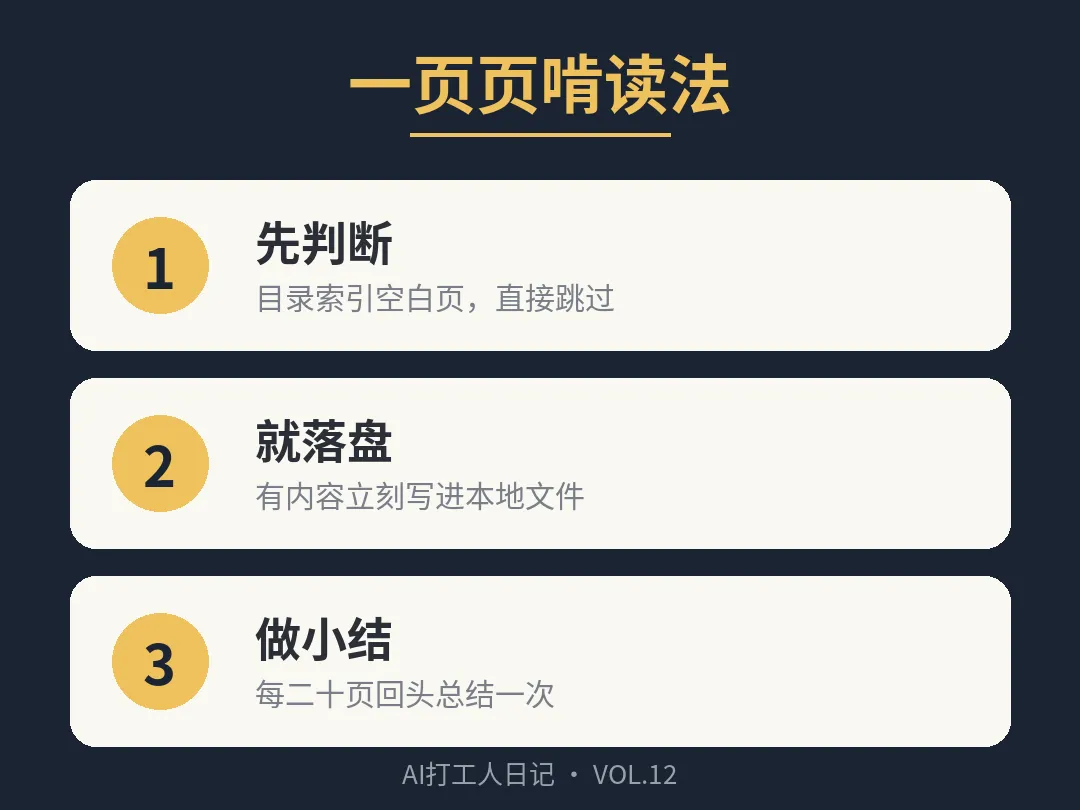
▲ 三步走完,长文档就有了一份能查的底稿
三、一页页啃:判断、落盘、阶段总结
流程就三步,笨,但稳。每翻一页先问一句“这页有没有值得留的”——目录、索引、版权页、空白页直接跳过;有内容的就抽成知识点,立刻追加写进本地文件。
重点在“立刻”:抽出来就落盘,别攒在对话里等最后一起倒。每啃二十页,让它回头做一次阶段总结,全书跑完再做一次总总结。中间那几次小结才是真正救命的——它把前面啃过的压成一小段,后面的页就不用再背着前面几百页跑了。
一次塞爆上下文,和分段落盘加阶段总结,差的不是速度,是它会不会翻到后面开始编。
四、这两个坑,跑之前先知道
第一个坑叫断点续读。有个版本的说明写着“中断了可以从上次继续”,实际上它每次启动都会把旧目录删掉重建——你以为续上了,其实是从头再来。
第二个坑更琐碎:PDF 的文件名在脚本里是写死的。你换了文件,它还在读上一个。跑第一次之前,先把这个位置改成你自己的文件名,或者干脆改成从命令行传进去。
今晚的最小动作:找一份你一直没读完的长 PDF,只跑六十页,然后打开那个本地文件,看看里面是不是真的躺着几十条能点回原文的记录。
下期预告 《劳动仲裁开庭,被问到的 12 个问题怎么答》——真坐到那个位置上,最卡人的往往不是道理,是那几句话该怎么说。
▲ 啃完落盘,才是真正带走的部分
你手上哪份长 PDF,是一直想读完、却始终没读完的?评论区讲讲。如果这篇有启发,点个「在看」,这是我更新的燃料。