ARTICLE · 1234745
4B 的小模型,把文档解析的天花板顶高了 12 分
LlamaIndex 发布 OCRia-1:一个 40 亿参数的视觉语言模型,在表格、图表、公式上全面反超一众大模型,单张 B200 每天能吞下约 86 万页。
如果问做文档 Agent 的人"最卡脖子的是哪一步",十个里有八个会说:读表。财报、保单、税表里的关键信息几乎都存在表格、图表和带格式的正文里,而一旦数字对错了列,下游 Agent 会给出一个自信但错误的答案。10 月 22 日,LlamaIndex 发布的 OCRia-1,正是对着这个痛点来的。
一、一句话概括这件事
一个 4B 模型,同时在"精度、成本、延迟"三条线上拿下第一
LlamaIndex 在官方博客里把话说得很满:OCRia-1 是"当今最好的文档解析模型"。它是一个 40 亿参数的视觉语言模型(VLM),由 Qwen3.5-4B 微调而来,输入一页文档图像,输出结构化的 Markdown 与 HTML。
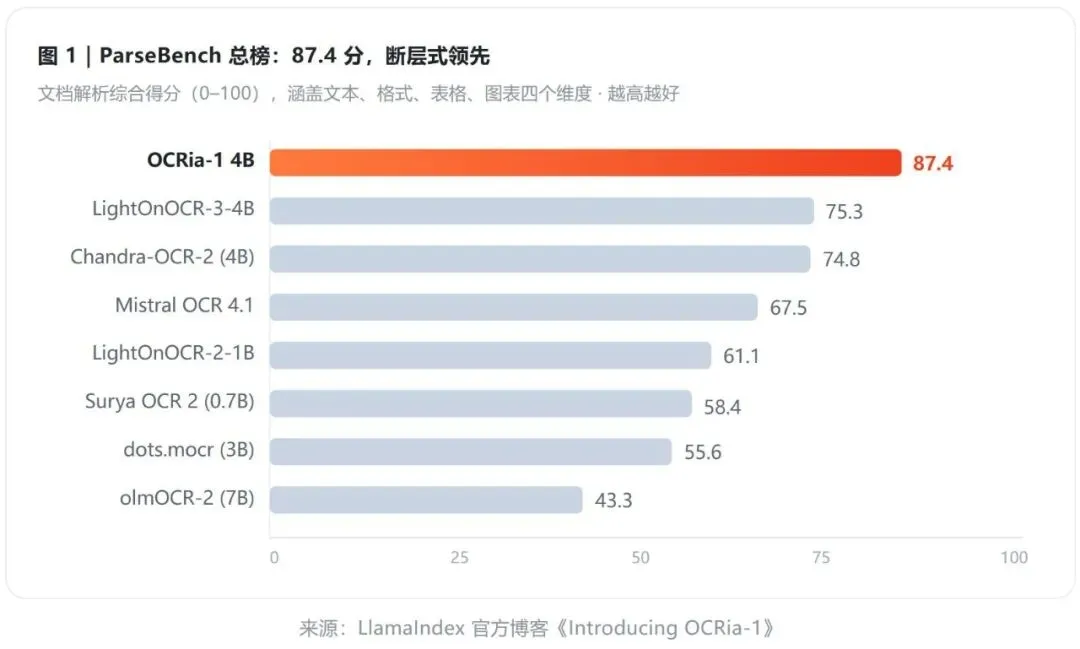
在自建基准 ParseBench 上,它拿到 87.4 的总分,高出第二名 LightOnOCR-3-4B(75.3)足足 12.1 分。同时,它在三个第三方基准的表格评测上也全部位列第一:olmOCR-bench(92.9)、PulseBench-Tab(84.1)、fr-bench-pdf2md。
更关键的是后半句——这些成绩是用一个 4B 模型拿到的。在"小模型能不能干专业活"这件事上,这是一次相当有力的实证。
二、先把话说清楚:领先幅度没那么均匀
12.1 分是"自建基准"上的领先,第三方基准上只有 0.7–1.7 分
这张图值得多看两眼。OCRia-1 在四个基准上都是第一,但领先的"形状"完全不同:
ParseBench(自建):87.4 vs 75.3,领先 12.1 分
olmOCR-bench(第三方):83.5 vs 82.3,领先 1.2 分
PulseBench-Tab(第三方):84.1 vs 82.4,领先 1.7 分
fr-bench-pdf2md(第三方):72.1 vs 71.4,领先 0.7 分
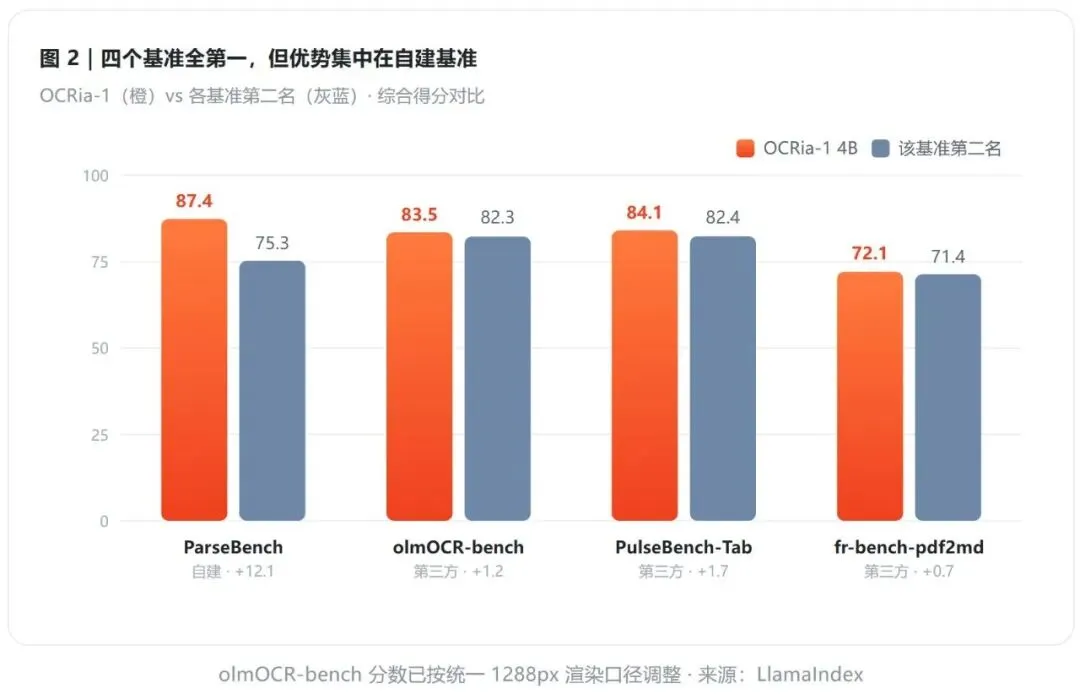
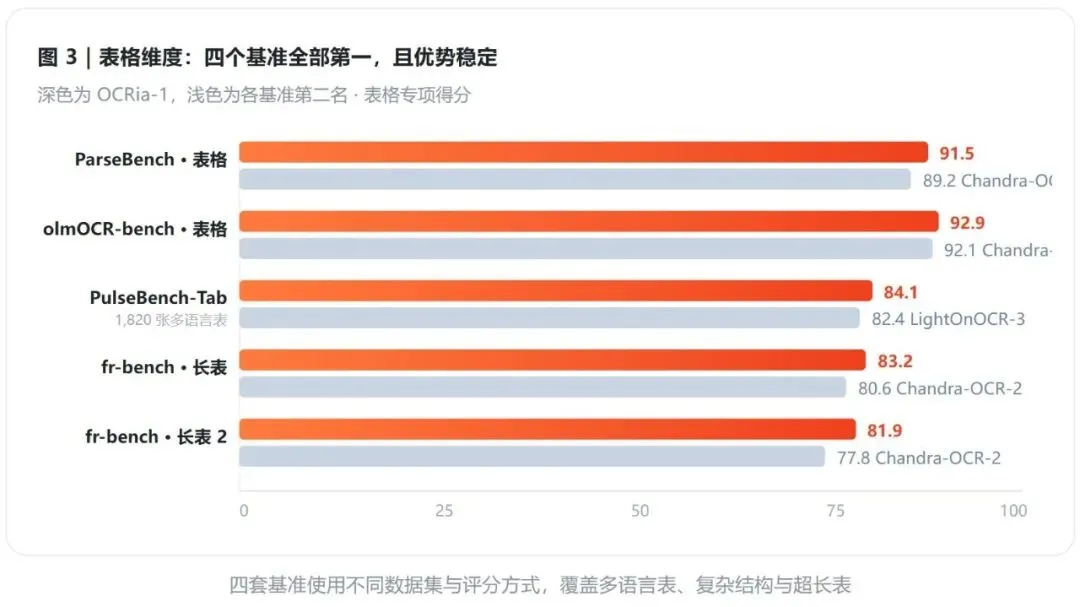
这个分布很重要:巨大的差距主要出现在 ParseBench 重点考察的"图表"和"格式"维度上(分别领先 19.0 分和 15.5 分)。而在纯表格维度上,OCRia-1 的领先是小幅度、但高度一致的——四个基准全部第一,且稳定领先 0.8–3.3 分。
三、真正的杀手锏:把"烂表"还原成表
嵌套表头、合并单元格、不规则网格——这些才是企业级文档的常态
为什么 LlamaIndex 会把表格当成主攻方向?官方的说法很实在:"丢失这些关系,会让一份准确的转录变成一次错误的财务对比,或一条被误读的保额上限。"
现实中的财报表格长这样——三层嵌套表头、跨列合并的单元格、中间还夹着小计行。多数解析器能"把字认出来",但认不出字属于哪一列。OCRia-1 的做法是:把页面渲染成 Markdown,表格部分则输出保留合并单元格与嵌套表头结构的 HTML。
谁最该关心这一项
金融服务与保险。财报、承保明细、赔付限额表几乎都是不规则表格。一个数字被放到错误的列头下,RAG 检索出来的上下文就是错的,最终答案会错得非常"自信"。
四、从"看懂图"到"取到数":图表转数据表
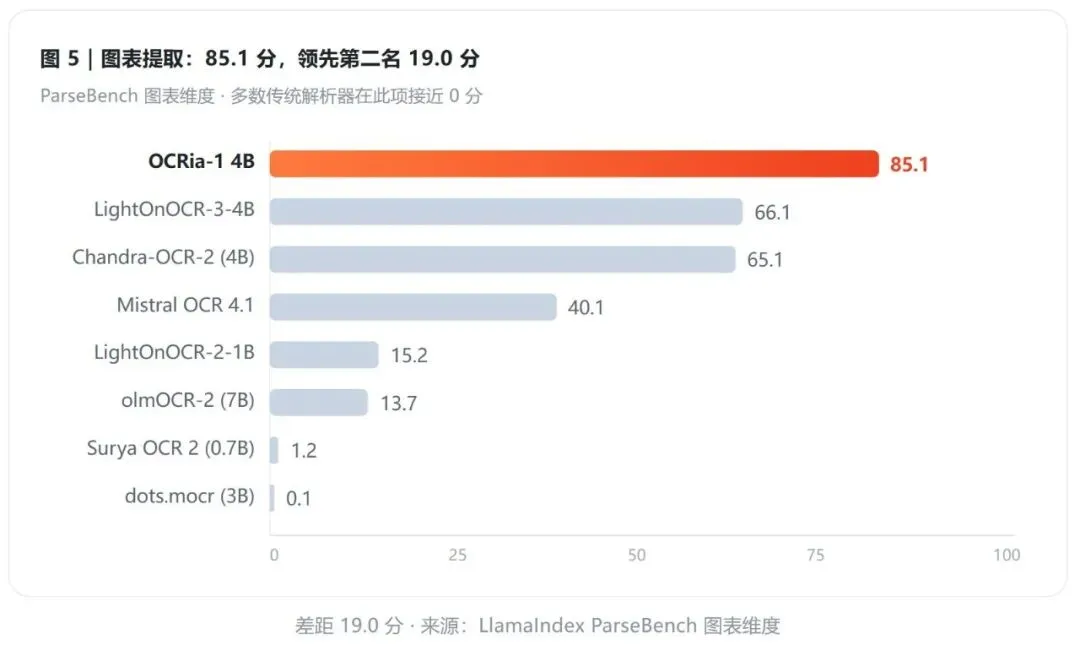
这是差距最悬殊的一项——第二名 66.1,多数模型接近 0
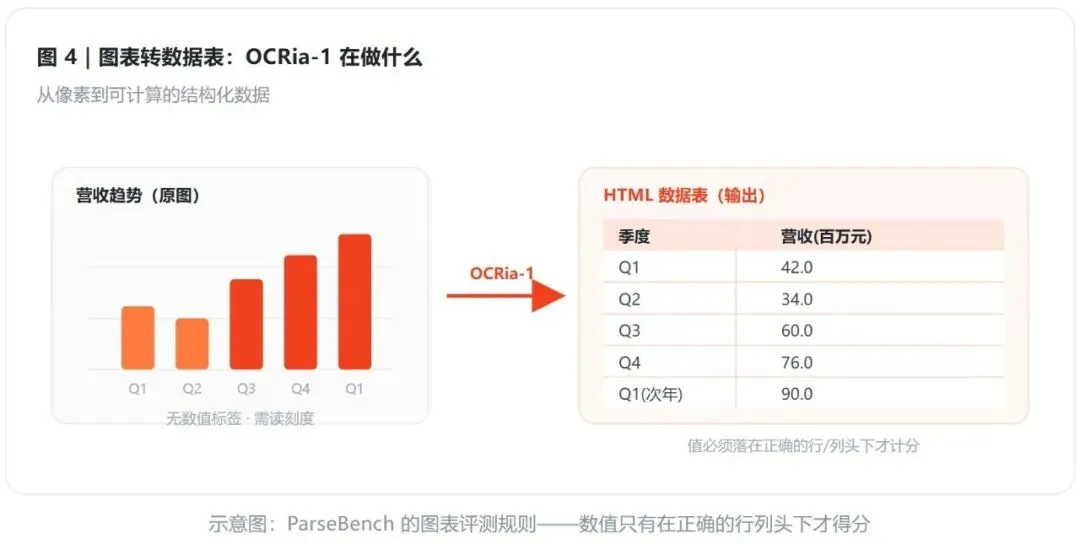
如果说表格是"难",那图表对绝大多数解析器来说就是"做不到"。堆叠柱状图、多轴折线、没有数值标签的数据点——需要读刻度、区分数列、把每个值匹配到正确的标签。
官方博客里那句话戳中了要害:"『各业务线营收均有增长』这样的总结不足以支撑计算,你需要的是真实的数字。"OCRia-1 会把图表转成对应数据点的 HTML 表格。
五、被低估的一项:格式与公式
上标、下标、删除线、勾选框……多数解析器会直接丢掉
这一项平时没人提,但真的用起来会要命。化学式 H2O 里的下标、合同里被划掉的原条款、表单里的勾选框——这些信息的丢失不是"排版不好看",而是"语义错了"。
OCRia-1 会把这些标记保留在 Markdown/HTML 中,并把数学公式转录为 LaTeX 而不是纯文本。在 ParseBench 的格式维度上,它拿到 83.4,第二名 Surya OCR 2 是 67.9,领先 15.5 分。
顺带一提,7B 的 olmOCR-2 在这一项上只有 2.2 分——这更能说明这个维度有多"偏门",也说明 LlamaIndex 是有意识地在补这块短板。
六、怎么炼成的:10 万+页数据 + SFT + RLVR
官方把功劳明确归给了数据与训练管线
模型结构没什么神秘的——Qwen3.5-4B 微调。真正的护城河在数据:
10 万+页训练集,专门挑现代 VLM 仍然会做错的场景:跨页的密集表格与图表、数学符号、多语言文本、糟糕的扫描件。
混合标注流水线:用生成式与评审式 VLM 自举出 ground-truth,再叠加人工标注;真实数据会与 PDF 文本层做交叉校验。
合成文档生成器:补齐真实数据覆盖不到的长尾分布,可以精确控制复杂度——尤其是超长表和重格式场景。
两阶段训练:SFT 打底建立基础解析能力,再用可验证奖励的强化学习(RLVR),为表格、图表、格式分别设计奖励函数,提升泛化能力。
这套"用合成数据补长尾 + RLVR 分别优化子能力"的组合,正是小模型能在垂直任务上反超通用大模型的典型路径。
七、速度:单卡日吞 86 万页,是怎么做到的
不是模型变小了,而是推理栈被重写了
精度之外,OCRia-1 的另一半故事是吞吐。官方给出的数字是:单请求在单张 NVIDIA B200 上解码约 4700 token/s,约为基座模型跑原生 vLLM 的 9 倍;64 并发下约每秒解析 10 页,折算下来单卡每天约 86 万页。
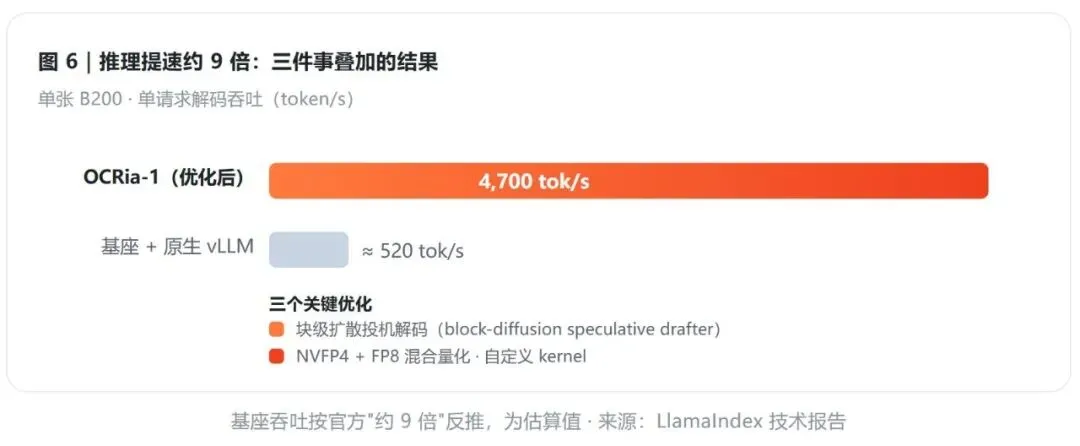
86 万页/天/卡这个量级意味着什么?一家中型券商的研报库、一家保险公司的历史保单档案,量级大致在百万到千万页。过去"把整个历史档案重解析一遍"是一个需要立项的工程项目,现在它变成了一笔可以随手批的算力账单。
八、成本:价格没变,能力升级
LlamaParse 原价切换,官方称每页不到半美分
对现有用户来说,这次更新最直接的好处是:OCRia-1 已经在 LlamaParse 上线,且价格与之前相同。LlamaIndex 官网给出的说法是"每页不到半美分"。
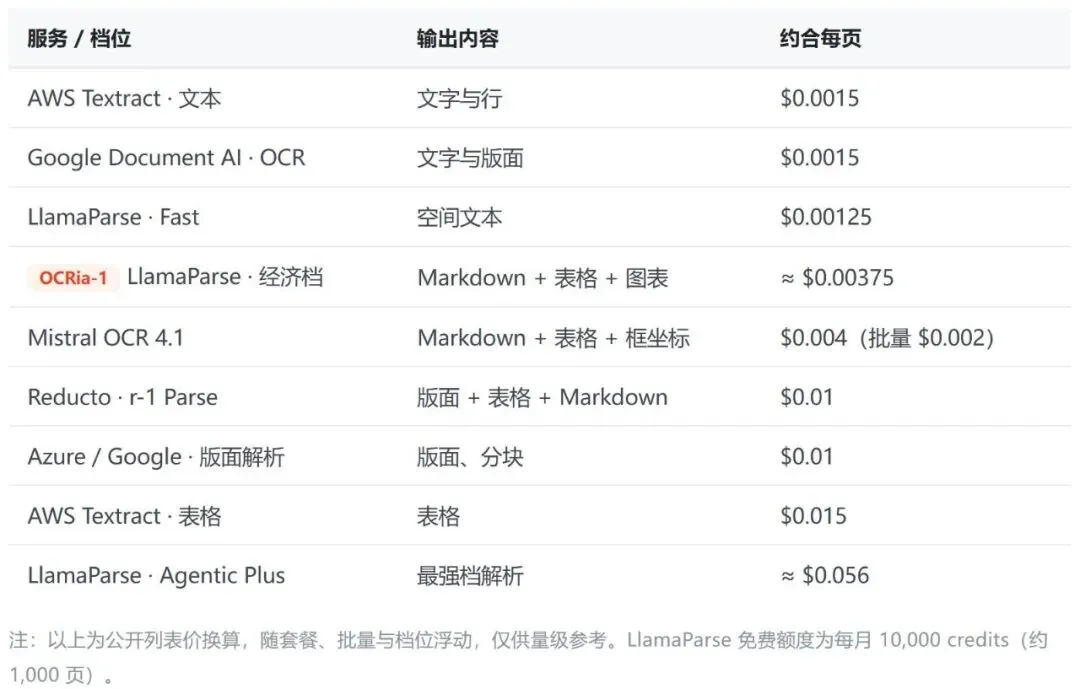
把这张表和前面的分数放在一起看,结论就很清楚了:OCRia-1 是在"$4/千页"这个区间里,提供了过去要"$10–15/千页"才能买到的表格与图表能力。
九、冷静一下:三个需要打折的地方
好消息值得关注,但证据强度要分层看
阅读这份成绩单时,请记住三点
1. ParseBench 是 LlamaIndex 自己造的尺子。该基准于 2026 年 4 月发布,约 2,000 页人工核验的企业文档、16.7 万条测试规则,覆盖表格、图表、内容保真、语义格式、视觉定位五个维度——设计得确实专业。但厂商在自己造的基准上拿第一,证据强度天然要打折。12.1 分这个数字,建议当作"上限预期"而非"确定差距"。
2. 第三方基准上的领先其实很窄。olmOCR-bench 领先 1.2 分、fr-bench 领先 0.7 分——都在误差范围内。真正稳健的结论不是"断层领先",而是"四个基准一致第一"。这仍然很强,但不是碾压。
3. 对比集里缺少前沿通用 VLM。公布的结果主要对标专业/开源解析器(LightOn、Chandra、dots.mocr、olmOCR)与 Mistral OCR,没有看到 GPT / Gemini / Claude 级别的通用多模态模型在同批页面上的成绩。权重也尚未开放——目前只能通过 LlamaIndex 托管服务使用,官方仅表示"即将提供",未给出日期与许可证。
那到底该怎么验证?
别信任何一家的基准,拿你自己的文档跑:你最烂的那批扫描件、你特有的表格版式、你业务里的语言。抽样 200 页,人工核对关键字段,比较的是"每个正确字段的成本",而不是列表价。
过去两年,文档解析的叙事一直是"用更大的模型去读更难的文档"。OCRia-1 提供的是另一条路的证据:把问题拆细、把数据做对、把奖励函数设计好,4B 也能在专业能力上超过大模型——而且快 9 倍、便宜一个数量级。
对做文档 Agent 的人来说,这件事的意义不在分数,而在于:表格和图表这个长期卡住流水线的瓶颈,落地门槛被实实在在地压低了一截。
相关链接:https://www.llamaindex.ai/blog/parse-ocria-1