ARTICLE · 1357240
FUXA 源码解读 ⑦|历史数据 DAQ
01
一句话结论
FUXA 的历史数据不是「定时采样」,而是设备轮询里被判定为需要保存的标签值,按设备分库追加进 SQLite;读的时候再按时间范围,把当前卷与归档卷拼回来,并套上三层分片(客户端 12 小时、REST 6 小时、socket 6 小时)。
02
入口与调用链
写侧的开关在设备启动时打开:devices/index.js:194-197 判断 settings.daqEnabled,为每个设备调 runtime.daqStorage.addDaqNode(device.id, getTagProperty),拿到返回函数后 activeDevices[id].bindSaveDaqValue(fnc)。驱动层只管在每次轮询结束时调用 this.addDaq(varsValueChanged, data.name, data.id),例如 Modbus 在 modbus/index.js:177-179、HTTP 请求驱动在 httprequest/index.js:95-97,前提都是 varsValueChanged 非空。
daqstorage.addDaqNode(daqstorage.js:43-68)按后端类型选实现:InfluxDB/18、TDengine、QuestDB 共用一个节点(id = dbType),其余落到 SqliteDB.create(settings, logger, id, ...),所以 SQLite 是一设备一节点。SqliteDB.setCall(sqlite/index.js:104-107)返回 addDaqValues,这就是驱动层拿到的 this.addDaq。
读侧有两条通道:
socket:DAQ_QUERY(runtime/index.js:285-328),脚本 $getHistoricalTags(script.service.ts:269-272)和图表控件的 onTimeRange(gauges.component.ts:874-876)走这条; REST:GET /api/daq?query={sids,from,to}(api/daq/index.js:36-108),uPlot 曲线自己分片后走这条(chart-uplot.component.ts:172-189)。
两条最后都落到 daqstorage.getNodeValues(daqstorage.js:70-79):先按 tag id 找到设备节点,找到就委托 daqnode.getDaqValue(tagid, from, to),找不到直接 resolve 空数组。
前端组装在 GaugesManager 的 onDaqResult 订阅里(gauges.component.ts:97-110):按 gid 找到图表或表格控件,交给 ChartUplotComponent.setValues(result, chunk)(chart-uplot.component.ts:437+)。
03
核心数据结构
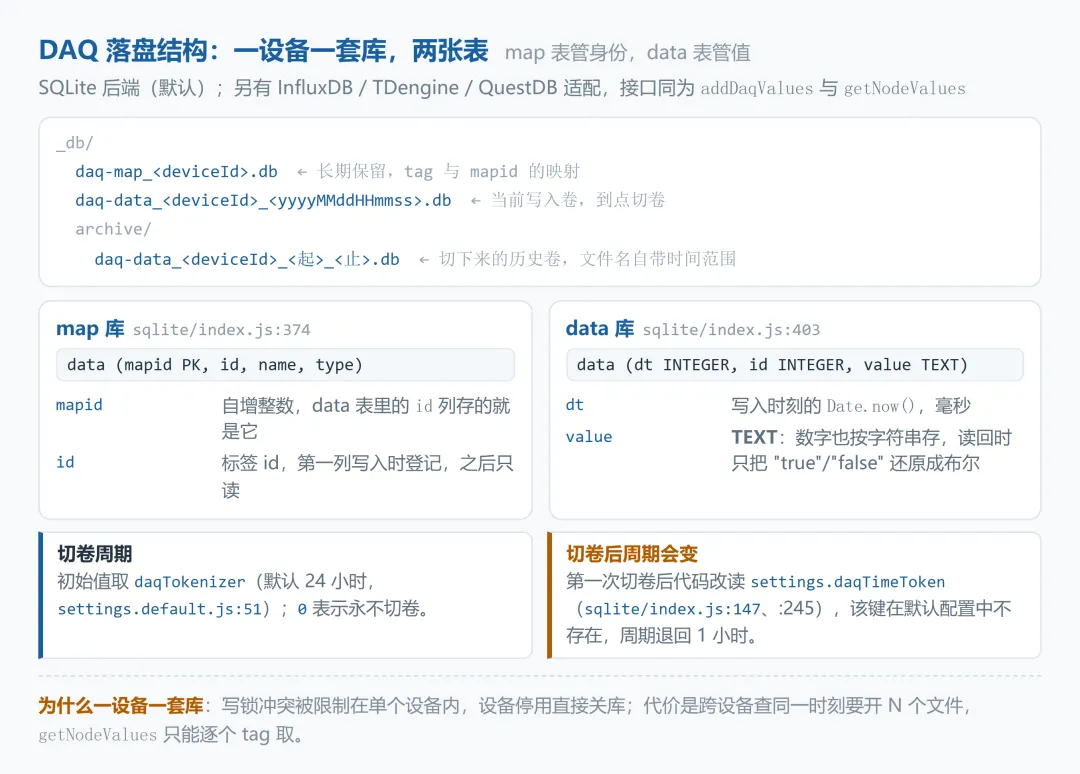
落盘结构
▲ 一个设备一套库:map 表只登记标签身份,data 表只追加值与毫秒时间戳。
DaqNode 是一个闭包工厂(sqlite/index.js:20-645),状态都藏在闭包里:daqTagsMap(tagid → {mapid, name})、daqNextToken(下一个切卷时刻)、db_daqmap / db_daqdata、mapworking、dataworking、initready。
两张表:
- daq-map_<deviceId>.db
里的 data (mapid INTEGER PRIMARY KEY AUTOINCREMENT, id TEXT, name TEXT, type TEXT)(:374); - daq-data_<deviceId>_<yyyyMMddHHmmss>.db
里的 data (dt INTEGER, id INTEGER, value TEXT)(:403)。
value 是 TEXT,数字也按字符串落盘;读回时只把 "true"/"false" 还原成布尔(:605-614),其余保持字符串。dt 是写入那一刻的 Date.now()(:623),毫秒级,不是文件头注释里写的「秒级分辨率」(:6,注释已过时)。
保存判定在 device-utils.js:9-20 的 tagDaqToSave:
- tag.daq.enabled || tag.daq.restored
才进入候选; - tag.changed && (daq.changed || daq.restored)
—— 变化即存; 否则看 daq.interval:距上次保存超过该秒数才存; - daq.lastDaqSaved
为空(首次)也存。
所以「按变化」和「按周期」是并存的,由标签自己的 daq.changed / daq.interval 两个开关决定;两个都没配、值又不变,就只在第一次落一个点。daq.restored 还会把最新值写进 currentStorage(sqlite/index.js:194-196、:270-272),供服务重启后恢复当前值。
后端抽象只有三个动作:setCall(fncGetTagProp) 交出 addDaqValues、getDaqValue(tagid, from, to) 返回 [{dt, value}]、getDaqMap() 返回映射表。daqstorage 里 _getDaqNode(tagid) 靠 map 反查设备,所以 InfluxDB/TDengine/QuestDB 三种共享节点也能用同一套调用;差异被压在各自目录里。SQLite 这一支另有一个隐式约定:map 文件是身份源,daq-data_* 丢了不影响,反过来 map 丢了、data 还在,启动时会直接删掉 data 库(:53-58),等于历史全清——迁移或备份时两个文件必须一起带走。
04
关键流程
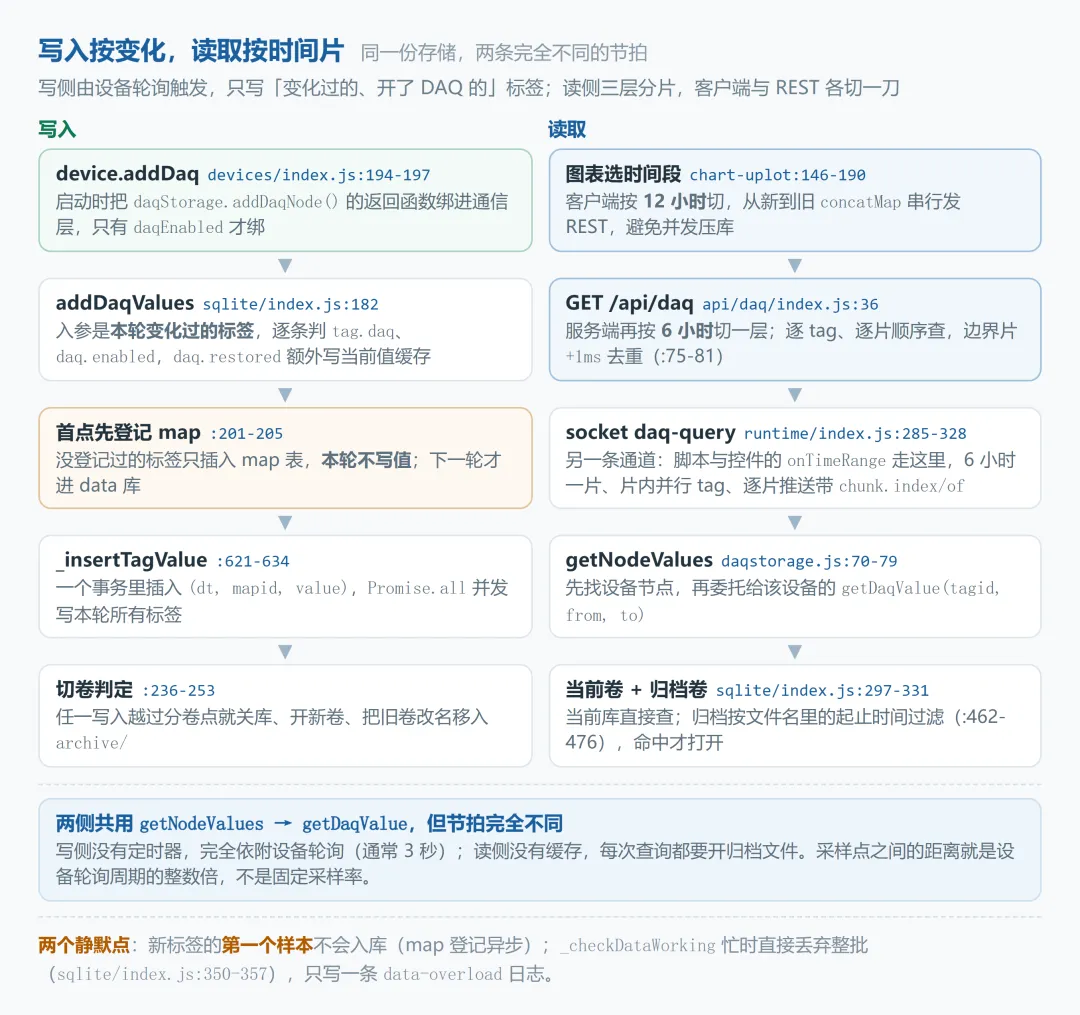
写入与读取
▲ 写侧没有定时器,完全跟着设备轮询走;读侧每次都开文件,没有查询缓存。
1. 一批写入。addDaqValues(tags, deviceName, deviceId)(sqlite/index.js:182-285)先遍历本轮变化的标签:没有 tag.daq 或 enabled=false 的跳过,restored 的塞进 dataToRestore。已在 daqTagsMap 里的标签,构造 _insertTagValue(mapid, value) 放进 addDaqfnc;没登记过的,构造 _insertTagToMap(...) 放进 addMapfnc。
注意这里有个首点丢弃:新标签本轮只登记 map,不入 data 库(:201-205)。下一轮它进了 daqTagsMap,值才开始落盘。现象是「刚勾上 DAQ 的那一秒没有点」,曲线起始处会空一拍。
2. 并发与背压。addMapfnc、addDaqfnc 各自 Promise.all 并发执行(:211-233)。真正写库前要过 _checkDataWorking(true)(:232、:350-357):如果上一批还没写完,直接返回 false,整批丢弃,日志里只有一条 daqstorage.data-overload。这是有意的背压——宁可丢点也不让 SQLite 队列无限堆积。
3. 切卷与归档。 每批写完后拿返回的 lastts 和 daqNextToken 比(:236):超过就关当前库、用新时间戳建新卷、把旧卷改名移进 archive/,文件名变成 daq-data_<id>_<起>_<止>.db(_archiveDBfile,:478-491)。启动时还会扫一遍 dbDir 里残留的 daq-data_* 文件,逐个补做归档(_checkToArchiveDBfile,:425-460);空库直接删掉。
4. 读一个标签。getDaqValue(:297-331)先在当前卷查 SELECT dt, value FROM data WHERE id=? AND dt BETWEEN ? AND ? ORDER BY dt ASC(:606),再枚举 archive/,用文件名里的起止时间和查询区间求交(_getArchiveFiles,:462-476),命中的文件逐个 _bindAndGetTagValues 打开、查、关(:587-601)。结果按归档顺序拼在前、当前卷拼在后,整体时间升序。
5. 服务端分片。 socket 通道固定 6 小时一片(runtime/index.js:288),最多 744 片(186 天),超限直接回 DAQ_ERROR;逐片 await,片内对多个 tag 并行(:301-315),每片推一次带 chunk.index/of 的结果。REST 通道同样 6 小时(api/daq/index.js:9),但遍历顺序是「先 tag 后片」,且片间边界 +1ms 防重复(:71-82);单次最多 100 个 tag(:40-46),支持 from === to 取当前值。
6. 实时段与历史段来自两个源头。 曲线打开时先拉一段历史,之后追加的点不走 DAQ,而是由 onVariableChanged → addValue(id, x, y) 直接推给 uPlot(chart-uplot.component.ts:413-431),还带 addValueInterval 节流。也就是说同一根曲线上,历史段的点距由 daq.changed/interval 决定,实时段的点距由设备广播节流决定,缩放回去时可能对不齐。
7. 前端拼图。 uPlot 控件把时间范围按 12 小时从新到旧切(chart-uplot.component.ts:165-204),用 concatMap 串行请求,避免同时开一堆归档库。setValues 用 chunk.index === 1 判断新一轮、chunkBuffer 缓存乱序到达的片、processedChunks 去重(:433-435、:470-480),最后统一喂给 uPlot。
05
设计取舍与坑
1. 变化触发,天生不是等间隔时序。 曲线上的点距等于设备轮询周期的整数倍,停机时是一条空窗,不是补零。做统计分析(如班产量、均值)时必须自己按时间加权或插值,不能直接拿点数除以时长。
2. 数字回读是字符串。value 列 TEXT,_getTagValues 只处理布尔映射(:605-614),{"dt": 1, "value": "82.5"} 里的 "82.5" 仍是字符串。前端 uPlot 能容忍,脚本里直接做算术会得到字符串拼接。
3. 切卷周期的配置项拼错了。 初始 daqNextToken 用 settings.daqTokenizer(:34,默认 24 小时,settings.default.js:51);第一次切卷之后改读 settings.daqTimeToken(:147、:245),而默认配置里没有这个键。结果是:首卷 24 小时后,后续每 1 小时切一卷。副作用不只是文件变多——归档检索要遍历的目录项、以及按文件名过滤的开销都随之上升。此条记为 D-10。
4. 首点必丢。 见上文第 1 步:标签第一次判定要保存时,只登记 map,不写值。对只变化一次的开关量,等于这个点永远不在历史里。
5. 忙时整批丢点且只留日志。_checkDataWorking 是布尔闸门(:350-357),没有队列;慢盘、批量导入、SQLite 锁竞争时都会触发 data-overload。丢的是哪一批、丢了多少,日志里只有一行警告,没有计数。现场表现是「历史曲线偶尔缺一段」,和通讯中断很难区分。
6. 名为并行、实为串行。daqstorage.getNodesValues 在循环里 dbfncs.push(await getNodeValues(...)),随后又 Promise.all(dbfncs)(daqstorage.js:91-98)——每个都已经 await 完了,Promise.all 只是把现成的值包一层。跨设备批量查询的实际耗时随标签数线性增长;同一个文件里 getDaqValue 的归档查询(:305-309)则是真并行。两处写法并存,读代码时容易误判性能特征。另有一层放大:_getDaqNode 对每个 sid、每一片都线性遍历全部设备节点(:159-166),186 天查询 = 744 片 × tag 数 × 设备数。
7. 保留策略按「卷」删,不按「点」删。checkRetention(:650-672)只判断文件名里的起始时间 fromTo.from < dtlimit,命中就整卷 unlink。如果一卷跨越了保留边界(切卷周期被改大、或服务停了很久后重启),窗口内的点会跟着整卷一起消失。默认配置下这套逻辑根本不执行:daqstorage.checkRetention 要求 settings.daqstore.retention 不是 'none'(daqstorage.js:137),而 settings.default.js 里没有 daqstore 段。文件名与查询边界都按本机时区生成和解析(_getDateTimeSuffix,sqlite/index.js:493-503;_suffixToTimestamp,:674-692),服务器换时区或跨时区部署时,归档筛选会整体偏几个小时。
8. 查询上限是硬约束。 socket 与 REST 都限 186 天、REST 限 100 个 tag,超限直接 400/DAQ_ERROR,没有降采样或服务端聚合。长时间跨度的高频标签只能在客户端自己抽稀。
06
小结 + 下一篇
DAQ 这层的核心就三条:写侧挂在设备轮询上、按标签的 daq.changed/interval 决定要不要落点;存储按设备分库、按时间切卷、value 一律 TEXT;读侧没有缓存,靠文件名筛归档再逐卷打开。 需要记住的边界:首点不入库、忙时丢批、切卷周期在第一次之后退回 1 小时、保留策略整卷删除。
如果要给这层加能力,改动点集中在三处且不动对外接口:给 addDaqValues 加一个有界写队列替代直接丢批;把切卷的两个配置键统一成 daqTokenizer;在 _getDaqNode 前面加一层 tagid→节点缓存,避免每个片、每个 tag 都遍历全部设备。三处都不改变 addDaqValues / getDaqValue 的签名,前端与脚本无感。
下一篇进入脚本与调度:脚本在哪里执行、setInterval 类任务怎样持久化、设备读写与报警动作如何从脚本反过来调用运行时。