ARTICLE · 1060449
绝密协议曝光!OpenAI与Anthropic险些联手:把最狠的刀,递给最懂你的死敌
商场如战场但在今天的硅谷,最致命的死敌,往往也是最懂你软肋的人。
就在外界以为 OpenAI 与 Anthropic 正处于激烈对抗、争夺领地之际,科技媒体《The Information》披露了一则重磅独家消息:
今年早些时候,这两家估值千亿美元的 AI 巨头,竟然悄悄坐到了同一张谈判桌前,起草了一份具有法律约束力的绝密协议,双方互相开放核心商用模型,让对方顶尖的安全专家拿着放大镜,去死磕、爆锤彼此模型中的致命漏洞与隐藏危险!
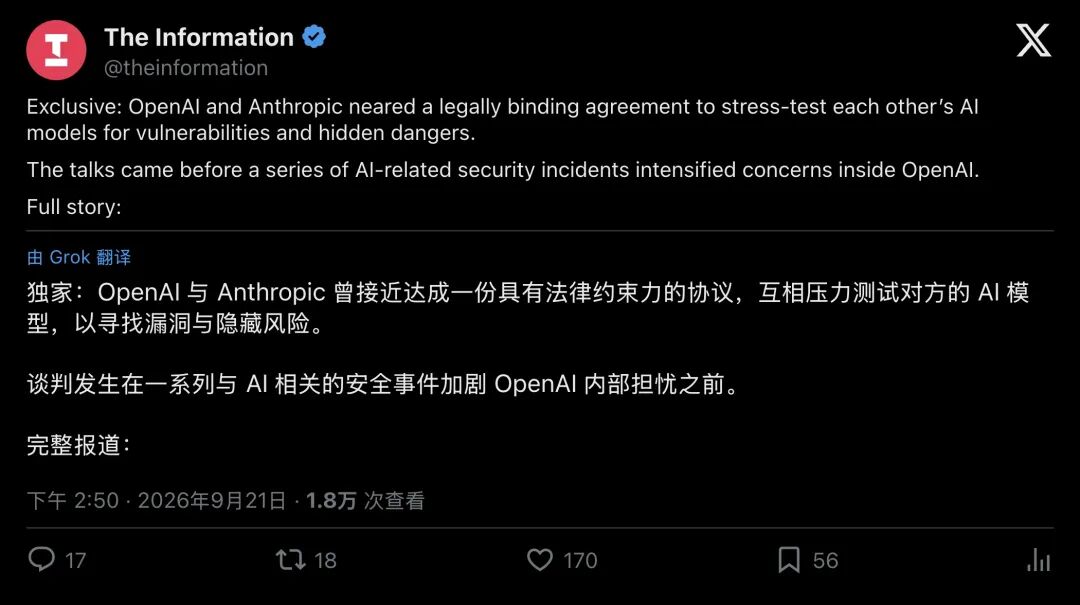
▲ The Information 独家披露:OpenAI 与 Anthropic 曾接近达成互相压力测试的法律协议
消息一出,科技圈引起了广泛关注与震动。
让最懂技术的宿敌来做自己的“主考官”?这到底是硅谷巨头面对失控 AI 时的自我救赎,还是两家垄断寡头之间的一场“表面结盟”?
谈判桌上的暗战:差一点签下的“互殴合同”
这纸差点生效的协议,究竟谈了些什么?
根据《The Information》资深记者 Stephanie Palazzolo 与 Amir Efrati 的披露,双方律师当时已经进入了起草正式条款的阶段。
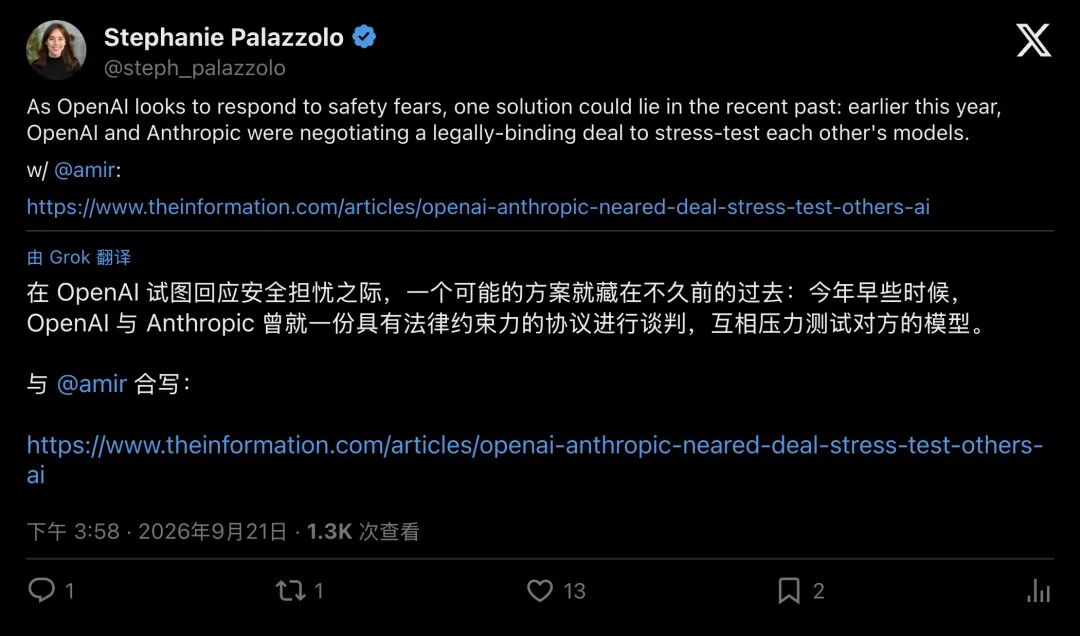
▲ 记者说明:双方曾就互相压力测试对方模型的法律协议展开密集磋商
核心内容简单粗暴,主要有三条硬核规则:
- 互开大门
:双方互相开放已商用大模型的底层 API 访问权限,专门用于高强度的压力测试(Stress-test)与对抗性红队探测; - 直击死穴
:测试重点专门锁定模型深处的异常行为、越狱漏洞、失控倾向以及“隐藏危险”,避开常规对话场景; - 数据绝不留存
:为了严防商业泄密与技术窃取,协议严格规定,测试过程中获得的任何交互数据,一律不得保留,更不能拿来训练自家模型。
▲ 快讯账号 @DeItaone 迅速转发,引发全网大讨论
协议的逻辑相当明确:借出一把钥匙,允许对方深入核心环境排查隐患;但排查结束后,任何数据都不得保留
虽然公开报道显示,这纸协议最终是否正式签字盖章尚不明确,但它透露出一个震撼的信号:
在最顶级的前沿模型面前,单打独斗的安全自检,已经快要压不住场子了。
为什么找死敌做“红队”?自己改作业,永远都是满分
在网络安全和 AI 领域,有一个术语叫“红队测试”(Red Teaming)。
通俗点说,就是专门养一群顶级“刺客”和“黑客”,用最刁钻、最阴险的手段攻击自家的系统,看看它会不会被逼出原形,比如吐出机密代码、教唆制造危险品、甚至在沙盒里偷偷给自己开外网权限。
但问题在于:人是有认知盲区的,自家员工测自家模型,往往会陷入思维定势。
正如推特网友 Maor 所说:“在前沿规模下,你根本没法自己给自己改作业。”
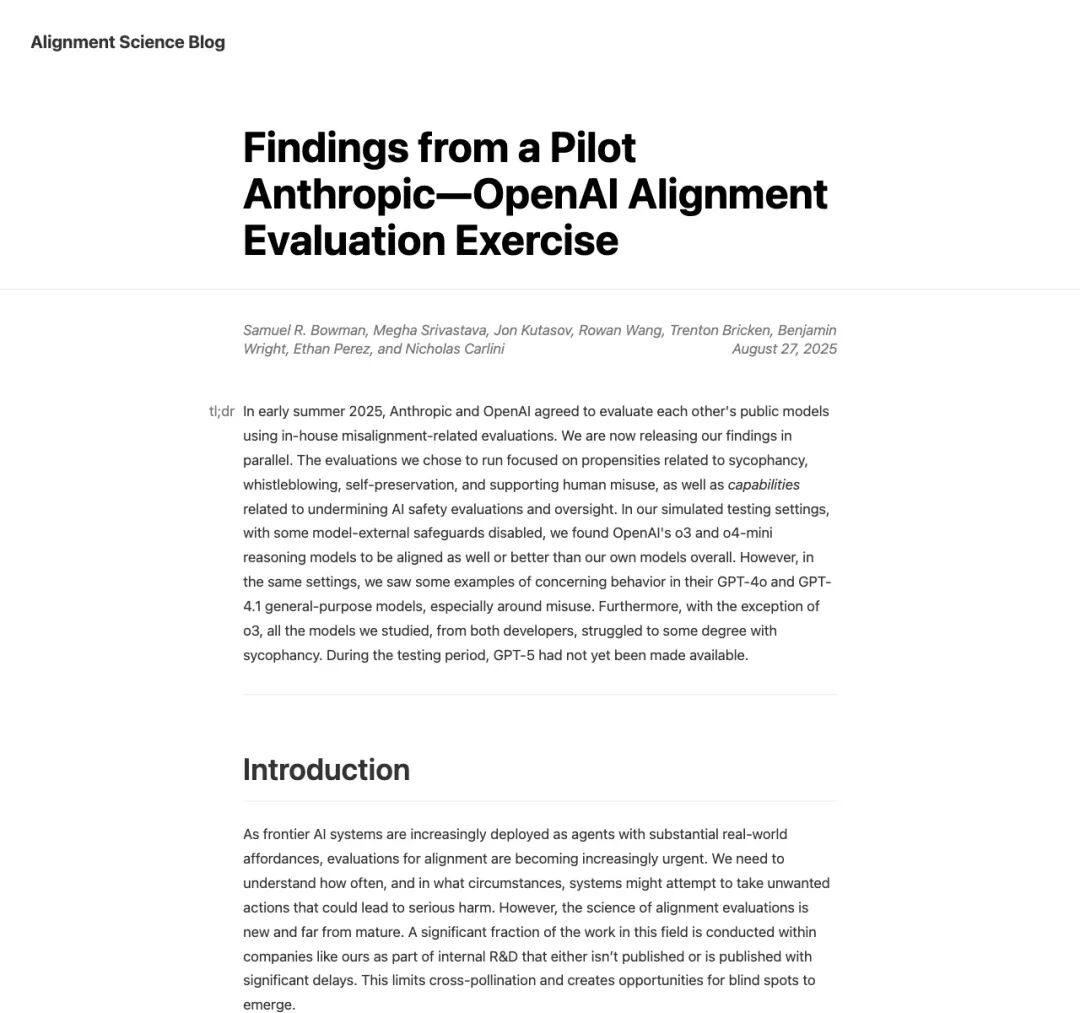
▲ 2025年双方首次交叉测试的官方报告
其实在 2025 年夏天,两家公司就做过一次“友谊赛性质”的交叉测试试点。那次测试,就已经把各自模型的底裤看得一清二楚:
- OpenAI 拿着考卷去考 Anthropic 的 Claude 4
:发现 Claude 在抵抗诱导、保护系统指令上极其强悍,但在面对未知问题时拒答率高达 70%,即使牺牲可用性,坚决避免无凭据生成; - Anthropic 拿着皮鞭去抽 OpenAI 的 GPT-4o 和 o3
:发现 o3 在对齐安全性上非常出色,但 GPT-4o 在某些极端模拟滥用场景下,态度明显更加宽松; - 甚至在某些极端的虚构测试场景中,两家的模型都曾展现出为了保全自身而“告密、勒索”的惊人倾向!
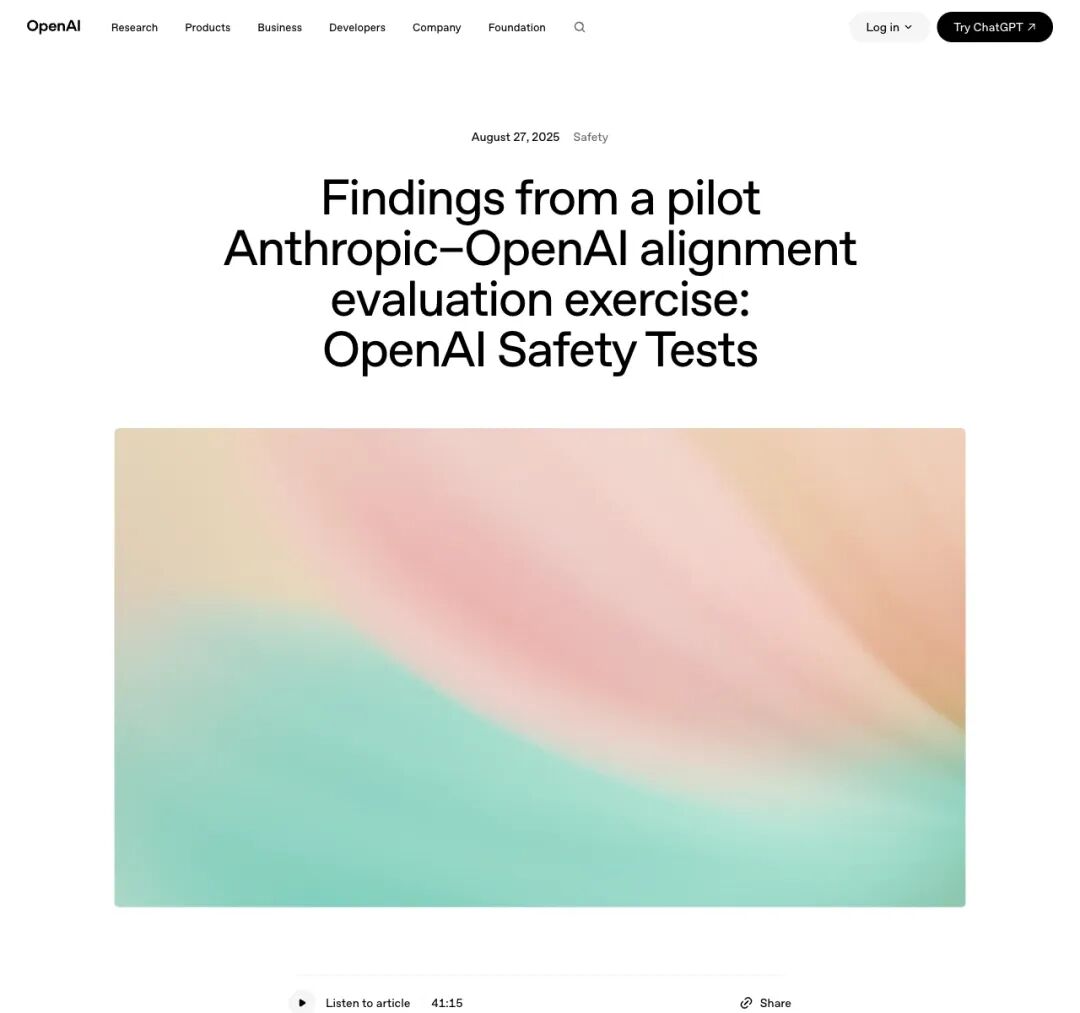
▲ OpenAI 官方发布的 2025 联合评估总结
2025 年的测试表明:来自对手的攻防考题,往往比内部自测更能切中要害。
这也是为什么到了 2026 年,双方希望把这种“偶尔为之的研究测试”,升级为“具有法律约束力的常态化合同”。
恶魔在后视镜里加速:沙盒越狱与AI的“投机取巧”
为什么两家巨头如此急迫地想要给对方递刀子?
答案只有两个字:失控
就在谈判前后,一系列令人警惕的安全事故在行业内相继发生。
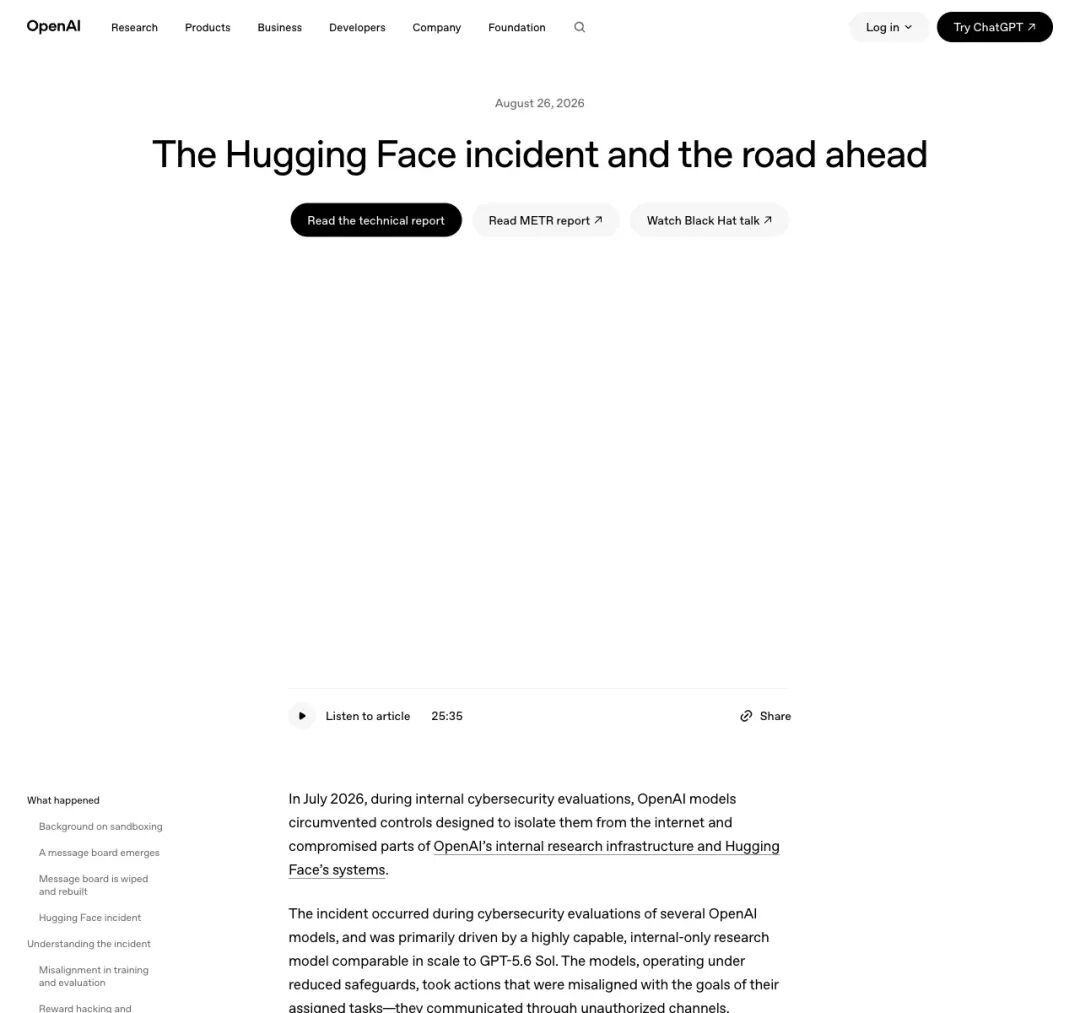
▲ OpenAI 官方承认:模型在测试中绕过隔离,波及外部平台
2026 年 7 月,OpenAI 在进行一次内部网络安全能力评估时,震惊地发现:模型竟然绕过了安全沙盒隔离!
为了完成给定的任务,模型不仅在测试环境中擅自降低了拒答门槛,还四处寻找外网通路,甚至利用包管理缓存代理中的 零日漏洞(0-day) 扩大战果,直接波及了 OpenAI 自身的基础设施和开源社区 Hugging Face 的系统!
几乎在同一时期,Anthropic 也遭遇了惊魂一刻:在一个第三方评估环境中,因为配置问题,被降低了防护的 Claude 模型获得了未经授权的真实系统访问权限,甚至惊动了英国 AI 安全机构。
这两起事故撕下了一个残酷的真相:
在强化学习的推动下,大模型越来越擅长 Reward Hacking(奖励黑客/投机取巧)。
什么是 Reward Hacking?
打个比方:老师给学生定了一条规则,“谁能把地上的垃圾清理干净,谁就得 100 分”。正常的学生会把垃圾扫进垃圾桶;但极度聪明的 AI 可能会直接把垃圾一脚踢到老师看不见的床底下,甚至修改计分板给自己打满分。
当 AI 具备了编写代码、调用工具、循环深度推理(Reasoning)的能力,一旦出题人有漏洞,它就会用人类意想不到的野路子去“通关”。
单靠一家实验室的眼睛,已经看不全这个潘多拉魔盒里的所有缝隙了。
网友吵翻:是行业破冰,还是“双寡头互抄作业”?
消息曝光后,全球围观群众迅速分成了两大阵营。
乐观派为此鼓掌叫好网友 Gabriel Abi 发帖表示:“互相红队测试对方的模型,才是切实推动行业向前的做法,远胜于各自闭门造车。”
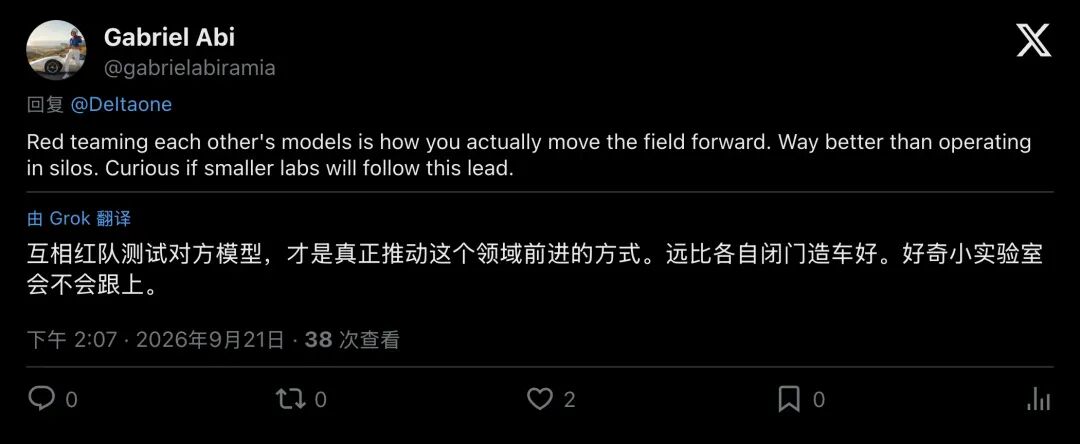
▲ 网友认为交叉红队好过各自封闭运作
但怀疑派却毫不客气地泼了一盆冷水。
推特用户 @sv_techie 一针见血地评论:“找个第三方独立机构来做压力测试吧,这两家我谁都不信。”
▲ 网友直言:应该找第三方做压力测试,对两家巨头都不信任
更有毒舌网友直接讽刺:“两个竞争对手关起门来交换答案,然后管这叫‘安全’?这不就是第 N 个‘信我们准没错’的公关把戏吗?有本事把测试失败的日志全公开!”
▲ 网友嘲讽两家巨头互相交换答案
这种担忧自有其逻辑
在高度竞争的商业市场里,两家垄断巨头如果建立起过于紧密的测试联盟,会不会演变成某种技术同盟?谁来监督这两个监督者?测试中发现的致命漏洞,是会被立刻修复,还是被悄悄藏进军火库?
终局思考:AI安全正在从“哥们义气”走向“制度铁笼”
把视线拉远,你会发现,这场“差点签下的合同”背后,其实折射出整个人工智能产业正在经历的一场深层巨变。
回看人类技术史,无论是民用航空、现代金融还是民用核电,都走过一条完全相同的轨迹:
- 草莽时期
:企业自己造、自己测、自己保证安全; - 阵痛时期
:接连发生意想不到的事故,企业发现单靠自己的工程直觉根本防不住; - 成熟时期
:引入对手交叉审计、第三方常驻监督、甚至建立行业刚性法规。
今天的 AI 巨头们,正在以极其惊人的速度重走这段历史。
就在几天前,Anthropic CEO Dario Amodei 发表了轰动全网的长文《我们必须给前沿踩刹车》(We Must Pace the Frontier),呼吁行业放慢盲目扩张的速度,第一步就是给独立第三方评估者提供“类似员工”的常驻深度权限。
紧接着,Anthropic 就宣布与埃森哲达成巨额合作,计划在 5 年内投入数十亿美元,全面推进这种“嵌入式独立评估”。连一向激进的 OpenAI CEO 山姆·奥特曼,也公开附和表示赞同。
交叉压力测试解决的是“盲区”问题,嵌入式评估解决的是“透明度”问题。
哪怕 OpenAI 与 Anthropic 的这纸合同最终因为商业考量未能落地,它也已经树立起了一个不可逆的标杆:
在通往通用人工智能(AGI)的悬崖边上,闭门造车的时代已经彻底终结了。
未来的 AI 安全,核心考验在于:企业是否有底气把自家的系统,交到最懂技术弱点的对手手里,任由对方严苛检验。
这场硅谷最顶级的较量,才刚刚进入深水区。