ARTICLE · 1042350
SSD卸载大模型,为什么不行?
最近DeepSeek V4.1 Flash刷屏行业,所有人都在算552B参数要多少张卡、全球HBM产能够不够用。但SemiAnalysis最新发布的这篇《Engrams Embedding Entendre》,撕开了AI算力竞赛的另一个维度:当大模型架构开始主动把“高频模式”做成可查表的内置记忆,整个推理服务器的存储层级逻辑,都正在被改写。
这不是简单的“省显存”小技巧,而是从训练到推理的全链路协同设计(Codesign)。Engram不仅改变了模型的计算范式,更重新定义了HBM、主机DRAM甚至NVMe SSD在AI服务器里的价值定位。今天我们就解读一下这份报告,看看这场大模型的“记忆革命”到底会带来什么。
一、Engram本质:给大模型装一本「常用短语词典」
传统Transformer架构的低效之处藏在细节里:每一个token的语义表示,都要通过注意力层和前馈层反复计算生成。但自然语言和代码里,大量局部模式是高度重复的——固定句式、常用代码片段、专有名词组合,这些内容每次出现都要重算一遍,本质上是算力和存储的双重浪费。
Engram的核心思路非常朴素:让模型“记住”高频出现的n-gram模式,推理时直接查表取向量,跳过冗余的注意力计算。
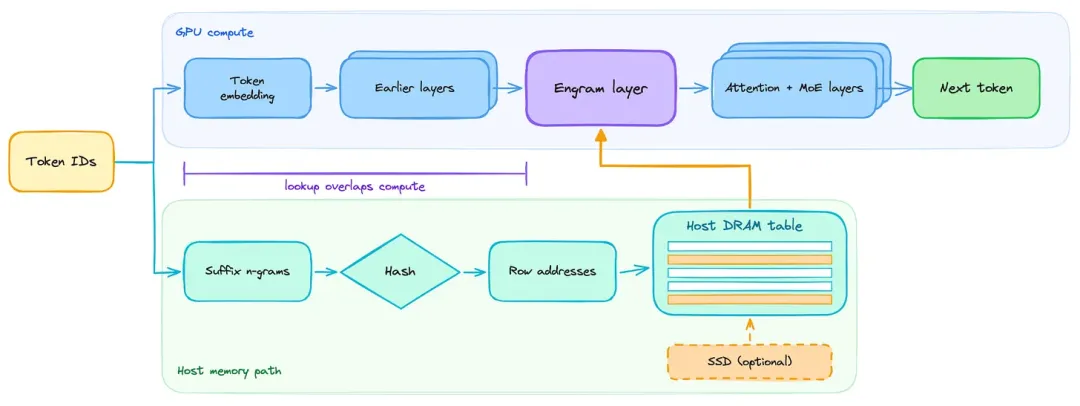
具体来说,它在标准token嵌入层之外,新增了一套可学习的多token查找表。
训练过程中,模型会自动把频繁出现的局部序列对应的特征向量固化下来;
推理时遇到匹配的token组合,就直接从表里取出预计算好的向量,不需要再通过完整的注意力+FFN链路重建。
SemiAnalysis团队复现了DeepSeek的实验,得到了两个非常关键的结论:
U型缩放规律:Engram对模型效果的提升呈现清晰的U型曲线,在特定分配比例下达到最优,效果全面优于纯MoE基线。 预测收敛提前:从KL散度随层数的变化来看,加入Engram后,模型早期层的表示就已经非常接近深层输出。相当于“浅层就把信息提取完了”,大幅降低了后续计算的压力。
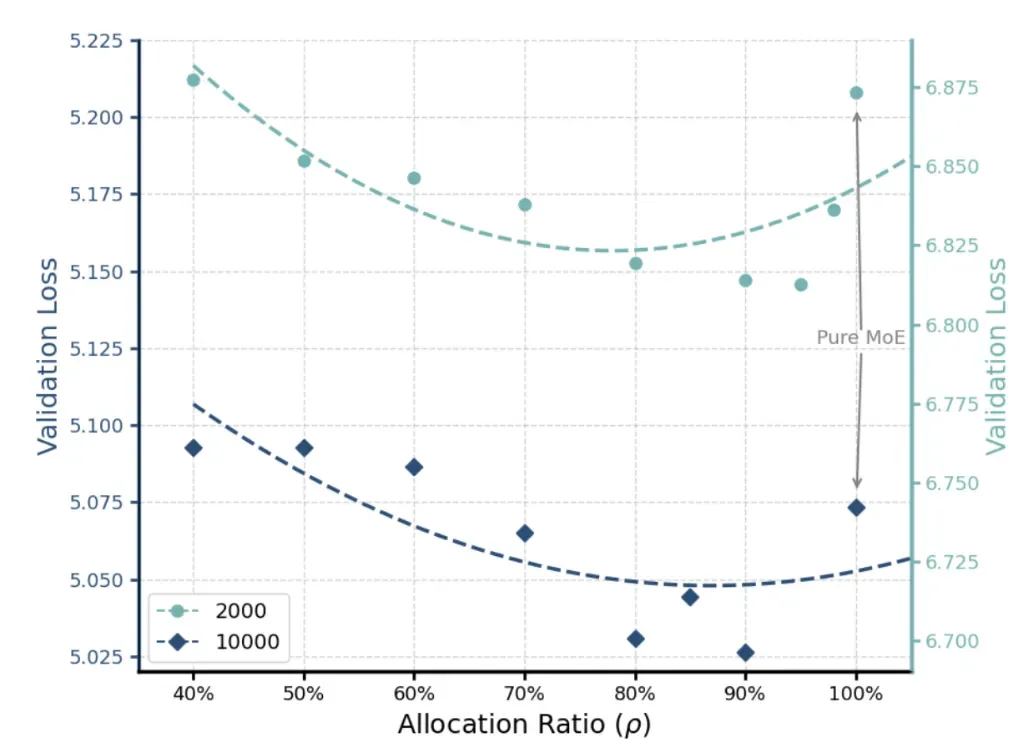
换句话说,Engram不是给模型“外挂知识库”,而是让模型在训练中就学会了“背常用句式”,把算力省下来处理真正需要推理的复杂内容。
二、大模型到底「记住」了什么?比你想的更琐碎
最有意思的部分,是SemiAnalysis对Engram门控权重的扫描——他们挖出了DeepSeek V4.1 Flash里使用频率最高的n-gram模式,结果和很多人预想的“存储硬核知识”完全不一样。
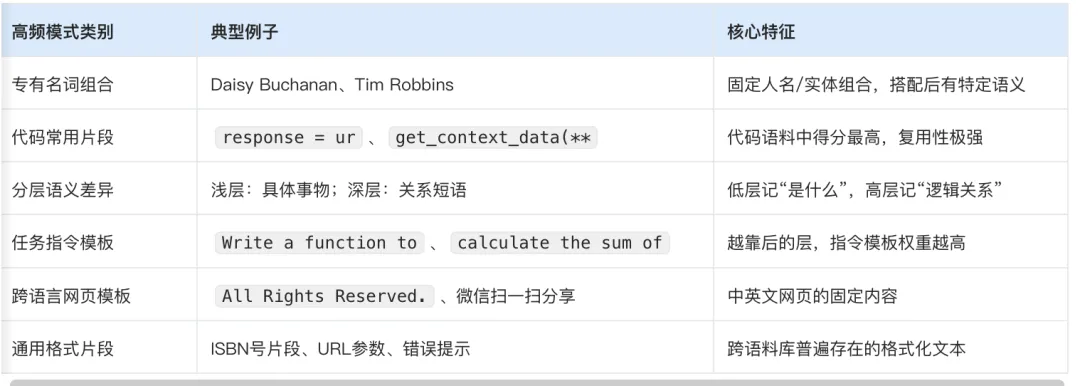
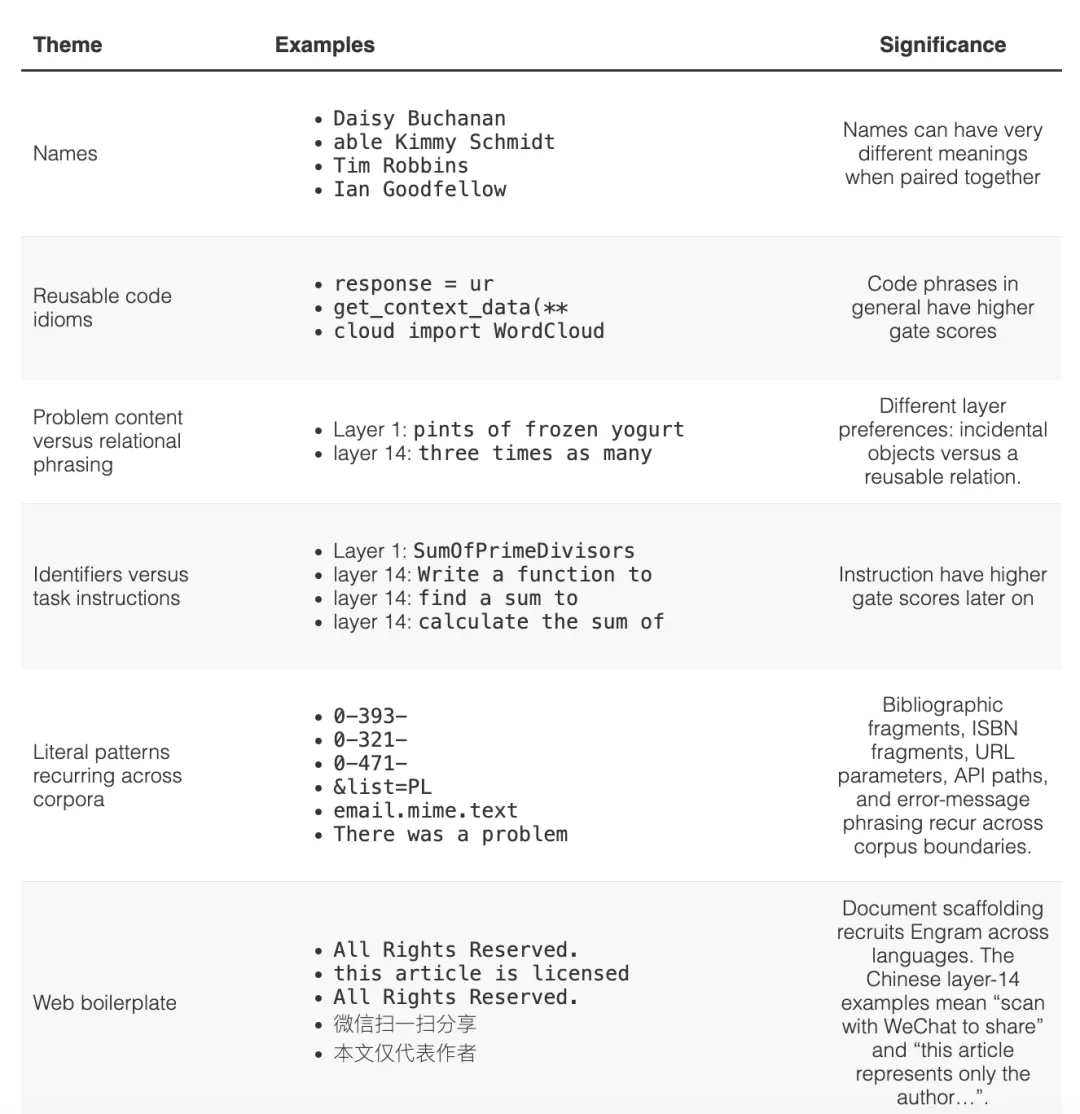
甚至还挖出了一个彩蛋:Wright : Ace Attorney(《逆转裁判》)也被模型记了下来。
这里有一个非常重要的认知纠正:Engram优化的是“预测准确率”这个训练目标,而不是“判断哪些知识有价值”。它记的不全是有用的知识,更多是“出现频率足够高的模式”——包括大量版权声明、网页导航、格式模板这类“数据噪音”。
这也带来一个产业推论:Engram的容量性价比,高度依赖训练数据的清洗质量。数据里的模板垃圾越多,记忆容量被无效内容占用的比例就越高。
三、真正的杀招:为「卸载」而生的架构设计
如果只是提升训练效果,Engram还不足以撼动存储产业。它真正的颠覆性,在于这是一个天生为参数卸载设计的架构——这也是整篇报告最硬核的部分。
传统大模型权重卸载为什么难用?因为权重访问依赖当前的隐藏状态,地址是动态变化的,没法提前预取,只能等算到那一步再去读,延迟直接爆炸,而且往往要搬运整个矩阵。
Engram完美避开了这些痛点:
地址确定性:每个token访问哪几行嵌入表,只由token ID决定,和当前计算状态无关。 可预取性:运行时可以提前预判需要的行,在前面层计算的同时,就从主机DRAM把数据预取过来,完全隐藏延迟。 细粒度访问:不需要传输整个权重矩阵,每次只取需要的几十行,数据量极小。
这种设计直接重构了推理服务器的存储分工:HBM只需要留着核心模型权重和KV缓存,Engram表完全可以放在主机DRAM里。
而实验结果甚至超出了“不损失性能”的预期——出现了反常识的提升:
即使在HBM容量充足的高端显卡上,把Engram卸载到DRAM,在绝大多数帕累托最优点位上,性能都比把Engram放在HBM里更好。 核心原因:省下来的HBM空间分给KV缓存,可以支持更大的batch和更多并发会话,带来的收益超过了Engram查表变慢的损失。
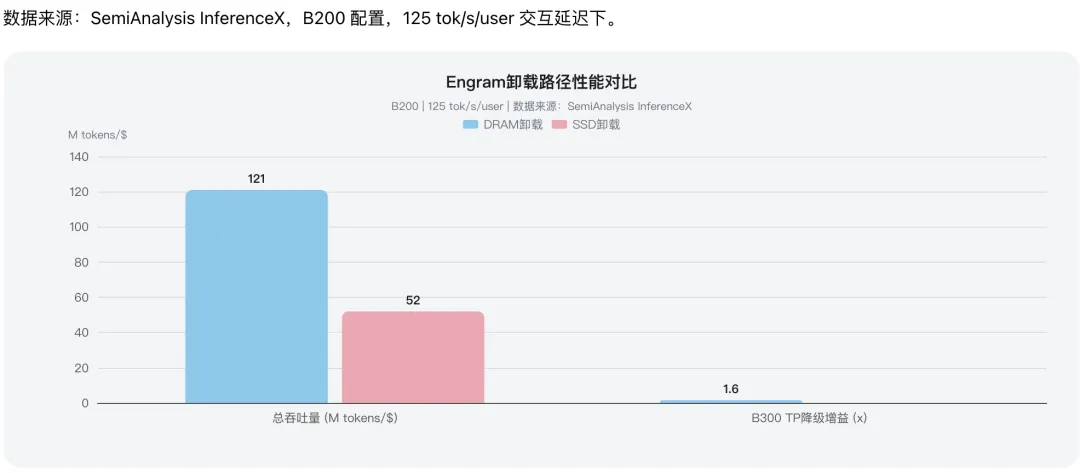
最重磅的数据来自B300配置:开启Engram DRAM卸载后,张量并行度可以从TP4(4卡)降到TP2(2卡),整体帕累托曲线最高提升1.6倍。换句话说,少一半GPU就能达到接近的推理性能,单位成本的吞吐量直接大幅跃升。
这里我们可以得出一个非常关键的产业判断:
推理端的HBM竞争,正在从“容量竞赛”转向“带宽竞赛”。容量不够可以用主机DRAM补,只要HBM带宽足够,就能把查表延迟完全隐藏。对于主流推理场景,4颗HBM的每美元带宽性价比,反而高于8颗堆叠的配置。
四、SSD卸载:看起来很美,目前还不实用
既然能卸到DRAM,很多人自然会想:能不能再往下卸到SSD?毕竟SSD容量大、成本低,能省更多钱。
SemiAnalysis在B200上做了专门的SSD卸载实验:用内存映射文件(mmap)把Engram表放在本地NVMe SSD上,让操作系统自动管理页缓存。
结论非常直接:生产环境完全不推荐。
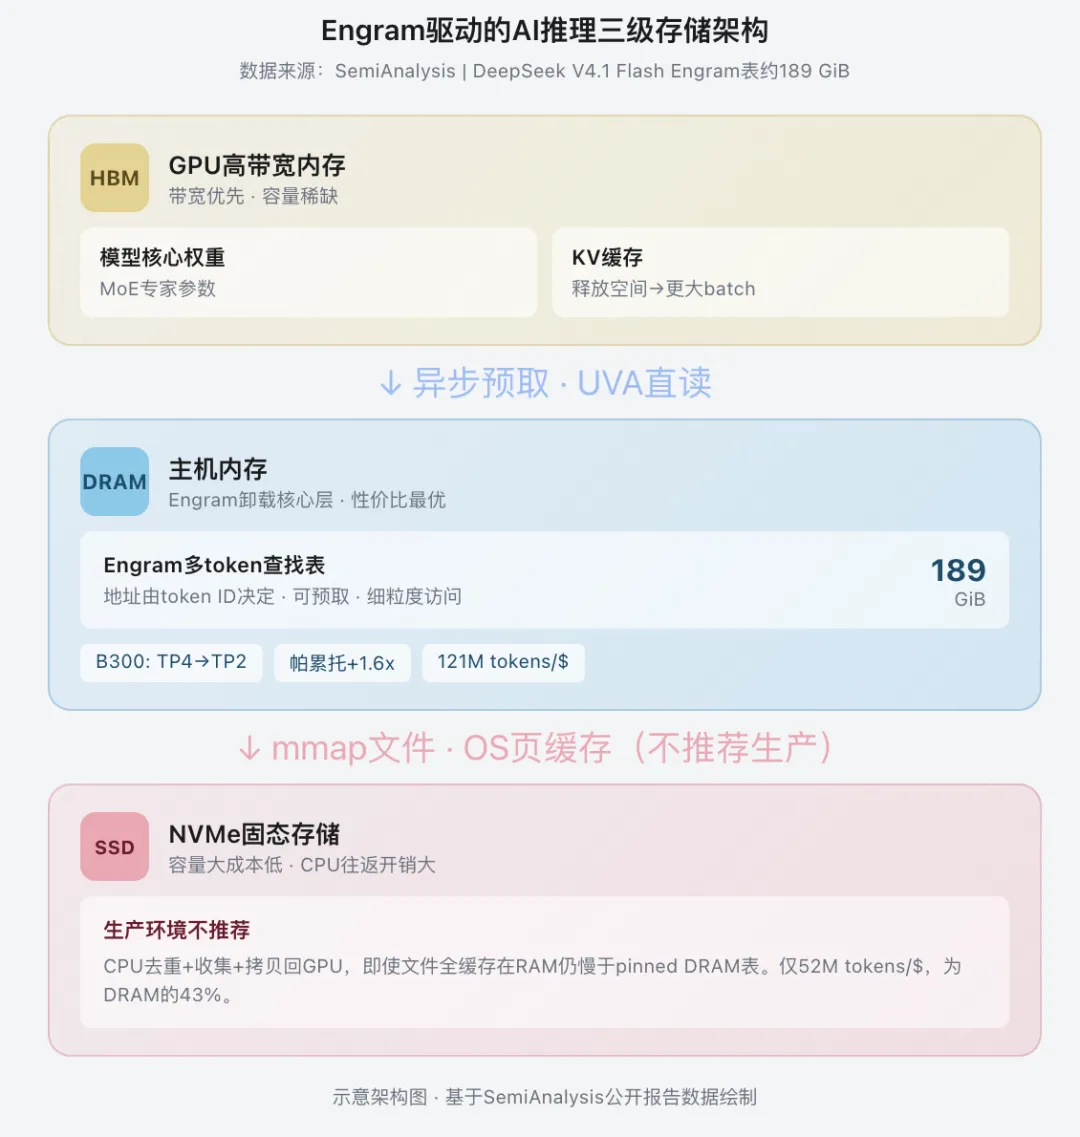
实验数据显示,在125 tok/s/user的典型交互延迟下,DRAM卸载能做到约1.21亿总tokens/美元,而SSD卸载只有约5200万,性能差了2.3倍;在部分配置下,差距最大可达3.84倍。
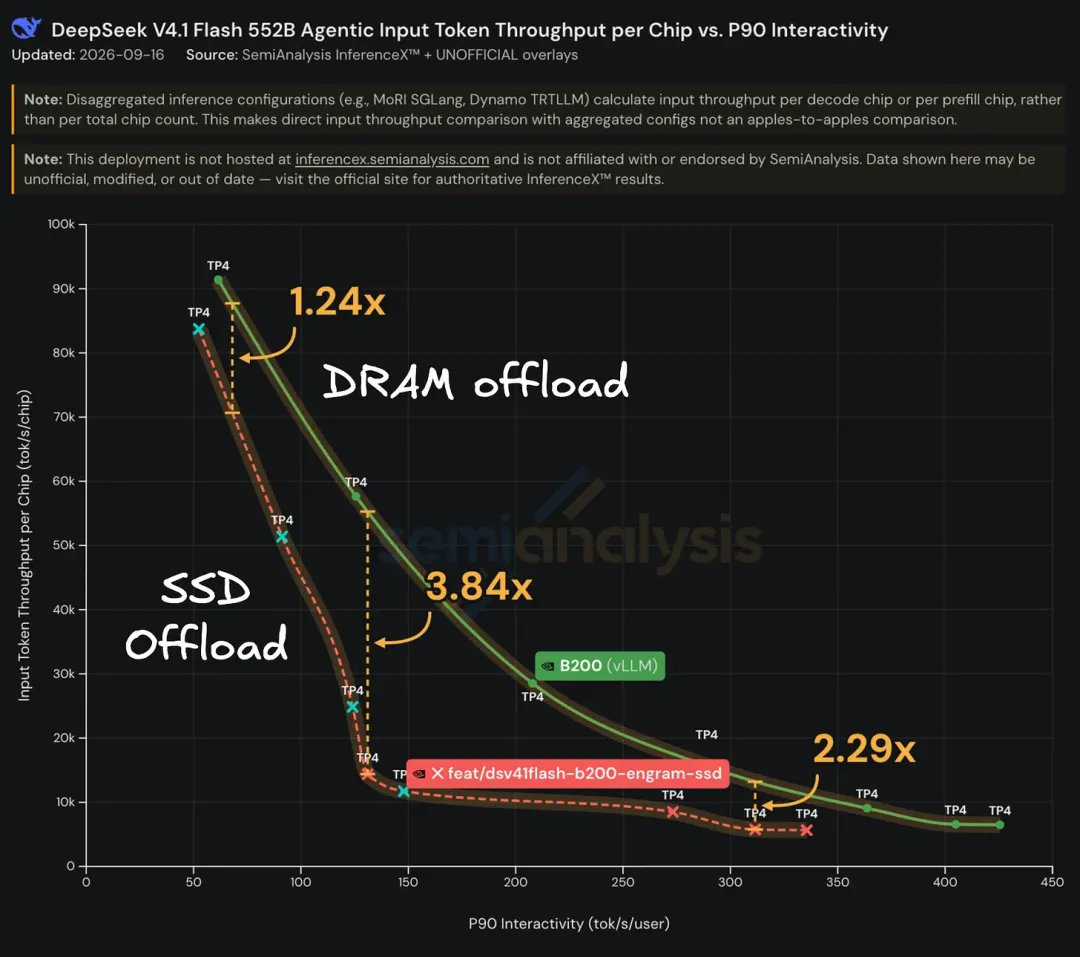
性能跳水的核心原因不是SSD读写速度,而是CPU往返的额外开销:
SSD路径需要把行ID先发给CPU、做去重、从SSD/页缓存中收集数据、再拷贝回GPU、最后做反量化。 即使文件已经完全缓存在内存里,这套调度和数据搬运的开销依然存在,性能还是不如直接钉在DRAM里的表。
更关键的是经济账:你只是把Engram从RAM挪到了SSD,服务器里那几张昂贵的GPU还在那儿,总成本没降多少,性能却先砍了一半。只有当释放的内存能让你改用更便宜的CPU/主板配置,或者能额外部署更多服务时,才可能有正收益。而目前的实现还远达不到这个临界点。
五、推理战场实测:CUDA护城河依然坚固
这份报告里另一个重头戏,是InferenceX基准测试下,NVIDIA与AMD在DeepSeek V4.1 Flash上的真实对战。
结果可以用一句话总结:硬件差距不大,生态差距碾压。
发布日当天(Day 0):NVIDIA全系列6款SKU(H100/ H200/ B200/ B300/ GB200/ GB300)在vLLM下开箱即用,零适配问题;AMD直到发布23小时后,都没有放出官方可用的推理镜像。 发布7天后:MI355X的每美元性能,仍然比B200差2~4倍。 最极端对比:刚发布的未优化阶段,AMD每美元性能比H200差14.8倍,比B200/B300最多差出42倍。
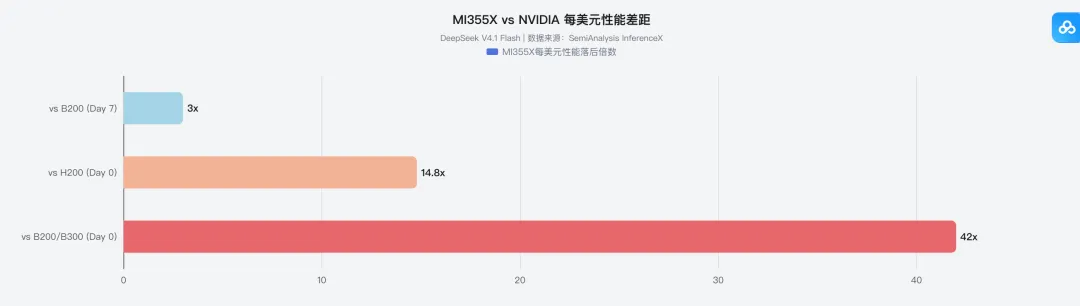
这就是CUDA最坚固的护城河:背后是600万开发者组成的生态,vLLM、SGLang、TensorRT-LLM这些主流推理框架,都会优先针对CUDA做深度优化。新模型发布当天就能跑满性能,这种“Day 0适配”能力,是AMD目前还追不上的差距。
当然也要客观说,MI355X相比前代进步已经非常大,只是生态的补课不是一朝一夕的事。
六、几个关键结论与产业思考
最后,我们把这份报告的核心启示浓缩成几点:
Engram不是可插拔的“字典插件” :移除Engram之后,模型的专家选择、下游特征都会发生变化,性能下降不是“少了个知识库”那么简单。记忆模块和推理主干是深度耦合、协同训练的,不是简单的“大脑+外挂硬盘”关系。 三级存储架构正式成型:AI推理服务器的存储格局正在从“HBM独大”演变为:HBM存核心权重与KV缓存、主机DRAM存Engram与热数据、SSD存冷数据与备份。架构创新正在倒逼硬件重新划分分工。 中国架构创新的反向影响力:以DeepSeek为代表的中国大模型团队,已经从“应用层创新”深入到“基础架构层创新”。如果Engram类架构成为行业主流,全球HBM的需求结构、DRAM的增量空间都会被重新计算。 这只是开始:报告末尾提到,LongCat、Qwen3.8 Flash Next等更多新模型,都会采用类似的n-gram记忆设计。这场“让大模型学会记忆”的架构革命,才刚刚拉开序幕。
过去两年聊AI存储,言必称HBM堆料,仿佛容量就是唯一真理。但Engram告诉我们:真正的效率革命,永远来自架构与硬件的协同设计。
当大模型开始“记住”而不是每次都“重新计算”,整个算力和存储产业的底层逻辑,都该重新写了。
基于 Engram 架构的核心结论 ——HBM 带宽比容量更重要、主机 DRAM 需求增量、CXL 内存池化加速。
扩展阅读:

如您有任何的建议与指正,敬请在文章底部留言,感谢您不吝指教!如有相关合作意向,请后台私信,小编会尽快给您取得联系,谢谢!