ARTICLE · 1099619
agentmemory:AI 编程助手最缺的不是更强的模型,而是"记忆"
AI 编程助手最缺的不是更强的模型,而是"记忆"
导语:你有没有发现,每次打开 Claude Code、Cursor 这类 AI 编程工具,都像面对一个"金鱼脑"同事——上个会话它刚帮你写完 JWT 鉴权,这个会话问它"接着加个限流",它一脸茫然,你只能把架构、技术选型、踩过的坑全部再讲一遍。今天要介绍的 agentmemory,就是专门治这个病的开源项目:它给 AI 编程代理装上一套可检索、可演化、可跨工具共享的"长期记忆"。项目今年 2 月才创建,7 个月拿下约 2.9 万 Star、2500+ Fork,登顶 Trendshift 热榜,Apache-2.0 协议,零外部数据库即可跑起来。
一、它到底是什么?
一句话:agentmemory 是给 AI 编程代理用的"持久化记忆引擎 + MCP 服务器"。它默默记录你的代理在每个会话里干过什么,压缩成结构化的记忆条目,在下次会话开始时把正确的上下文喂回去。
每个 AI 编程工具其实都自带"记忆":Claude Code 有 MEMORY.md,Cursor 有 notepads。但这些东西本质上只是便利贴——200 行的容量上限,手动维护,写多了把上下文窗口塞爆。agentmemory 做的事,是给便利贴后面装一个可搜索的数据库。
举一个官方文档里的例子:第一个会话你让代理搭 JWT 鉴权,它写完代码、跑完测试、修完 bug。第二个会话你只说一句"现在加个限流",代理就已经知道:鉴权用的是 jose 中间件、在哪个目录、测试覆盖了什么、当年为什么选 jose 而不是 jsonwebtoken(为了 Edge 兼容)。不用复述,不用贴代码,它就是知道。
项目脱胎于作者的一篇设计文档(一个 1.6 万阅读量的 GitHub Gist),思路是在 Karpathy 提出的 LLM Wiki 模式之上,补上置信度评分、记忆生命周期、知识图谱和混合检索——agentmemory 就是这套设计的完整实现。底层跑在一个叫 iii 的开源引擎上,整个系统不依赖任何外部数据库(SQLite 起步),一条 npx 命令就能跑。
二、它是怎么工作的?
整个流程分三段,全程在后台自动发生,你不需要手动记任何笔记:
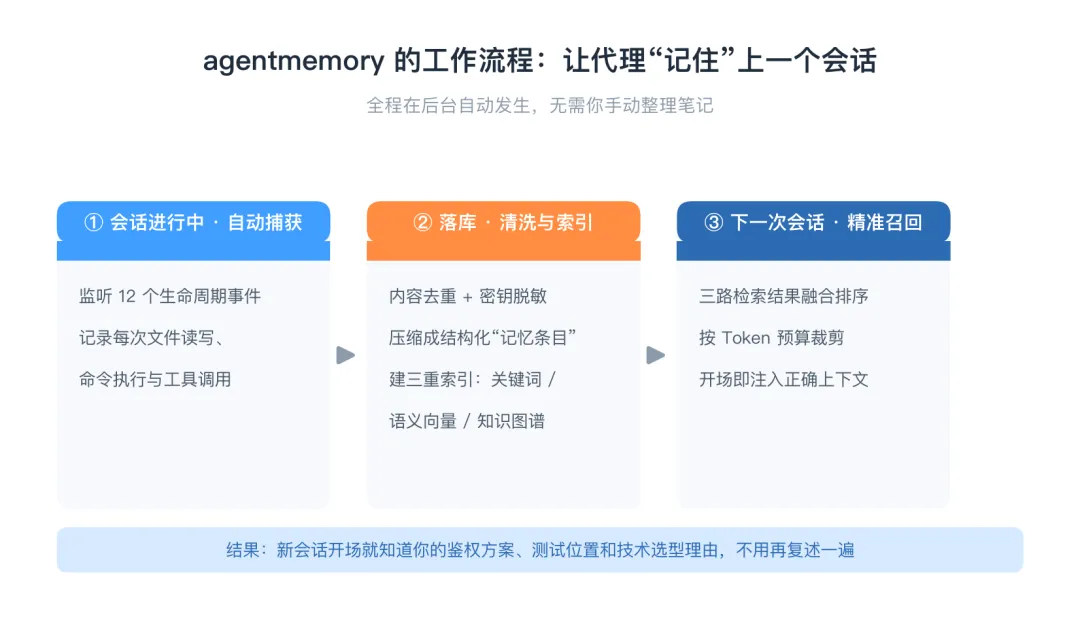
图:agentmemory 的"捕获 → 落库 → 召回"流水线
三段背后各有一些值得说的细节:
捕获阶段:通过监听代理的 12 个生命周期钩子(会话开始、用户提问、工具调用前后、出错、会话结束……),把每一次文件读写、命令执行都记下来。存之前会先做内容去重和隐私过滤——API 密钥、token、被 <private> 标签包裹的内容会在入库前被剥离。
整理阶段:这是 agentmemory 最有意思的设计——它模仿人脑的"睡眠整理"机制,把记忆分成四层:
- 工作记忆
:原始的工具调用记录,类似"瞬时印象"; - 情景记忆
:压缩后的会话摘要,即"发生了什么"; - 语义记忆
:从会话中提炼出的事实和模式,即"我知道什么"; - 程序性记忆
:工作流和决策模式,即"这类活儿怎么干"。
记忆还会按艾宾浩斯遗忘曲线衰减:常被访问的记忆被强化,过期的自动淘汰,相互矛盾的记忆会被检测出来并解决。你的代理不会变成一个囤积癖。
召回阶段:新会话开始时,系统用三路检索(BM25 关键词 + 语义向量 + 知识图谱)融合排序,按 Token 预算(默认 2000)裁剪后注入对话——只给"此刻最相关的记忆",而不是把整个仓库历史塞进去。
三、四个最打动我的特点
① 一个记忆库,喂饱所有工具
它通过 MCP 协议对外提供服务,Claude Code、Cursor、Codex CLI、GitHub Copilot CLI、Gemini CLI、Devin、Warp 等 20 多种代理都能接,任何支持 MCP 或 HTTP 的客户端都行。关键是:所有工具共享同一个记忆服务器。你在 Claude Code 里踩的坑,Cursor 第二天就知道。相当于给整个工具箱配了一个公共大脑,而不是每个工具各挂一块孤立硬盘。
② 零成本也能跑,不交 API Key 也能用
默认"无钥匙模式"(keyless)下,系统用 BM25 关键词检索,完全不需要任何 API Key。想要语义检索时,把嵌入模型切到本地的 all-MiniLM-L6-v2——首次下载模型后推理全程在你电脑上跑,免费。对个人开发者来说,这是一套"电费都几乎不掏"的方案。
③ 它不只是存,还会"协调"
54 个 MCP 工具里有一整套多代理协作原语:任务租约(lease,防止两个代理同时改一个文件)、代理间信号(signal)、动作依赖图、P2P 记忆同步。当你同时开多个代理干活时,它们能通过记忆库"对表",避免互相踩脚。这在同类项目里相当少见。
④ 记忆看得见、可回放、可审计
本地起了服务后,浏览器打开 3113 端口就是实时查看器,你能看着代理的记忆一条条长出来;每个会话还能像看录像一样回放——拖动时间轴,提示词、工具调用、返回结果逐一呈现,支持 0.5x~4x 倍速。每一次记忆的增删都有审计记录,可追溯来源。老用户还能一键导入 Claude Code 的历史会话记录(JSONL),存量记忆不浪费。
四、成绩单:省了多少钱,准了多少
先看最实在的账:记忆要占上下文窗口,占多少决定你烧多少钱。按官方基准,一年高强度使用,直接粘贴完整历史要 1950 万+ Token(根本装不下);让 LLM 做摘要式记忆约 65 万 Token、500 美元;agentmemory 只要约 17 万 Token、10 美元——切到本地嵌入后是 0 美元。摊到每个会话,注入的记忆约 1900 Token,比内置方案(240 条观察要 2.2 万+ Token)省 92%。
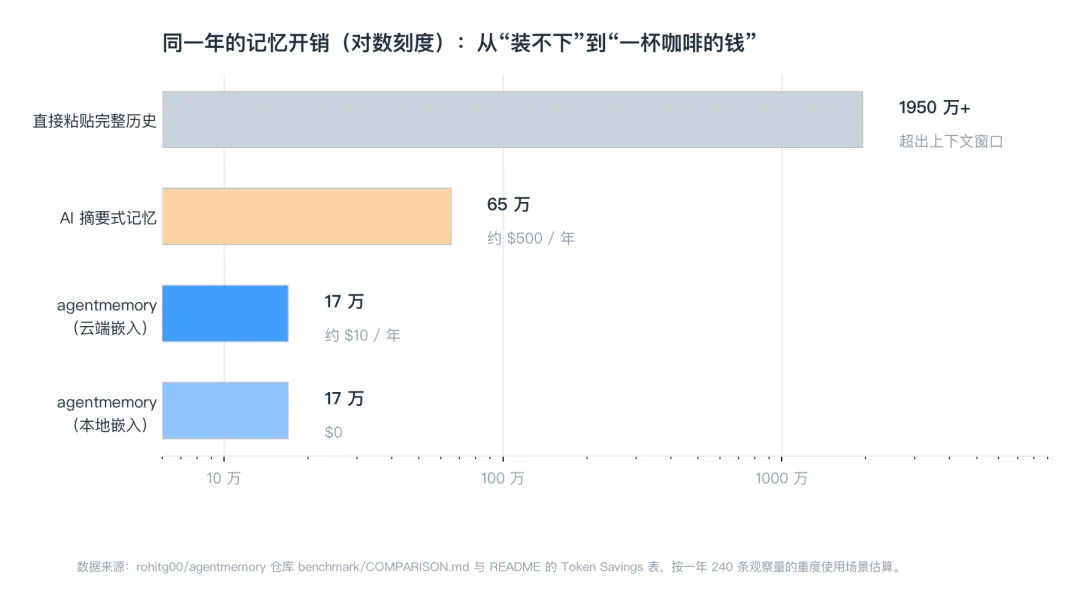
图:一年重度使用下的记忆开销对比(数据来自仓库 benchmark 目录)
再看检索质量。在学术基准 LongMemEval-S(ICLR 2025,500 道题)上,agentmemory 的混合检索拿到 95.2% 的 R@5(前 5 条结果命中正确答案的比例),R@10 达 98.6%;就算退到纯 BM25 兜底也有 86.2%。和同类项目放一起看要强调一点:各家数字大多来自不同基准或厂商自报,只能看个量级,不能当严格对排名——这一点项目自己在文档里也老实标注了,比很多"吊打一切"的 README 实在:
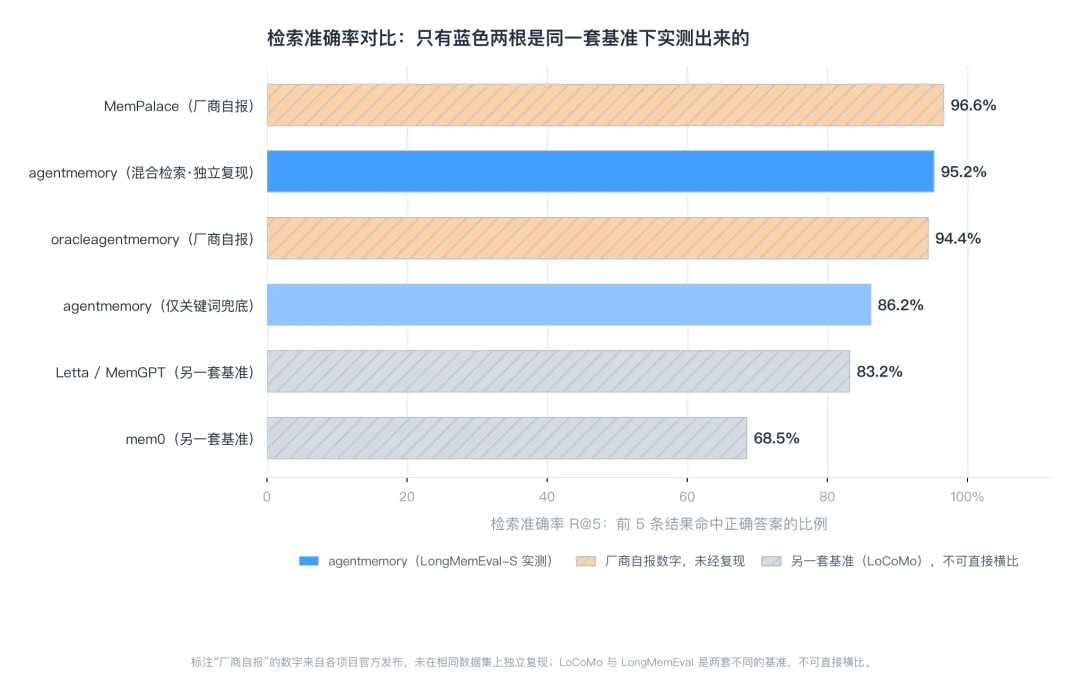
图:检索准确率 R@5 对比(蓝色两根为同一基准下的可复现实测)
和主要同类方案摆在一起看定位差异:
| 定位 | ||||
| 自动捕获 | ||||
| 检索 | ||||
| 多代理协作 | ||||
| 外部依赖 | ||||
| 记忆生命周期 | ||||
| 自托管 |
注:mem0、Letta 的检索数字发布于 LoCoMo 基准(与 LongMemEval 不同),此处不直接横比;Star 数为写作时快照,会随时间漂移。
简单说:mem0 适合给已有系统挂一个记忆 API,Letta 适合想要整套代理运行时的人,而 agentmemory 的差异化在于——"零手动捕获 + 跨工具共享 + 零外部依赖 + 本地优先"这个组合,目前没有第二家凑齐。
五、适合谁?以及几盆冷水
适合:同时用多个 AI 编程工具的开发者(记忆互通是刚需);在长期演进的大项目里被"反复解释架构"折磨的人;在意代码隐私、不想把工程上下文传到云端的团队;想给多代理工作流加"对账机制"的进阶玩家。
冷水也要泼几盆,入手前想清楚:
- 还没到 1.0
。当前版本 0.9.x,官方路线图明确 v1.0 要到 2027 年一季度才发布、之后才冻结 REST/MCP 接口。现在上车要做好随版本升级调整配置的心理准备。 - Windows 安装体验最差
。官方指引是优先 WSL2 或 Docker;原生 Windows 要手动下载引擎的可执行文件,自动安装仅支持 Copilot CLI 一家。 - 它自带一个底层引擎
。整个系统构建在 iii 引擎之上且严格锁版本,这换来了"零外部数据库"的简洁,但也意味着多一层对第三方运行时的依赖,出问题时排查多一层。 - 基准对比的水分要自己掂量
。竞品 R@5 数字多数是厂商自报或不同基准,别把 95.2% 当成"碾压一切"的证据——它证明的是"混合检索优于纯关键词",而不是"市场第一"。 - 单维护者风险
。项目目前核心维护者只有一人,正在按治理章程招募外部维护者;608 个 open issue 的响应速度可能波动。对稳定性敏感的生产环境,建议先在个人项目里试用。 - 无钥匙模式检索打了折扣
。不配嵌入 provider 时只有 BM25 关键词检索,语义类查询可能空手而归——想体验完整能力,记得切到本地嵌入(免费)。
六、一分钟上手
装好 Node.js 20+,两条命令就能跑起来(macOS / Linux):
# 终端 1:启动记忆服务器(首次运行有交互式引导)npx -y @agentmemory/agentmemory@latest# 终端 2:灌入示例数据,亲眼看看"召回"长什么样npx -y @agentmemory/agentmemory@latest demo# 可选:装 17 个原生技能,让代理自己知道何时查记忆npx skills add rohitg00/agentmemory -y
Claude Code 用户更省事,把下面这段直接丢给代理:
Install agentmemory: run `npx -y @agentmemory/agentmemory@latest`, then run `/plugin marketplace add rohitg00/agentmemory` and `/plugin install agentmemory`.然后浏览器打开 localhost:3113,实时看你的代理"长记忆"。想接 Cursor、Codex、Gemini CLI 等其他工具,一条 agentmemory connect <工具名> 即可,完整的 20 多个接入适配器在 README 里有对照表。
写在最后
大模型的上下文窗口再大,也装不下一个团队两年的工程记忆——而且"全塞进去"本身就是最贵的方案。agentmemory 押注的方向很清晰:记忆不该是大模型的临时缓存,而应该是工程团队的一等资产——可检索、可演化、可审计、可继承。
更值得玩味的是它的节奏:从一篇 Gist 设计文档到 2.9 万 Star 只用了 7 个月,同时项目把治理章程、路线图、维护者招募都写得清清楚楚,甚至给基准对比专门写了一页"哪些数字不可直接横比"。这种克制,在动辄"吊打全网"的开源宣传里反而成了稀缺品。
AI 编程工具的竞争正在从"谁的模型强"转向"谁的上下文管理好"。记忆层,很可能是下一个兵家必争的基础设施位。agentmemory 是不是最终赢家不好说,但它把"该长什么样"提前画了出来。