ARTICLE · 1379666
PDF翻译完排版全乱?这个开源工具整篇翻成中文,公式、图表、目录都留在原位
译文和原文左右对照,边读边做笔记
结果公式变成一堆乱码,表格错位,段落被拆得七零八落,图表干脆不见了。
换成整页截图丢给翻译,意思倒是能看懂,但只剩文字,原来的图和版式全没了。
想对照原文看,还得开两个窗口来回切,一页一页对着找,看三页就累了。
其实麻烦的从来不是英文,是 PDF 这个版式。
有人专门做了个工具,把翻译和排版一起解决:PDFMathTranslate,做全文 PDF 双语翻译的开源项目。
它能把整篇 PDF 翻成中文,翻完公式、图表、目录都还在原来的位置,另外再给你一份原文译文左右对照的双语版。
🔗 GitHub:github.com/PDFMathTranslate/PDFMathTranslate⭐ Star:38.4k
01 看外文 PDF,最麻烦的其实不是英文

因为 PDF 不是纯文字,是一张排好版的纸:双栏、公式、图表、脚注、目录、跨页表格,全都有固定的位置。
复制出来的文字顺序经常是乱的,双栏会串栏,公式会碎成一堆符号。翻译软件把文字抽走再塞回来,版式就没了——你拿到的是一段译文,不是一份还能接着用的文档。
更现实的是做笔记、写综述、跟同事讨论的时候,你需要的是「原文在这、译文在那」能对着看,而不是两个窗口来回切。
碰上扫描件更没辙,连文字层都没有,复制都复制不出来。
所以很多人最后还是硬啃原文,或者只翻个摘要将就一下。
02 PDFMathTranslate:翻完还是原来那个版式

丢一份 论文.pdf 进去,出来两份:论文-mono.pdf(纯译文)和 论文-dual.pdf(原文译文对照)。想先试试水,可以用 -p 1 只翻第一页;源语言、目标语言用 -li、-lo 指定。
翻译服务默认走 Google,也能换成 DeepL、OpenAI、MiniMax、Ollama 这些,用 -s 指定就行。
它不是随手写的脚本:相关工作被 EMNLP 2025 的 System Demonstrations 收录,仓库 2024 年 9 月建立,到今天还在更新。
03 三种用法,挑一个顺手的

想留在自己电脑:装一次,之后一行命令。需要 Python 3.11~3.12,终端里跑两行:
pip install pdf2zh
pdf2zh 论文.pdf
跑完当前目录就多出 mono 和 dual 两份 PDF。也能用 uv:先 pip install uv,再 uv tool install --python 3.12 pdf2zh。
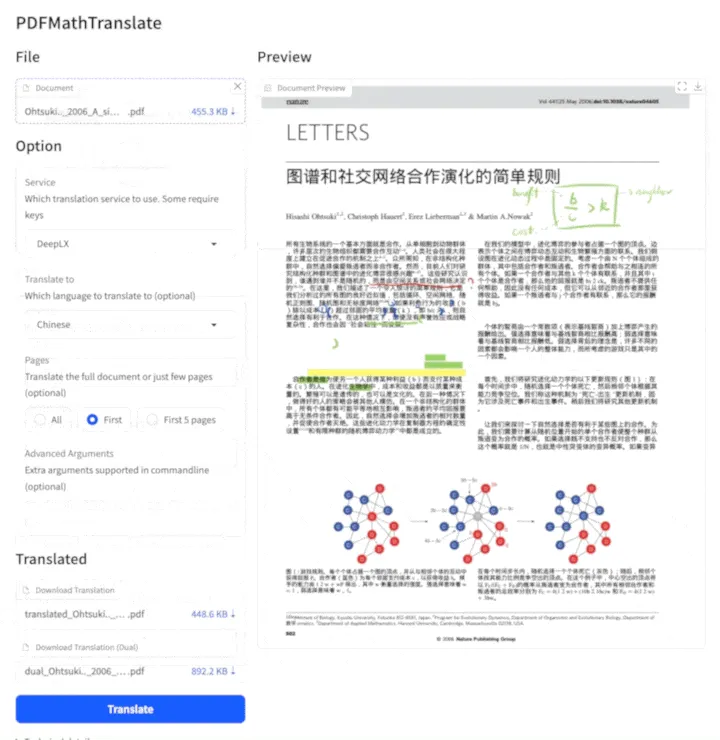
不想记命令:用项目自带的网页界面。终端跑一次 pdf2zh -i,浏览器会打开 localhost:7860,拖文件进去、选翻译服务和目标语言、点 Translate,右边直接预览译文,下面能下载单语版和双语版——上面那张截图就是这个界面。用 Docker 的话一条 docker run -d -p 7860:7860 byaidu/pdf2zh 也能得到同一个网页。
Windows 用户还有更简单的:Releases 里下载 pdf2zh-v1.9.11-win64.zip,解压双击 pdf2zh.exe 就能跑。Mac 没有官方图形安装包,只能走 pip、Docker 或在线服务这三条路。
另外它还有 Zotero 插件和 MCP 接口,习惯用文献管理器或者 AI 客户端的,可以接着往下配。
04 好用的地方,和得先知道的几件事

好用的地方:
· 版式保留是真卖点:比拼的不是「翻得像不像」,是「翻完这份文件还能不能接着用」。
· 一次给两份:纯译文和双语对照各一份,做笔记、核对原文都省事。
· 翻译服务能换:默认 Google 免费,想上更好的模型可以自己接。
· 本地跑得起来:不想把文档传出去,有得选。
得先知道的:
· 首次运行要下版面识别模型(DocLayout-YOLO),国内网络可能卡住,可以用 HF_ENDPOINT=https://hf-mirror.com 这个镜像。
· 默认翻译要联网:换 DeepL、OpenAI 得有自己的 key;想全程离线,得自己配 Ollama 本地模型,这一步并不省事。
· 复杂版式还没稳:扫描件 OCR 是 2026 年 9 月才加的实验功能,页面旋转、目录和列表格式、旧论文里的像素公式这些还没修完,翻完最好自己检查一遍。
· 许可证是 AGPL-3.0:自己用没问题,二次开发或者对外提供服务,要先看清楚开源义务。
05 谁适合用,谁先别急

· 经常要读英文论文、外文报告、技术标准的学生和研究者
· 需要原文译文对着看、边读边做笔记的
· 手里有一批 PDF 要批量翻的(有 --dir 参数可以整个文件夹一起处理)
可以先别急的:只是偶尔翻一两页,用浏览器自带的翻译就够,不值得装环境;纯扫描件、手写稿、排版特别复杂的老论文,效果还没稳;要求 100% 版式还原,或者要做商业闭源集成的,也建议先小范围试一遍再决定。
它解决的是「整份文档翻完还能接着用」,这是普通翻译工具做不到的——当然,再好的自动排版,交出去之前也该自己翻一遍。
项目还在更新,能用的路径也多,挑一条顺手的试一篇 PDF,比看十篇介绍管用。
下期预告: 下一期聊聊一个免费无广告的开源办公套件,Word、Excel、PPT、PDF 一套全齐,文件全留在自己电脑上。
💬 你平时看英文 PDF 是怎么对付的?复制粘贴、整页截图,还是硬啃原文?评论区聊聊~
我是捡星指南,帮你从 GitHub 捡起真正能用的开源好东西。
觉得有用的话,点个「赞」再走呗~