ARTICLE · 1111685
GAIA:面向通用 AI 助手的基准测试
原文:GAIA: a Benchmark for General AI Assistants
作者:Grégoire Mialon、Clémentine Fourrier、Craig Swift、Thomas Wolf、Yann LeCun、Thomas Scialom
出处:ICML 2024|arXiv:2311.12983,2023-11
主页与数据集:https://huggingface.co/gaia-benchmark/GAIA
摘要
我们提出 GAIA,一个面向通用 AI 助手(General AI Assistants)的基准测试;如果某系统能够解开它,将代表 AI 研究的一座里程碑。GAIA 提出真实世界的问题,这些问题需要一组基础能力,例如推理、多模态处理、网页浏览,以及通常意义上的工具使用熟练度。GAIA 的问题对人类而言在概念上很简单,却对大多数最先进的 AI 构成挑战:我们展示出,人类受访者可以得到 92% 的成绩,而装备了插件的 GPT-4 只有 15%。这一显著的性能差距,与近来 LLM 在法律、化学等专业性技能任务上超越人类的趋势形成鲜明对比。GAIA 的理念偏离了当前 AI 基准的趋势——后者建议瞄准对人类越来越难的任务。我们主张,通用人工智能(AGI)的到来,取决于一个系统能否在这类问题上展现出与普通人类相似的鲁棒性。使用 GAIA 的方法论,我们设计了 466 个问题及其答案。我们公开这些问题,但保留其中 300 个问题的答案,以驱动由此可访问的排行榜。
译注(原文扉页信息):日期:2023 年 11 月 23 日。通讯:{gmialon,tscialom}@meta.com,clementine@huggingface.co。代码:https://huggingface.co/gaia-benchmark。
1 引言
大语言模型(LLM)可以说为通用系统开辟了道路。事实上,其中最新的模型(OpenAI, 2023; Anthropic, 2023; Anil et al., 2023; Touvron et al., 2023)表达流畅、知识丰富、在某种程度上与人类偏好对齐(Ouyang et al., 2022),并且可以在零样本或少样本设定下(Brown et al., 2020)用网页浏览器或代码解释器等工具进行增强(Mialon et al., 2023)。
然而,评估这些系统是一个悬而未决的问题:鉴于其不断涌现的新能力,LLM 正以越来越快的速度不断攻破 AI 基准(Kiela et al., 2023)。
为了寻找更有挑战性的基准,当前的趋势是寻求对人类越来越难的任务,用更繁复的教育测评(例如 STEM 和法律领域)来考验 LLM,或瞄准更复杂的成品,例如写一本连贯的书。但是,对人类困难的任务未必对最近的系统困难:例如颇具挑战性的 MMLU 或 GSM8k 基准(Hendrycks et al., 2021; Cobbe et al., 2021)已接近被解决¹,这源于 LLM 的快速进步,并可能叠加了数据污染²。此外,开放式生成通常需要人类评估或基于模型的评估(Zheng et al., 2023)。随着任务复杂度提高——例如输出长度或所需技能的增长——人类评估将越来越不可行:如何评估一本 AI 生成的书,或全世界只有极少数人能解出的数学题的解答?另一方面,基于模型的评估按其构造依赖于更强的模型,因而无法评估新的最先进模型,更不用说其潜在的微妙偏差,例如偏爱摆在前面的选项(Zheng et al., 2023)。总而言之,评估新的 AI 系统需要重新思考基准(Chollet, 2019)。
¹ GPT-4 在 MMLU 上得 86.4%。人类非专业者在 MMLU 上的准确率只有 34.5%;专家级人类表现估计为 89.8%。 ² 例如 Hellaswag 的情况。
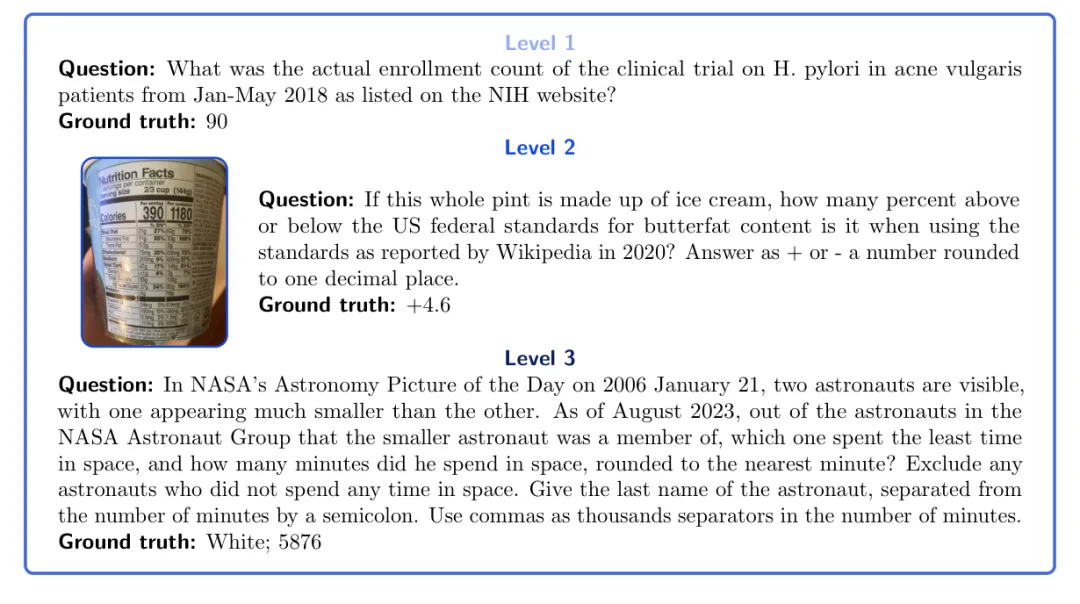
图 1:GAIA 问题示例。完成任务需要推理、多模态处理或工具使用熟练度等基础能力。答案无歧义,并且(按设计)不太可能在训练数据中以纯文本形式被找到。部分问题附带额外证据(如图片),反映了真实使用场景,并允许对问题做更好的控制。
除了对人类更难的任务之外,另一种思路是让 AI 系统去解决概念上简单、却需要准确执行复杂动作序列的任务,其组合空间巨大。输出只有在任务成功完成之后才能得到,而且易于验证——类似于工作量证明(Proof of Work)算法(Jakobsson and Juels, 1999; Dwork and Naor, 1993),其中计算机被要求解一个复杂问题,而其解易于核验。AI 助手的任务,鉴于其需要接触多样且不确定的世界,恰好满足这一准则,同时天然扎根于实际使用场景。
我们沿着这个方向提出 GAIA——一个面向通用 AI 助手的基准,包含 466 个精心构造的问题及其答案,以及配套的设计方法论。我们的问题易于创建,对 AI 系统有挑战性——对 LLM 而言,大多数问题需要复杂的生成——却存在唯一的事实性答案,从而允许简单而鲁棒的自动评估。
GAIA 试图避开当前 LLM 评估的若干陷阱,其目标是:
•真实世界且有挑战性的问题。例如,LLM 通常需要浏览开放且变化着的网页、处理多模态,或进行多步推理才能回答我们的问题。相反,许多 LLM 基准相当专门化和/或局限于封闭的合成环境。
•通过概念简单的任务实现易解释性——非专业标注者可取得近乎满分的成绩——加上配套的推理轨迹,以及数量不多但高度精选的问题。这与那些缺乏效率和可靠性的聚合型基准形成对比(Perlitz et al., 2023)。
•不可博弈性(Non-gameability)。回答问题需要成功完成若干步骤,而这些步骤因其多样性而难以被暴力穷举。检查推理轨迹的可能性、答案所需的精确度、以及答案不以纯文本形式存在于互联网上,都防止了可能的数据污染。相比之下,多选题答案(如 MMLU)使污染评估更加困难,因为一个错误的推理轨迹更容易碰对正确选项。
•使用简便。至关重要的是,我们问题的答案是事实型的(factoid)、简洁且无歧义的。这些性质允许简单、快速、事实性的评估。我们的问题旨在被零样本回答,从而限制评测设定的影响。相反,许多 LLM 基准的评估对实验设定敏感,例如提示(prompt)的数量与性质(Liang et al., 2022b)(第 8.2 节),或基准的实现方式。³
尽管在人类感到困难的任务上很成功,最强能力的 LLM 在 GAIA 上表现很差。即便装备了工具,GPT-4 在我们最简单的任务上成功率也不超过 30%,在最难的任务上为 0%。与此同时,人类受访者的平均成功率为 92%。因此,一个能够解决 GAIA 的系统可以在 t-AGI⁴ 的框架下被评估——注意人类通常在最简单的问题上花约 6 分钟,在最复杂的问题上花约 17 分钟。从另一个相关视角看,这样的系统可以说是在 Morris et al. (2023) 最近提出的框架内的一个称职的通用 AI,而且由于 ChatGPT(OpenAI, 2023)比它低一个层级,这似乎是 ChatGPT 之后 AI 研究的下一座里程碑。本文涵盖 GAIA 的构成、其设计选择,并解释如何构造问题及相关挑战,以便社区能够进一步扩展该基准,瞄准新出现的问题,例如与工具使用或多模态相关的安全性。我们还分析了迄今一些最强助手成败的原因,展示了增强 LLM 的潜力。我们发布一个包含 166 个已标注问题的开发者集,并发布其余 300 个问题(不附标注):该基准将主要以排行榜的形式托管。我们希望我们的方法论有助于解决 NLP 内外的开放式生成评估问题,并相信成功解开 GAIA 将是迈向下一代 AI 系统的重要里程碑。
³ https://huggingface.co/blog/evaluating-mmlu-leaderboard ⁴ 如 https://www.alignmentforum.org/posts/BoA3agdkAzL6HQtQP/clarifying-and-predicting-agi 所定义,t-AGI 指在大多数任务上胜过被给予时间 t 的多数人类专家的系统。
2 相关工作
评估大语言模型。 随着 LLM 能力的快速进步,基准被饱和的速度越来越快。举一个例子,阅读理解在几年前还是一项有挑战性的任务(Rajpurkar et al., 2016)。Wang et al. (2018) 提出通用语言理解评估基准(GLUE),模型在一年之内就超越了人类。其扩展版(Wang et al., 2019)在发布后也没能撑过几年。更一般地,每过一年,静态基准就以越来越快的速度被饱和并以人类水平被解决,Kiela et al. (2023) 对此有很好的展示。在寻找更难评估的过程中,一个自然的方向是探索需要各领域(如法律或科学)专业级知识的任务:例如 MMLU(Hendrycks et al., 2021),包含超过 15,000 个问题,覆盖 STEM、人文、社会科学等 57 个学科。然而 LLM 已经在这些基准上超过了人类表现,甚至有报道称它们已达到可令人信服地通过美国律师资格考试(OpenAI, 2023),或超过 USMLE 及格线的程度——USMLE 是美国用于评估临床能力并授予执照的考试项目(Nori et al., 2023)。在更全面地评估 LLM(包括其更广泛的对话维度)的方向上,已有的尝试包括:(i) 评估合集(Gao et al., 2021; Liang et al., 2022a; Srivastava et al., 2023),它们往往难以被有意义地聚合,且容易因数据泄漏而受到污染;(ii) 人类评估,它耗时且难以扩展;或 (iii) 为克服这一限制而使用的基于模型的评估(Zheng et al., 2023)。然而,最后这种方案依赖于使用一个比当前被评估模型更强的 LLM(通常是 GPT-4),评估的质量会受评估者 LLM 缺陷的影响,而这些缺陷并不总是显而易见,可能导致微妙错误的结果。
评估通用助手。 尽管将 LLM 变成通用助手的努力在持续进行(见我们在附录 A 的讨论),相应的评估却滞后了。大多数评估依赖于封闭系统、特定 API 调用、某种给定的"正确做法",或只是简单地挪用现有评估数据集。例如 ToolQA(Zhuang et al., 2023)或 Gentopia(Xu et al., 2023a)将现有数据集与人类标注(MMLU、MATH 等)组合,存在训练时被污染的风险,且无法确保工具使用真的被测试到。Gorilla(Patil et al., 2023)提出 APIBench,测试类智能体系统调用特定 API 的能力,与 API-Bank(Li et al., 2023b)类似,后者提供一个 API 池在评估期间帮助 LLM。AgentBench(Liu et al., 2023a)更通用一些,提供了若干封闭盒子环境(从 Unix shell 到 WebShopping API),助手 LLM 可部署其中回答用户查询。然而,由于这类评估依赖封闭环境,它们评估的可能是助手学会使用特定 API 的程度,而非扎根于真实世界交互的更一般的结果。与此相反,GAIA 不指定可能的 API,而是依赖与真实世界的交互。OpenAGI(Ge et al., 2023)同时提出了一个平台和一个基准,由跨模态、跨能力的多步任务构成,与我们的工作更接近。其与 GAIA 的核心区别在于,他们的任务聚焦于当前模型能力而非即将到来的进步。
3 GAIA
本节涵盖 GAIA 的设计与内容,以及构造问题及相关挑战的指南。
3.1 一个方便却有挑战性的通用 AI 助手基准
GAIA 是什么,如何工作? GAIA 是一个面向 AI 系统的基准,提出通用助手类问题。GAIA 试图规避 LLM 评估的多种陷阱。它由 466 个由人类设计并标注的问题组成。这些问题以文本为主,有时附带一个文件(例如图片或电子表格)。它们覆盖各种助手使用场景,例如日常个人事务、科学或通识。问题的设计使其只有简短、唯一的正确答案,因此易于验证。使用 GAIA,只需将问题(及附带的证据,若有)零样本喂给一个 AI 助手即可。在 GAIA 上取得满分需要多样化的基础能力集合(见第 3.3 节)。我们在补充材料中提供问题及多种元数据。
设计选择。 GAIA 既源于对修订版 AI 基准的需求,也源于观察到的 LLM 评估的缺陷。
我们的第一条原则是瞄准那些概念上简单(尽管对人类可能繁琐)、但多样、扎根真实世界、且对当前 AI 系统有挑战性的问题。这使我们能聚焦于基础能力,例如通过推理实现的快速适应、多模态理解,以及潜在多样的工具使用,而非专门化技能(Chollet, 2019)。这些问题通常在于从不同且多样的来源(如提供的文档或开放且变化着的网页)中查找并变换信息,以产出准确的答案。要回答上面的第一个示例问题(图 1),LLM 通常应当浏览网页找到一项研究,再查找正确的入组人数。这与那些对人类越来越难、和/或在纯文本或人工环境中运作的基准趋势相反。
我们的第二条原则是可解释性。数量有限、高度精选的问题使该基准比聚合型基准更易使用(Perlitz et al., 2023)。任务在概念上的简单性(人类成功率 92%)使用户易于理解模型的推理轨迹。对于图 1 的级别 1 问题,推理轨迹主要是查到正确的网站并报告正确的入组人数,这很容易核验。
我们的第三条原则是对记忆化的鲁棒性:GAIA 旨在比当前大多数基准更不可被博弈。要完成一项任务,系统必须规划并成功完成若干步骤,因为最终答案按设计不存在于当前预训练数据的纯文本中。准确率的提升反映的是系统的真实进步。由于其多样性和动作空间的大小,这些任务无法在不作弊(例如记忆标准答案)的情况下被暴力穷举。尽管意外的记忆化可能经由数据污染发生,但答案所需的精确度、它们在预训练数据中的缺席、以及检查推理轨迹的可能性,都缓解了这一风险。相比之下,多选题答案使污染评估变得困难,因为一个错误的推理轨迹仍可能碰对正确选项。即便在这些缓解措施之下仍发生灾难性记忆化,也可以按照我们在第 3.4 节提供的指南轻松构造新问题。
我们的最后一条原则是使用简便。我们的任务是简单的提示,可能附带一个额外文件。至关重要的是,我们问题的答案是事实型的、简洁且无歧义的。这些性质允许简单、快速、事实性的评估。我们的问题旨在被零样本回答,从而限制评测设定的影响。相反,许多 LLM 基准的评估对实验设定敏感,例如提示的数量与性质(Liang et al., 2022b)(第 8.2 节),或基准的实现方式。
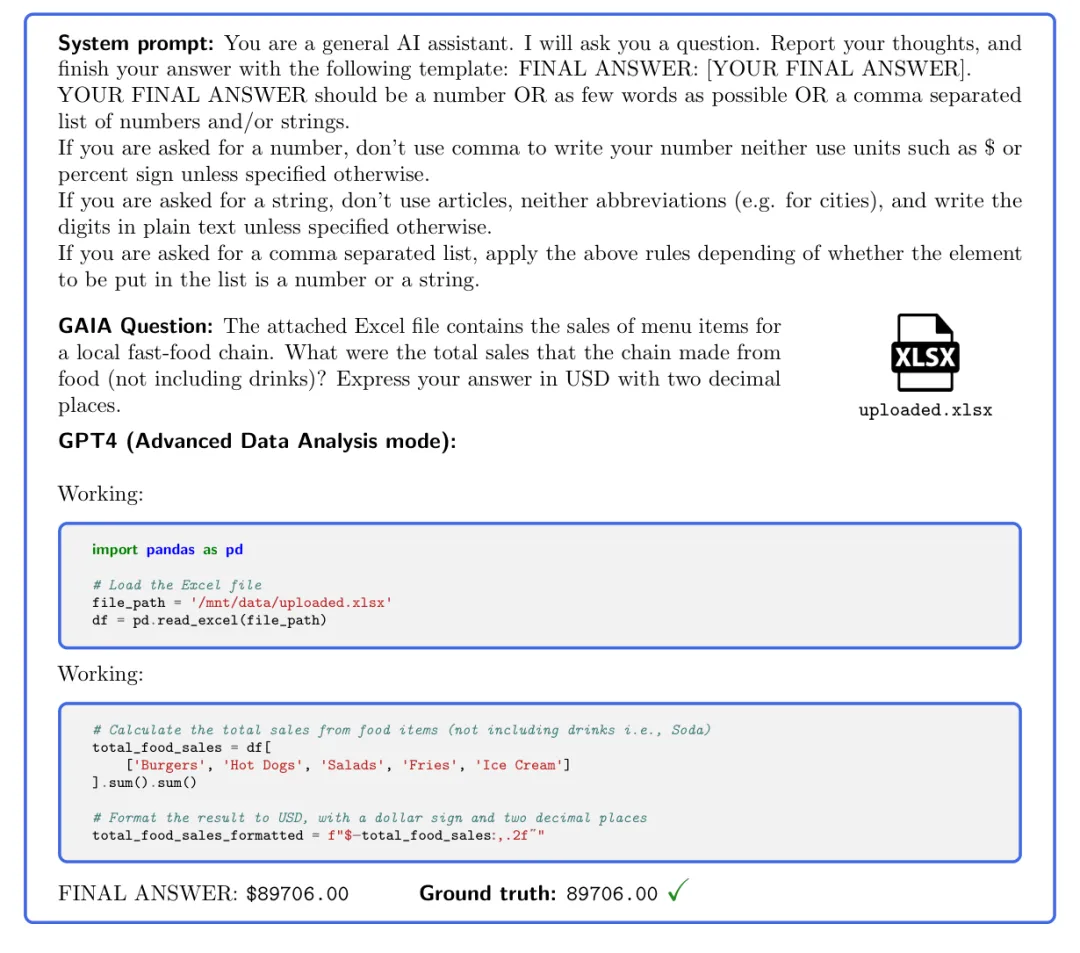
图 2:要回答 GAIA,一个像 GPT-4 这样的 AI 助手(此处装备了代码解释器)需要完成几个步骤,可能使用工具或读取文件。
3.2 评估
GAIA 的设计使评估是自动化、快速且事实性的。实践中,除非另有说明,每个问题要求的答案要么是一个字符串(一个或几个词)、一个数字,要么是一个以逗号分隔的字符串或浮点数列表。只有一个正确答案。因此,评估通过模型答案与标准答案之间的准精确匹配完成(在某种与标准答案"类型"挂钩的归一化之下)。使用一个系统(前缀)提示告知模型所需格式,见图 2。实践中,GPT-4 水平的模型能轻松遵循我们的格式。我们随排行榜一并提供评分函数。
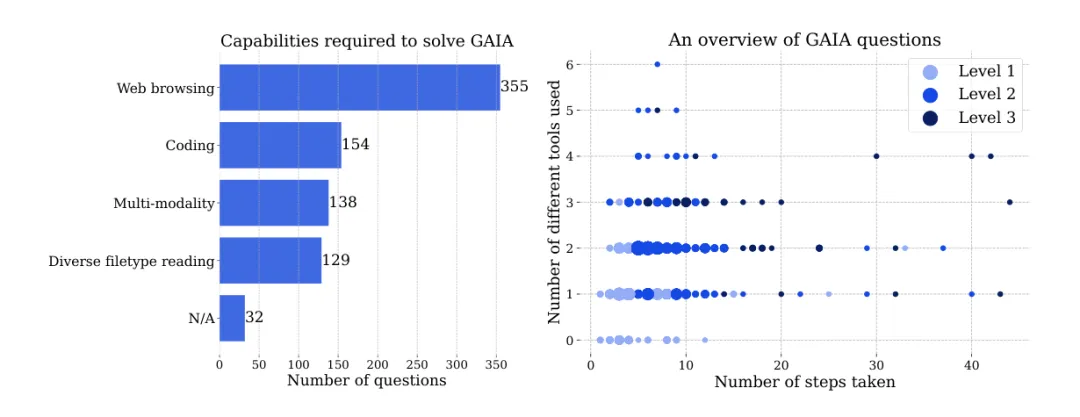
图 3:左:每个能力上,至少需要该能力才能解决的问题数量。右:每个点对应一个 GAIA 问题。在同一位置上,点的大小与问题数量成正比;为可读起见,只显示问题数最多的级别。两图均基于人类标注者回答问题时报告的信息,AI 系统的做法可能不同。
3.3 GAIA 的构成
本小节深入介绍我们为 GAIA 设计的 466 个问题的构成。
能力覆盖。 在 GAIA 上取得满分需要高级推理、多模态理解、编程能力以及通常意义的工具使用(例如网页浏览),我们在附录 C 中给出更精确的定义。我们还包含需要处理多种数据模态的问题,例如 PDF、电子表格,也有图片、视频或音频,其分布见附录 C(图 6)。图 3(左)是这些能力的概览:需要网页浏览的问题有 355 个,编程 154 个,多模态 138 个,多样文件类型读取 129 个,无需增强工具(N/A)的 32 个。尽管网页浏览是 GAIA 的关键组成部分,我们并不要求助手在网站上执行"点击"之外的动作,例如上传文件、发表评论或预订会议。在真实环境中测试这些能力同时避免骚扰网站,需要审慎考虑,我们把它留给未来工作,并请读者参考近期提出面向 LLM 智能体封闭环境的工作(Liu et al., 2023a)。我们没有提供解题所需能力的更详细清单,因为大多数问题都可以通过不同能力组合同样好地解决。例如,某条证据可能已被助手 LLM 妥善记住,也可能通过网页搜索检索到。特别地,我们不提供 LLM 工具使用的细粒度基准测试,读者可参考 Xu et al. (2023b); Li et al. (2023c)。
难度递增。 问题按难度递增分为三个级别,依据是解题所需的步骤数以及答题所需不同工具的数量。"步骤"和"工具"自然没有唯一定义,回答一个给定问题也可能有许多路径。因此,我们以标注者构造问题时所用的步骤数和工具数作为代理。图 3(右)沿这两个轴展示了问题分布。工具总是与一种或多种能力相关(见附录 C)。我们粗略使用如下定义为问题指定级别:
•级别 1 的问题通常不需要工具,或至多一个工具,且不超过 5 步。
•级别 2 的问题通常涉及更多步骤,大致在 5 到 10 步之间,且需要组合不同工具。
•级别 3 是面向近乎完美的通用助手的问题,需要任意长的动作序列、使用任意数量的工具,以及对世界的一般性访问。
图 1 给出了这些级别的示例。这些定义并非硬性约束:例如,一个标注者步骤少于 10 步但需要复杂网页导航的问题可能被归为级别 3 而非 2。我们在第 4 节验证了这一难度定义。
所需能力的分布。 GAIA 在瞄准真实世界助手问题的同时,也包含可能惠及身体障碍者的任务,例如在一个小音频文件中查找一条信息。最后,我们尽力覆盖多样的主题领域与文化,尽管数据集的语言仅限英语(见第 6 节)。
3.4 构建与扩展 GAIA
本小节深入介绍我们的问题设计与标注流程。特别地,我们讨论其中的一些挑战,希望我们的经验能帮助社区在 GAIA 之上继续构建。
构造问题。 我们的问题由人类创建⁵,旨在反映 AI 助手的真实使用场景。作者设计了初始问题,并把它们作为示例连同说明(见附录 D)交给标注者以创建更多问题。问题基于一个或多个"真相来源"(source of truth),且真相来源常在问题中被指明以避免歧义。真相来源的例子是不太可能很快消失的可信网页,例如 Wikipedia、Papers With Code 或 arXiv。其他情况下,真相来源随问题完整提供,例如一份附加文档。最后一种情况是自足的问题,例如一个小谜题。我们不指定固定的真相来源清单,以保证问题的多样性并避免记忆化。除谜题外,大多数问题都是通过查找并(可能)组合来自不同真相来源的信息以产出特定答案而创建的。问题创建后还会被标注,即问题创建者提供答案以及元数据:需要哪些工具、走了哪些步骤、答题花了多少时间。典型的标注结果见表 1(附录 C)。
⁵ 更准确地说,这是我们的团队与来自 Surge AI 的受偿标注者之间的合作。
验证问题。 与构造问题相关的大部分工作在于确保问题无歧义,即只有一个正确答案。这一性质允许快速而事实性的评估,因此维护它至关重要。歧义可能很微妙,问题创建者很少能显而易见地察觉。例如,如果问题没有指明网页的版本,而回答所需的信息在其他版本中不同,那么这个问题就有歧义。因此,我们请两名新标注者独立回答每个问题。如果原始标注者与两名新标注者得到相同答案,该问题即被验证通过。标注者意见不一的问题通常只需简单修复,否则就被移除。正因如此,在保持问题的趣味性和多样性的同时,问题的创建很难自动化。我们在表 3(附录 C)中报告了这一验证阶段的统计。68% 的问题直接合格,其余必须修正或移除。虽然问题在概念上简单,标注者仍可能犯无心之错:我们估计在所有难度级别上汇总的标注者成功率为 92%,并将其作为 GAIA 的人类分数报告。这接近满分,说明 GAIA 对非专业人员是简单的。我们估计创建一个问题(包括两名补充标注者的验证及潜在修复)需要两个小时的标注者时间。
依赖网页带来的挑战。 当真相来源托管在网页上时,设计问题可能很棘手。第一,证据可能随时间变化。例如,Wikipedia 条目可能在问题创建之时与问题被提交给 AI 助手之时之间被更新,可能删掉回答所需的证据。对这类问题,指明证据的版本(例如页面日期)通常很重要。实践中,我们发现基准对这类变化是鲁棒的,因为我们尽量依赖可能经受时间考验的证据。第二,一些网站所有者希望通过 robots.txt 文件阻止机器人访问其网站的部分或全部内容。虽然这更是一种请求而非约束,但遵守它显然是可取的。例如,OpenAI 为希望禁止 GPT-4 访问的网站所有者提供了如何相应修改 robots.txt 的说明。因此,我们会核实托管证据的网站部分未被限制访问。
4 LLM 在 GAIA 上的结果
用 GAIA 评估 LLM 只需要能够提示模型,即 API 访问。我们在向模型提问之前使用一个前缀提示。为便于答案抽取,我们在前缀提示中规定格式,见图 2。我们评估了 GPT-4(OpenAI, 2023)——带插件与不带插件两种情况——以及以 GPT-4 为后端的 AutoGPT。GPT-4 目前需要手动选择插件(见下一段)。相反,AutoGPT 能够自动完成这一选择。我们的非 LLM 基线是人类标注者和网页搜索。对于后者,我们把问题键入搜索引擎,检查答案能否从第一页结果中推得。这使我们能够评估我们问题的答案是否容易在网络上找到。只要有 API 可用,我们就把模型跑三次并报告平均结果。
GPT-4 插件。 与 GPT-4 不同,目前带插件的 GPT-4 没有 API,我们只能求助于手动 ChatGPT 查询。在写作本文时,用户必须在"高级数据分析"模式(Advanced Data Analysis,具备代码执行和文件读取能力)与至多三个第三方插件的组合之间手动选择。我们要么使用前者,要么根据对任务所需最重要能力的最佳判断来选择第三方插件。我们常依赖:(i) 一个读取多种类型链接的工具,(ii) 一个网页浏览工具,(iii) 一个计算工具。遗憾的是,目前无法在一段时间内使用一组稳定的插件,因为插件经常在商店中变更或消失。类似地,GPT-4 的官方搜索工具曾因可能绕过付费墙而被移除,最近才被恢复。因此,我们给出的"GPT-4 + 插件"分数,是对 GPT-4 在拥有更稳定、自动选择的插件时潜力的"先知"(oracle)式估计,而非一个易于复现的结果。
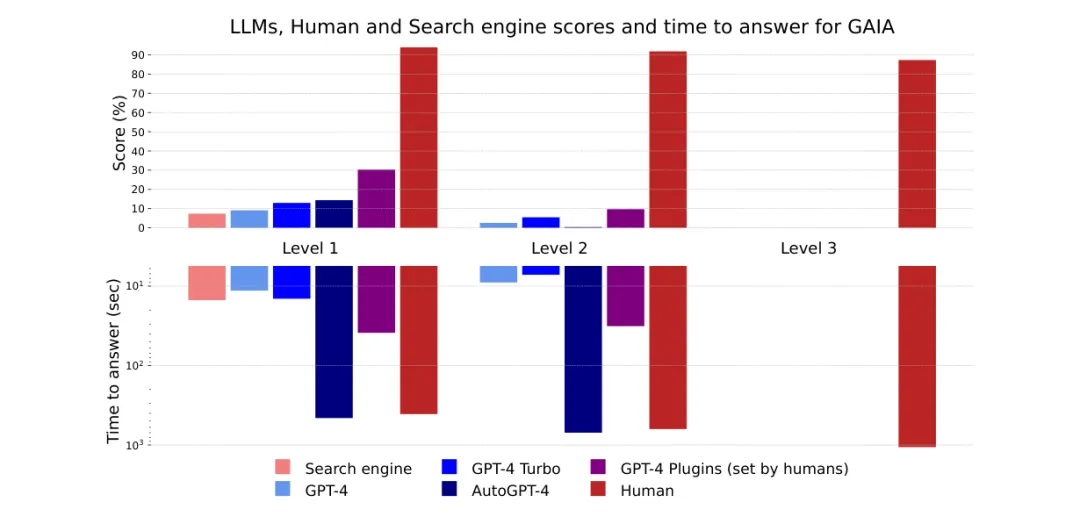
图 4:各方法与各级别的得分与答题时间。如正文所述,GPT-4 + 插件的分数应视为先知分数,因为插件是按问题手动挑选的。人类分数指我们的标注者在验证问题时的得分。
结果。 我们的评估见图 4,更多细节见表 4(附录 D.1)。我们提议的难度级别——以步骤数和使用的不同能力数量粗略定义——与当前模型的性能相关,这增强了其有效性。人类在所有级别上都表现出色,而当前最强的 LLM 表现很差。总体而言,GAIA 能够清晰地为有能力的助手排序,同时在未来数月甚至数年内留有巨大的改进空间。
人类网页搜索可能返回能从中推出正确答案的文本结果(对级别 1 有效),但对稍微复杂一点的查询就不管用了;而且由于用户必须浏览第一页搜索结果,它也比典型的 LLM 助手略慢。这证实了 LLM 助手作为搜索引擎竞争者的潜力。
GPT-4 无插件的结果与其他方法之间的差距表明,通过工具 API 或网络访问来增强 LLM 能提高答案准确率,并开启许多新的使用场景,证实了这一研究方向的巨大潜力。特别地,GPT-4 + 插件展现出诸如结果不满意时的回溯或查询改写等行为,以及相对长的计划执行。我们在附录 D.1 给出这类行为的示例。它与人类之间的差距则说明,要完全释放这一潜力还需要多少工作。
AutoGPT-4 允许 GPT-4 自动使用工具,但它给出的结果令人失望:与不带插件的 GPT-4 相比,级别 2 甚至级别 1 的结果都更差。这一差距可能源于 AutoGPT-4 依赖 GPT-4 API 的方式(提示与生成参数),需要在不久的将来重新评估。AutoGPT-4 也比其他 LLM 慢。总体而言,到目前为止,人类与带插件的 GPT-4 的协作似乎提供了得分与所需时间之间的最佳比值。
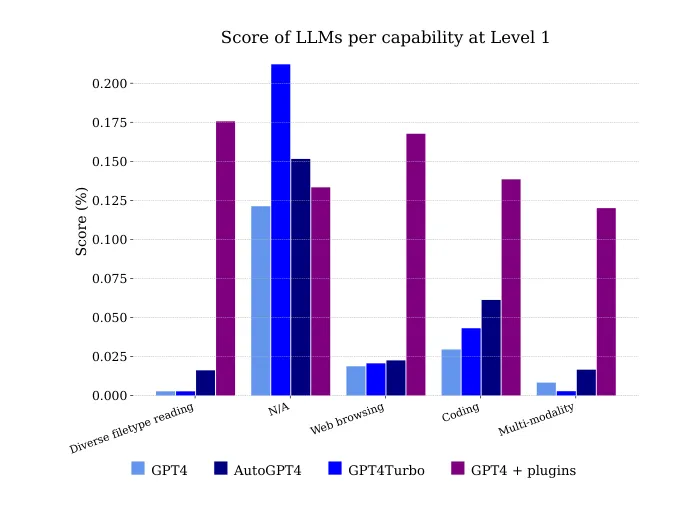
图 5:各 LLM 在级别 1 按能力划分的得分。非工具型模型在"多样文件类型读取"和"多模态"上的非零分数,源于部分任务可以不用标注者所用的方式解决。非工具型模型在网页浏览上的非零分数,主要源于对完成中间步骤所需信息的正确记忆。
图 5 展示了各模型按能力划分的得分。不出所料,GPT-4 无法处理文件与多模态,但仍能解出一些标注者使用网页浏览的问题,主要因为它恰当地记住了需要组合起来才能得到答案的信息片段。
5 讨论
设计 GAIA 促使我们思考 AI 系统评估的当前与未来范式。
闭源助手的可复现性。 被封闭在 API 背后的模型能力可能随时间变化(Chen et al., 2023),使某一时间点完成的评估不可复现。问题可能更严重:例如,ChatGPT 插件及其能力定期变化,且尚不能通过 ChatGPT 的 API 访问。由于静态基准可能消失、让位于因依赖真实世界而随时间衰减的基准,可复现性可能变得更加难以捉摸。不过,GAIA 对生成 token 的随机性是鲁棒的,因为只有最终答案(只有一个正确响应)被评估。
静态基准与动态基准。 与其他复杂的专家数据集一样,GAIA 目前附有数百个经过精心筛选和挑选的问题。相比之下,更庞大的基准如 MMLU 接近 15,000 题。然而,MMLU 由多选题构成,因此看起来比我们的开放式问题容易。只有唯一正确答案的问题需要精心呵护,我们宁可重质不重量。此外,我们希望我们关于问题设计的见解能帮助社区添加更多问题。GAIA 确实可能随时间衰减,或经由 (i) 预训练数据的灾难性污染,或 (ii) 回答问题所需的某些信息从网络上消失。我们有信心,我们为这些问题提供的各种缓解措施将帮助 GAIA 保持其价值,直到它被解决。静态基准是正在形成中的坏基准,让 GAIA 逐年演化——移除失效问题、添加新问题——可能是更好地评估 AI 系统泛化性与鲁棒性的重要组成部分。
迈向生成模型的统一评估。 许多 GAIA 任务可能通过调用可能出错的模块来解决,例如返回错误标签的图像分类器。有人可能认为这使得评估有歧义,因为它把系统当作整体考量,不把错误归因于子部分,例如网页浏览或视觉模块。然而,对于文本理解之外的每个任务都把 LLM 与外部工具耦合的范式可能不会长久。例如,未来的模型可能趋向于 LLM 与其他能力之间更紧密的整合,就像视觉-语言模型那样(Alayrac et al., 2022; Laurençon et al., 2023)。GAIA 的目标是评估 AI 系统,而非当前的架构标准。更一般地,对复杂生成的自动、事实性且可解释的评估是生成式 AI 的一个长期问题,另一个重要例子是图像(Stein et al., 2023)。Hu et al. (2023) 在该方向上迈进了一步,但仍依赖基于模型的评估和简单问题。向前看,多模态系统与 GAIA 的结合可能进一步改进对高级生成模型(例如图像生成器)的评估:通过要求一个复杂的图像修改序列,并用自然语言就最终图像提出一个无歧义的问题。只有当模型对原始图像正确施加了所有修改,答案才能被找到。
部分自动化与完全自动化。 部分自动化仍然需要人类在环,而完全自动化完全消除了这一需求。分别允许部分自动化与完全自动化的系统,在给定任务上的错误率可以只差几个百分点——比如前者 1%、后者 0%——却对应两种根本不同的范式。完全自动化是深度学习一直奋斗的目标,但迄今未完全成功:尽管在诸多领域取得最先进的结果,大多数基于神经网络的系统可能在不可预测的时刻失败(例如在常见场景中),这阻碍了自动驾驶汽车等技术的到来。解决 GAIA 需要完全自动化,因为答案不允许任何近似。更多人类活动的完全自动化将重塑我们的社会经济格局(Growiec, 2022),并带来新增价值主要被技术所有者而非人类劳动者攫取的风险。这是支持开源的一个有理有据的论点。
6 局限性
尽管 GAIA 试图规避当前 LLM 基准的陷阱,一些局限仍然存在。
缺失的评估维度。 在当前形式下,GAIA 不评估通向答案的轨迹。事实上,与唯一的标准答案不同,不同路径都可能通向正确答案,而没有显而易见的简单办法为这些路径打分——我们优先考虑了 GAIA 的易用性。向前看,人类评估与基于模型的评估(虽有局限)是评估计划(plan)的有趣选项,而且可能相当方便,因为 (i) 我们的问题很少需要专家知识,从而减轻了寻找专业标注者的需要;(ii) 裁判可以依赖标准答案:验证往往比独立推导答案更快。我们把人类与基于模型评估的加入留给未来工作。最后,我们只评估了拥有工具、因而能获得有意义分数的最强可用 LLM。然而,OpenAI 的 API 尚不提供工具调用的详细日志,而这正是细粒度分析所需要的。我们期待加入其他具备足够工具使用能力和日志的模型,尤其是开源模型。
设计无歧义问题的代价。 一个真实世界而又易用的基准,其代价是要确保问题无歧义。我们发现需要两轮标注:第一轮标注者尽最大努力设计一个无歧义的问题——这比例如为 RLHF 排序两个不同生成结果更花时间——然后由两名补充标注者独立回答该问题,必要时予以消歧。即便经过这样彻底的流程,仍可能残留歧义。然而,标注成本是固定的,且相对于多次不可信评估的潜在成本而言可能很小。一个问题对一台完全合乎逻辑的计算机可能有歧义,对人类却没有歧义:这不是问题,因为我们想要 AI 系统与人类偏好对齐。我们相信人类标注者目前对多样且扎根现实的问题不可或缺,相比之下程序化生成的问题则不然。Chollet (2019) 提出了类似的论点。不过,通过放宽无歧义约束,人们可以合成生成类 GAIA 数据,例如用于训练目的。此外,一些 GAIA 问题带有许多细节,因而显得不自然:这些细节确保问题只有一个正确答案,因而是必要的。实践中,用户会提出一个欠指定(under-specified)的问题,而有用的助手会通过引用其来源或保留最可信的来源来回答。两者都难以事实性地评估,我们把这一方面留给未来工作。
语言与文化多样性的缺失。 GAIA 的一大局限是语言多样性缺失:所有问题仅以"标准"英语提出,且许多问题主要依赖英文网页。因此,该基准无法验证助手对非英语使用者(占全球人口 80%)的有用性,也无法验证其在非英语网页内容(约占一半)上的有用性,更无法验证英语的任何方言变体。因此,GAIA 只是估计 AI 助手潜力的第一步,不应被视为其成功的绝对一般性证明。我们希望在未来工作或通过社区参与来填补这一空白。
7 致谢
作者感谢 Nicolas Usunier 建议了网页搜索基线,Edwin Chen 帮助我们改进面向标注者的这一不同寻常的协议,Yacine Jernite 分享了他在基准构建中关于多样性的见解,以及 Sasha Luccioni 花时间校对了我们写不好地道英语的一些章节。
参考阅读:
翼络智能体实验室
联系人:零点壹,微信号:punkt1