ARTICLE · 1383784
“平均数”的级数:从两道习题到幂平均级数
对一个数列反复取平均,通常会削弱局部波动。若正数列 xₙ 趋于 0,那么它前 n 项的算术平均数、几何平均数和调和平均数也都趋于 0。平均数保留了大尺度趋势,抹平了个别项的起伏。
那么一个自然的问题便是,当 Σxₙ收敛的时候,反映其性质的算术平均数、几何平均数和调和平均数的级数是否收敛?
这个问题来自谢惠民等老师《数学分析习题课讲义》中的两道习题。一道估计调和平均数,另一道估计几何平均数。本文就从这个问题出发,结合math stackexchange这个数学问题网站上面的相关讨论,谈论“平均数”级数的收敛性以及衍生的思考问题。
一、三种平均数级数
设 x₁, x₂, … 都是正数(为了使几何平均数以及调和平均数始终有定义,且将三者放在同一条件下考虑,本文只考虑严格正项级数的情况)。前 n 项的调和平均数、几何平均数和算术平均数分别记为
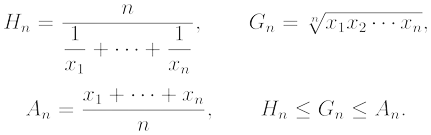
根据均值不等式,三个平均数自然成立这样的大小关系: Hₙ ≤ Gₙ ≤ Aₙ 。又这三个平均数都是正数,根据比较判别法,这三种级数的收敛性的命题本身具有强弱关系——如果ΣGₙ收敛,ΣHₙ自然也收敛,且收敛的值小于等于ΣGₙ的值;如果ΣGₙ发散,则ΣAₙ自然也发散。
下面我就来具体看看这三个平均数级数的收敛性如何。
1.1 算术平均数:一个始终成立的发散结论
不管 Σxₙ 是否收敛,都有
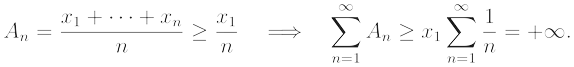
原因是前 n 项算术平均数始终保留着第一项 x₁>0 的贡献。把它除以 n 以后,得到的是调和级数的正数倍。后面的项无论怎样衰减,都无法消去这部分贡献。
所以,Σxₙ 收敛这个条件救不了 ΣAₙ。Math StackExchange 上的相关讨论也把这一点作为整个问题的起点:几何平均数与算术平均数之间隔着一层均值不等式,但这层不等式的方向对证明收敛没有帮助。Gₙ ≤ Aₙ 只能说明几何平均数的通项更小,至于小得是否足够,还需要新的估计。
1.2 另外两种平均数:两道习题给出的答案
统一改用上面的记号,我们最终得到的结论是
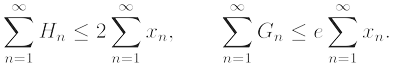
只要 Σxₙ 收敛,ΣHₙ 和 ΣGₙ 就都收敛。 除此以外,我们还能证明上面不等式中的2和e是最优的放缩常数。
1.3 Math StackExchange
经典问题网站 Math StackExchange 对调和平均数的级数问题有相当完备的讨论 The series Σn/(1/a₁+···+1/aₙ) is convergent。ziang chen 在 2013 年发布的原帖把问题拆成三部分:先证明收敛,再求最小常数 k,最后判断反向不等式是否存在正常数 l。这三问分别对应收敛性、最佳常数 2 和反向控制。
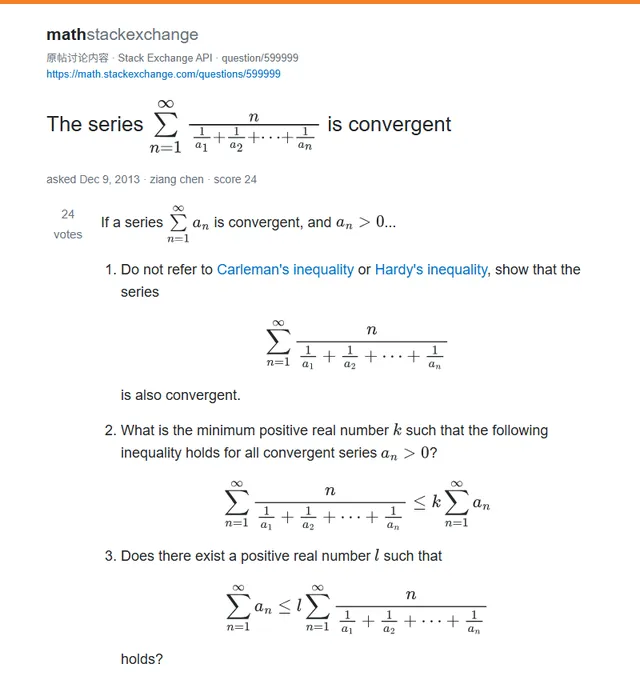
Julien 的采纳回答给出了常数 2 的 Cauchy 证明、最佳性以及反向构造。下面的论述和证明主要采纳的便是Julien的回答。
二、调和平均数
2.1 把倒数和变成可以加总的估计
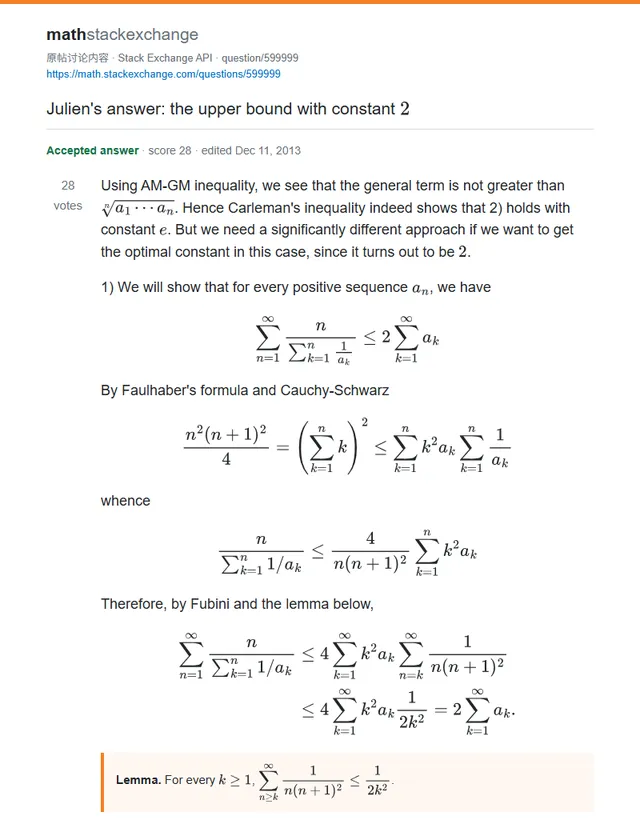
调和平均数带有倒数和,直接估计部分和并不方便。一个自然的想法是对分母利用Cauchy不等式放缩,但直接放缩精度太低,无法得到需要的结果。因此,我们给每一项带上一个权重,将调和平均数放缩为带权重的部分和
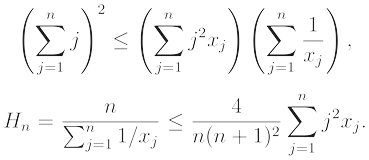
对 n 从 1 到 N 求和,并利用正项级数的可交换性交换两层求和的次序,得到
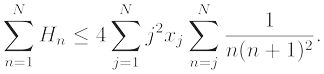
内层关于 n 的和可以用裂项控制:
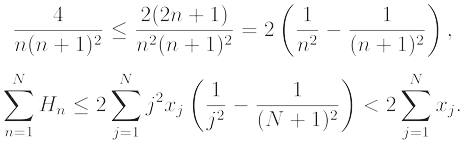
于是 j² 与 1/j² 相消,剩下
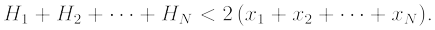
所以 ΣHₙ 收敛。证明只用到了 Cauchy 不等式、换序求和和裂项,常数 2 也在这个过程中自然出现。
Julien 在原帖中的证明与这里使用同一个 Cauchy 起点,并把尾部估计单独写成一个引理。讨论图里的 Fubini 指非负二重求和的换序,在这道有限项或正项级数问题中可以直接使用。
2.2 常数 2 不能再减小
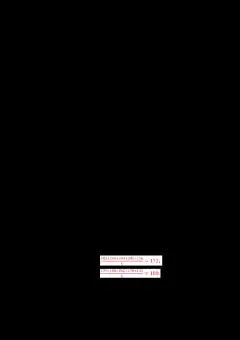
取 xⱼ = 1/j,前 n 项的调和平均数正好是
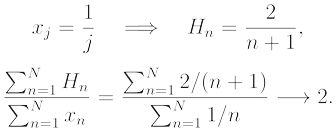
随着 N 增大,分子和分母都按对数增长,比值趋于 2。因此,任何适用于所有正数列的常数 C 都不能小于 2。
2.3 反方向没有统一的正比例控制
人们有时会在得到一个上界后继续寻找下界。既然调和平均数的级数可以被数列本身的级数控制,那有没有反过来的控制呢?也就是两者的收敛性是否等价呢?答案是否定的。这里不存在正常数 ℓ,能使 ΣHₙ ≥ ℓΣxₙ 对所有正数列成立。
取前 N−1 项都等于 1,最后一项取 M。前 N−1 个调和平均数都等于 1,而
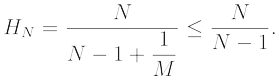
左边前 N 项调和平均数之和有与 M 无关的上界,右边前 N 项之和等于 N−1+M,却随 M 趋于无穷。两者的比值可以任意小,所以统一的反向不等式不存在。
这个构造里,最后一项的突增抬高了 Σxₙ,却几乎没有改变前 N 项的调和平均数,这也印证了我们开头说的,平均数可以很好的削弱某一项带来的影响。事实上,这种平均数的方法是非常普遍的,当原级数不一定很好的收敛的时候,取平均值以后再求和就有很有可能收敛。Cesaro求和与Fourier分析中的Fejer核都是类似的方法。
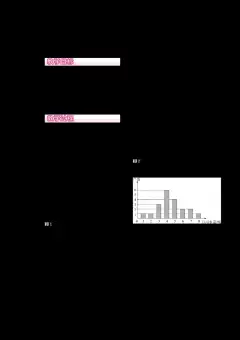
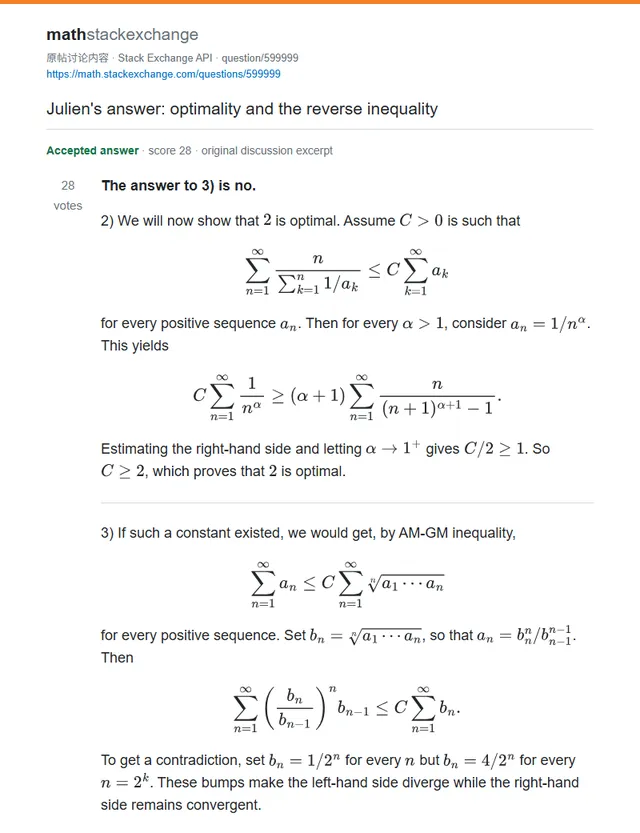
原帖对最佳性采用 aₙ 为 n 的 −α 次幂(α > 1),再令 α 趋于 1;反向问题则通过几何平均数代换,把反例归结为在一列稀疏位置放置突增。下面这张图保留了这两段讨论。本文前面使用 xₖ = 1/k 检验常数 2,两种检验的极限过程不同,结论一致。
三、几何平均数:Carleman 不等式
3.1 从乘积到加权和
几何平均数处理的是乘积。证明的第一步是人为配入权重 1, 2, …, n,再用普通的 AM–GM 不等式:
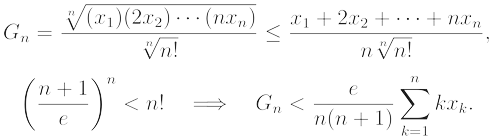
这里出现的 n! 需要单独处理。我们有初等估计
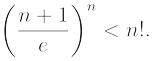
紧接着,我们便可以对有限部分和交换求和次序:
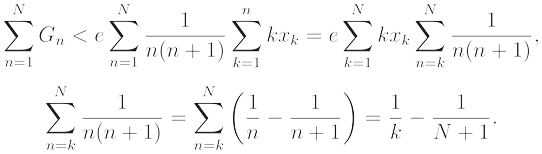
因此,我们就能得到
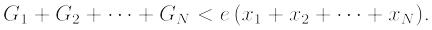
令 N 趋于无穷,就得到 Carleman 不等式
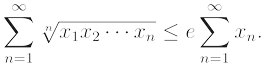
这条证明没有尝试逐项比较 Gₙ 与 xₙ。它先给 Gₙ 配上一组合适的权重,再把所有 n 放在一起计算。单看某一项时不明显的衰减,在换序以后变成了裂项和。
3.2 常数 e 也不能再减小
最佳性仍由截断的调和数列检验。取 xₖ = 1/k(k ≤ N),其余项取 0。由 Stirling 公式,
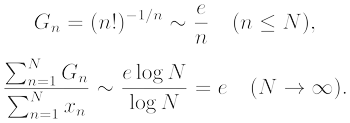
所以 ΣGₙ 与上界 eΣxₙ 的比值趋于 1。要求所有项严格为正时,可以用充分小且迅速衰减的正尾项逼近同一结论。
前面的初等证明实际上给出了严格不等式,因此非零正项级数不会取到等号。最佳常数表达的是一族数列对上界的逼近,并不要求某一个非零数列取到等号。
四、小结
回过头来看,几何平均数的收敛性因此覆盖了调和平均数的收敛性。而另一方面,调和平均数有自己的最佳常数 2,直接证明比经过 Carleman 不等式得到的常数 e 更准确。
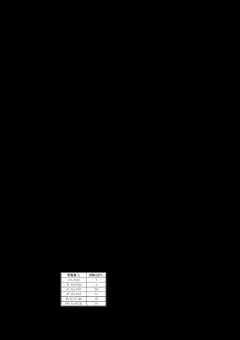
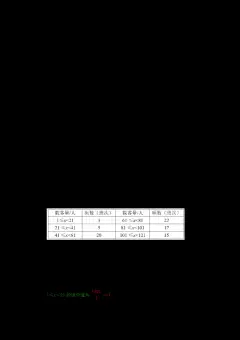
算术平均数则留在另一侧。对每个 n 都有 Gₙ ≤ Aₙ,但 ΣAₙ 总是发散。于是三种平均数形成了一个清楚的对照:
这张表提示,也许2 和 e 属于同一个公式。事实确实如此。
五、统一公式的证明:Hardy、Knopp 与 Carleman
我们将算术平均数,几何平均数,调和平均数可以作更一般的推广:对实数 p ≠ 0,定义前 n 项的 p 阶幂平均;p = 0 时取几何平均数作为连续延拓:
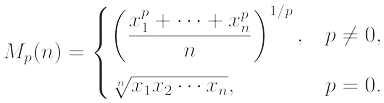
p = −1, 0, 1 分别对应 Hₙ, Gₙ, Aₙ。幂平均关于 p 单调递增,因此前面三种平均数的次序也纳入了同一个参数族。
Hardy、Landau、Knopp、Carleman 的工作可以统一写成下面的估计:
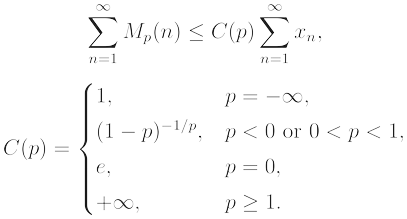
可以看到这个结论自然覆盖了我们前面得到的放缩常数2和e。下面把证明补齐。核心是 q > 1 时的 Hardy 不等式与 q < 0 时的 Knopp 不等式。两者可以共用一段凸性估计,只在最后分别使用 Hölder 不等式和反向 Hölder 不等式。
5.1 引理
设 aₙ > 0,αₙ 是 a₁, …, aₙ 的算术平均数。我们要证明
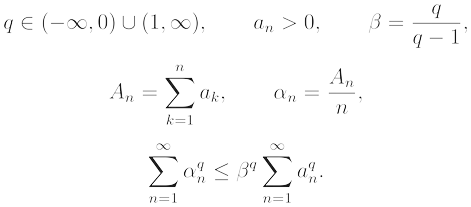
其中 q > 1 或 q < 0,β = q/(q−1)。这个常数与前面的 C(p) 看起来不同,下一小节做代换 q = 1/p 后就会一致。
记 α₀ = 0,则 nαₙ = (n−1)αₙ₋₁ + aₙ。函数 t 的 q 次幂在 t > 0 上是凸函数,切线估计给出
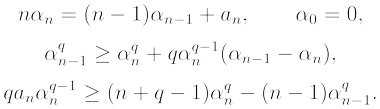
最后一行对 n 求和,右边发生裂项,得到
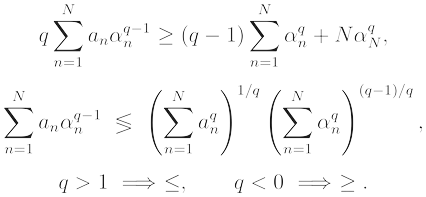
当 q > 1 时,对上面那个不等式左边的乘积和使用 Hölder 不等式;当 q < 0 时,使用反向 Hölder 不等式。把三种符号情形写在一起,可以统一整理为
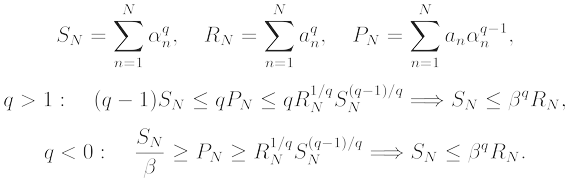
令 N 趋于无穷,引理得证。正负指数共用同一条凸性估计,Hölder 不等式的方向则随 q 改变。
5.2 引理中的常数也是最佳的
取 aₖ 为 k 的 −1/q 次幂。无论 q > 1 还是 q < 0,指数 −1/q 都大于 −1,因此可以用积分估计部分和的渐近阶:
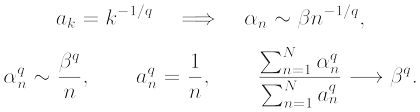
两边部分和都按 log N 增长,比值趋于 β 的 q 次幂。所以引理中的常数无法继续减小。
5.3 回到幂平均
在引理中令 q = 1/p,aₙ 为 xₙ 的 p 次幂。于是
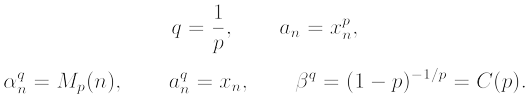
引理立刻变成 ∑Mₚ(n) ≤ C(p)∑xₙ,其中 p < 0 或 0 < p < 1。最佳性也有统一的检验数列。取 xₖ = 1/k,则
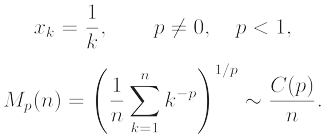
因此 ∑Mₚ(n) 与 C(p)∑xₙ 的部分和之比趋于 C(p)。前面分别出现的 2 和 e,在这里有了共同的检验来源。
其余参数逐一处理:
p = 0 时,第三节已经证明 Carleman 不等式及常数 e 的最佳性;它也与 p → 0 时 (1−p) 的 −1/p 次幂趋于 e 这件事相容。 p = −∞ 时,Mₚ(n) = min{x₁, …, xₙ} ≤ xₙ,所以常数 1 够用;数列单调递减时取等号,故它最佳。 p ≥ 1 时,Mₚ(n) ≥ Aₙ ≥ x₁/n,所以不存在有限的统一常数。 p = −1 时,C(−1) = 2;p → 0 时,C(p) → e。
这条统一公式把两道题放在了一条连续的分界线上。参数 p 从 −∞ 走向 0,最佳常数从 1 连续变化到 e;p 继续接近 1 时,常数不断增大;到达 p = 1,有限上界消失。
从历史看,Hardy 在 1920 年给出的相关估计尚未带有最佳常数,Landau、Knopp 和 Carleman 随后分别推进了不同参数范围的结果。Carleman 的原始工作与 1923 年赫尔辛基会议报告相关。今天把它们按幂平均的参数排列起来,原本分散的几条不等式就有了共同的形式。
六、写在最后
总的来说,我们从简单的两道题目出发,从仅仅考虑几个平均数的级数的收敛性,到讨论其精确的放缩常数,再到将平均数推广得到全局的统一公式,我们得到的结果也变得越来越强。
---完---
参考资料
谢惠民,恽自求,易法槐,钱定边:《数学分析习题课讲义》,第二、第三题相关内容。本文的题设与初等证明据此整理。 ziang chen, The series Σn/(1/a₁+···+1/aₙ) is convergent, Mathematics StackExchange, 2013;Julien 的采纳回答。本文三张网页讨论图及 2.3 节所述原帖构造据此整理。 Mathematics StackExchange: Inequality for harmonic means。其中收录了 Grahame Bennett 对 American Mathematical Monthly Problem 11145 的证明,以及常数 2 的最佳性讨论。 Mathematics StackExchange: Convergence of averging series。几何、调和、算术平均数级数的对照。 MathOverflow: What bounds the ratio of summed partial harmonic means to a sum?。调和平均数估计与 Hardy、Carleman 不等式的联系。 Zsolt Páles and Paweł Pasteczka, On the best Hardy constant for quasi-arithmetic means and homogeneous deviation means。引言给出了本文第五节采用的统一公式及历史文献。 John Duncan and Colin M. McGregor, Carleman's Inequality, The American Mathematical Monthly, 110(5), 2003, 424–431, DOI: 10.2307/3647829。 K. Knopp, Über Reihen mit positiven Gliedern, Journal of the London Mathematical Society, 3, 1928, 205–211。 G. H. Hardy, Note on a theorem of Hilbert, Mathematische Zeitschrift, 6, 1920, 314–317。 T. Carleman, Sur les fonctions quasi-analytiques, 第五届斯堪的纳维亚数学家大会报告,赫尔辛基,1923;会议录,181–196。