ARTICLE · 1137286
OpenAI 一次放出 722 篇数学手稿,多数未经验证
2026 年 10 月 7 日早上,OpenAI 在 GitHub 上开了一个叫 openai/math 的仓库,一次放出 722 篇数学手稿,归成 372 个结果族,覆盖数论、代数几何、理论计算机科学等 17 个方向。
这批手稿出自一个尚未发布的内部模型,仓库首页只有一次提交,提交者显示为 Anonymous,Contributors 一栏写着 No contributors,每篇论文的作者栏只有一个名字,OpenAI。
清单上有准黎曼猜想、唯一游戏猜想、马勒猜想这些名字。罗格斯大学的数学家 Alex Kontorovich 看过之后说,准黎曼那一项如果由人类做出来,够得上菲尔兹奖。
OpenAI 在仓库说明里交代了流程,模型在既有数学评测上已经"饱和",团队于是把评估范围扩到开放研究问题,整个过程投喂了约 4000 道题,输出按相关性归成结果族,再按一道"足够重要"的门槛筛一遍,留下这 372 族、722 篇。
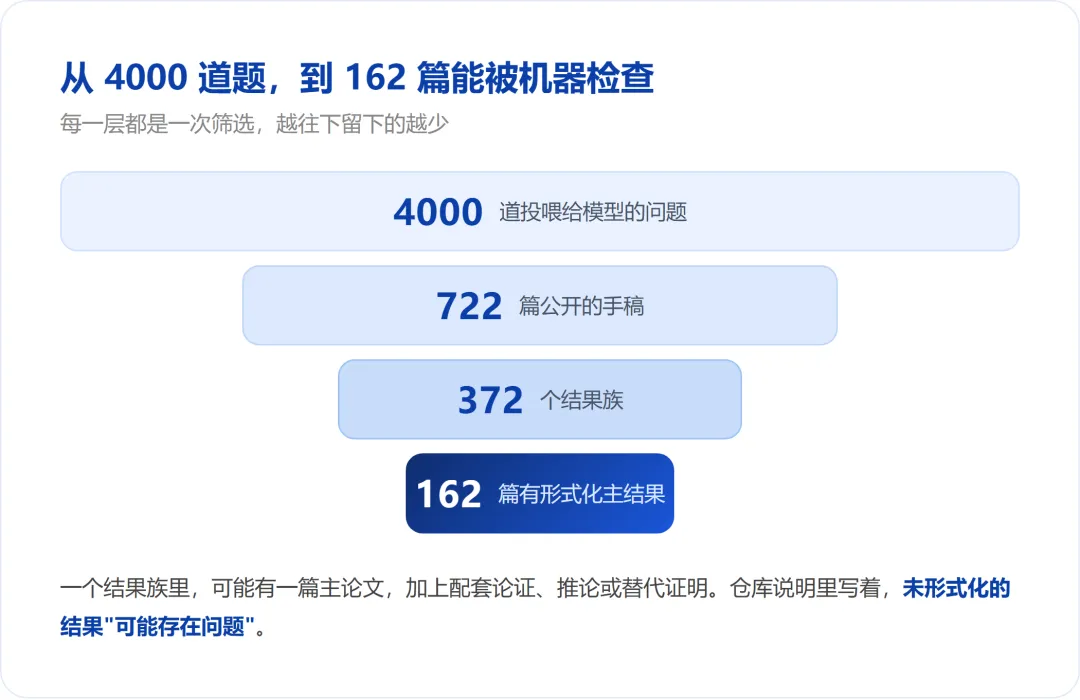
从 4000 道题到 372 个家族,挑选比大约是九个里留一个。手稿的文件夹名以日期结尾,721 篇的日期落在今年 9 月下旬到 10 月初这半个月里,最多的一天是今年 9 月 24 日,193 篇。
上个月那次和这次可以对照,2026 年 9 月,OpenAI 宣称内部模型解出纳维-斯托克斯方程,千禧年七大难题之一,当时用的是约 1 万个智能体并行跑了 88 小时,据 The Conversation 估算花掉约 1500 万美元。一个月之后,平均每个结果的门槛降到了相当于 ChatGPT Pro 思考三个小时。
722 篇里,162 篇有经过机器检查的主结果,73 篇只做了部分覆盖,剩下 487 篇除了 OpenAI 自己的判断之外没有别的核验。这三档数字来自仓库自带的那个形式化目录。
这里说的机器检查指的是 Lean,一种证明助手,把命题和证明写成有严格规则的代码,交给计算机逐行核对,证明不能靠一句"显然成立"糊过去。
它能保证的范围其实有限,Lean 核对的是证明与它拿到的那个陈述是否一致,而那个陈述有没有忠实于原本要解决的问题,仍然要人判断。康奈尔大学的数学家 Daniel Halpern-Leistner 正在做把自动形式化接进日常研究的工具,他说这件事现在非常紧迫,因为用自然语言写出来的论证正大量涌来。
仓库说明里还有一句,部分未形式化的结果"可能存在问题",会尽快修正,修订作为新版本记录,旧版本继续可查。
两个月前,OpenAI 以下一代模型 Astra 的名义放出 10 项数学与理论计算机成果;2026 年 9 月 8 日,它宣称解决了纳维-斯托克斯方程;三天后,25 位拿过数学界最高奖项菲尔兹奖的数学家联名发出一封公开信,批评把攻克名题当作模型评测目标,忽略了理解、引用和人才培养。这封信发出来不到一个月,722 篇就到了。
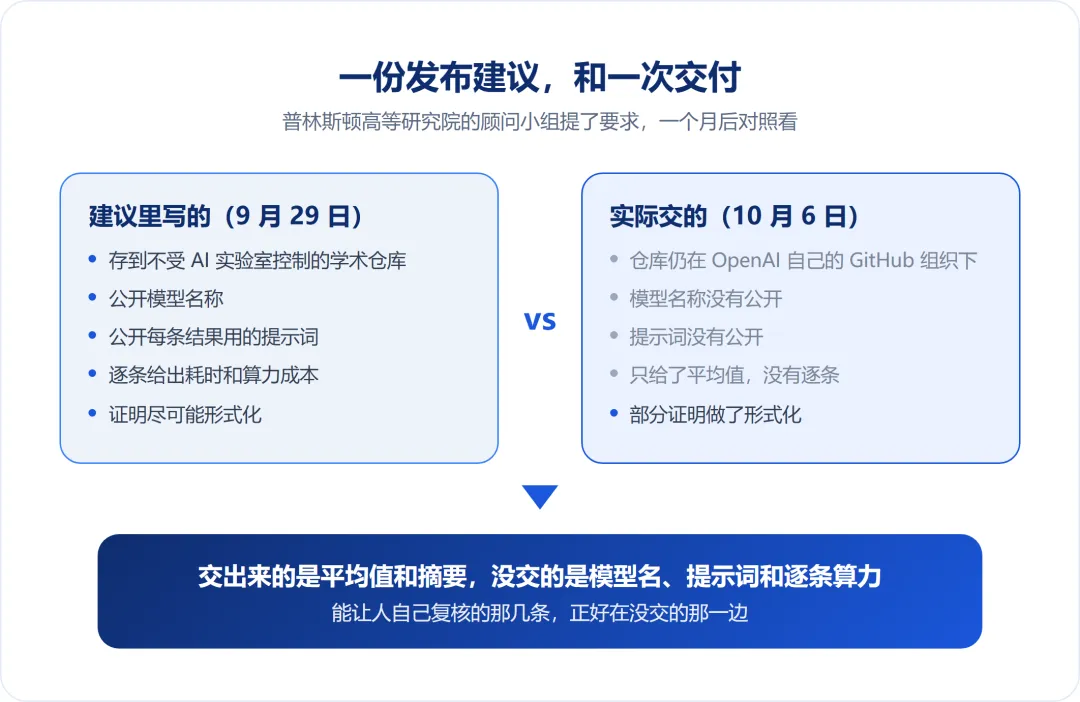
公开信之后,普林斯顿高等研究院成立了一个数学与人工智能顾问小组,简称 AGMAI,它不是评审方,管的是发布流程。
2026 年 9 月 29 日,这个小组给出的建议里,结果应当存到不受 AI 实验室控制的学术仓库,每条结果都要公开模型名称、使用的提示词、推理过程摘要、耗时和算力成本,证明尽可能形式化。建议里还有一句,该组不认可在专有模型上测试高等数学问题,要求相关公司停止这种做法。
一个月后,OpenAI 交出来的东西是算力平均值、投喂问题数、10 份推理摘要和部分形式化。模型名称没有,逐条提示词没有,逐条算力也没有,仓库仍然挂在自己的 GitHub 组织下面。
公司发言人对《科学美国人》说,OpenAI 不受这些建议约束。AGMAI 在同一天发了一份声明,提供建议不等于认可这批结果的产生过程。
剩下的事就只有读了,数学界要用几个月判断,这 372 族里哪些经得起推敲,哪些只是既有技巧的重新组合。陶哲轩在这批材料发布前后发帖,说这种做法是在"不可持续地收割"解法,一些还没被解出的方向因为怕被抢,已经不再公开。
产出这一侧可以并行堆出来,验证那一侧只能靠人一条条读,两边的时间尺度不一样。这批材料要花几个月才消化得完,而在它们被读完之前,下一批大概已经来了。