ARTICLE · 1229073
我做了个Excel数据体检Skill,AI的报告先出了错
一、我本来只想分析一份销售数据
我想找一份销售数据练练手,做点课程作业之外的真实分析。结果分析还没开始,先被数据整不会了。
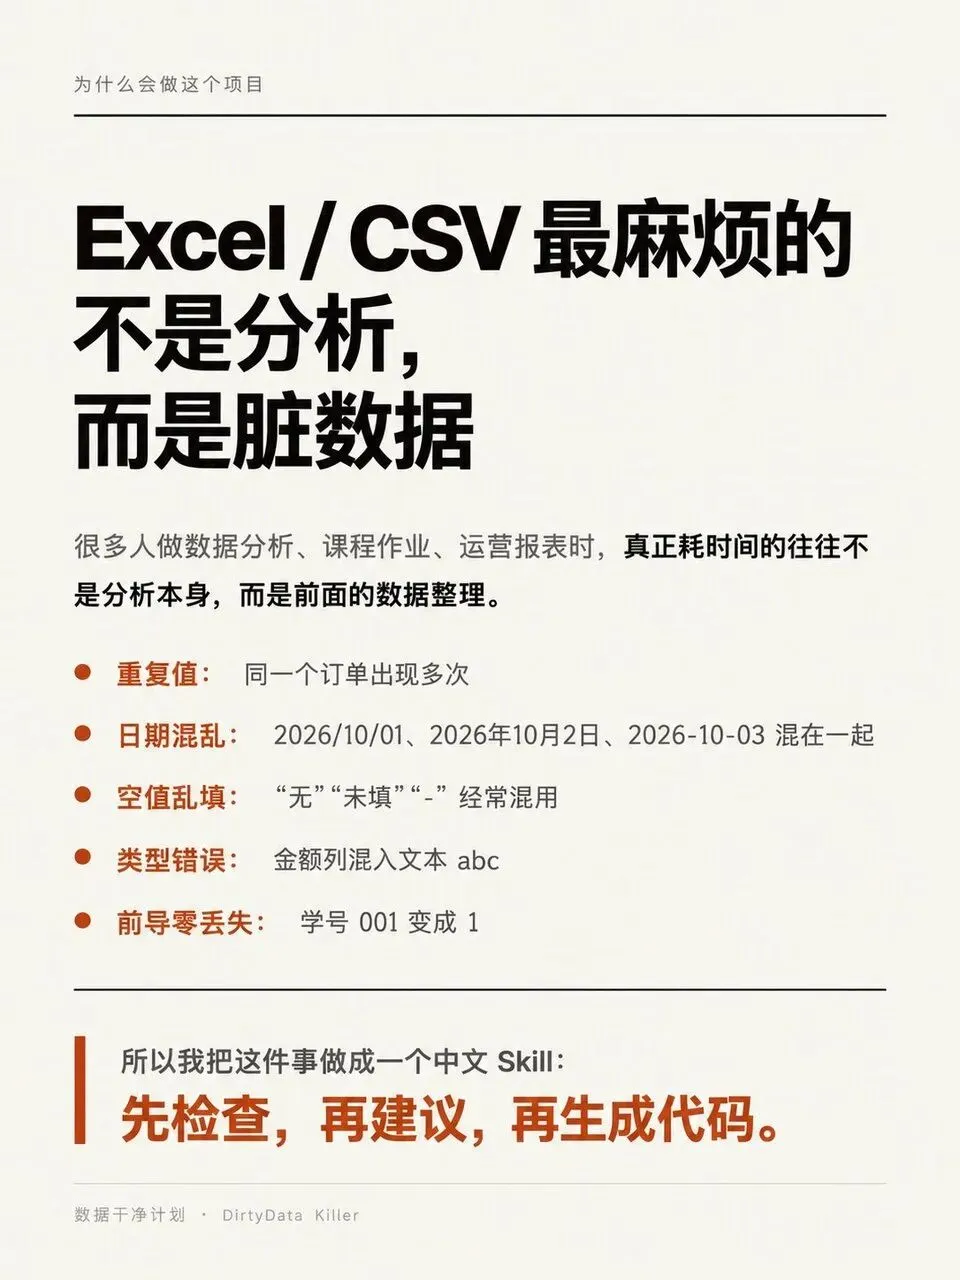
0002 香蕉 -10 2026年10月2日 退货0002 香蕉 abc 2026-10-03 录入错误0003 葡萄 0 2026-13-01 赠品十三月一号,这个日子我反正是没活过。后来我意识到,这不是我一个人的问题。
做课程作业要清洗成绩表,做问卷要处理“无”“未填”“-”混用的空值,帮社团整理报表要面对同一订单出现三次的表格。真正耗时间的从来不是分析,而是分析前面那一步:数据清洗。
于是我做了个决定:与其每次徒手捡脏数据,不如把这件事做成一个工具。它叫数据干净计划(DirtyData Killer)。
二、我把数据清洗拆成了三个Skill
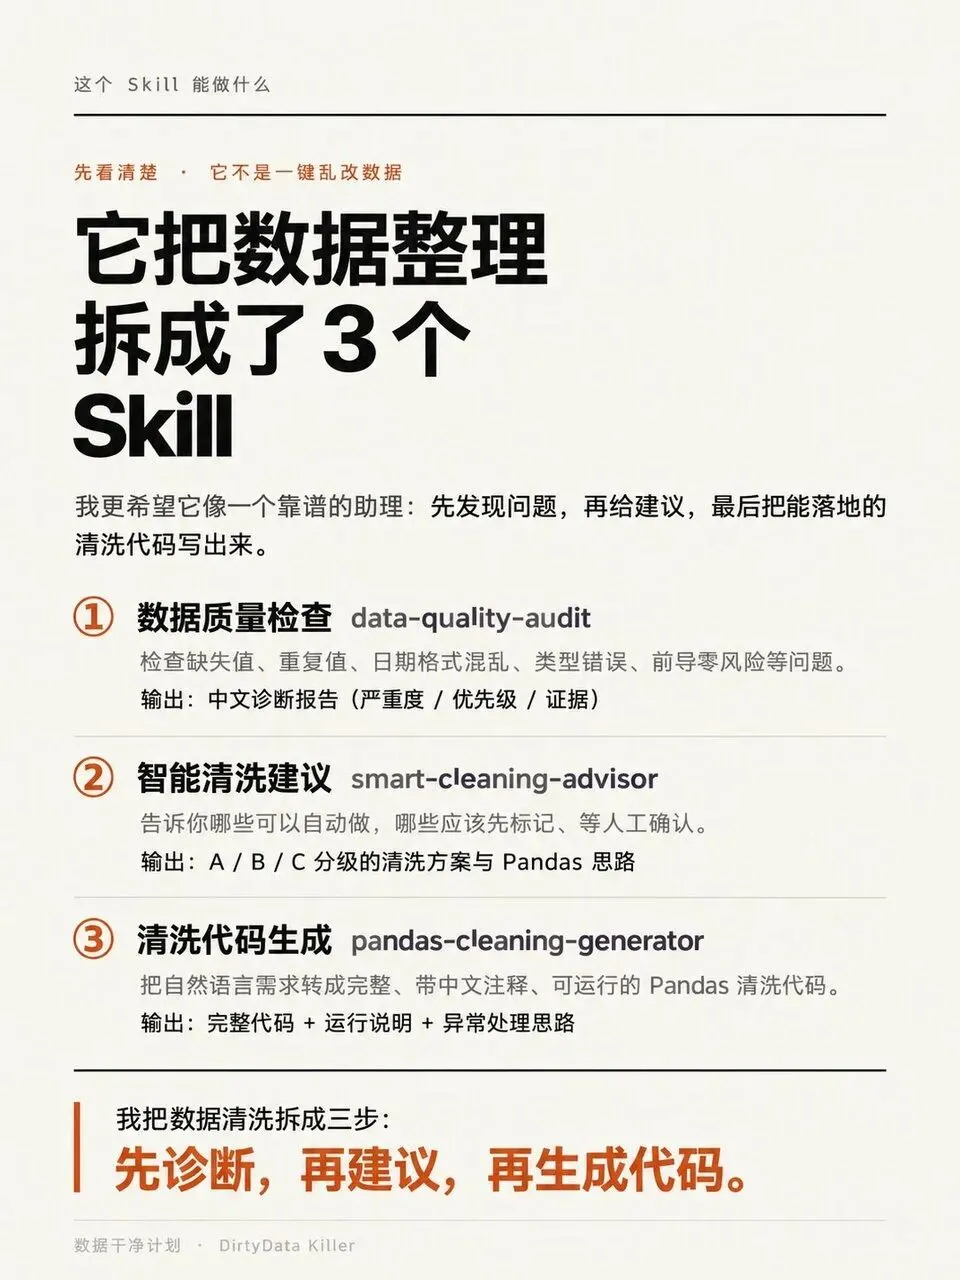
做的时候我想明白一件事:清洗数据不能一上来就改,得像医生看病一样,先检查、再开方、最后动手术。所以它不是一个“一键搞定”的黑盒,而是三个各管一段的Skill。
•︎ ① 数据质量检查(data-quality-audit):给它一份Excel或CSV,它输出中文诊断报告——有哪些问题、严重程度、优先级、证据在哪一行哪一列。
•︎ ② 智能清洗建议(smart-cleaning-advisor):告诉你哪些能自动处理、哪些要标记、哪些必须人工确认。金额 -10 且备注“退货”,它不会建议直接删掉。
•︎ ③ 清洗代码生成(pandas-cleaning-generator):用一句中文描述怎么洗,生成带中文注释、可直接跑的Pandas代码。
一句话概括:先诊断,再建议,再生成代码。
三、真实测试:AI的报告,自己先错了
我故意造了一份只有5条记录的电商销售测试数据——小而脏,问题密集,正好当“体检样本”。
第一版报告很快出来了,问题找得挺全。但核对时我发现一个矛盾:报告开头写着“共4条数据记录”,正文引用的却是CSV第6行。
4条记录,怎么会有第6行?表头占1行,5条数据正好是第2到第6行。我没放过这个细节,直接要求重新读取、重新复核。第二版修正为5条记录,还附了逐行核对表,并用三种独立方法交叉验证行数。
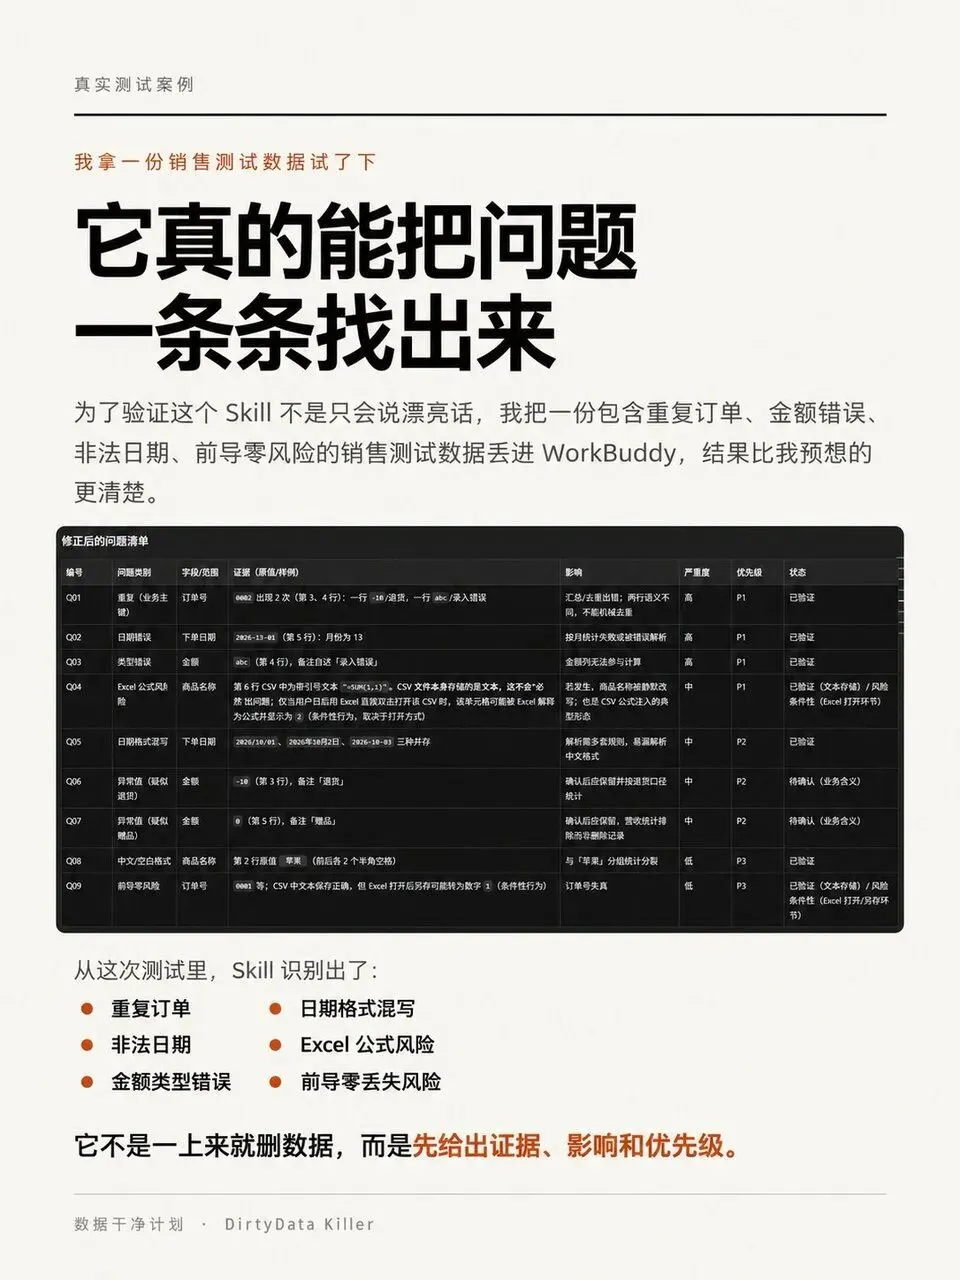
修正后的v2报告一共列出了9个问题,几个典型的:
•︎ 重复订单号 0002,两行语义不同,不能机械去重
•︎ 金额 abc,备注自己写着“录入错误”
•︎ 非法日期 2026-13-01
•︎ 三种日期格式混写:2026/10/01、2026年10月2日、2026-10-03
•︎ 商品名称“ 苹果 ”带首尾空格,分组统计会分裂
•︎ 商品名称是 =SUM(1,1) 文本,Excel直接打开有被当公式的风险
•︎ 订单号 0001 的前导零,Excel另存可能变成 1
这个插曲给我的触动,比9个问题本身更大。AI能帮你发现问题,但AI自己也会出错——这次它错在最不该错的地方:数数。所以我给项目定了几条铁律:保留原始值,先标记再确认,所有结论带证据、可复核。
数据清洗最怕自作聪明。看起来像错误的数据,也许只是业务含义没确认:-10 可能是退货,0 元可能是赠品,学号 001 不能变成 1。
四、项目已经开源了
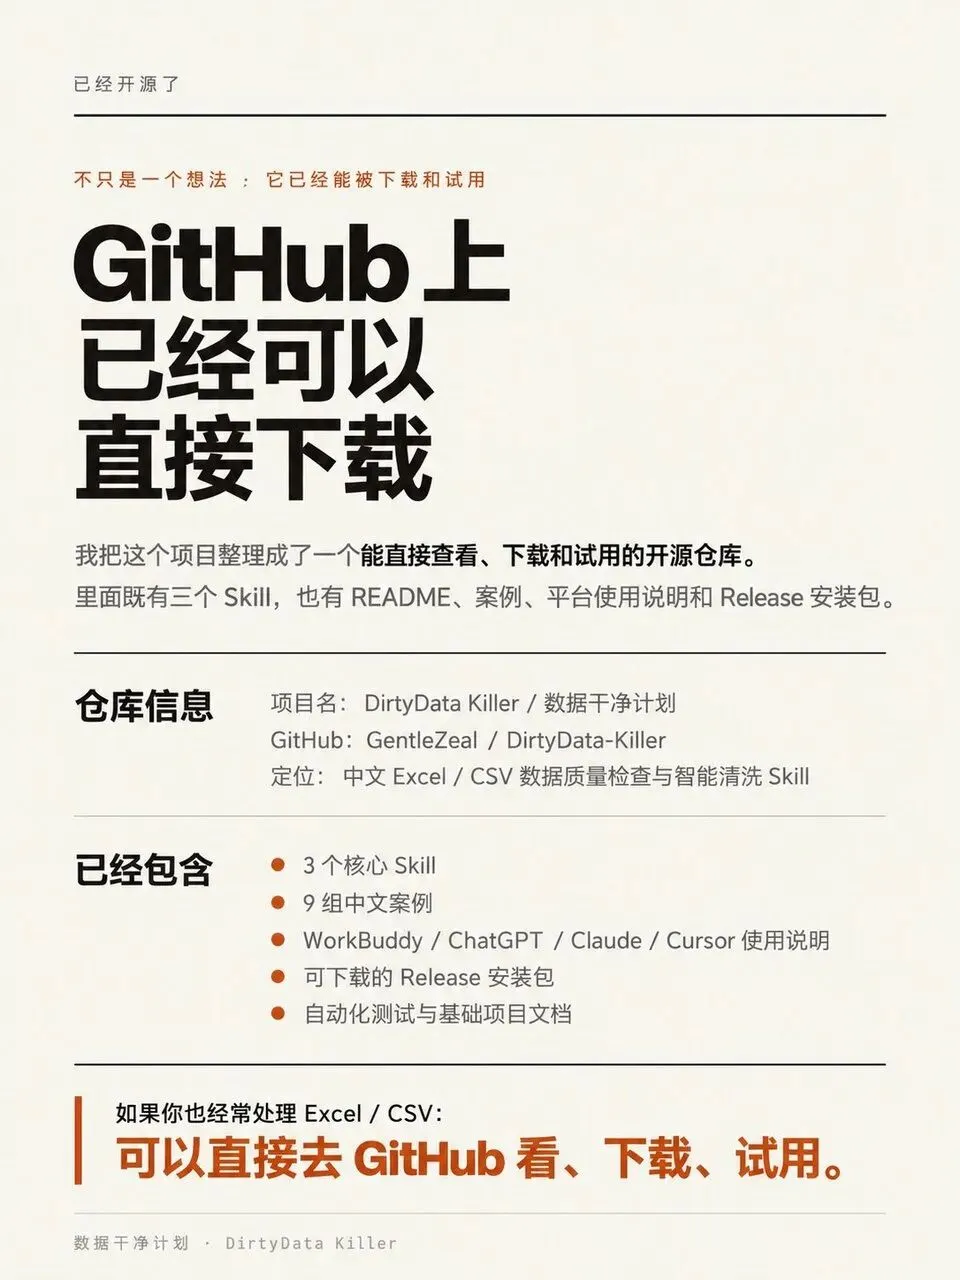
目前项目已发布 v0.1.0,仓库地址:https://github.com/GentleZeal/DirtyData-Killer
仓库里有三个核心Skill、9组中文使用案例、WorkBuddy / ChatGPT / Claude / Cursor 等平台的使用说明、一份可运行的Pandas销售数据清洗参考脚本、Release安装包和自动化测试。
想试用有两条路径:一是支持原生Skill安装的平台(WorkBuddy、Claude、Cursor等),按仓库里的平台文档安装;二是普通聊天AI,直接复制仓库中的Prompt来用。
需要说明的是,不同平台的能力和权限不一样,实际效果可能有差异,仓库文档里也写清楚了。README、examples、docs在根目录,安装包在Releases页面下载。
五、第一次开源,我学到了什么
•︎ 先解决真实问题,再考虑复杂技术。大而全的自动清洗系统大概率做不完,也做不准。
•︎ AI不等于绝对正确。数错行数这件事教会我:AI的输出也需要被审查,工具里必须留出人工确认的位置。
•︎ 数据清洗需要业务上下文。技术上 -10 是异常值,业务上它可能是一笔退货。
•︎ 用户能用起来,比功能多更重要。中文报告、中文注释、生活化例子,都是为了让初学者真的能用。
项目上线只是开始,后面还要靠反馈继续迭代。
六、接下来想做什么
这些都是计划中的方向,还没做完,先立个flag:覆盖更多中文真实场景(成绩单、问卷、运营报表);更完善的数据质量检查引擎;一个Streamlit可视化小助手;从Skill逐步升级为更完整的数据清洗Agent。
如果你也经常和Excel、CSV打交道,欢迎去仓库试用、提Issue,或者一起贡献。发现bug、觉得哪里不好用,都是对这个项目最好的帮助。