ARTICLE · 1328244
用 AI 处理表格和文档:别让它自由发挥,给它结构化出口
一、十四张表汇总,出来十四个样子
月底要做一次跨部门汇总。十四份出货表,字段名各写各的:有的叫数量,有的叫件数,有一张写的是 QTY。
我把它们全贴给 AI,让它汇总成一张总表。第一次的结果挺漂亮,表头齐、合计对,备注也全。
这十四份表我一份份开过。光看表头就花了四十分钟,其中三份是截图贴进 Excel 的,只能我自己敲。敲的时候我在想,这活要是每个月都来一次,我迟早得给它想个办法。
第二个月我照同样的话再跑一遍,出来的东西换了个长相:合计跑到最后一行去了,备注从单独一列变成了括号里的说明。
我没当回事,把结果粘进系统,报错。
那天下午我干的活不是分析数据,是让两份东西长得一样。
二、病根不在模型,在你没定义出口
我一开始以为是自己提示词不够狠。后来往里加了一堆"必须""务必""严格遵守格式",好一点,但没解决。
真正的问题是我从来没说清楚:这份东西下一步要被谁消费。
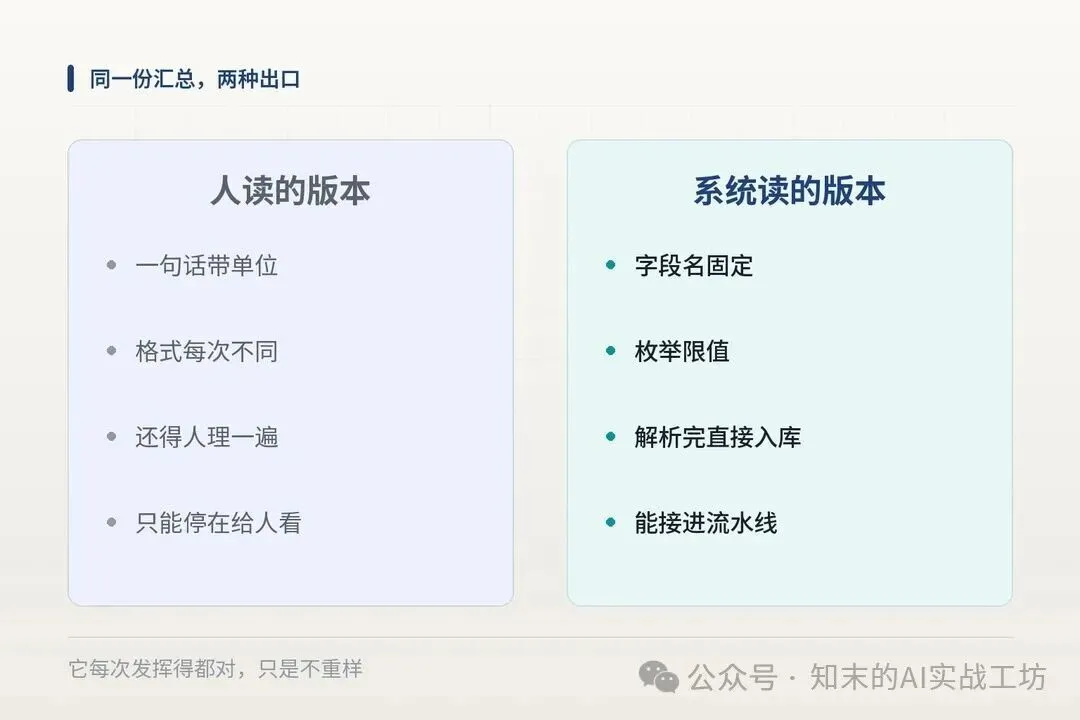
人读的东西格式松一点没关系,读的人会自动补齐。系统读的不行,它只认字段。
我让它自由发挥的时候,它每次发挥得都对,只是不重样。而业务系统要的恰恰是每次都一样。
举个具体的。同一份汇总,人读的版本是「本月共出货 1,240 件,金额约 86 万」。系统要的版本是两个字段,数量 1240,金额 862300.00。
前面那句读起来舒服,后面那组才能算。
我原来一直交的是前面那句,然后回头抱怨系统不好用。
这个差别听着小,代价很大:出口不稳,这份产出就只能停在"给人看"这一步,进不了任何一个自动流程。
三、先定结构,再让它干活
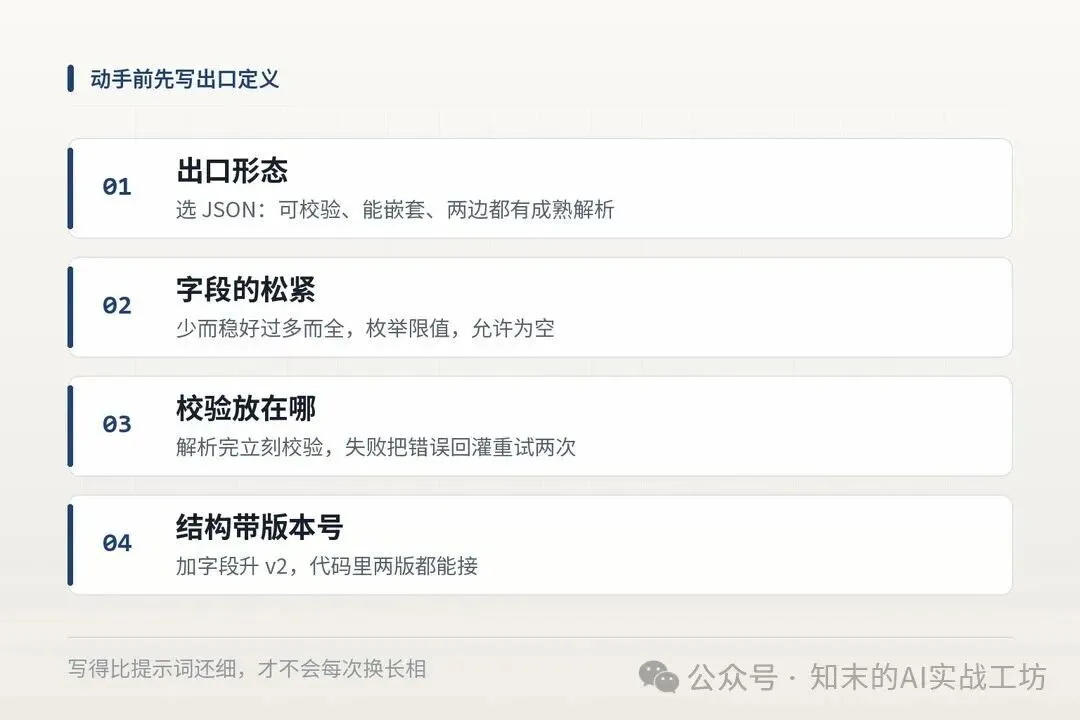
我改的做法是:动手前先写出口定义,写得比提示词还细。
三个决定,按顺序定。
第一,出口形态。我选 JSON,理由是可校验、能嵌套、两边语言都有成熟解析。排除掉的是 markdown 表格,人能看,解析起来脆,一行少个竖线就崩;也排除让它直接输出代码或 SQL,跑不了的东西我不敢往生产里放。
第二,字段的松紧。少而稳好过多而全。第一版我只定六个字段:来源文件、单号、数量、金额、币种、备注。币种用枚举,只允许三个值;备注允许为空。
第三,校验放在哪。解析失败不能靠人眼看。我把校验写成代码,失败就把错误原文回给模型重来一次,最多两次。第三次还失败,落一条待人工处理的记录,不硬猜。
顺手排除的还有 CSV。看着简单,可字段里只要出现逗号、换行或者中文引号,解析就得靠猜。JSON 有明确的转义规则,这一点省心。
还有一条经验:结构要带版本号。第一版我定了六个字段,第二个月业务要加一个到货日期,我升成 v2,代码里两版都能接。没版本号的时候,我只能祈祷所有调用处一起改。
字段名也踩过一次。我叫 qty,模型有时给 quantity,有时给 QTY。现在提示词里把字段名连大小写一起写死。
四、模板、代码,和一次真实的报错
模板骨架是这样,可以直接抄:
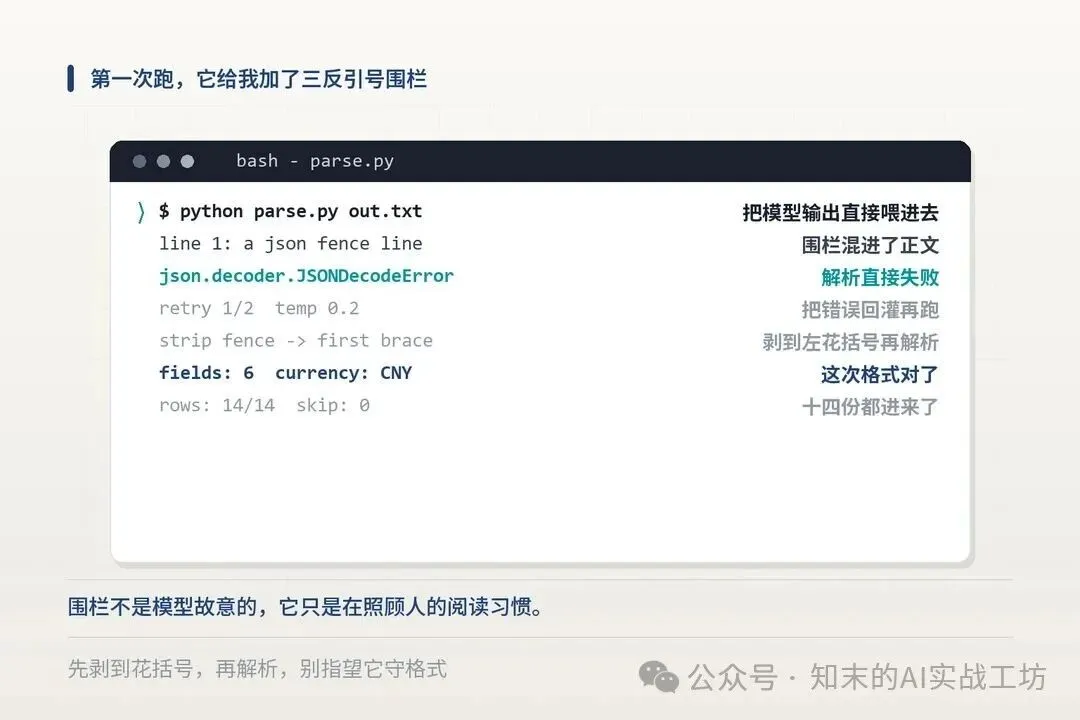
只输出一个 JSON 对象,不要解释,不要加代码块围栏。字段:source_file string 必填order_no string 必填qty number 必填,整数amount number 必填,两位小数currency enum CNY / USD / EURnote string 可为 null规则:数字不要千分位,不要写约多少拿不准的字段填 null,不要猜第一次跑,它给我的 JSON 前面加了一行 json 标记和三反引号围栏,解析直接失败。
我加了剥围栏这一步,两个栈写法一样:先找第一个左花括号和最后一个右花括号,中间那段才是 JSON。
.NET 这边用 System.Text.Json:
staticstringStripFence(string raw){int i = raw.IndexOf('{'), j = raw.LastIndexOf('}');if (i < 0 || j <= i) thrownew FormatException("no json body");return raw.Substring(i, j - i + 1);}var doc = JsonDocument.Parse(StripFence(raw));var orderNo = doc.RootElement.GetProperty("order_no").GetString();var qty = doc.RootElement.GetProperty("qty").GetInt32();Java 用 Jackson:
static String stripFence(String raw) {inti= raw.indexOf('{'), j = raw.lastIndexOf('}');if (i < 0 || j <= i) thrownewIllegalArgumentException("no json body");return raw.substring(i, j + 1);}varnode=newObjectMapper().readTree(stripFence(raw));varorderNo= node.get("order_no").asText();intqty= node.get("qty").asInt();解析只是第一道。第二道是字段校验:必填是否为空、枚举值在不在范围内、数量是不是正数、金额有没有超过两位小数。
校验的写法也就十几行:
var required = new[] { "source_file", "order_no", "qty", "amount", "currency" };foreach (var f in required)if (!doc.RootElement.TryGetProperty(f, outvar v) || v.ValueKind == JsonValueKind.Null)thrownew InvalidDataException($"missing {f}");var cur = doc.RootElement.GetProperty("currency").GetString();if (cur isnot ("CNY"or"USD"or"EUR"))thrownewInvalidDataException($"bad currency {cur}");varrequired= List.of("source_file", "order_no", "qty", "amount", "currency");for (var f : required) {if (!node.hasNonNull(f)) thrownewIllegalArgumentException("missing " + f);}varcur= node.get("currency").asText();if (!List.of("CNY", "USD", "EUR").contains(cur))thrownewIllegalArgumentException("bad currency " + cur);写完这两段,我就不用再肉眼比对了。收益在第二个月才显出来:同样的输入,能直接进系统的比例从八成多到接近全部,剩下那几条是真数据有问题,不是格式问题。
校验失败那次,我把错误拼成一句话,连同原文回给模型:字段 currency 的值「人民币」不在允许集合内。
第二次它就改成了 CNY。
这句回灌,比在提示词里加十个"必须"都管用。
重试的循环不长:跑一次,解析,校验,失败就把错误信息和原始输入一起塞回去再跑一次。每次重试把温度调低一点,随机性小了,格式反而更稳。
第三次还失败的那条就不硬跑了,写进一张待处理表,第二天上班人工看一眼。量不大,一个月两三条。
五、四个坑
第一个坑,长表被截断。有一张表三百多行,让它一次输出 JSON,末尾永远是断的。后来改成分片,每片五十行,各出一个小 JSON,最后在代码里合并。
合并有个前提:每片必须带自己的来源文件,否则拼回去你不知道哪行是哪张表的。这条我漏过一次,结果两张表的行混在一起,排了半天才发现。
第二个坑,合并单元格。给老板演示那次,第一张表跑通了,第二张直接报错。那张表有个合并单元格,解析出来少了两行。现在喂之前先规整成一行一条记录。
还有一类更常见:表尾带合计行。模型会把合计当成一条记录吃进去,数量翻倍。现在入口先把合计行认出来去掉。
第三个坑,数字里藏东西。千分位、约多少、多少左右,这三种写法我都收到过。千分位可以在提示词里禁掉,后两种只能靠校验拦。
金额更麻烦。有列写着 86.2 万,模型很老实地填了 862000,而我事先没定单位,差点多算一位。现在单位写进字段名里,叫 amount_cny。
第四个坑,把结构交给模型定。我试过让 AI 根据这份表设计输出字段,它设计出来的比表头还多,一半用不上。结构得自己定,因为它决定下游怎么用。
一条边界:只在"这份产出要给系统用"的时候做这件事。写文案、改语气、润色段落这类,人读就行,上 schema 是自找麻烦。
反过来也是一样。如果这份东西只给一个人看一次,为它设计六个字段,纯属给自己加活。
六、出口稳了,才谈得上接流程
它真正的用处,是把 AI 的产出变成一个能塞进流水线的零件。
我现在的规矩是:任何要进系统的产出,先有结构,再有提示词。
结构定下来之后,换模型、改提示词都不影响下游,因为出口没变。这一点在换模型的时候特别值钱。
下一步是把它接进流程:表格自动进、JSON 自动出、异常落一条待处理。这一步我在自己的个人 AI 工作台上已经跑起来了,怎么串是另一篇的事。
个人用不到这一步也行,自己扫一眼就过去了。但这份产出一旦要交给别人用,或者要进系统,结构就得先谈一次:谁定字段、字段变了谁通知、老数据怎么办。这三句谈不清楚,接流程就是给后面埋雷。
顺带说一句这套东西的代价:前两份表,我改提示词加校验花的时间,比我手工整理还久。到第三份才开始回本。
你手上有没有那种"AI 给的结果挺好,但我还得手工理一遍才能用"的活?
文末那份《文档结构化输出 Prompt 模板包》是这个模板的完整版,含字段定义表、剥围栏与校验的两段代码,以及四个坑的报错原文。回复「结构化出口」领取。