ARTICLE · 1165086
AI论文解读:更贵的模型,完成任务可能更便宜?
一次交给 AI 的任务,可能包含读文件、修改内容、运行测试和反复纠错。模型在每一步接收的内容,除了新要求,还可能包括此前积累的对话与工具结果。这些内容会被多次读取,并产生费用。
《Harness Tokenomics: A Router for the Enterprise Agentic Control Plane》算了这笔账。在论文采用的价格表中,最高档模型的输入、输出单价更高,缓存读取单价却更低。当一项任务需要反复读取大量历史内容时,缓存读取省下的费用,可能超过输入和输出多花的费用,让完成任务的总成本反而更低。
论文据此设计了模型路由策略,把会话长度、缓存状态和任务类型一起纳入选择。本文依据 2026 年 9 月 26 日修订版,介绍它的成本机制与万人企业模拟结果。
01 一次提问可能对应多次模型调用
论文所说的 harness,是运行 AI 代理的软件。Claude Code、Codex 都属于这类产品:接收用户要求,把任务交给模型,执行模型调用的工具,再把工具结果交回模型,直到任务结束。
在这种工作方式中,用户只发出一条要求,模型却可能先读文件,再修改内容、运行测试、检查报错,反复调用工具。
按照论文的计费模型,一轮任务包含 k 次工具步骤,就会产生 k+1 次模型请求。18 次工具步骤,对应 19 次请求。 每次请求都携带截至当时的对话内容,后续请求还会带上新增的工具结果与模型输出。
这使得账单中的输入量,可能远大于用户亲手输入的那段文字。
提示词缓存可以降低重复处理相同内容的费用。已有内容满足缓存条件时,服务商按“缓存读取”计价;首次建立缓存则产生“缓存写入”费用。论文将每次请求分成四类分别计算:未缓存输入、缓存写入、缓存读取和输出。
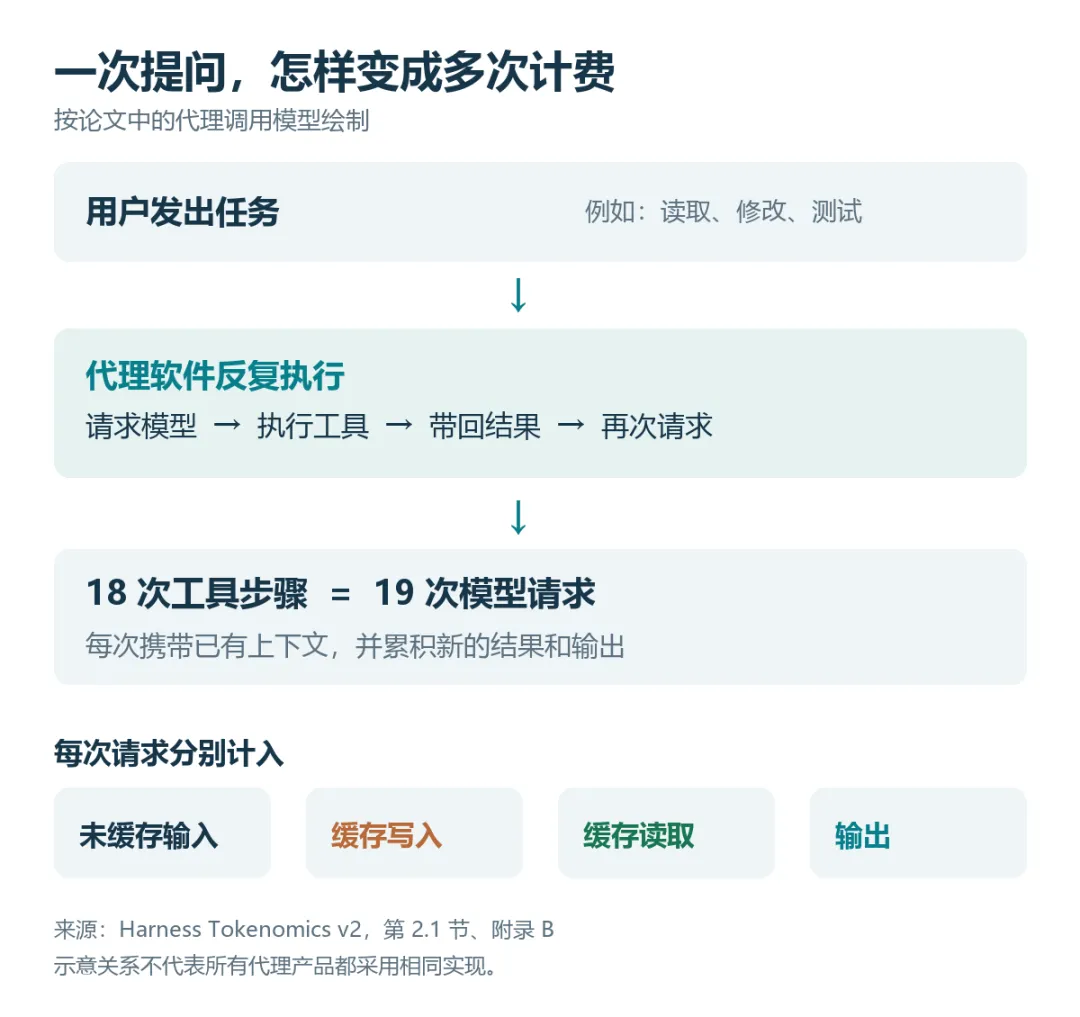
缓存还受两个条件约束:前缀内容需要匹配,缓存属于特定模型。将一段很长的对话交给另一个模型,通常需要在新模型上重新建立缓存;超过有效时间后再继续,也会产生重新写入的费用。
02 高单价模型的缓存读取可能更便宜
论文采用 Anthropic 在 2026 年 9 月 21 日的公开价格。其中,Fable 5.1 的普通输入与输出单价,都是 Opus 5 的两倍,但缓存读取单价只有后者的一半。
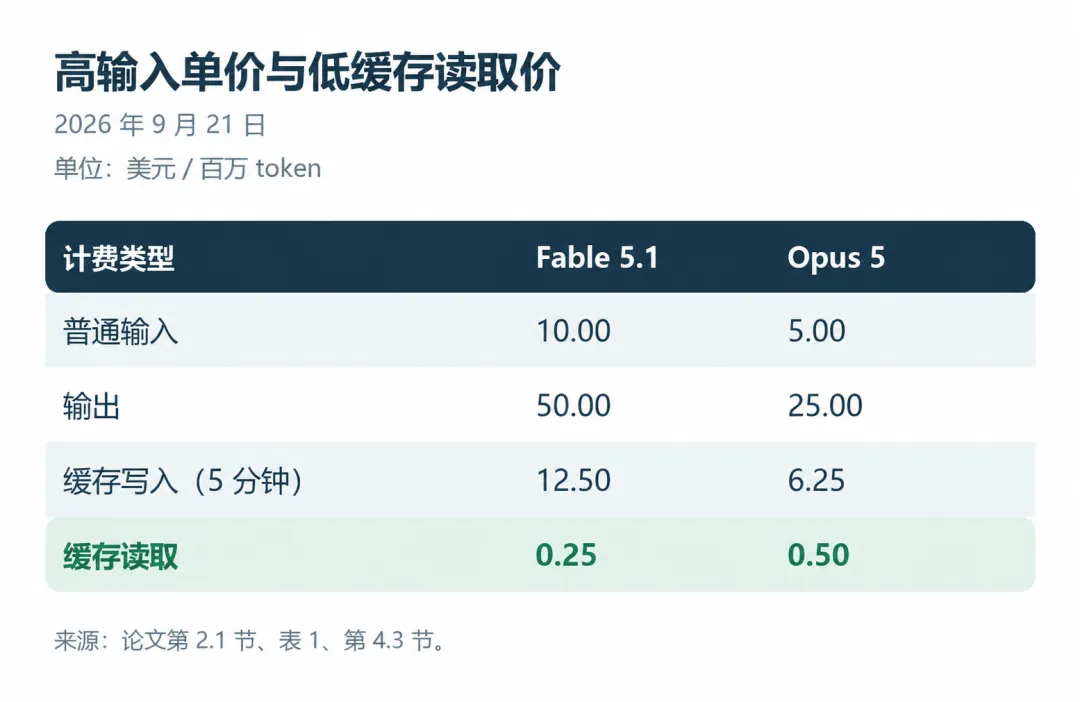
每百万 token,Fable 5.1 的普通输入、输出分别为 10 美元、50 美元,Opus 5 分别为 5 美元、25 美元。缓存读取则相反:前者为 0.25 美元,后者为 0.50 美元。
短任务中,新输入、输出和缓存写入占比较高。长任务中,同一段历史被反复读取,缓存读取费用逐渐成为总成本的重要部分。论文由此计算了两种模型的成本交点。
在缓存仍然有效、每轮新增 4 万 token、输出 6000 token 的设定下:
• 每轮包含 6 次工具步骤时,上下文超过约 23.1 万 token,Fable 5.1 的单轮成本低于 Opus 5。 • 每轮包含 18 次工具步骤时,这个交点降至约 7.1 万 token。
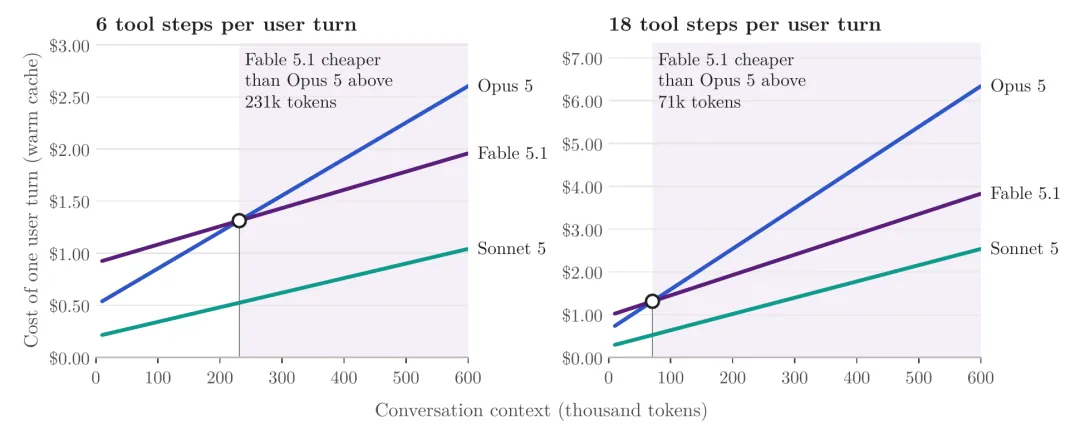
论文原图 2。横轴为上下文长度,单位为千 token;纵轴为缓存有效时的一轮用户交互成本,单位为美元。左图每轮 6 次工具步骤,右图 18 次。原图英文标注保留。
这两个交点来自相同 token 用量下的价格计算。它们不以“更强模型更少犯错”为前提:即使调用次数和输入、输出量相同,缓存读取价格的差异也能改变成本排序。
作者还对 TraceLab 的 5319 段、SWE-chat 的 4806 段 Claude Code 会话逐项重新计价。在按 Opus 5 价格计算达到 100 美元的会话中,换用 Fable 5.1 价格后更便宜的比例,分别为 51% 和 80%。这部分高成本会话的样本数分别为 102 和 30。
这里进行的是对已有 token 记录重新计价,并未让两种模型各自重新执行全部任务。论文也没有据此报告两种模型的实际完成质量相同。
03 中途换便宜模型需要支付什么
如果某一步很简单,将它交给低价模型是否一定省钱?论文把切换模型时的缓存重建费用也计入了账单。
原模型已经缓存了一段很长的历史。切到另一模型时,新模型要重新写入这段历史;之后回到原模型,还可能再发生一次写入。低价模型后续节省的费用,需要覆盖这些切换成本。
论文计算了切换模型后,节省的费用何时能抵消切换成本。仅计算长上下文已有缓存的部分,Opus 5 切换到 Sonnet 5、随后再切回,需要超过约 27 次请求才能抵消切换费用;Fable 5.1 切到 Sonnet 5 再返回,则需要超过约 291 次请求。
两者差距来自缓存读取价差:Fable 5.1 本身的缓存读取已经很便宜,切换到 Sonnet 5 后,每次重复读取所能节省的钱更少。
计入新输入与输出后,抵消切换成本所需的轮数也会改变。在论文给定的任务形态和 5 万至 20 万 token 上下文中,从 Opus 5 切到 Sonnet 5 再返回,约需 1—3 轮才能抵消切换费用;从 Fable 5.1 切到 Sonnet 5 再返回,则约需 3—11 轮。它们是特定参数下的计算结果,不是固定的产品规则。
04 路由器怎样分配任务
论文设计的路由器,负责根据任务和会话状态选择模型。它主要在三个位置分配工作:会话开始时、独立小任务出现时,以及子代理启动时。
会话开始时选择模型。 此时历史内容较少,不必迁移一大段已经建立的缓存。路由器估算整段会话的成本;对于预计有较多工具调用的长任务,候选模型中包括缓存读取更便宜的 Fable 5.1。
将独立小任务放进单独的会话。 论文称其为 side lane,可理解为从主任务旁边另开一段短会话。它带上精简的项目记录,而不复制完整对话。完成后,将结果作为新说明追加回主会话,并用一次请求刷新主会话的缓存。
论文给出的例子,是在已经积累 80.5 万 token 的会话中,修改一个按钮的颜色。按其参数计算,留在 Fable 5.1 主会话中处理,费用为 0.90 美元;交给 Sonnet 5 的独立会话处理,连同项目记录和主缓存刷新,费用为 0.36 美元。
在子代理启动时选择模型。 子代理承担拆分出去的工作,启动时本来就要建立新会话。因此,论文在这一时点选择模型,避免让所有子代理都自动继承主代理的模型。
判断任务类型的,是一个名为 Jev 的分类器。它给出任务动作、领域、复杂度和历史依赖程度等标签及其概率。路由器要求“候选模型足以完成任务”和“任务不依赖完整历史”这两项概率,都达到设定阈值后,才执行相应的转移。论文基准阈值为 0.8。
如果概率不足,任务留在原模型。对于“刚才做错了,请修改”这样的纠错要求,系统沿用被纠正任务所需的能力档位,不因提示文字很短就降到低档模型。
论文分别记录了误判与保留的代价:转移的轮次中,12.5% 被分配到了低于作者标签要求的能力档位;符合转移条件的轮次中,42% 因分类器把握不足而留在原处。模拟把误分配后回到原模型重做及后续纠错的费用,计入了结果。
05 万人企业模拟节约了多少
作者编写了 46 段对话、109 轮提示,覆盖 11 类工作,包括工程、数据、产品、营销、销售、法务、财务和人力资源等。
随后,研究从前述公开会话数据中提取纠错、停顿和子代理使用等行为,将每段对话扩展为 200 个随机变体,再按职能和使用强度分成 14 类人群,模拟一家拥有 1 万个使用席位的企业。
在该人群结构中,工程相关任务占原始模型支出的 86%。基准情形采用 5 分钟缓存有效期,并使用 9 月 21 日的模型价格。
模拟结果如下:
• 维持原有模型配置:每月模型支出约 203.1 万美元。 • 使用实际分类器标签路由:降至约 176.0 万美元,减少 13.4%。 • 假设所有任务标签完全正确:降至约 161.0 万美元,减少 20.8%。
对应的年度节约额约为 330 万—510 万美元。论文摘要将比例概括为 13%—21%。作者将理想标签假设下约 21% 的节约率界定为上限。
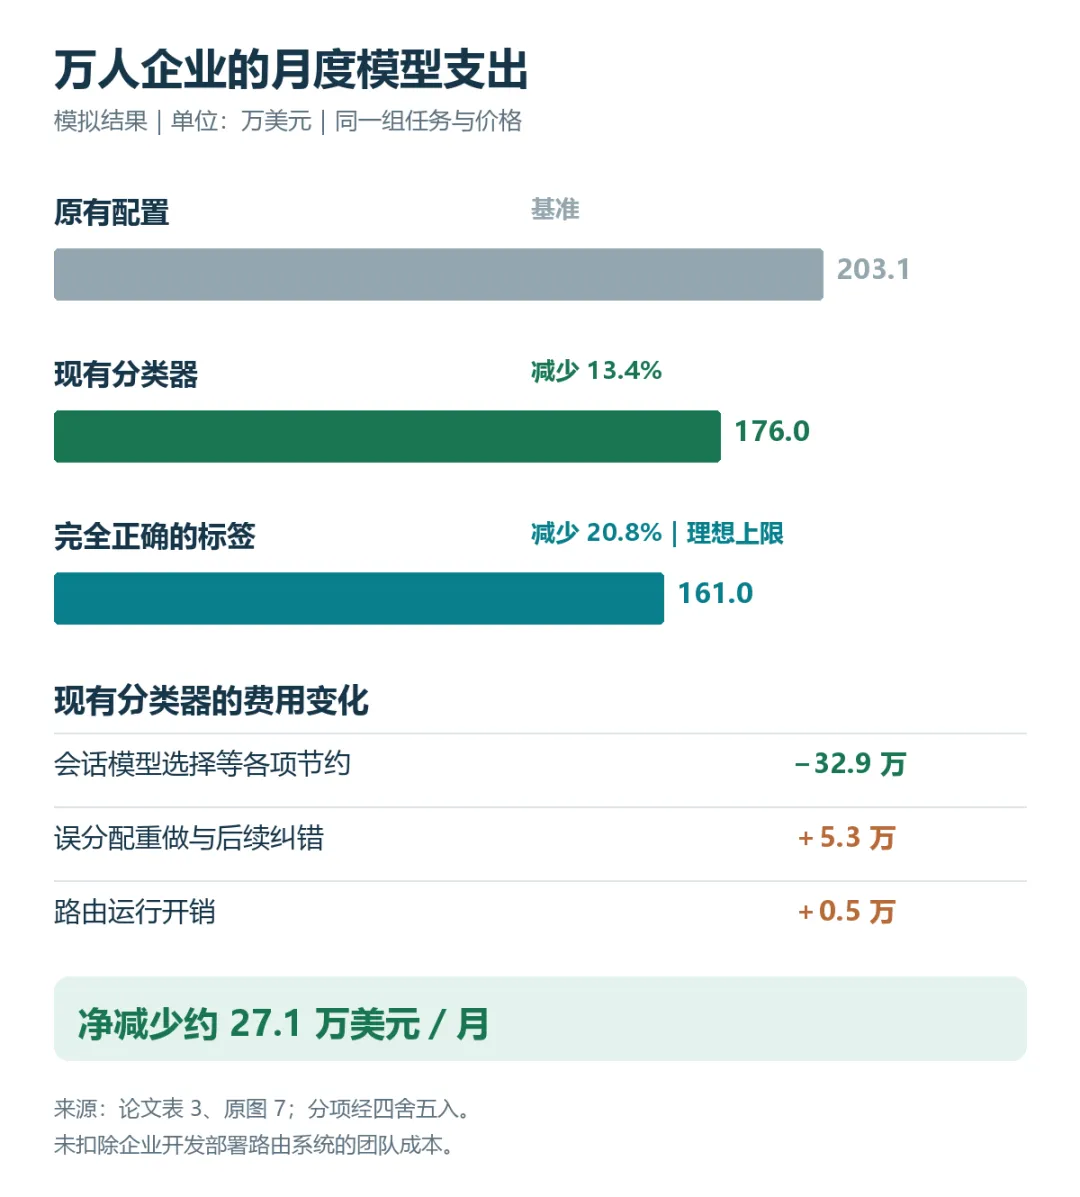
依据论文表 3 与原图 7 整理。金额为月度模型支出,单位为万美元;分项经过四舍五入。模拟已计入误分配重做和路由运行开销,未扣除企业开发部署路由系统的团队成本。
按现有分类器计算,选择整段会话成本更低的合适模型,每月贡献约 19.8 万美元节约,占净节约额约四分之三。独立小任务、子代理启动路由和会话起点的其他调整,也贡献了节约;误分配及其纠错链增加约 5.3 万美元,路由运行开销增加约 0.5 万美元。
路由后的模型支出中,86% 花在 Fable 5.1 上,尽管只有约五分之一的会话从它开始。它承担的是模拟中费用较高的长时间工程和数据任务。
06 结果随哪些条件变化
论文对缓存、价格和任务长度分别做了敏感性分析。
停顿会改变缓存是否有效。保持其他设定不变,采用几乎没有超过 5 分钟停顿的情形时,节约率为 22.8%;采用 TraceLab 中停顿更多的行为分布时,降至 8.2%。将基准的缓存有效期从 5 分钟延长至 1 小时,节约率为 15.5%,这里比较的是同样采用 1 小时缓存的原配置与路由配置。
价格结构也会改变结果。将各模型的缓存读取价格统一设为各自输入价格的 10%,Fable 5.1 原有的缓存折扣优势消失,节约率降至 5.9%。若没有 Fable 5.1 使用权限,节约率为 3.1%。
任务强度同样有影响。工具步骤数和工具返回的 token 量同时减半时,节约率约为 0.3%;同时加倍时,约为 23.8%。
这些结果都来自模拟。论文实现了决策引擎、策略和模拟器,连接真实代理软件的网关、执行钩子及用户界面尚未完成。46 段任务及其标准标签由作者编写,工程任务的缓存读取占比也略高于两个公开数据集。代码和任务目录尚未公开。
研究计入了模型消耗、误路由后的纠错和路由运行费用,但没有给出一家真实万人企业部署系统后的实测账单,也没有扣除开发与运营团队成本。13%—21% 描述的是上述设定下的模型支出变化。
论文最后提出,用“经过验证完成的任务成本”衡量代理工作,并按团队或配置汇总。在它的计算框架中,这笔成本需要同时包含模型价格、反复读取的上下文、工具调用、缓存重建、子代理,以及纠错重做。
资料来源
[1] Ted Kwartler、Alan Aqrawi、Arian Abbasi,Harness Tokenomics: A Router for the Enterprise Agentic Control Plane,arXiv:2609.28919v2,2026 年 9 月 26 日修订。论文原文