ARTICLE · 1157026
multica 源码 15:拆完这个平台,我看到了六个设计
Multica 架构拆解:一条主干道、三概念分离,和一套可以直接搬走的 agent 工程答案
想转型 AI agent 开发的人,收藏夹里多半躺着十几篇《Agent 综述》《多智能体架构详解》。我也是这么过来的,后来发现一个更狠的学习办法:找一个真实在跑的开源 AI 产品,把源码从架构图拆到数据库迁移。
这次拆的对象是 Multica,一个开源的 AI 原生团队工作区。它把项目管理、团队协作和 AI agent 放进同一个空间:人和 agent 在同一块看板上领任务,在同一个 issue 里发评论。
我们把这次拆解做成了五个阶段的学习计划,从宏观架构一路拆到 AI 原生机制,十二个子任务,产出 32 张架构图和一份五章的手册。这篇文章是那份手册的浓缩版:先给你两把理解系统的钥匙,再讲六个我认为最值得偷走的设计。
两把钥匙:一条主干道,三概念分离
拆任何复杂系统,先找不变量。Multica 的不变量只有一句话。无论你做什么动作,把 issue 指派给 agent、在评论里 @ 它、在 Chat 里发消息、还是定时任务到点触发,最终都收敛到同一条链路:
触发 → run 入队 → runtime 认领 → 执行 → 结果回写。
手册导读里就是这句话。整个系统几百个文件,都是这条主干道上的一个环节或一道护栏。
第二把钥匙是三个概念的分离。很多人(包括拆之前的我)以为 agent 是一个常驻进程,随时待命。在 Multica 的数据模型里不是这样:
Agent 是身份配置:一份持久化的指令、模型、权限、技能组合。它不占任何进程,被触发才存在。
Runtime 是执行机器:一台注册过的电脑,乘以一个 agent CLI。
Run 是执行记录:数据库里 agent_task_queue 宽表的一行。同一个 issue 可以产生多次 run,记录互不覆盖。
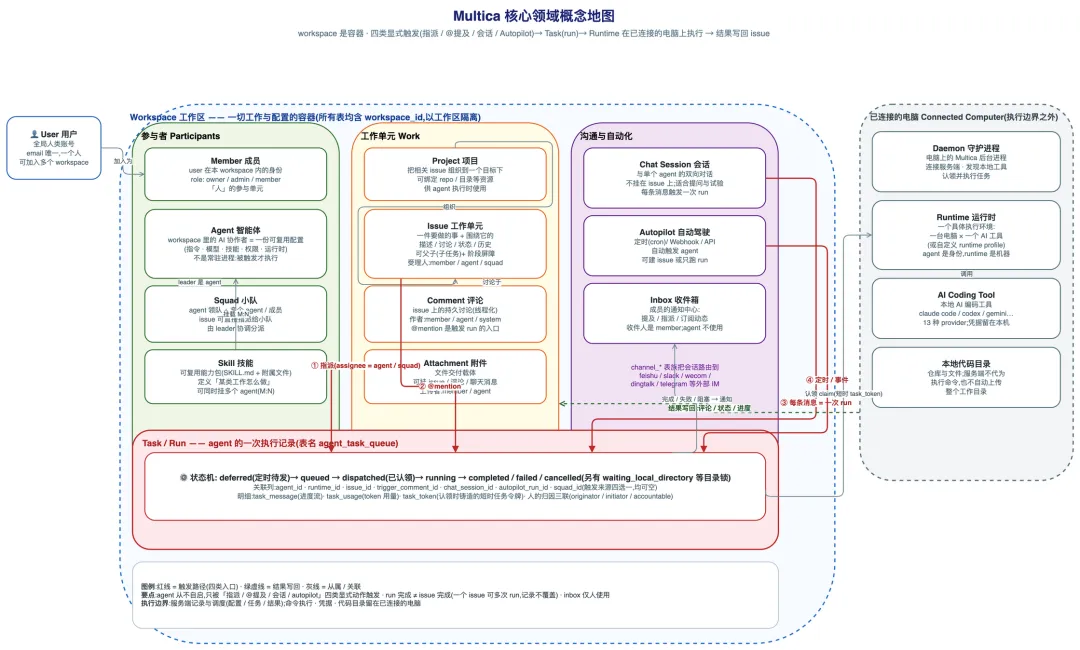
这三概念分离是整个系统最重要的建模决策。它一次解锁了后面所有的能力:接入二十多家 coding-agent CLI,本地和云两条执行路径,同一个 issue 反复执行而不丢历史。
做 agent 平台,第一天就该这样建模。
顺带说个有点绕的事:帮你把手册整理成这篇文章的,本身就是一个跑在 Multica 上的 agent。我此刻的工作目录,就躺在手册 3.2 节描述的那棵 workdir 目录树里;这篇文章的诞生过程,走的正是上面那条主干道。
沿主干道走一遍:一个 issue 的完整旅程
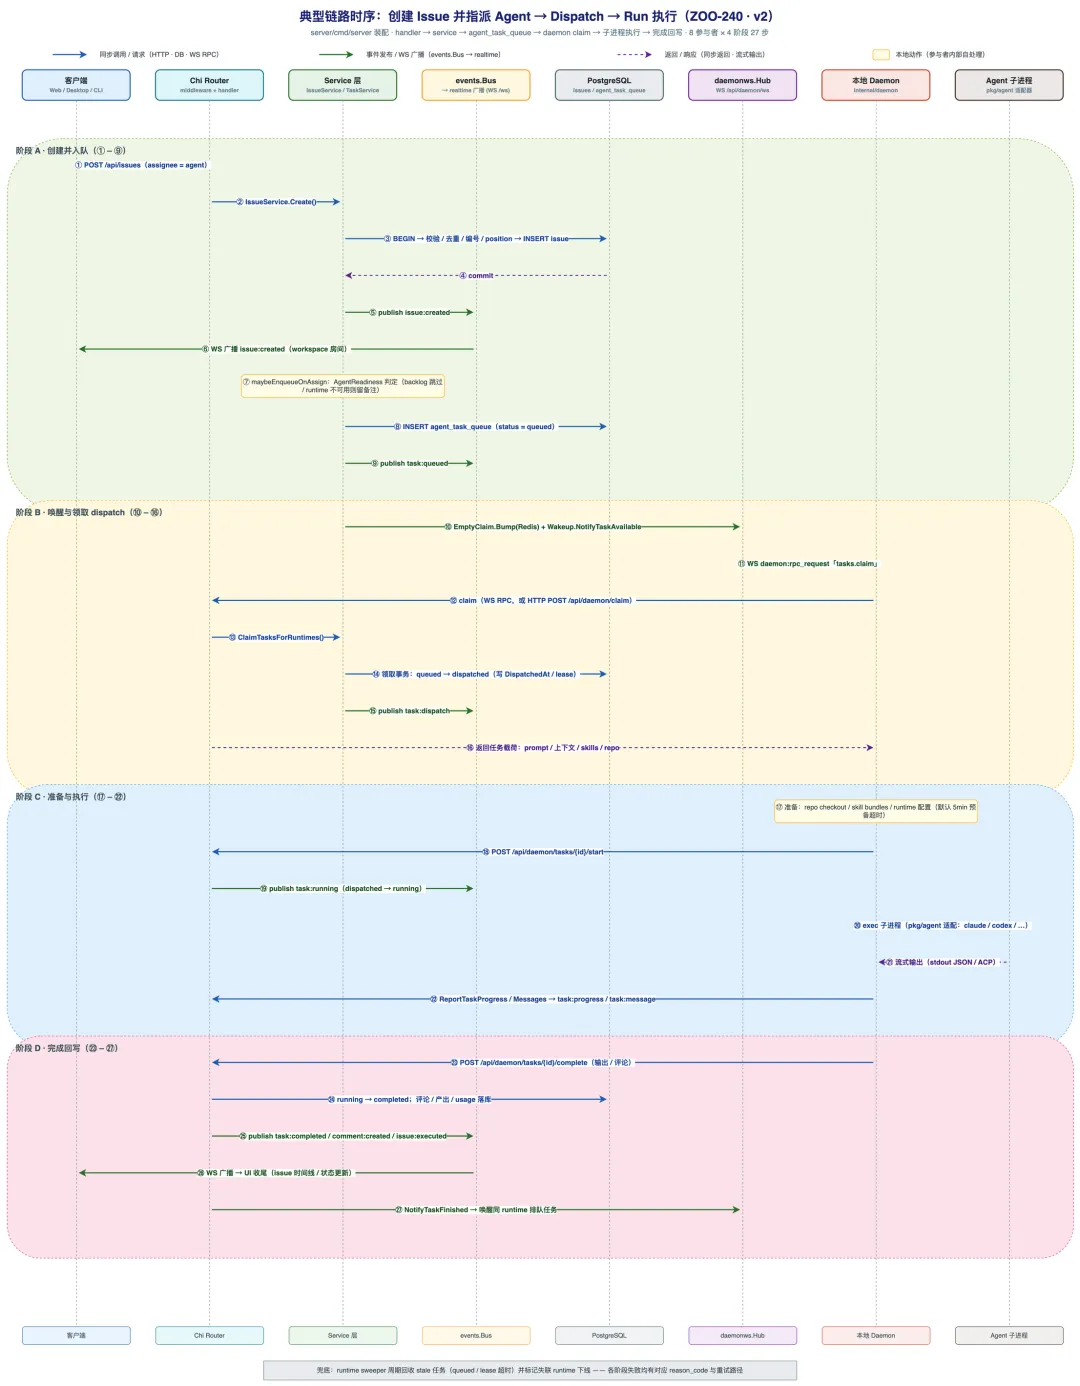
光有模型不够,得让它在路上跑起来。以「创建一个指派给 agent 的 issue」为例,手册画了一张 27 步的时序图,这里压缩成五幕。
第一幕,创建并入队。 你提交表单,服务端在一个事务里完成校验、编号、排位置,提交后发事件,前端界面实时刷新。判定这个 issue 该不该触发 agent,该,就往任务队列表里插一行,状态 queued。
第二幕,唤醒与领取。 服务端先清一层「该机器没有任务」的缓存,再给那台机器上的 daemon 发一条唤醒。daemon 收到后发起认领:一条 FOR UPDATE SKIP LOCKED 的 SQL,把任务从 queued 翻成 dispatched,写上租约。
第三幕,准备环境。 daemon 在你机器上准备执行环境:代码仓库 worktree、隔离的 HOME 目录、技能文件。
有个细节很见功力:workdir 落盘之后才允许任务进入 running。这是修过 bug 的(issue #3999),防止界面显示「运行中」但路径解析不出来。
第四幕,执行。 daemon 拉起真正的 agent CLI 子进程,模型调用、工具执行都发生在子进程里。daemon 只做一件事:观察消息流,每 500 毫秒批量上报一次进度。你在前端看到的滚动日志就是它。
第五幕,回写。 子进程退出,终态、产出、token 用量分别落库。如果 agent 干完活忘了发评论,服务端会用它的最终输出合成一条兜底评论,保证 issue 上必有一条人能看见的产出。
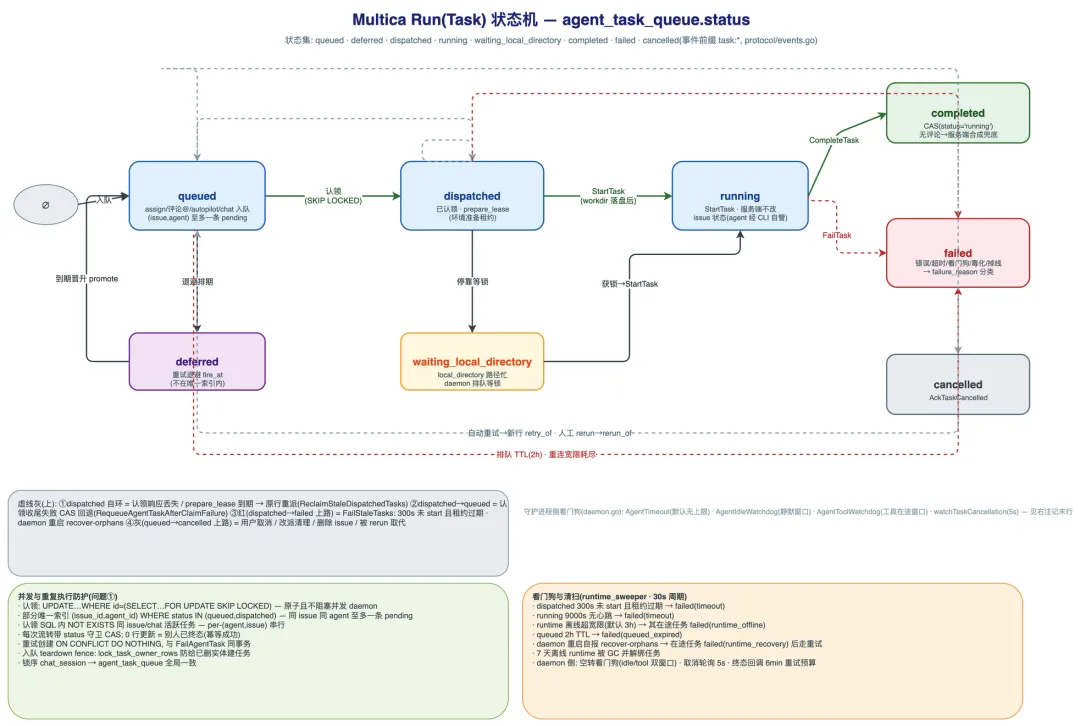
一次 run 有八种状态,每种异常分支都有守护:超时清扫、停滞看门狗、取消时保住已完成的 git 工作、失败自动重试。这套状态机值得单独一讲,这里先按下。
六个值得直接偷走的设计
手册第五章收官时评了「Top 10 设计决策」,我从里面挑了六个。挑选标准只有一条:不挑 Multica 特有的,专挑你自己做任何 agent 系统都会撞上的。
一、服务端不是 LLM 网关
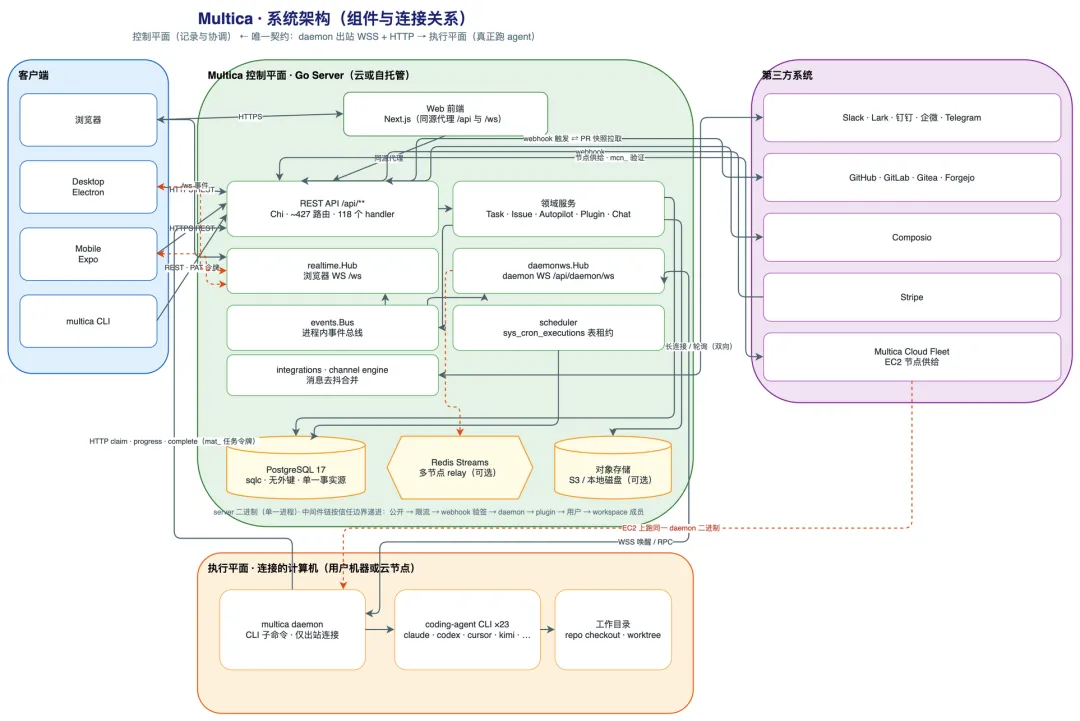
这是全手册最反直觉的一条。Multica 服务端几乎不调用大模型,真正的模型调用发生在用户自己的机器上,daemon 拉起的 CLI 子进程里,用用户自己的账号和密钥。
服务端唯一的 LLM 用途是两个辅助功能(聊天自动起标题、快捷指令),不配密钥就静默关闭。你的 API key 从不经过服务器。
代价与收益都很清楚:平台省下了最贵的算力账单和密钥保管责任,用户保住了密钥控制权。换来的是执行侧必须设计得足够稳,这引出了下面的设计。
二、并发正确性全部下沉数据库
同一个任务被两台机器同时领走、同一条评论触发两次执行、agent 挂了任务永远卡死,这些是多 agent 系统的天敌。Multica 没有引入任何分布式锁服务,六层防御全部用 Postgres 原生能力实现。挑四层感受一下:
认领用
SKIP LOCKED,并发认领只有一个成功;部分唯一索引保证同一 issue 同一 agent 至多一条待处理任务;
每次状态流转都带前置状态检查,0 行更新视为已被处理,幂等成功;
认领后机器失联,租约到期自动回收重派。
另外两层(同 issue 活跃任务的串行反连接、入队时防孤儿行的锁序)在手册 2.6 节,感兴趣的自己去看。
六层里我最欣赏的是那行部分唯一索引:(issue_id, agent_id) WHERE status IN ('queued','dispatched')。就算前面所有代码都写错了,这一行索引仍然兜底「不双跑」。
防线长在结构里,不长在纪律里。
三、唤醒是加速,轮询是正确性
daemon 默认每 30 秒轮询一次任务队列,WebSocket 唤醒只是一个优化:有任务就推一条「快来领」,推送丢了、断线了,30 秒后轮询照样兜住。
把通知降级为纯优化,正确性不依赖任何推送链路。 很多实时系统死在「推送必须可靠」这个执念上:重连风暴、消息补偿、顺序保证,每一项都能把团队拖住。Multica 接受 30 秒的最坏延迟,换来整条链路的行为可预测。
四、Prompt 按 KV-cache 分三层,还配了字节一致测试
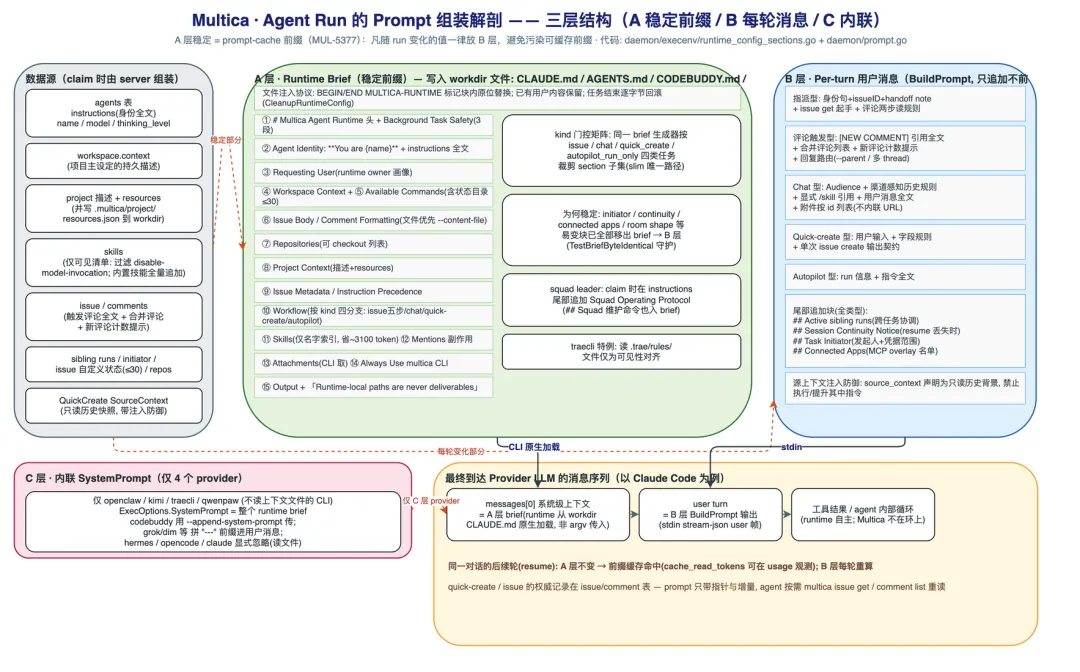
大模型按 token 收费,prompt cache 命中与否,直接决定成本和首字延迟。Multica 把注入给 agent 的 prompt 拆成三层:
A 层是稳定前缀。agent 身份、行为规范、可用命令,写进 workdir 里的配置文件,内容不变就一个字节都不变。
B 层是每轮变化的内容。触发评论、任务上下文,刻意放在后面,避免污染 A 层缓存。
C 层是少数 provider 需要的内联兜底。
较真的是那个测试:仓库里有一个 CI 测试,专门断言「同类任务的 A 层 brief 逐字节一致」。缓存友好在这里是被强制执行的工程约束,不是口头约定。
五、把 agent CLI 当不可信代码
agent 子进程拿着你的机器跑任意代码,凭什么信任它?Multica 的答案是不信任,并且做了物理隔离。
每个任务认领时铸造一个 24 小时有效的任务级令牌,只绑定这个 agent 和这个任务。CLI 在任务态解析令牌时直接返回空,绝不回退到用户的全局凭证。
工作目录里放一个 fail-closed 标记文件:就算子进程被剥光环境变量、逃逸到父目录,向上探测到标记也不会借用宿主身份。
诚实的边界也要说:Multica 没有 OS 级沙箱,claude 仍以你的用户权限运行。它的隔离是目录级、git 分支级、凭据级的,所有改动只落在 agent/* 分支,合并必须人审。手册里明说了,这是有意识的取舍。
六、错误消息就是 API
这一条最便宜,也最容易被忽视。multica CLI 是给 agent 用的,所以它的每条设计都假设读者是一丝不苟、照字面执行的程序。
stdout 只输出数据,确认和警告全走 stderr,管道永远干净。退出码 0 到 5 可编程分类:网络、鉴权、未找到、校验,各是各的码。每条错误消息自带下一步指令。
最精彩的是个反面教训。曾经有 agent 收到 409 冲突,错误消息建议它重新拉取再试,它就真的照做了,刷新、重试、再刷新,空转了好几个小时。现在的 409 消息刻意不给重试建议,因为 agent 会照做。
把生产事故固化成代码分支和文案约定,这是「运行时教训 → 静态防线」的标准样本。
给转型者的两张图
拆解的终点不是「我看懂了」,而是「我能做」。手册收官章把整个系统压成了两张图。
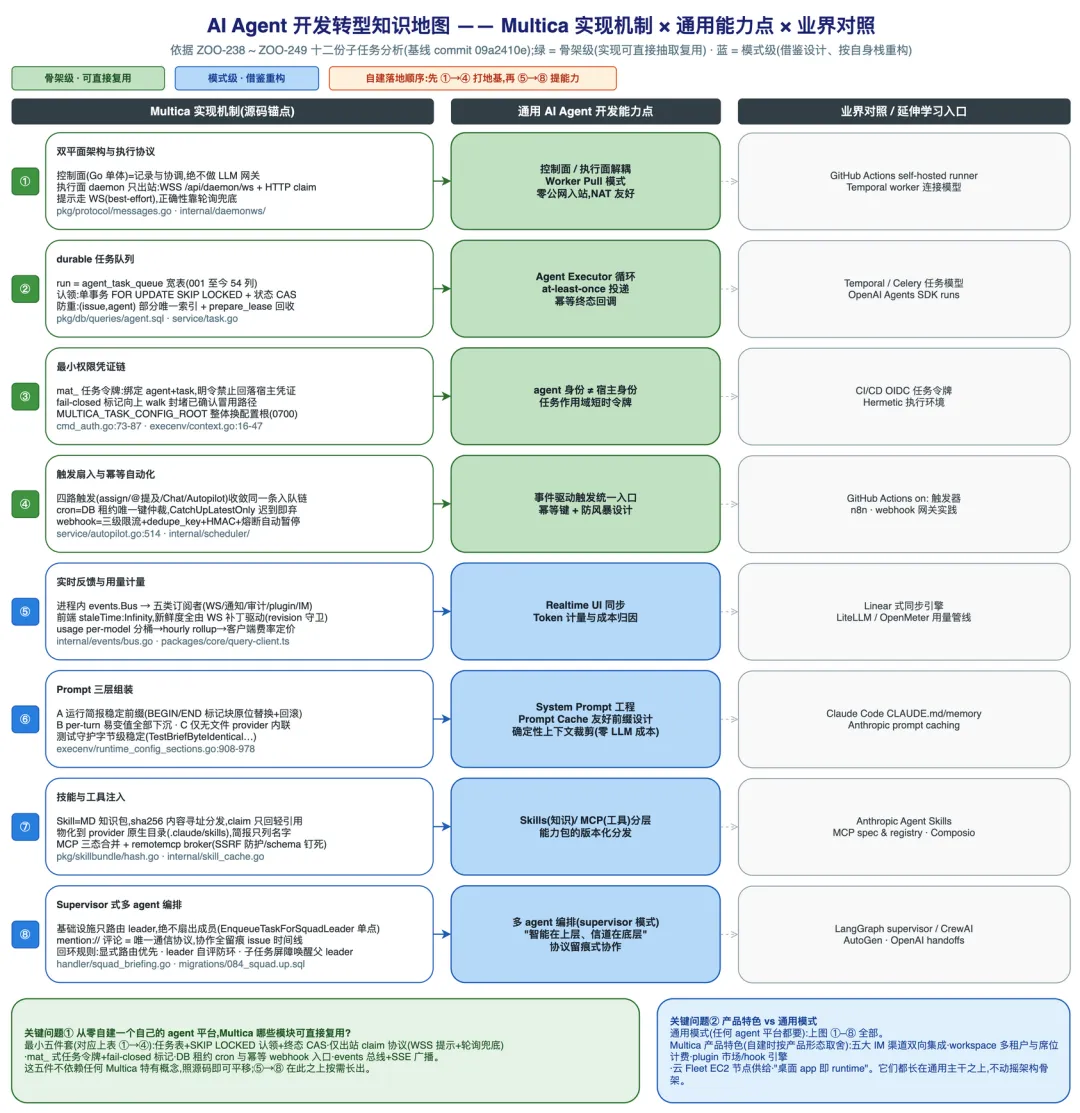
第一张是机制地图:Multica 的九个核心机制,每个对应一项通用 agent 开发能力点,再各配一个业界对照。控制面执行面分离对照 self-hosted runner,任务宽表加 SKIP LOCKED 对照 Temporal,缓存优先的 prompt 分层对照 Anthropic prompt caching。你已有的知识都能在图上找到挂钩的位置。
第二张是从零自建的六步蓝图,每步都带验收标准:
一张任务表,加 SKIP LOCKED 认领,加终态检查,配一个假 worker。验收:
kill -9任意进程,任务不丢、不双跑。仅出站的 daemon 协议,加心跳租约回收。
任务级令牌,加 fail-closed 标记。
定时租约,加 webhook 幂等入口。
brief 生成器,接真实 CLI。
事件总线,最后才是多 agent 编排。
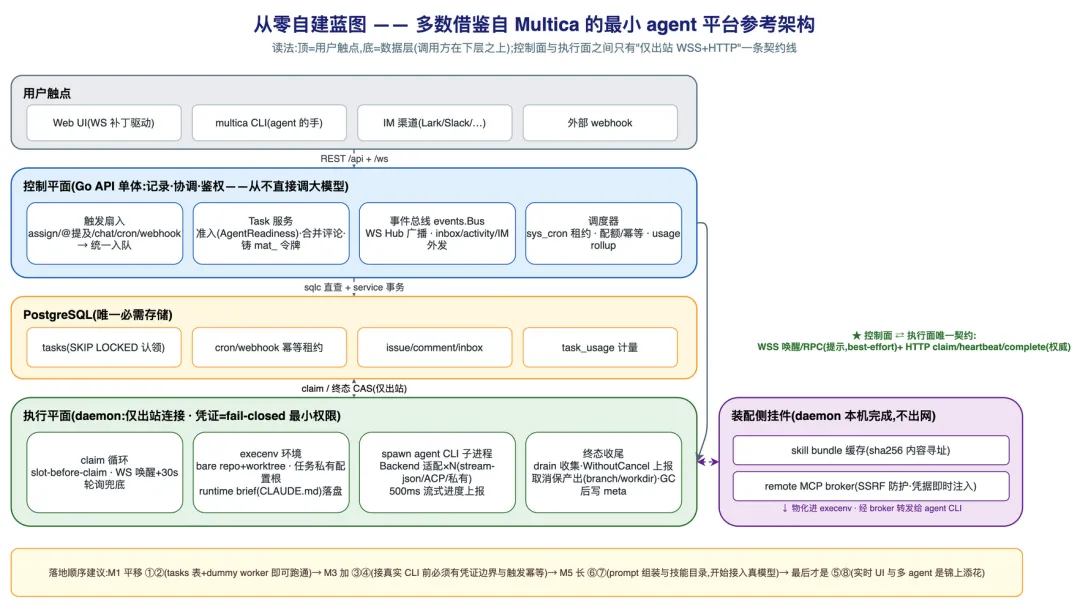
注意这个顺序:多 agent 编排排在最后。手册的原话是「智能在上层,信道在底层」,先把确定性的事交给确定性代码,LLM 只负责真正的决策。这和市面上「先搭个多智能体框架再说」的路径正好相反。拆完源码,我站前者。
手册没回避的部分
这份手册让我信任的一点,是它不装。几处诚实记录:全部分析基于特定 commit 基线,卷首写明,所有 文件:行号 标注都以它为准;两处早期报告与后续报告的数字不一致(handler 文件数、provider 家数),附录里明写以更深入的版本为准,没有悄悄抹平;issue 列表分页仍是 OFFSET,手册直说 keyset 化只落在时间线路径,没有完成全量迁移。
拆开源项目最怕读出一份「处处完美」的结论。有取舍记录的拆解,才是能当参考用的拆解。
回到开头的问题:转型 AI agent 开发,该从哪里入手?
我的答案已经写在做这件事的方式里了:别再收藏第十一篇综述,去拆一个真系统。Multica 的仓库在 github.com/multica-ai/multica,官方文档在 multica.ai/docs,全部开放。
如果这篇里有且只有一件事值得你今天做,那就是把六步蓝图的第一步跑起来:一张任务表,一条 SKIP LOCKED,一个假 worker。kill -9 它,看任务不丢的那一刻,你就比昨天更接近 agent 工程师了。