ARTICLE · 1313032
知网 CAJ 格式转换大师 · 技术文档
1. 项目背景与痛点
知网(CNKI)的论文常以下载为 CAJ / KDH / NH / CAA等私有格式分发,只能在官方CAJViewer中打开,且基本只支持 Windows。对 macOS、Linux 用户,以及想把论文转成 Word / Markdown 做笔记、引用的用户来说,极其不便。
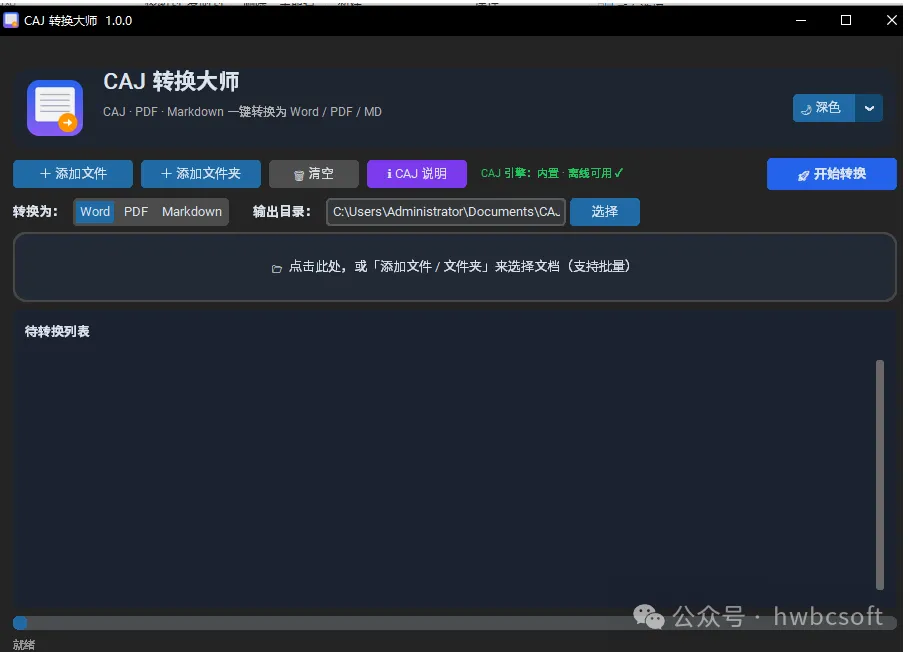
常见的转换需求:
• 把 CAJ 论文转成 Word,方便二次编辑;
• 转成PDF,跨平台通用;
• 转成Markdown,方便进入笔记 / 写作工作流。
但这类转换长期存在两个难点:一是 CAJ 是封闭格式,公开解析资料少;二是网上很多方案依赖联网下载第三方工具(如 mutool),不稳定、不适合打包成单机软件交付。
2. 技术选型
维度 | 选型 | 用途 |
语言 | Python 3.10+ | 主开发语言 |
界面 | CustomTkinter | 现代化桌面 GUI(深/浅色主题) |
PDF 处理 | PyMuPDF(fitz) | 渲染、页面操作、图片抽取 |
Word 生成 | python-docx / pdf2docx | 生成 .docx |
文本/排版 | markdown、html2docx、xhtml2pdf | MD↔PDF 等 |
打包 | PyInstaller | 打包为单文件 .exe |
整体理念:离线优先、单文件交付、零运行时联网。
3. 系统架构(分层)
┌─────────────────────────────┐
│ GUI 层 (CustomTkinter) │ 选择文件 / 目标格式 / 进度展示
└──────────────┬──────────────┘
│
┌──────────────▼──────────────┐
│ 转换调度层 (converters) │ 按输入/目标格式路由
└───────┬──────────────┬──────┘
│ │
┌───────▼──────┐ ┌─────▼──────────┐
│ CAJ 引擎层 │ │ 通用格式互转 │ PDF/MD ↔ DOCX/PDF/MD
│ (caj2pdf) │ │ │
└───────┬──────┘ └────────────────┘
│
┌───────▼──────┐
│ 输出层 │ PDF / DOCX / MD 落盘
└──────────────┘
4. CAJ 格式科普(适合做科普文章)
CAJ 并非单一格式,知网历史上使用过多种封装:
• CAJ / CAA:早期主格式;
• KDH / NH / HN:不同年代、不同压缩算法的变体;
• C8 / CAJ8:较新的封装,内部常内嵌JBIG / JBIG2 / JPEG等图像数据(说明很多论文其实是“扫描页 + 图像”)。
为什么难解析:
1. 格式未完全公开,社区主要靠逆向经验;
1. 图像可能使用 JBIG/JBIG2 等专业压缩,需要对应解码器;
1. 不同变体的页面结构、旋转标记不一致,容易造成“页面方向错乱”。
开源社区已有若干 CAJ 解析实现(如基于 CAJViewer 逆向的 caj2pdf思路),核心流程都是:先把 CAJ 解析成标准 PDF,再做后续格式转换。
5. 整体转换流程(Pipeline)
CAJ ──解析──▶ PDF ──┬──▶ Word (.docx)
├──▶ PDF (副本/再封装)
└──▶ Markdown (.md + 图片)
• 第一步把 CAJ 统一“归一化”为标准 PDF,是降低后续复杂度的关键;
• 之后所有目标格式(Word / PDF / Markdown)都只与“PDF”打交道,互不影响。
6. 功能与格式矩阵(可对外宣传)
输入 \ 输出 | Word | Markdown | |
CAJ | ✅ | ✅ | ✅ |
✅ | ✅ | ✅ | |
Markdown/文本 | ✅ | ✅ | ✅ |
额外能力:批量添加、文件夹递归、拖拽、自动转换、深/浅色主题。
7. 工程化经验(通用,可写文章)
• 离线优先:尽量把第三方能力内嵌进安装包,避免运行时联网下载导致的不稳定。
• 单文件交付:用 PyInstaller 把 Python 程序打包成单个 .exe,降低用户门槛。
• 图片型文档的特殊处理:扫描类 PDF 转 Word 时,若直接抽取原始图片对象容易出现“方向错乱”,更稳妥的做法是“整页渲染后再嵌入”。
• 自检机制:打包后的程序内置一个隐藏自检入口,可一键验证转换链路是否仍正常工作,方便回归测试。
• 体验细节:添加即自动转换、进度可视化、状态逐文件反馈,能显著降低使用门槛。
8. 后续规划(可做预告类文章)
• 接入OCR,让扫描型 CAJ 也能产出可编辑文字;
• 支持更多输入来源与批量目录监控;
• 输出样式优化(保留目录、图表位置等)。