ARTICLE · 1333097
文档转Markdown实测:19万星的markitdown,3万行表格比pandas慢11倍
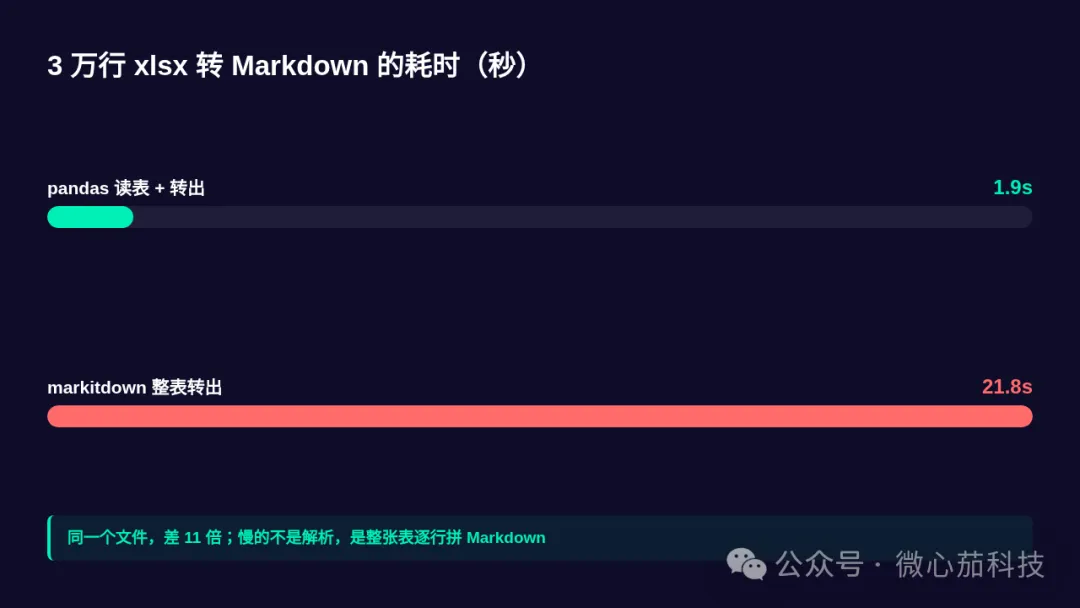
先说个数:3万行的客户表,用19万星的 markitdown 转一遍,21.8 秒,吐出来 165 万字符的 Markdown 表格。
同样的活,我原来的写法是 pandas 读进来、to_markdown() 出去,1.9 秒。
我第一次算完不信,又跑了一遍,还是 21.8 秒。所以这篇不是荐股,是复盘我为什么把主力方案换掉了,又在哪一步换回来。
"
结论先放这:markitdown 适合“杂七杂八的文件扔进来,要一份能喂给模型的文本”,不适合进批量流水线。当批量清洗工具用,你会被那 20 秒和 165 万字符坑得很难受。
{01}
PART
我需要解决的不是“转格式”,是三条不同的活
PART 1
背景放一下:我做的生意里有宽带、号卡、二手设备回收,客户资料散在 Excel、Word 合同、PDF 对账单、微信里别人发来的图片上。这些东西要进模型,得先变成文本。
以前我以为是同一件事,装了个工具就全丢进去。跑了两周才发现是三条活,要求完全不同。
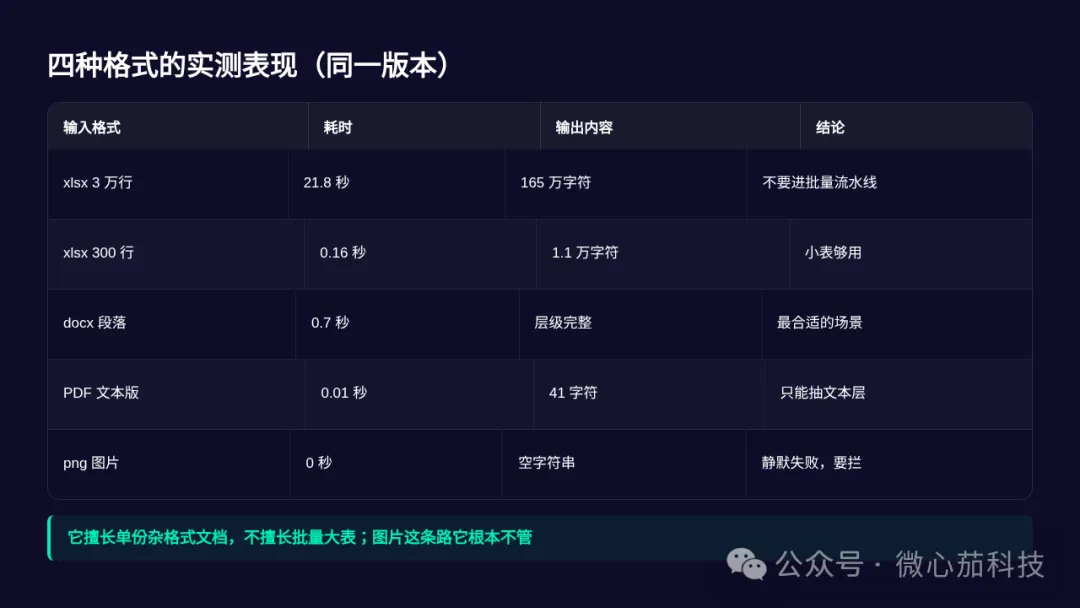
先说我最后悔的一步:我一开始拿 xlsx 去测 markitdown,看到「一份 300 行的客户表,0.16 秒转出干净的 Markdown 表格」,觉得这东西真好用,直接接进流水线。
{02}
PART
300 行的时候它很快,3 万行的时候它是另一个东西
PART 2
第一次发现不对,是我把上个月导出的全量客户表丢进去,脚本跑了二十几秒没动静。我以为卡死了,Ctrl+C 之后又跑,还是一样。
后来老老实实掐表:
$ time python3 -c "from markitdown import MarkItDown; MarkItDown().convert('big.xlsx')"
real 0m21.89s
$ python3 -c "import pandas as pd; pd.read_excel('big.xlsx').to_markdown(index=False)"
real 0m1.91s
差 11 倍。而且慢不是最要命的,最要命的是它吐出来什么。
3 万行 xlsx,输出 165 万字符。因为 markitdown 对 xlsx 的处理方式是「每个 sheet 一个标题,然后整张表转成 Markdown 表格」——| 客户编号 | 套餐 | 月费 | 到期日 | 这种行,一行一行全吐出来。
这 165 万字符进了模型上下文会怎样?我试过。塞不进去,得先切块,切块又会把表头切散,切散了模型就不知道第三列是什么。
这里就是我第一次被“通用工具”这个词骗了。通用意味着对每种格式都有一套转换器,不意味着它对每种格式都合理。
{03}
PART
它的长处确实在,只是不在流水线上
PART 3
公平讲,markitdown 有两件事我原来的写法做不了。
第一件是格式覆盖。我用 markitdown[all] 装了一遍,实测这几种喂进去都能出东西:
xlsx:每个 sheet 转一个 Markdown 表格,sheet 名当二级标题
docx:标题层级和列表能保住,一段说明加两条列表,输出 40 个字符,干干净净
PDF:文本层能抽出来(我的测试件抽出 41 个字符),扫描版仍然要靠 OCR
png:输出空字符串,它不会给你报错,很安静地返回空
最后这条要单独说,因为它是最容易在流水线里埋雷的地方。我拿一张纯白测试图跑,返回 '',没有异常,没有警告。如果你的脚本只判断「有没有抛异常」,这批图会被当成「转出来了,内容为空」悄悄放过。
第二件是统一入口。以前我得写一堆 if:.xlsx 走 pandas,.docx 走 python-docx,.pdf 走 pdfplumber。现在一个 convert() 全吃掉,代码短了一大截。
所以它真正省的不是时间,是我那堆分支判断的维护成本。这笔省下的维护时间确实有用,但值多少要看你手上格式有多杂。
{04}
PART
最后我把流水线拆成两段
PART 4
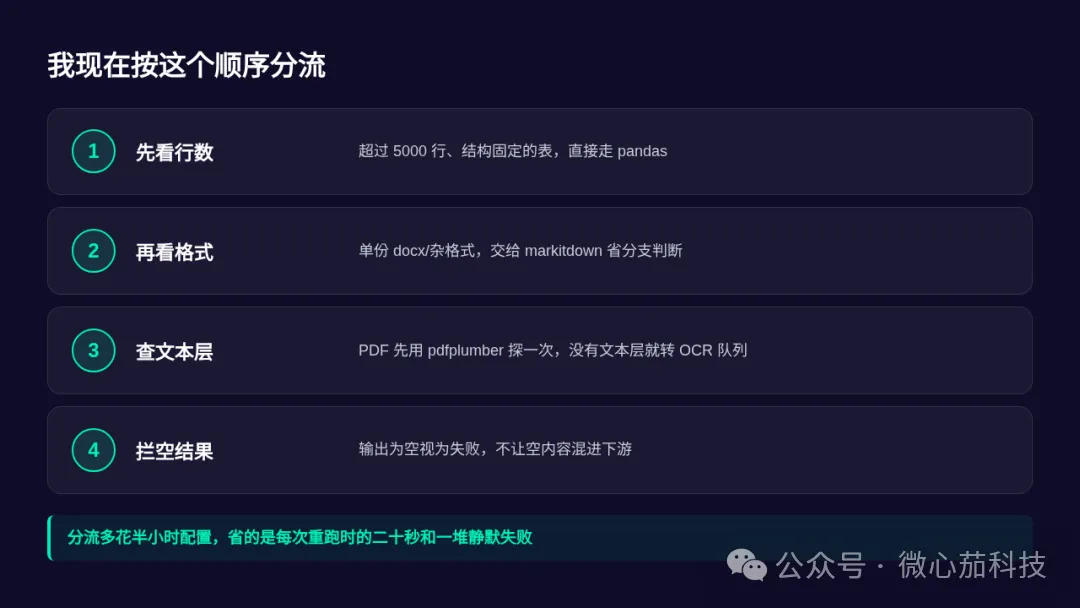
现在我的写法是这样的:日常批量跑的还是 pandas 和 pdfplumber,markitdown 只负责来路不明、格式不确定、量很小的那批。
判断标准我整理成了三条,你可以直接拿去用:
超过 5000 行、结构固定的表 → 别用 markitdown。pandas 读进来自己决定怎么表达,转成 JSON 行、或者直接抽你要的那几列喂模型,都比转整张 Markdown 表强。
单份文档、要保留标题层级 → markitdown 很合适,docx 的层级它保得住,省你自己写解析。
图片、扫描件 → 跟它没关系,直接上 OCR,别指望 convert() 顺手解决。
还有一条是踩出来的:它慢是设计取舍,不是 bug。它对每种格式都走一遍通用转换流程,单份文件的开销里有一大块是固定成本。我测同一批小文件时发现,0.16 秒那份和 0.01 秒那份的区别,基本就是「要不要启动那套转换器」。
这也意味着,如果你一天要处理几十份文件,把它装在常驻服务里,比每次起一个新进程划算得多。我第一次是每份文件起一个 python 进程,光启动就吃掉大半时间。
{05}
PART
说句可能不中听的
PART 5
我不认为 markitdown 被高估了。19 万星它配得上,因为它解决的是一个真问题:你的文件格式太杂,你又不想为每种格式写一遍解析。
但它被误用的地方也很明显:很多人(包括我)第一次看到「文件转 Markdown」这五个字,就默认它是清洗工具,直接放进批量流水线。它不是。它是一个入口转换器,把乱七八糟的东西变成一份人能读、模型也能读的文本,代价是慢、是啰嗦、是对大表不友好。
如果你的活是「一天几十份格式各异的文档,扔给模型看过就完」,装它,一条命令的事。
如果你的活是「每天几万行结构化数据,要稳定、要快、要能重跑」,别装它做主力,你会怀念自己写的那几行 pandas。
我不建议把它当唯一方案。两个都装,按文件类型分流,配置时间不到半小时,省下的是后面每次重跑时的等待。
最后留个问题:你们那边「文件转文本」这一步,是统一走一个工具,还是按格式分流?我目前是分流,但每加一种新格式就要改一次代码,这个维护成本我还没找到好办法摊掉。
还有一件事本来没打算写,但它确实改了我的做法:测试件和真实件不是一回事。
我测 PDF 用的那份对账单,是系统里导出来的文本版,抽出来 41 个字符,很干净。真拿客户拍的对账单照片转 PDF 去试,convert() 直接返回一个空字符串,和那张白图一模一样。
也就是说,PDF 这条路「能抽文本」和「能识别内容」是两码事。文本层的 PDF 才是它的射程,扫描件永远要另找 OCR。我现在流水线里加了一步前置判断:先用 pdfplumber 看一眼有没有文本层,没有就转去 OCR 队列,不让它空跑。
这一步加上之后,批量任务里「静默产出空内容」的情况基本没了。
你们那边「文件转文本」是统一走一个工具,还是按格式分流?我现在是分流,但每加一种格式就要改一次代码。
THANKS FOR READING