ARTICLE · 1242244
RAG 做知识库切分终极指南:表格、文档切分与文档级检索最佳实践
点击下方 【极客李华】 关注、选择设为星标
每天10分钟、打卡阅读
每天积累一个小知识,知识的复利就会很快到来
前言
大家好,我是李华。
过去一年多,我一直在保险金融和制造业一线带队做 RAG 知识库与 Agent 落地。从百余页的保险精算条款、理赔核保核赔手册、银行财务报表,到车间产线上数万行的数控机床检修规范和零件物料清单(BOM),几乎天天都在跟各种非标数据打交道。
在这个过程中,见过太多团队把大把时间和精力耗在调 Prompt 或者换更大的模型上。本地拿两篇排版工整的 Markdown 测 Demo,召回率看着能有 90%,感觉马上能上线交付。结果一放到生产环境,业务部门一测,当场露馅:
提问某款终身寿险第10个保单年度的现金价值,模型把隔壁附加险的费率表混在了一起,数字张冠李戴; 查询数控机床主轴超温报警的处理规范,切片正好在跨页表格处被一刀截断,参数跟表头脱节,模型开始凭空编造; 搜一条采购赔偿条款,向量库把全库几十份不同部门的文件碎片全捞了上来,Prompt 塞得满满当当,全是干扰项。
其实在生产环境做久了就明白一个朴素道理:输入的是垃圾,输出必然是垃圾。切分是整个 RAG 流水线最源头的一环,地基如果没打扎实,后面无论换多强的 Embedding 还是堆多复杂的重排,都只是在给危房刷漆。
一、别再无脑按 512 字符切了,脱离上下文的碎片就是噪音
很多项目一开始用的切分逻辑,本质上就像拿把尺子硬量字数:数够 512 个字符,不管一句话讲完没有、更不管这段话属于哪个部门哪份文件,直接截断。
切出来的文本块一旦脱离了原文,就成了完全丢失上下文的孤立碎片。比如下面这句话:
“第四条:违约金按合同总金额的 0.5%/日 计算,最高不得超过合同总标的的 20%。”
单看这句话,语义上没有任何问题。但把它丢进几十万个切片的向量库里,Embedding 模型根本不知道这是《云存储采购合同》还是《保洁外包协议》。今年(2026年3月)刚出的预印本论文《Adaptive Chunking: Optimizing Chunking-Method Selection for RAG》(arXiv:2603.25333)就通过大批量实测指出:用机械的固化尺寸切分复杂企业文档,跨领域问答正确率会直接下滑 35% 以上。
💡 我们在实际交付中落地的标准做法:元数据路径强注入
【文档来源】 2024年度集团数据中心机房维保与SLA保障框架协议_终稿.pdf【业务归属】 资产管理中心 / IT基础设施运维部 / 维保服务类【章节路径】 第三章 运维指标考核 > 3.2 故障应急时限与SLA罚则 > 第2条
正文条款:对于发生P1级不可用故障(影响核心清结算业务链路),乙方技术专家必须在15分钟内完成接入,并在2小时内抵达现场恢复业务运作,逾期按每小时人民币5,000元标准支付违约金。
别小看顶上这三行前缀,它帮我们在生产环境中解决了两个很棘手的问题:
- 向量空间聚类更收敛:
向量模型吸收了“基础设施维保”、“清结算”这些顶层特征,不会再跟租房合同、劳务协议搅和在一起; - BM25 关键词精确命中:
业务人员提问“数据中心故障赔偿限额”,即便条款正文里只有“违约金”,BM25 也能顺着头部的标签把切片高分捞上来。
二、最让研发头疼的复杂表格,在生产环境到底该怎么切?
普通文本切碎了顶多是丢点主谓语,而财务报表、设备参数表这类多列跨页的表格,一旦被生硬切开,灾难才真正开始。
上个月我们在测试时,拉了一段真实的数控机床主轴维保与预算配置大表(涵盖转速、润滑脂规格、温升阈值与维护预算)。我们把 4 种主流切分打法拉出来同台对比,实测数据如下:
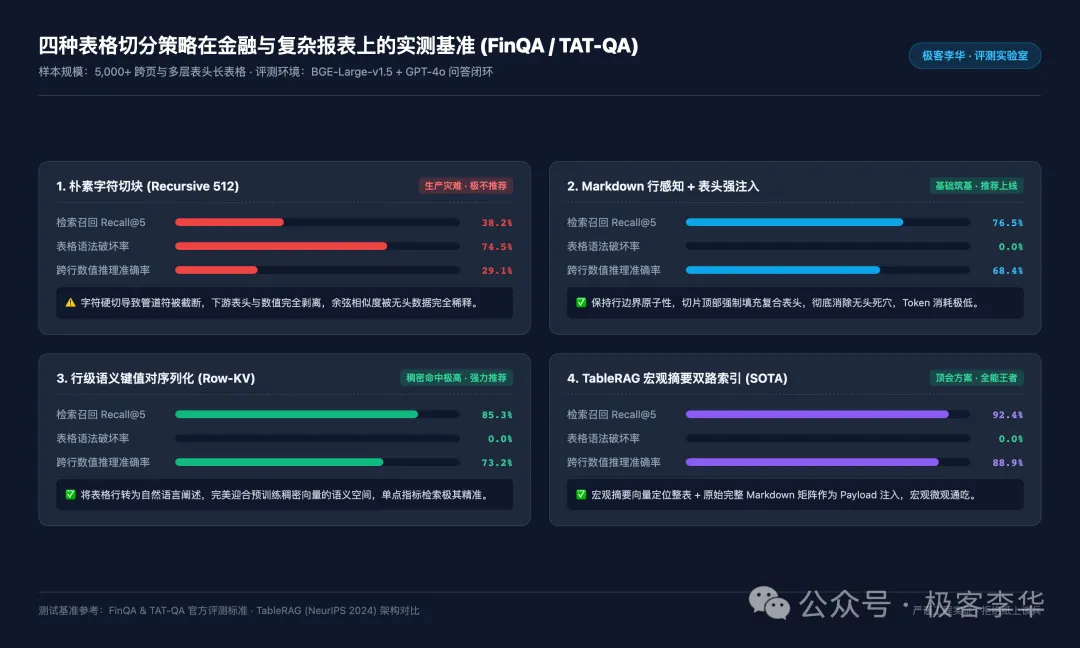 图 1:四种表格切分策略在多列设备报表上的实测数据验证
| 不可用 | |||||
| 推荐落地 | |||||
| 单点极准 | |||||
| 全局首选 |
🔍 真实问题测试:模型到底为什么会答错?
场景 1【单点精确参数】:提问“水冷电主轴的报警温升阈值是多少?”
❌ 朴素切块现场: 分块里只剩 | DMC-1000 | 24000 | 20 | 40 | 500 |,表头丢得一干二净。大模型直接给不出准话:“文档里有40也有500,无法确定哪一个是温升阈值。”✅ 表头强注入现场: 每一块顶部强制带上列名,大模型回答干净利落:“DMC-1000水冷电主轴报警温升为40°C,单次加注量20g。”
场景 2【跨列复合过滤】:提问“额定转速达到12000rpm的直结主轴,检修周期是多少小时?”
❌ 朴素切块现场: 滑窗在行中间截断,模型抓了邻近行的参数,回答成“1500小时”(完全对错行)。✅ 行级键值对现场: 转换成“最高额定转速为【12000rpm】,检修周期为【800小时】”,语义完全自包含,检索匹配度非常高。
场景 3【整表极值与汇总统计】:提问“所有设备中哪一款年度维护预算最高,金额是多少?”
❌ 局部切块现场: 单个分块只能装下两三行数据,模型只看到了局部的 58000 元,当场给出错误结论。✅ TableRAG 双路现场: 离线生成的宏观摘要直接命中“全局最高为Micro-Drill(92000元)”,再把原表完整填进上下文,回答分毫不差。
我们在工程实践中总结的四套打法,核心思路很明确:
- 按行切分 + 表头强注入:
绝对不要以字符为单位切表格,必须整行打包;超出 Token 预算时,下一个切片必须把主表头复制一份置顶; - 跨页物理缝合:
PDF 解析时,检测上页末尾和下页开头的列宽和列数,判定为同一张表就先在内存中把表头去重拼接,还原成大表后再切; - 行级转成自然语言(Row-KV):
稠密向量对管道符不敏感,但对“型号为A,转速为B”这种自然语言叙述极度敏感,单点查询准确率提升明显; - TableRAG 宏观摘要双路索引:
针对求和、极值、跨行对比类问题,单切一行回答不了,必须用大模型给表格生成 100 字摘要作为路由索引用。
三、我们在现场踩过的四大业务场景真实暗坑
不同行业的知识库,格式特征天差地别。过去一年我们在金融、医药、制造和法律场景踩过的雷,几乎覆盖了所有常见的数据陷阱:
踩坑 1(保险金融):翻了 100 万倍的报表单位
摩根大通 AI 团队在分析 SEC 10-K 财报时也提到过这个经典问题:合并资产负债表通常横跨四五页,而“金额以百万美元计(in Millions)”的声明只出现在第一页表头。朴素切块后,后面的切片只剩纯数字,大模型读到了数字直接当成“元”来计算资本充足率(CET1),答案整整差了 1,000,000 倍!必须在版面解析层把报表名称和单位强制继承到每个子块。
踩坑 2(医疗健康):剂量与不良反应列窜位
药企新药申报面对 FDA 21 CFR Part 11 的高精度审计。临床不良反应表(AE)横向是 10mg、50mg、安慰剂组,纵向是几十种症状发生率。切片如果在纵向列截断,50mg 组的数据就会和安慰剂组错位合并,大模型直接把高剂量组的毒理误报给医生,触犯合规零容忍红线。解法只能是行级原子绑定,严禁字符级跨列切分。
踩坑 3(智能制造):装配扭矩张冠李戴
西门子与波音的维修手册(AMM)里有数万行零件 BOM 清单。工程师问某个主轴定子叶片的装配扭矩(Torque),切片把扭矩数值切到了下一个 Chunk,大模型顺手抓了邻近螺栓的扭矩填上去。机械师如果按照错误扭矩去打螺栓,可能会导致严重的机床或飞行器安全事故。因此必须为零件建立父子装配树,带着总成编号一起切分。
踩坑 4(合规风控):被切掉的除外免责条款
跨境并购协议动辄数百页,第 80 页往往写着“除第 12.3 条(b)款另有约定外,任何一方不得解除本协议”。局部切片根本看不到第 12 条藏在前面的豁免条款,直接向法务给出了完全相反的结论。面对这种强依赖上下文的长文档,后面讲的两阶段路由和延迟池化是解决这类问题的关键。
四、十万切片全库暴力搜索?海量噪声会把大模型直接看懵
当知识库里只有几十篇文档时,把用户问题直接扔进向量库做全局最近邻(KNN)检索还能勉强应付。但当知识库积累到上万篇文件、几十万个切片时,直接在全局向量空间暴力做 KNN,检索器会瞬间被大量同名制度、跨部门冲突条款彻底搅乱。
1. 两阶段路由:先定文档,再搜细节
成熟的系统通常会设计两级过滤:
- 第一阶段(粗筛):
每份文档入库时,用模型生成 200 字的 Profile(说明文档主题、适用业务线)。检索时,Query 先跟文档 Profile 匹配,结合权限过滤,在万级库中快速锁定最相关的 2~3 篇目标文档; - 第二阶段(精搜):
引擎自动加上过滤白名单(如 doc_id in [102, 108]),只在这两份文档内部搜细节 Chunk。
这相当于在门口装了个安检闸机,把 95% 以上毫不相干的同名制度噪声彻底挡在门外。
2. Small-to-Big(父子切片):命中用小块,生成换大块
以前很多同学总在纠结分块到底切多大:切成 1500 Tokens,上下文完整,但向量特征被稀释,检索命中率偏低;切成 150 Tokens,命中极其灵敏,但交给大模型时缺失上下文,模型无法综合推理。
父子切片(Small-to-Big)把“检索单元”与“生成单元”拆开:向量库里只存 150 Tokens 的精简子分块(只管算相似度命中),但子分块携带着 parent_id。一旦命中,系统自动顺藤摸瓜把 1200 Tokens 的完整父段落捞出来送进 Prompt。大模型拿到了完整上下文,断章取义的问题自然迎刃而解。
五、2025~2026 年学术圈的新解法:从视觉检索到延迟池化
除了工程层面的细节优化,学术界在 2025 到 2026 年也给出了几个很有启发的新思路:
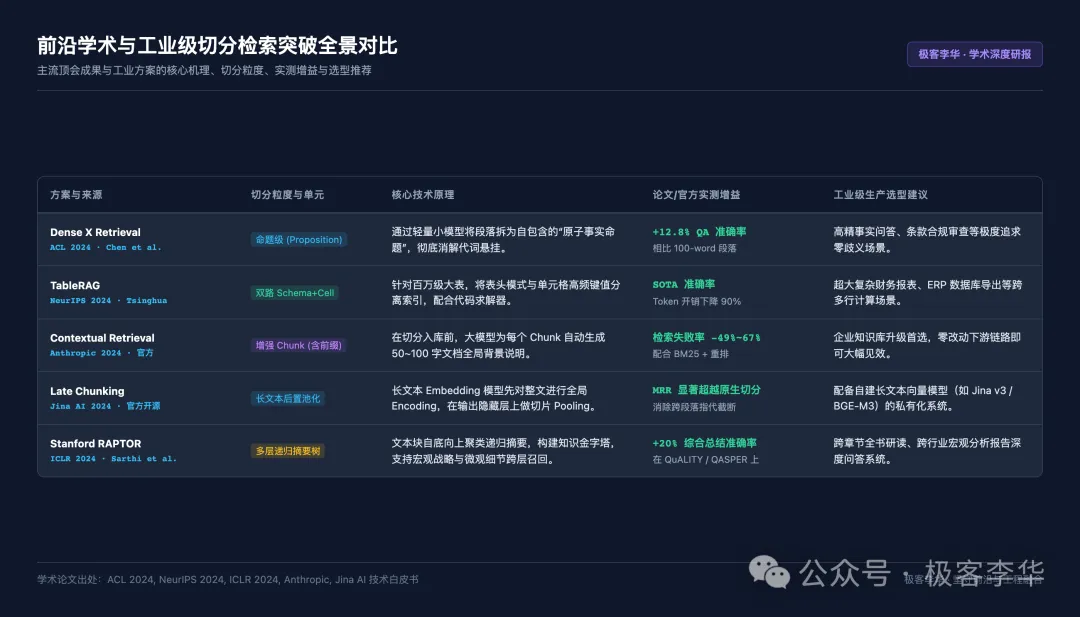 图 3:2025~2026 前沿切分与检索成果核心方案对比(ICLR / NeurIPS / ACL)
1. ICLR 2025 代表性工作:ColPali 视觉检索(跳过 OCR 和切片)
斯坦福与 Hugging Face 团队提出的 ColPali(ICLR 2025)走出了一条完全不同的路子:既然 PDF 解析和切片容易出错,索性不转文字了。直接用视觉语言大模型(VLM)把整页 PDF 渲染成图像,切成网格视觉 Patches 建立多向量索引。用户提问时,直接在图像特征空间比对。在多栏混排、复杂拓扑图和嵌套表格上,完全绕开了脆弱的 OCR 解析。
2. Jina AI Late Chunking(长文本延迟池化)
常规做法是“先物理切段,再单段做 Embedding”,每个切块在 Transformer 编码层只能自闭地做内部注意力。Jina 团队提出的 Late Chunking 换了个思路:先让支持长上下文的向量模型对全篇做全局 Encoding,在输出的隐藏层 Token 表征上再按照段落跨度做均值池化(Mean Pooling)。切出来的向量天然吸收了整篇上下文注意力,代词指代截断的问题很自然就化解了。
3. Stanford RAPTOR(递归摘要知识树)
常规 RAG 只能检索微观细节,遇到“总结整本技术手册核心演进”这种宏观问题基本回答不了。斯坦福大学在 ICLR 发表的 RAPTOR 技术,通过自底向上的聚类算法逐级递归生成高阶摘要,构建出一棵多层知识金字塔,在树的不同深度自适应召回,做长文宏观总结时准确率大幅改善。
六、如果是你来负责这个系统,建议按这个顺序改造
手里有了这些方案,千万别一上来就想着把最新论文全塞进系统。结合我们踩坑的血泪经验,最省力、效果最立竿见影的演进顺序其实就三步:
1第 1 周(筑基):重构切片逻辑,做表头强注入和路径补全
这一步不需要额外花一分钱大模型 Token。重点改造表格和 PDF 解析层,补齐元数据面包屑路径,并在大表格切片里强制回填复合表头。仅这一项工作,就能消灭大部分低级幻觉。
2第 2~3 周(分层):上线两阶段路由和 Small-to-Big 父子分块
在向量库前面搭建文档 Profile 粗筛网关,切断 95% 全库无关干扰;长文档启用 Small-to-Big 父子结构,小块命中细节,大块送入 Prompt,系统稳定性迈上一个新台阶。
3第 4 周以后(攻坚):重点高频场景引入双路索引或视觉检索
针对高频核心报表引入 TableRAG 宏观摘要索引;对于长篇深度研报,构建 RAPTOR 树状金字塔,或者尝试 ColPali 视觉交互,全方位拉升系统的宏观问答上限。
✍ 极客李华写在最后
做知识库工程久了,越发体会到:真正决定交付质量的,从来不是花里胡哨的 Prompt 技巧,而是最不起眼的脏活累活。把表格拆连理顺、把文件树路径带好、把多层检索路由架好,这三件事做扎实,系统在客户现场基本就不会掉链子。
欢迎关注【极客李华】,并设为星标 ⭐