ARTICLE · 1246654
【LevelDB 源码阅读】06 日志的物理格式:WAL
06 日志的物理格式
WAL
上一篇结尾留下了几个问题:log_->AddRecord 把 93 字节交出去之后,字节去了哪?一条 record 被切成 32KB 的 block 分片时发生了什么?写一半断电,恢复时的 CRC 检查和尾部截断,是怎么把“半个 batch”安全地丢掉的?以及 03 篇遗留的一个更早的问题:sync=false 时“进程被杀不丢数据、机器掉电可能丢数据”,这条边界的物理细节如何。
这一篇的任务就是把这一批债还清。我们仍旧考虑短链服务:写入洪峰里机器掉电,磁盘上的 log 文件停在一个任意的字节位置——可能是一条 record 的正中间,可能是 7 字节头刚写了 3 个字节,也可能什么都没少。重启之后,LevelDB 靠什么决定“恢复到哪一条”?
掉电前写到一半的日志,重启后怎么处理?——LevelDB 的答案是:让每条 record 自带 checksum、长度和类型,恢复时完整的重放、残缺的丢弃,把“恢复到哪”从一个难题变成一次线性扫描。
01
一条 record 长什么样
格式的定义集中在两个地方。db/log_format.h——这是一个很短的文件,拢共 35 行,包含了 writer 和 reader 共享的全部常量(log_format.h:14-30):
enum RecordType {// Zero is reserved for preallocated fileskZeroType = 0,kFullType = 1,// For fragmentskFirstType = 2,kMiddleType = 3,kLastType = 4};static const int kMaxRecordType = kLastType;static const int kBlockSize = 32768;// Header is checksum (4 bytes), length (2 bytes), type (1 byte).static const int kHeaderSize = 4 + 2 + 1;
配套的 doc/log_format.md 中还有一段描述,清楚地讲解了整个文件的格式:
block := record* trailer?record :=checksum: uint32 // crc32c of type and data[] ; little-endianlength: uint16 // little-endiantype: uint8 // One of FULL, FIRST, MIDDLE, LASTdata: uint8[length]
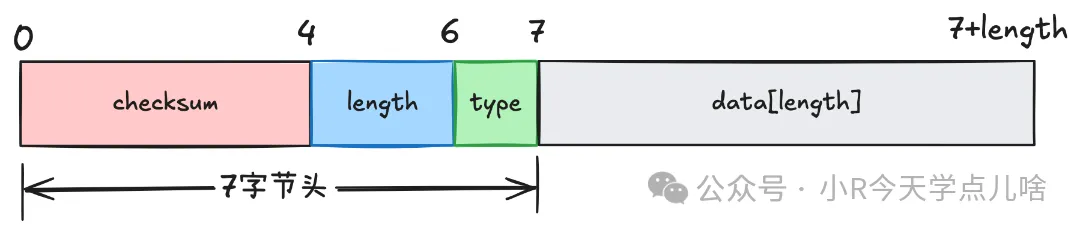
log 文件是一串 32KB 的 block(文件尾部允许最后一个 block 不满),每个 block 里是一条条连续的 record,每条 record 是 7 字节头 + 载荷:
checksum 4 字节(uint32)
length 2 字节(uint16)
type 1 字节(uint8)
checksum 和 length 两者均为小端。type 说的是这条物理 record 与它所属的逻辑 record 的关系——一个逻辑 record 如果塞得进剩余空间就是 FULL;塞不下就被切成若干片,第一片 FIRST、中间各片 MIDDLE、最后一片 LAST。
把 record 的字节布局画出来(数字为字节偏移):
看完了规则,我们拿一条真实的 record 来实际观察一下。用 05 篇的三合一 batch 原样重做一遍实验:新建库,写入那个 93 字节的 batch(sync=false),然后 kill -9。log 文件恰好 100 字节——7 字节头加 93 字节载荷,hexdump 出来(附录 crash_batch.cc 的 three 子命令):
00000000 26 73 05 f1 5d 00 01 01 00 00 00 00 00 00 00 03 |&s..]...........|00000010 00 00 00 01 07 63 3a 41 62 33 78 4b 23 68 74 74 |.....c:Ab3xK#htt|00000020 70 73 3a 2f 2f 65 78 61 6d 70 6c 65 2e 63 6f 6d |ps://example.com|00000030 2f 61 2d 76 65 72 79 2d 6c 6f 6e 67 2d 75 72 6c |/a-very-long-url|00000040 01 0f 75 3a 72 6f 62 69 6e 3a 63 3a 41 62 33 78 |..u:robin:c:Ab3x|00000050 4b 01 31 01 0d 63 3a 41 62 33 78 4b 3a 63 6c 69 |K.1..c:Ab3xK:cli|00000060 63 6b 01 30 |ck.0|00000064
我们逐段查看:
偏移 字节 含义------ ------------------ --------------------------------0 26 73 05 f1 checksum(小端 uint32,Mask 后的 CRC32C)4 5d 00 length = 0x005d = 93(小端 uint16)6 01 type = 1 = FULL7 01 00 ... 00 03 batch 载荷:seq=1(8B)+ count=3(4B)...------ ------------------ --------------------------------100 文件恰好在 record 末尾结束
93 字节的载荷与 05 篇手工推演的 batch 布局可以对上:seq=1、count=3,三条 kTypeValue record 依次是 c:Ab3xK、u:robin:c:Ab3xK、c:Ab3xK:click。write 路径没有对 batch 做任何再加工——AddRecord(Contents(write_batch)) 收到的就是 rep_ 原文,前面加 7 字节头,一条 FULL record,就这么多。
这 100 字节也验证了一件事:一个三合一 batch 在 WAL 里就是一条 record——05 篇那条结论,提交的最小单位是 WAL 的一条 record,而一条 record 恰好就是一个完整的 batch,在字节层面长这个样子。
顺手写了个小工具 wal_inspect(附录),不经过 log::Reader 的重组逻辑,直接按 32KB block 逐条走 record 头,把每个字段的值解出来、CRC 现场重算对照:
$ .output/wal_inspect .output/wal-three/000003.log -b[ 0] block 0 #0 type=FULL len= 93 crc=OK seq=1 count=3file size: 100 bytes
后面所有实验都会用它来给文件“拍 X 光”。
02
为什么切 32KB 的 block
既然追加写,一条 record 接一条 record 直接排下去不行吗?为什么要引入 block 这一层?主要有三重理由。
日志读到坏数据时,恢复手段只有“跳过一段再试”。如果没有 block,跳过之后从哪里开始试?只能碰运气地逐字节滑动。有了固定的 32KB 边界,答案变成确定的:跳到下一个 block 边界,从头扫。
一个字节翻转,最多污染它所在的 block,下一个 block 边界就是防火墙。
CRC 按 record 计算、按 block 隔离,一条损坏、只需要将它所在 block 的剩余部分丢弃掉,损失可控。
block 边界上还有两条规则。
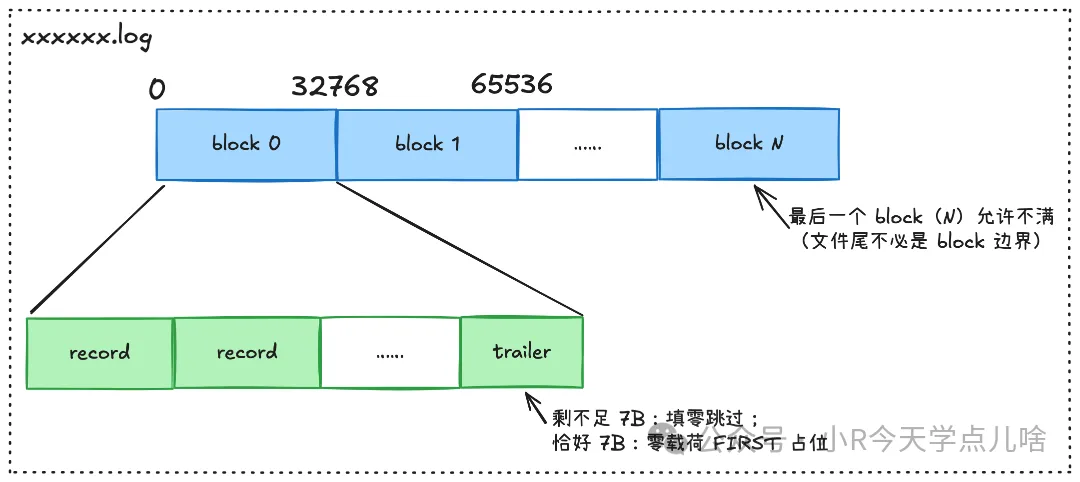
一条 record 绝不在 block 的最后 6 字节内起头,剩下不足 7 字节的空间必须填零,reader 跳过。
如果当前 block 恰好剩 7 字节,而下一条 record 非空,writer 必须在这 7 字节里发一条零载荷的 FIRST record 占位,把真正的数据全部挪到后面的 block。
分开看这两条规则也许不好理解,但把它们放到一起,我们可以发现它们共同维护着同一个不变量——任何 record 的头永远不会横跨 block 边界,reader 永远可以从 block 开头无歧义地顺序解析。
文件、block、record 的三层关系如下图:
读 log_reader.cc 的时候发现一个有意思的注脚:ReadRecord 的 kFullType/kFirstType 分支里各有一段“Handle bug in earlier versions of log::Writer”的兼容代码(log_reader.cc:93-117),说的是旧版 writer 曾在不该发的场合发过“块尾空 FIRST”,reader 至今带着补丁。也就是说“恰好剩 7 字节”这个边角的正确处理,历史上翻过车——格式文档里那句不起眼的 Aside 是有故事的。(具体是哪个版本引入的 bug,我没有考证,这里只转述注释。)
03
写侧走读:AddRecord 怎么操作的
格式了解清楚了,接下来我们看看 writer 怎么生产它。Writer::AddRecord(log_writer.cc:34-80)是一个 do-while 循环,每一轮“发射”一个物理 fragment(EmitPhysicalRecord,lol):
Status Writer::AddRecord(const Slice& slice) {const char* ptr = slice.data();size_t left = slice.size();// Fragment the record if necessary and emit it. Note that if slice// is empty, we still want to iterate once to emit a single// zero-length recordStatus s;bool begin = true;do {const int leftover = kBlockSize - block_offset_;assert(leftover >= 0);if (leftover < kHeaderSize) {// Switch to a new blockif (leftover > 0) {// Fill the trailer (literal below relies on kHeaderSize being 7)static_assert(kHeaderSize == 7, "");dest_->Append(Slice("\x00\x00\x00\x00\x00\x00", leftover));}block_offset_ = 0;}// Invariant: we never leave < kHeaderSize bytes in a block.assert(kBlockSize - block_offset_ - kHeaderSize >= 0);const size_t avail = kBlockSize - block_offset_ - kHeaderSize;const size_t fragment_length = (left < avail) ? left : avail;RecordType type;const bool end = (left == fragment_length);if (begin && end) {type = kFullType;} else if (begin) {type = kFirstType;} else if (end) {type = kLastType;} else {type = kMiddleType;}s = EmitPhysicalRecord(type, ptr, fragment_length);ptr += fragment_length;left -= fragment_length;begin = false;} while (s.ok() && left > 0);return s;}
循环体按照顺序做四件事:
当前 block 装不下一个头(leftover < 7)就填零 trailer 换新 block;
算出这个 block 还装得下多少载荷(avail,注意头本身要占 7 字节);
按”是不是第一片、是不是最后一片“的二维表格选出 type;
发射这一片,指针前移,直到载荷发完。
注意 static_assert(kHeaderSize == 7) 这一行:填 trailer 用的字符串字面量写死了 6 个零,格式头长度一变这行就得跟着改。
真正的“发射”逻辑在 EmitPhysicalRecord(log_writer.cc:82-108)中:
Status Writer::EmitPhysicalRecord(RecordType t, const char* ptr,size_t length) {assert(length <= 0xffff); // Must fit in two bytesassert(block_offset_ + kHeaderSize + length <= kBlockSize);// Format the headerchar buf[kHeaderSize];buf[4] = static_cast<char>(length & 0xff);buf[5] = static_cast<char>(length >> 8);buf[6] = static_cast<char>(t);// Compute the crc of the record type and the payload.uint32_t crc = crc32c::Extend(type_crc_[t], ptr, length);crc = crc32c::Mask(crc); // Adjust for storageEncodeFixed32(buf, crc);// Write the header and the payloadStatus s = dest_->Append(Slice(buf, kHeaderSize));if (s.ok()) {s = dest_->Append(Slice(ptr, length));if (s.ok()) {s = dest_->Flush();}}block_offset_ += kHeaderSize + length;return s;}
有三个细节值得我们关注。
我第一反应是:为什么不拼进一个 buffer 一次写?想了想这其实是个合理的选择——头是 7 字节的栈上小 buffer,载荷直接引用调用方的内存(在 Write 路径上就是 batch 的 rep_),两次 Append 省掉一次拼装大 buffer 的拷贝。而且这两次”写“多数时候只停留在用户态:PosixWritableFile 内部有一个 64KB 缓冲(kWritableFileBufferSize,env_posix.cc:58),record 装得进缓冲剩余空间时,头和载荷都只是 memcpy 进去,由 EmitPhysicalRecord 末尾的 Flush() 合成一次 write() 落进页缓存(env_posix.cc:265-292)——进程崩溃劈不开这种 record,内核还在,write() 不会写一半。真正能被劈开的是两种情况:载荷超过 64KB、装不下缓冲的大 record,头先随缓冲刷出去、载荷随后走 WriteUnbuffered 直写(env_posix.cc:285-291);以及 record 恰好骑在缓冲边界上,Append 的”先填满、刷出、再装剩余“逻辑把同一条 record 的字节拆成两批送进页缓存。后一种概率很小,但却真实存在——kill -9 实验里我们再来看它。
构造 Writer 时 InitTypeCrc 把每种 type 那 1 个字节的 CRC 先算好存起来(log_writer.cc:16-30),每条 record 只需在此基础上增量计算载荷部分。type 只有 5 个取值,每个都高频出现,这笔预计算是纯赚。
为什么?稍想一下就会发现 length 没法自我保护:校验范围(type+payload 有多少字节)本身要由 length 说了算,把被测对象请进裁判席是绕不出去的死循环;退一步说,就算把 length 塞进 CRC,失败时也分不清是 length 坏了还是载荷坏了,不带来新信息。真正要操心的是读取侧——一个不受保护的 length,读它的人该怎么对待?这个悬念留给 reader 一节。
Writer 还有第二个构造函数 Writer(dest, dest_length),把 block_offset_ 初始化为 dest_length % kBlockSize(log_writer.cc:27-30)。什么时候用?03 篇 RecoverLogFile 里”复用旧 log 接着写“的场景(db_impl.cc:480):接着一个已有内容的 log 追加,必须先对齐到它当前的 block 偏移,否则新旧 record 会在同一个 block 里踩到对方。
看一个真实的大 batch 分片。用 05 篇的 batch_bench 一次写 2000 条(单批约 76KB,必然跨 block),sync=false,进程正常退出——close 并不消费 log,消费发生在下次 open(03 篇见过),所以文件原样留在磁盘上,wal_inspect 看 log:
$ .output/wal_inspect .output/wal-big/000003.log -b[ 0] block 0 #0 type=FIRST len=32761 crc=OK seq=1 count=2000[32768] block 1 #1 type=MIDDLE len=32761 crc=OK[65536] block 2 #2 type=LAST len=10490 crc=OKfile size: 76033 bytes
一个逻辑 record 切成三片:block 0 装满 32761 字节(FIRST),block 1 又装满 32761 字节(MIDDLE),剩下的 10490 字节收尾(LAST)。32761 × 2 + 10490 = 76012 字节载荷,加三个 7 字节头,76033 字节,与文件大小严丝合缝。seq/count 只在第一条物理片里出现——它本来就是 batch 头的一部分,跟着载荷的第一片走。
把这次分片画成图:
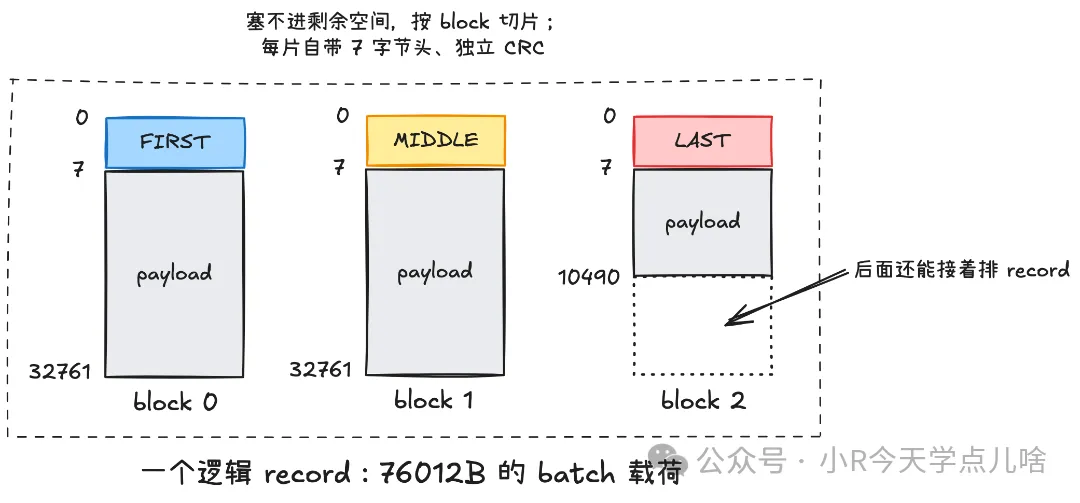
四种 type 至此各就各位:装得下的是一片 FULL——前面那条 93B 的三合一 batch 就是这个形态;装不下就 FIRST 起头、MIDDLE 接力、LAST 收尾。
CRC32C 在这个格式里的职责被严格限定:只告诉你这条 record 是否损坏。坏了的处置方式只有一种——丢弃。这是与”纠删码/ECC“一类技术的分界线,日志场景选择检测 + 丢弃,因为发送端(写路径)随时可以重试或重放,接收端没有必要背负修复的复杂度。
实现上一句话带过:util/crc32c.cc 首次使用时用已知向量探测 CPU 是否支持 SSE4.2 的 CRC32C 硬件指令(port::AcceleratedCRC32C),不支持就退回查表的软件实现(crc32c.cc:265-280)。
还有一个细节:存进文件的 CRC 不是裸值,而是经过 Mask 变换的(EmitPhysicalRecord 里那句 crc = crc32c::Mask(crc))。util/crc32c.h 的注释解释了动机(crc32c.h:22-38):如果数据里嵌着它自己的 CRC 裸值,对这段数据再做 CRC 会产生病态的相关性(”计算包含内嵌 CRC 的字符串的 CRC 是有问题的“);Mask 把 CRC 循环右移 15 位再加上一个固定常数,破坏这种规律,Unmask 可逆。读侧的校验就是 Unmask(DecodeFixed32(header)) 对比重算值(log_reader.cc:245-246)。
04
读侧走读:重组,与三种“静默”
Reader::ReadRecord(log_reader.cc:56-174)是一个状态机,外层循环不断调 ReadPhysicalRecord 拿物理片,按 type 归位:
Slice fragment;while (true) {const unsigned int record_type = ReadPhysicalRecord(&fragment);// ...}
FULL 直接返回;
case kFullType:if (in_fragmented_record) {// Handle bug in earlier versions of log::Writer where// it could emit an empty kFirstType record at the tail end// of a block followed by a kFullType or kFirstType record// at the beginning of the next block.if (!scratch->empty()) {ReportCorruption(scratch->size(), "partial record without end(1)");}}prospective_record_offset = physical_record_offset;scratch->clear();*record = fragment;last_record_offset_ = prospective_record_offset;return true;
FIRST 存进 scratch、标记 in_fragmented_record;
case kFirstType:if (in_fragmented_record) {// Handle bug in earlier versions of log::Writer where// it could emit an empty kFirstType record at the tail end// of a block followed by a kFullType or kFirstType record// at the beginning of the next block.if (!scratch->empty()) {ReportCorruption(scratch->size(), "partial record without end(2)");}}prospective_record_offset = physical_record_offset;scratch->assign(fragment.data(), fragment.size());in_fragmented_record = true;break;
MIDDLE 追加;
case kMiddleType:if (!in_fragmented_record) {ReportCorruption(fragment.size(),"missing start of fragmented record(1)");} else {scratch->append(fragment.data(), fragment.size());}break;
LAST 追加后把 scratch 整体交出去——分片的重组就是这么朴素,一个字符串拼接到尾。
case kLastType:if (!in_fragmented_record) {ReportCorruption(fragment.size(),"missing start of fragmented record(2)");} else {scratch->append(fragment.data(), fragment.size());*record = Slice(*scratch);last_record_offset_ = prospective_record_offset;return true;}break;
还有两个分支是对“读不下去”的处理。仔细区分,reader 面对两种性质完全不同的异常,态度也截然不同。
第一种:文件到头了(EOF)。 “写一半”的 log 是正常产物——任何一次崩溃都会留下一个停在任意字节的文件,恢复机制必须把它当常态消化。所以截断类的 EOF 一律静默,不报告、不报错,只是安静地丢弃,忽略这一条。具体有三条代码路径,分别对应”断在哪里“的三种可能:
头都没写完。ReadPhysicalRecord 发现缓冲区不足 7 字节且已到文件尾(log_reader.cc:206-213),注释写得很清楚:这是 writer 写头写到一半崩了,当作 EOF 处理。后面 truncate 矩阵里截断在 110 字节那一行(r1 只剩 3 个字节的残头)走的就是这个分支。
// Reader::ReadPhysicalRecordelse {// Note that if buffer_ is non-empty, we have a truncated header at the// end of the file, which can be caused by the writer crashing in the// middle of writing the header. Instead of considering this an error,// just report EOF.buffer_.clear();return kEof;}
头完整、载荷不完整。头里声明的 length 超出文件剩余内容(log_reader.cc:222-233):如果不是文件尾,报 bad record length 损坏;是文件尾,静默 EOF——writer 写载荷写到一半崩了。
// Reader::ReadPhysicalRecordif (kHeaderSize + length > buffer_.size()) {size_t drop_size = buffer_.size();buffer_.clear();if (!eof_) {ReportCorruption(drop_size, "bad record length");return kBadRecord;}// If the end of the file has been reached without reading |length| bytes// of payload, assume the writer died in the middle of writing the record.// Don't report a corruption.return kEof;}
逻辑 record 拼了一半到头。FIRST 甚至 MIDDLE 都读到了,文件结束(log_reader.cc:144-151),注释同样直白:writer 写完一个物理片、还没写完下一个就死了,不算损坏,整条逻辑 record 静默丢弃。
// Reader::ReadRecordcase kEof:if (in_fragmented_record) {// This can be caused by the writer dying immediately after// writing a physical record but before completing the next; don't// treat it as a corruption, just ignore the entire logical record.scratch->clear();}return false;
第二种:数据坏了(corruption)。 CRC 对不上,或者中段冒出读不通的 length。这不是正常崩溃的产物,而是磁盘、传输层面的真问题,reader 会老老实实报告——但报告之后继续往下读,恢复流程不停。
其中最要紧的是 checksum mismatch 的处置(log_reader.cc:243-257):
// Check crcif (checksum_) {uint32_t expected_crc = crc32c::Unmask(DecodeFixed32(header));uint32_t actual_crc = crc32c::Value(header + 6, 1 + length);if (actual_crc != expected_crc) {// Drop the rest of the buffer since "length" itself may have// been corrupted and if we trust it, we could find some// fragment of a real log record that just happens to look// like a valid log record.size_t drop_size = buffer_.size();buffer_.clear();ReportCorruption(drop_size, "checksum mismatch");return kBadRecord;}}
buffer_ 里是整个 32KB block。CRC 失败,丢的不是这一条 record,而是整个 block 的剩余部分。为什么这么做?回想上一节的悬念:length 字段不在 CRC 的覆盖范围内。CRC 失败时你无从知道是载荷坏了还是头坏了——如果 length 本身就是坏数据,顺着它走下去,可能在一堆噪声里”恰好“解出一条 CRC 也对得上的假 record(32 位 CRC 挡不住精心或碰巧的碰撞)。唯一的安全做法是退到下一个可信边界:block 开头。”坏长度不可信,那就一个字节都别信“——这是一条看似粗暴却很实用的防御性读取原则。
还有个分支:kZeroType 且长度为 0 的 record 直接跳过、不报损坏(log_reader.cc:235-241),注释说这是 env_posix.cc 里 mmap 预分配文件区域的产物——kZeroType 这个枚举值就是为它保留的,正常写路径永远不会产生。
if (type == kZeroType && length == 0) {// Skip zero length record without reporting any drops since// such records are produced by the mmap based writing code in// env_posix.cc that preallocates file regions.buffer_.clear();return kBadRecord;}
05
损伤实验:数据缺失与损坏
读完代码,我们脑子里也对整个流程有了一个初步的认识,下一步就是动动手,确认下我们的认识是否正确。
我们不可能在程序运行时去拔掉电源,看看掉电后怎么处理,只能在代码上”动动手脚“,主动制造损伤——这里我的方法是:直接对 log 文件做字节级操作(截断、翻转)。写了个 wal_torn 工具(附录),先构造一个”全形态“文件:4 条逻辑 record,[100, 32650, 70000, 100] 字节,一个文件集齐 FULL、4 字节 trailer、FIRST/MIDDLE/LAST 跨 block 序列、再来一条 FULL:
$ .output/wal_torn make .output/torn.logwrote 4 records: [100, 32650, 70000, 100] -> .output/torn.log$ .output/wal_inspect .output/torn.log[ 0] block 0 #0 type=FULL len= 100 crc=OK[ 107] block 0 #1 type=FULL len=32650 crc=OK[32764] block 0 trailer 4 bytes (all zero)[32768] block 1 #2 type=FIRST len=32761 crc=OK[65536] block 2 #3 type=MIDDLE len=32761 crc=OK[98304] block 3 #4 type=LAST len= 4478 crc=OK[102789] block 3 #5 type=FULL len= 100 crc=OKfile size: 102896 bytes
r0(100B 的 FULL)和 r1(32650B 的 FULL)都落在 block 0:107 + 7 + 32650 = 32764,块尾恰好剩 4 字节,正好展示一条真实的全零 trailer。r2(70000B)跨三个 block 被切成 FIRST/MIDDLE/LAST。r3 收尾。
给 torn.log 画张全景图(方括号内是各段字节数:record 记 头+载荷,trailer 记填零宽度;右侧是该 block 的偏移区间):
block 0 [r0 FULL 7+100B ] [r1 FULL 7+32650B ] [trailer 4B zeros] [0, 32768)block 1 [r2 FIRST 7+32761B ] [32768, 65536)block 2 [r2 MIDDLE 7+32761B] [65536, 98304)block 3 [r2 LAST 7+4478B ] [r3 FULL 7+100B ] (free) [98304, 102896)
后面 truncate 和 flip 两类实验都是在这张图的不同位置动刀——r0~r3 的位置记住了,下面的矩阵就好读了。
把文件截断到不同偏移,模拟”写到一半断电“,每个点都先重新 make 再截断再读:
| 截断到 | 截断位置 | 恢复 | reader 的反应 |
五次截断,零报告。这正是上一节“三种静默”的实测版:无论断在头的中间、载荷的中间还是恰好齐整的 record 边界,reader 都把它当作“writer 死在半路”的正常现场,安静地恢复到此为止。
要把”reader 的反应“一列对回代码,得看 ReadPhysicalRecord 的入口(log_reader.cc:190-214,后半省略):
// Reader::ReadPhysicalRecord 入口(log_reader.cc:190-214)while (true) {if (buffer_.size() < kHeaderSize) {if (!eof_) {// Last read was a full read, so this is a trailer to skipbuffer_.clear();Status status = file_->Read(kBlockSize, &buffer_, backing_store_);end_of_buffer_offset_ += buffer_.size();if (!status.ok()) {buffer_.clear();ReportDrop(kBlockSize, status);eof_ = true;return kEof;} else if (buffer_.size() < kBlockSize) {eof_ = true;}continue;} else {// Note that if buffer_ is non-empty, we have a truncated header at the// end of the file, which can be caused by the writer crashing in the// middle of writing the header. Instead of considering this an error,// just report EOF.buffer_.clear();return kEof;}}// ...
我们一行行看上面列出的表格。55、40000、102846 三行的头都解析得出来,死在后面的载荷长度检查上——头里声明的 length 超过了文件实有字节,且 eof_ 已置位,于是走上一节”头完整、载荷不完整“的静默路径(log_reader.cc:222-233)。40000 那行还有个细节:截断的是 r2 FIRST 片的载荷,片本身就没读出来,in_fragmented_record 从未置位——上一节第三条路径里”清空 scratch“的分支(log_reader.cc:145-150)在这张表里一次都没触发。要请它出场,得断在两片之间的缝隙里,比如恰好 65536:FIRST 片完整读到了、MIDDLE 还没影,实测同样是静默的 2/4。
再看 107 和 110 这两行——断点齐整与否,恢复条数一模一样。我起初以为这是两条分支,对着代码看了一遍才发现,它们最终都走到了同一个逻辑 return kEof:截断在 107 时,r0 刚好消费完,下一轮进来 buffer_ 已经空了,buffer_.size() < kHeaderSize 以 0 < 7 成立;截断在 110 时,buffer_ 里还攥着 r1 的 3 字节残头,同一个判断以 3 < 7 成立。差别只在离开时 buffer_ 里有没有东西可清——注释那句”if buffer_ is non-empty, we have a truncated header“说的正是后一种现场。一条分支消化两种情况,这在读代码时容易漏掉。
数据缺失部分我们模拟了”文件少了一截“,位翻转模拟的是”字节坏了“——后者才会触发 CRC。翻转 r0 载荷里的一个字节(偏移 60,block 0 内部):
$ .output/wal_torn flip .output/torn2.log 60flipped byte at 60 (0x61 -> 0x9e)$ .output/wal_torn read .output/torn2.log[reporter] dropping 32768 bytes: Corruption: checksum mismatchrecovered record #1: 70000 bytes (head: Z x 1)recovered record #2: 100 bytes (head: x x 1)readdone: 2/4 records recovered from 102896 bytes
r0 坏了,意料之中;但注意 r1 也阵亡了——明明 r1 自己完好无损。原因就是上一节那条”丢整个 block 剩余部分“的规则:CRC 失败后 length 不可信,r1 和 r0 同在 block 0,被连带丢弃。这是”不信 length“策略的代价,用一条无辜的 record 换取”绝不采信假 record“的保证。而 r2 虽然起点在 block 1、身体横跨三个 block,它的 FIRST 片完好,重组不受影响——爆炸半径被 block 0 的边界死死圈住。
再翻转 r2 的 MIDDLE 片里的一个字节(偏移 70000,block 2 内部):
$ .output/wal_torn flip .output/torn3.log 70000flipped byte at 70000 (0x5a -> 0xa5)$ .output/wal_torn read .output/torn3.logrecovered record #1: 100 bytes (head: a x 1)recovered record #2: 32650 bytes (head: b x 1)[reporter] dropping 32768 bytes: Corruption: checksum mismatch[reporter] dropping 32761 bytes: Corruption: error in middle of record[reporter] dropping 4478 bytes: Corruption: missing start of fragmented record(2)recovered record #3: 100 bytes (head: x x 1)readdone: 3/4 records recovered from 102896 bytes
r2 一条逻辑 record 的死亡,被 reporter 讲成了一个三幕悲剧:checksum mismatch 丢弃整个 block 2(32768 字节)——MIDDLE 片所在的 block;此时 scratch 里还攒着它的 FIRST 片,进入 kBadRecord 分支触发 error in middle of record(32761 字节,正是 FIRST 片的长度);
case kBadRecord:if (in_fragmented_record) {ReportCorruption(scratch->size(), "error in middle of record");in_fragmented_record = false;scratch->clear();}break;
等扫描推进到 block 3,迎面撞上孤零零的 LAST 片,missing start of fragmented record(4478 字节)。
case kLastType:if (!in_fragmented_record) {ReportCorruption(fragment.size(),"missing start of fragmented record(2)");} else {// ...}break;
而 block 0 的 r0、r1 和 block 3 的 r3 全部幸存——1 个字节的损伤,半径精确等于 1 个 block。
两个实验对照出一条干净的分界:尾部缺损静默,中段损坏报告。前者是每次崩溃的必然后果,后者才值得写进日志让人排查。
06
kill -9 之后:恢复恰好停在 batch 边界上
物理层的最后一块拼图:真实进程的 kill -9,恢复到底停在哪里。crash_batch(附录)先往一个新库连续写 batch(每批 100 条短链,每批一次 Write,sync=false),写的过程中从外部 kill -9。重启数数之前,先用 wal_inspect 给 log 拍张 X 光——reopen 会消费掉 log 文件(03 篇见过的现象),取证必须跑在前面:
$ .output/crash_batch write .output/wal-bench 1000 100 &$ sleep 0.08 && kill -9 %1 # 退出码 137$ .output/wal_inspect .output/wal-bench/000003.log -b | head -1[ 0] block 0 #0 type=FULL len= 4212 crc=OK seq=1 count=100$ .output/wal_inspect .output/wal-bench/000003.log -b | tail -2[856639] block 26 #229 type=FULL len= 4212 crc=OK seq=20301 count=100file size: 860858 bytes$ .output/wal_inspect .output/wal-bench/000003.log -b | grep -c "seq="204$ .output/wal_inspect .output/wal-bench/000003.log | grep -c "type=FULL"178$ .output/crash_batch count .output/wal-bench 100recovered 20400 links (last: c:K00020399)aligned to batch boundary (per=100): YES (204 batches)
文件一侧,log 里不多不少 204 条 record:`seq=` 的取值从 1 递增到 20301、步长恰好 100,每条 count=100;最后一条 record 起点在 856639,7 字节头加 4212 字节载荷走完,正好是文件大小 860858——文件在 record 边界上干净收尾,第 205 个 batch 连一个字节都没落盘。恢复一侧,重启数出来 20400 条 = 204 × 100,最后一条 key `c:K00020399` 正是 seq=20301 那条 record 的第 100 条。文件里躺着几条 record,恢复就重放出几批数据,两侧严丝合缝——”完整的重放、残缺的丢弃“在真实崩溃现场对上了账。
顺手再验证一件事:`grep -c "type=FULL"` 数出来只有 178——204 条里有 26 条撞上了 32KB block 边界,被切成 FIRST/LAST 两片(4212 字节的载荷不足 32KB,至多两片),物理 record 总数 178 + 26 × 2 = 230,最后一条编号 #229,对上。4219 字节一条的 record 与 32768 的 block 并不对齐,分片在真实写入里是常态而非例外,reader 的重组逻辑一直在默默干活。
为什么能这么齐?两层保证共同作用。
第一层:sync=false 时字节已经通过 write() 进了操作系统页缓存,进程死亡不带走页缓存,所以 204 个完整 batch 的 record 一个不缺、也不多——内核还在,写过的字节都在。
第二层:就算击杀的瞬间不巧落在第 205 个 batch 的 EmitPhysicalRecord 里,结局也只有三种——字节还全部或部分留在 64KB 用户态缓冲里没刷出去,随进程一起消失,磁盘上什么都不多;已经完整落进页缓存,第 205 批照样算数;或者恰好骑在缓冲边界上只落了一半,成为残缺 record,恢复时被上一节的静默 EOF 路径原样丢弃。无论落在哪种,完整的重放,残缺的丢弃,恢复出来的集合永远是”完整 batch 的前缀“,count % 100 == 0 不是运气,是格式的性质。
07
为什么“直接丢弃”是安全的
现在可以正面回答标题问题了:掉电前写到一半的日志,重启后怎么处理?——完整 record 重放,残缺 record 丢弃。但”丢弃“凭什么安全?丢掉的会不会是已经提交给用户的数据?
不会,判据是 05 篇建立的那个提交点:DBImpl::Write 里 AddRecord(以及可选的 Sync)成功、InsertInto 完成、唤醒等待的 writer,这之后 Write 才返回 OK(db_impl.cc:1228-1263)。一条 record 只有完整地跨过了崩溃边界,它对应的 `Write` 才可能返回过成功;反过来,残缺 record 对应的那次 Write 必然还没返回——调用方拿到的是错误或压根没拿到结果,这批数据本来就不算数,丢了正是语义要求的。恢复丢弃的,从来只是”用户不知道成没成“的写,而不是”用户以为成了“的写。
这里还有一层容易被忽略的细节:恢复时的 reader 是强制开校验的。RecoverLogFile 构造 reader 的地方带着一段注释(db_impl.cc:418-422):
// We intentionally make log::Reader do checksumming even if// paranoid_checks==false so that corruptions cause entire commits// to be skipped instead of propagating bad information (like overly// large sequence numbers).log::Reader reader(file, &reporter, true /*checksum*/, 0 /*initial_offset*/);
即使 paranoid_checks=false(reporter 的 status 为空,只往 LOG 文件打一行 (ignoring error) dropping N bytes),校验也照做——宁可整批跳过,也不能让坏数据(比如一个坏掉的序列号)污染 MemTable。校验可以低调,但从不缺席。
而提交点的另一半——Sync 失败怎么办——库的态度同样干脆:RecordBackgroundError,之后所有写失败(db_impl.cc:1242-1247)。注释说得很直白:此时 log 文件状态不确定,宁可把库逼进”未来所有写都失败“的模式,等人工介入,也不假装无事发生。
08
回到 03 篇遗留的问题:Flush、Sync 与数据丢失窗口
03 篇说 sync=false ”进程崩溃不丢、机器掉电可能丢“,物理细节在这一节中我们都看到了。EmitPhysicalRecord 末尾那句 dest_->Flush() 不是 fsync——WritableFile 的接口语义里,Flush 只是把库内部缓冲的字节交给操作系统(env_posix.cc 里 Flush() 转发 FlushBuffer(),env_posix.cc:304),数据落在页缓存里;真正把页缓存推向磁盘的是 Sync()(SyncFd,最终 fdatasync / fsync,env_posix.cc:306、369)。所以:
sync=false:AddRecord + Flush 就返回。页缓存里的字节进程死了也在(kill -9 实验的 20400 条就是证据),但整机断电页缓存蒸发,最后若干条 record 消失——丢失的单位是 record,也就是 batch,所以丢也是”整批整批地丢“,不会丢出半个 batch;
sync=true:Write 路径在 AddRecord 后追加一次 logfile_->Sync()(db_impl.cc:1232-1237),语义上从 write(2) 升级成 write(2)+fsync(2)。include/leveldb/options.h 对 WriteOptions::sync 的文档注释(options.h:168-182)把这两档语义写得非常清楚,包括”sync=true 会显著变慢“。有多慢、以及攒批怎么把这笔钱赚回来,05 篇的表格已经算过这笔账,这里不再赘述。
顺带一个 macOS 特供的冷知识:env_posix.cc 的注释提到,macOS 的 fsync() 不保证掉电后数据仍在,所以 LevelDB 在这个平台走 F_FULLFSYNC(env_posix.cc:371-374)——04 篇实测这台机器 fsync 慢得离谱,此刻有了合理的解释,同时备注中我也大概描述了原因。
最后补上 log 文件生命周期的边界:这个文件什么时候产生、什么时候删掉,属于 MemTable 切换与 flush 的地盘。根据 03 篇 reopen 实验里见过现象,我们不妨猜测:写满 4MB 换新文件,旧 log 的内容落成 L0 SSTable 之后整文件删除,但我们的猜测对不对,留待后续文章展开。
09
MANIFEST:同一套格式的第二位用户
读到这里你可能以为这套 record 格式是 WAL 专用的——不是。MANIFEST 文件(元数据日志)用的是同一套 log::Writer / log::Reader:建库时 NewDB 用 log::Writer 写下第一条 VersionEdit;运行期 VersionSet 每次 LogAndApply 都把一条 VersionEdit 编码后 AddRecord;恢复时用 log::Reader(checksum 同样强制打开)重放。一份“checksum + length + type + 块分片”的格式同时服务数据日志和元数据日志。
10
对比参照:三种日志,分别记录得是什么
WAL 不是世界上唯一的日志,把三个熟悉的系统摆在一起看“日志里记什么、恢复时干什么”,约束与设计的对应关系会清楚很多。
文本的 SET key value 命令流,恢复 = 把命令从头重新执行一遍,在内存里重建全部状态。持久化策略是显式的旋钮:appendfsync always/everysec/no。
512 字节固定 block(对齐磁盘扇区),每条记录说的是“某页某偏移改成了什么”,外加全局单调的 LSN 把所有变更放在一条时间线上,恢复 = 从 checkpoint 起重放。
既不是命令文本也不是页级物理变更,而是把提交的原子单位——batch 的 rep_——原样快照下来。恢复不需要理解内容语义:SetContents 灌回一个 batch、InsertInto 重放,写路径怎么写、恢复路径就怎么吃。
11
工程启示
按崩溃场景选 sync,而不是无脑 true。 sync=false 的数据丢失窗口很明确:只有整机断电才会丢,丢失单位是完整 batch;进程崩溃(含被管理器 kill、panic 重启)一分不丢。短链服务里,点击计数这类容忍少量丢失的写完全可以用 false,创建短链这类关键写要么 true,要么参考 05 篇的攒批方案把 fsync 的钱赚回来。
fsync 失败不是普通错误。 一旦发生,库进入“所有后续写失败”的模式,这是刻意设计。监控上要把写错误与 LOG 里的背景错误一起告警,别当成偶发抖动重试了事。
对 .log 文件做取证,务必在 reopen 之前。 恢复成功的那一刻旧 log 就被消费删除了,hexdump、wal_inspect 都要先做。
paranoid_checks=false 不代表恢复不校验。 reader 永远开着 CRC,只是损坏时降级为 LOG 里一行 dropping N bytes 而已。定期 grep 一下 LOG 文件里的 dropping,是发现磁盘静默损坏的廉价手段。
checksum + length + type 的自描述 record 加固定 block,是一套可以直接借鉴的 append-only 文件格式。 LevelDB 自己就用它同时支撑了 WAL 和 MANIFEST 两种语义迥异的日志。自己的场景里要做持久化队列、操作流水、binlog,照抄这 7 字节头加 32KB block 就有及格线以上的健壮性。
不被 checksum 保护的字段,出错后就不要再信。 length 不在 CRC 覆盖内,于是 CRC 失败时干脆丢弃整个 block 剩余部分,退到下一个可信边界。任何自描述格式都要回答“元数据坏了怎么办”,这个“宁可多丢、不可错信”的答案值得记住。
把“写一半”和“数据损坏”当成两类事件。 EOF 类(尾部残缺)静默处理,因为它是每次崩溃的必然副产品;corruption 类(中段损坏)如实报告,因为它指向真实的硬件或软件问题。日志系统里这种分类让监控信号干净——静默的不是问题,报告的才值得查。
到这里,之前文章中欠下的两笔债都还清了。93 字节出了 AddRecord 的门,先被套上 7 字节的头(checksum + length + type),变成一条 100 字节的 FULL record;大 batch 撞上 32KB block 边界,被切成 FIRST/MIDDLE/LAST 的接力;掉电留下的残缺尾巴,恢复时被三种静默路径截得整整齐齐;翻转的字节则被 CRC 揪住、连坐整个 block,但火势绝不越过块边界。sync=false 的数据丢失窗口,也终于有了字节级的账目:正是页缓存里那些“进程死了还在、机器死了才没”的 record。
可是故事只讲了一半。恢复时 InsertInto 把 20400 条短链一条条插回了 MemTable,写路径上每一个 batch 落 WAL 之后也立刻进了同一个地方——这个所有写入的必经之地、库内存里唯一可变的数据结构,内部长什么样?为什么它选了跳表,而不是红黑树或者哈希表?
下一篇,我们进入 MemTable 的世界。