ARTICLE · 1223187
AI 检测报告只能证明「像」,证明不了「是」
17000 字自己写的:一个平台 27%,另一个 95%
它量的是「这段话有多好预测」,不是「这段话是谁写的」。斯坦福研究:61.3% 的非母语作文被误判;华盛顿州立、滑铁卢、开普敦已停用或禁用检测器。
先讲一个真实的事,细节来自《光明日报》2026 年毕业季的调研报道。
广东省某高校文学院的大四学生张理(化名),写了一篇 17000 字的毕业论文,一字一句自己写的。
学校提供的 AI 检测平台测出来:AI 率 27%,符合要求。
但在第三方盲审环节,另一款软件给出的数字是:AI 率 95%。
同一篇论文,两个平台,差了 68 个百分点。 而多数高校的合格线定在 30%—40%。也就是说,这个差值比合格线本身还宽。
张理立刻申诉,提交了开题报告、原始提纲、不同版本的修改意见,几次补充材料,等专家组评议。最后 AI 率被修正为 32%——踩着最后时限惊险过关。
01先说清检测工具到底在测什么
这是整篇文章最需要讲明白的一点,因为大部分误解都从这里来。
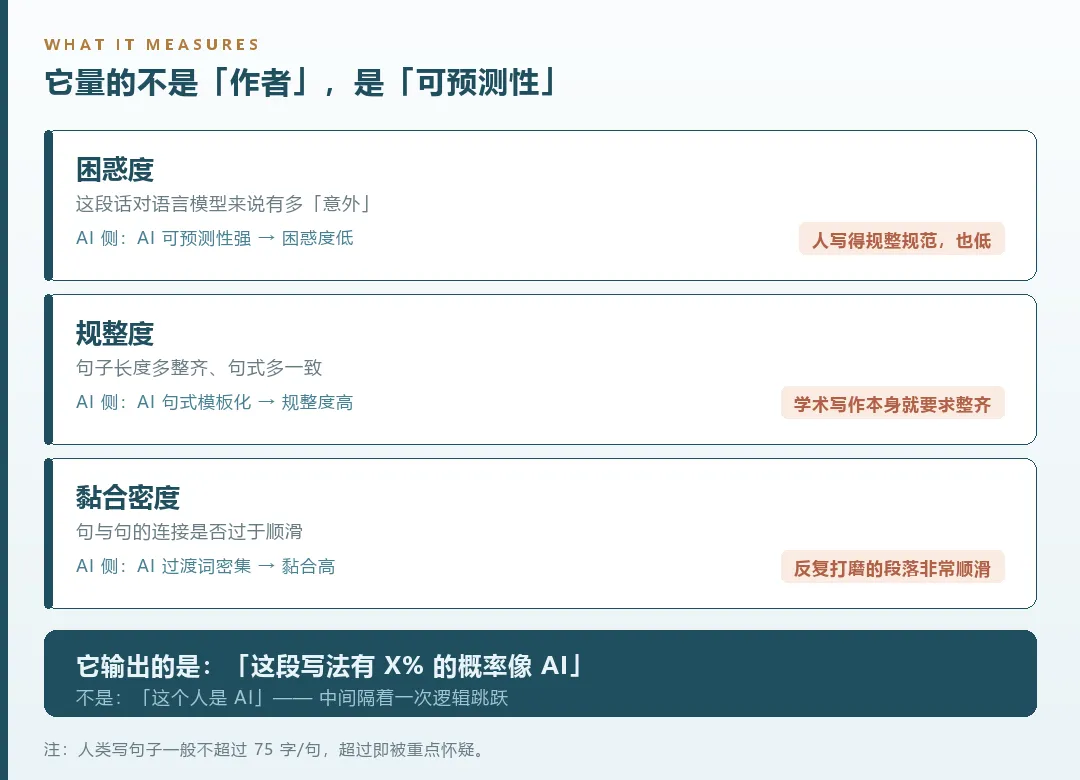
AIGC 检测不比对数据库。它和查重是两套完全不同的东西——查重是拿你的句子去和已发表的文献比,看有没有重复;AIGC 检测没有可比对的"标准答案",它做的是统计推测。
主流的判定依据是三个指标:
| 困惑度 | ||
| 规整度 | ||
| 黏合密度 |
一位开源了 AIGC 检测工具的计算机专业研究生刘嘉,把这个逻辑讲得很直白:人类的写作"总是充满多样性和意外",AI 的"很大概率是规整、逻辑严密的句式"。他还提到一个细节——人类写句子一般不超过 75 个字/句,超过就值得怀疑。
所以,检测工具输出的是这样一个判断:
"这段话的写法,有 X% 的概率是 AI 生成的。"
请注意它说的是什么:"写法像 AI",不是"作者是 AI"。
这两件事之间隔着一次逻辑跳跃。而学校在流程里,把这个概率数字直接当成了"有没有作弊"的证据。
一次统计推测,被当成了事实认定。
02误判不是意外,是结构性的
如果只是偶尔出错,那还能叫误差。但研究数据说明,它是这个工具的固有缺陷。
第一组:混合文本的准确率会掉下来。
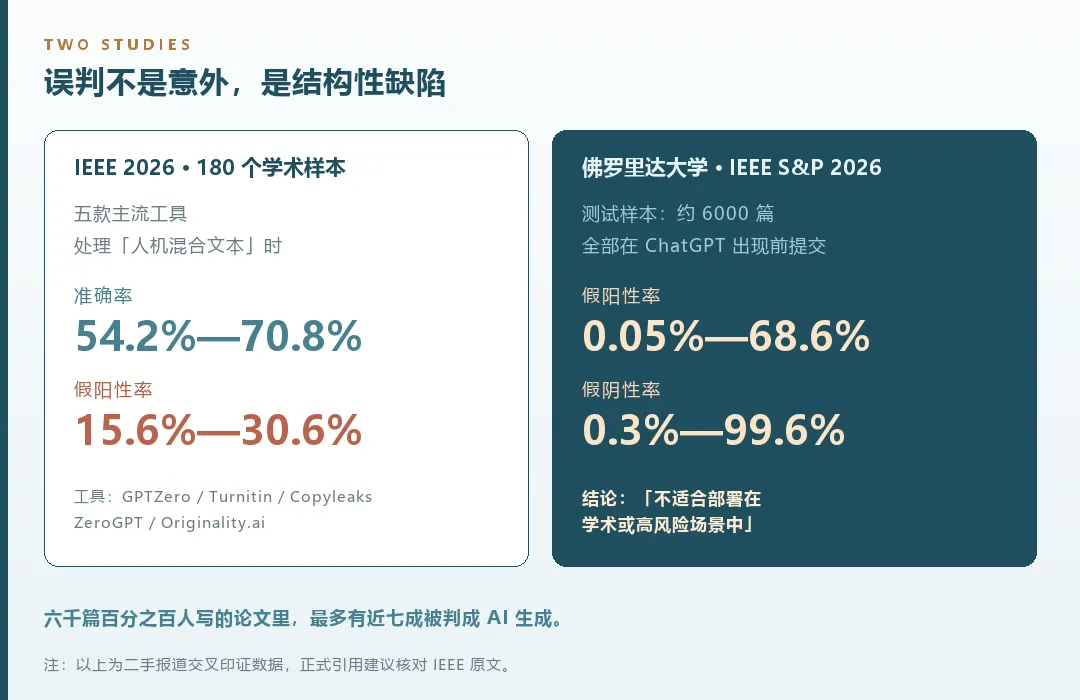
2026 年 IEEE 发表的一项实验评估,考察了五款主流工具——GPTZero、Turnitin AI Detection、Copyleaks、ZeroGPT、Originality.ai——在 180 个学术写作样本上的表现。
结果是:处理人机混合文本时,准确率下降至 54.2%—70.8%,假阳性率在 15.6%—30.6% 之间。
第二组:这个范围有多离谱。
佛罗里达大学团队在 2026 年 IEEE 安全与隐私研讨会上发表了更大规模的评估。他们对约 6000 篇 ChatGPT 出现之前就已提交的论文做测试——这些论文百分之百是人写的,没有任何 AI 参与的可能。
结果:多款商业检测工具的假阳性率在 0.05% 到 68.6% 之间,假阴性率在 0.3% 到 99.6% 之间。
研究团队的结论很直接:这些工具"不适合部署在学术或高风险场景中"。
第三组:谁最容易被误伤。
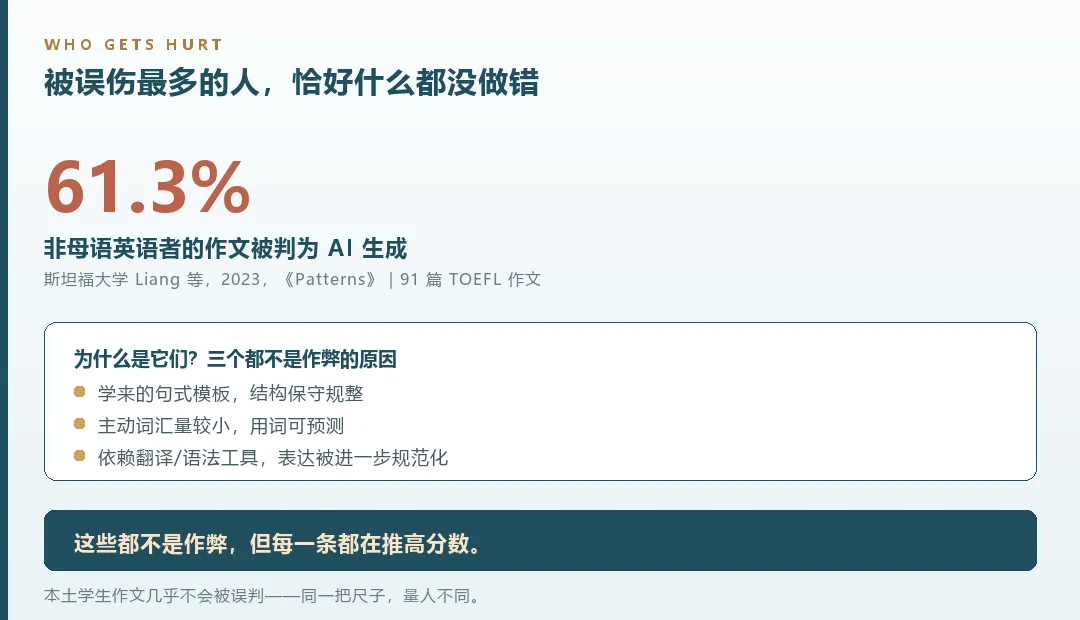
斯坦福大学 2023 年发表于《Patterns》的研究(Liang 等)发现:主流检测器把 61.3% 的非母语英语者作文判为 AI 生成,而美国本土学生的作文几乎不会被误判。
原因是结构性的:非母语写作者更多使用学来的句式模板、主动词汇量较小、表达更保守规整——这些恰好都是检测器读作"机器味"的信号。
这些都不是作弊,但每一条都在推高分数。
03有些学校已经不用了
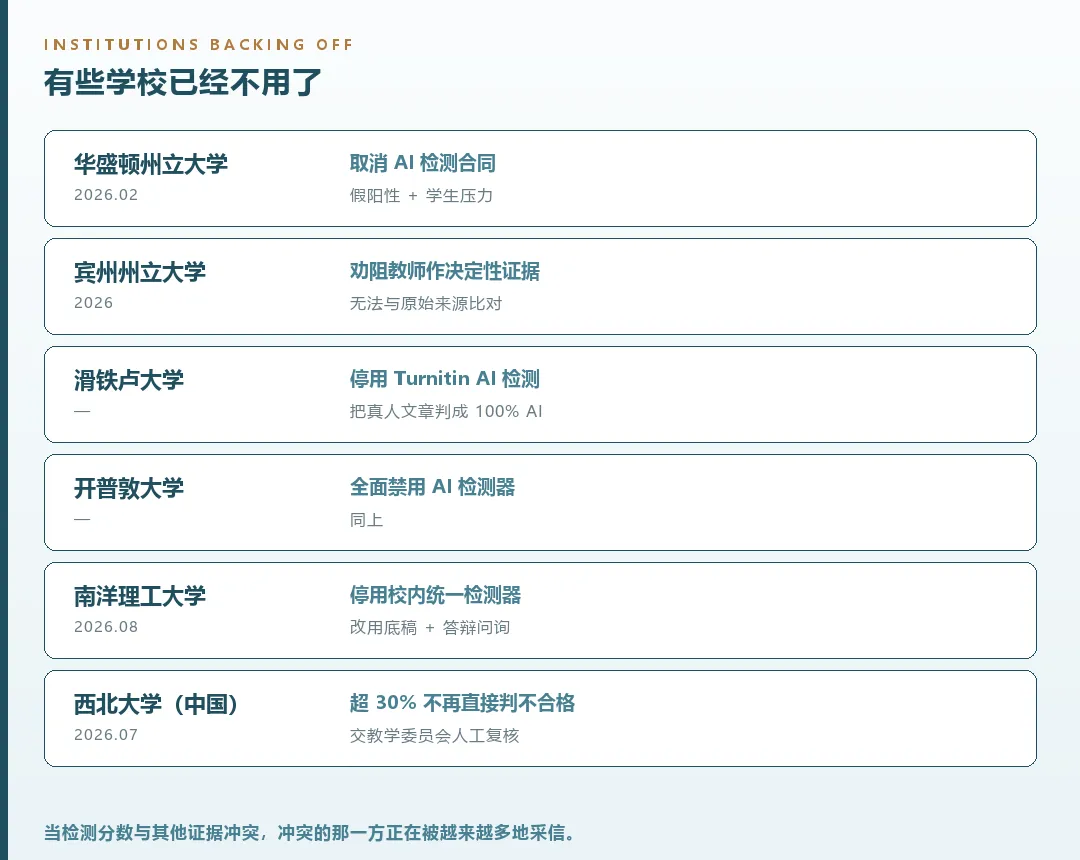
值得说的是,不少机构比学生更早意识到这个问题。
| 停用 | ||
| 全面禁用 | ||
还有一条法律层面的进展:2026 年 1 月,纽约一家法院撤销了一所大学的学术不端认定——那个案子里,Turnitin 报告显示 100% AI 生成,但其他证据与之冲突。
这些案例不构成"检测器一律不能用"的规则。但它们说明了一件很具体的事:
当检测分数与其他证据冲突时,冲突的那一方正在被越来越多地采信。
04一个反过来的现象
调研里还有一个细节,我觉得最值得说。
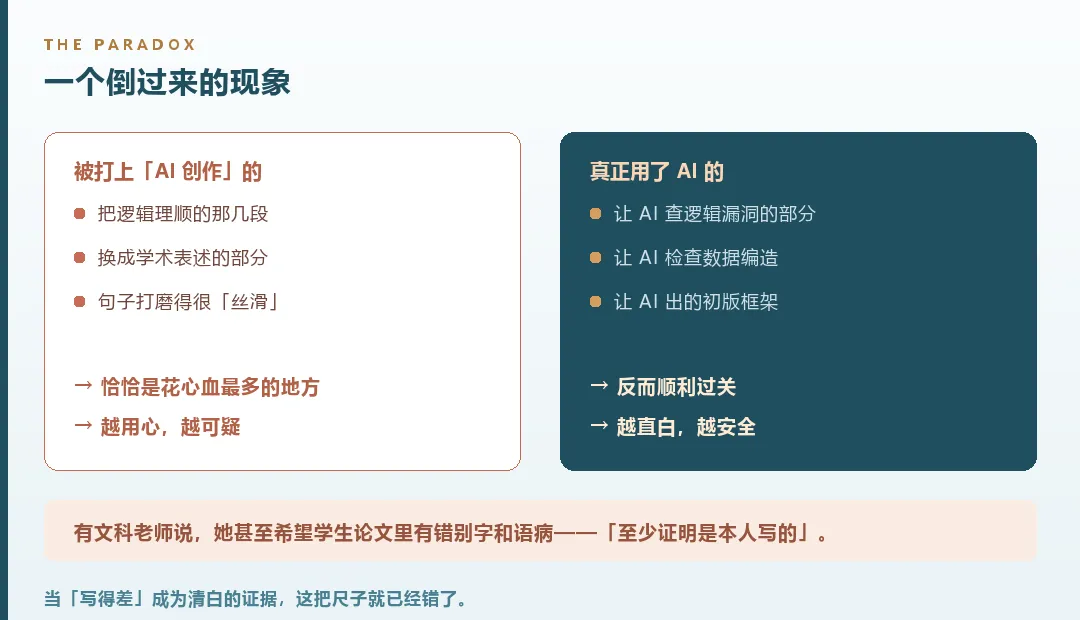
北京某高校研二学生李萤收到检测报告,密密麻麻标红。她仔细看完,哭笑不得——被判定为"AI 创作"的部分,不少是她花最多心血打磨的地方:把逻辑理顺、换成学术表述、句子润色得很"丝滑"。
而她确实用 AI 辅助过的部分,反而顺利过关了。
另一个例子更极端:山西某二本院校的一位老师,纯手写了一篇论文,平台检出 AIGC 率 80%。
湖南师范大学的张恒,同一篇文章、同一个格子达平台,间隔一周两次检测:第一次 7%,第二次 52.91%,风险等级直接跳到"高风险"。
同一篇、同一个人、同一个平台,一周之内从 7% 变成 52.91%。
这说明检测结果的可重复性本身就不稳定。而报告只会标"疑似 AIGC 内容",不会解释缘由——它不告诉你哪句话为什么被标,你也就无从反驳。
于是出现了那句在毕业生里流传的话:
"当 AI 变得越来越像人,我却要向 AI 证明我是人。"
还有更荒诞的:有文科老师坦言,她甚至希望看到学生论文里有错别字和语病——"这样至少证明作业是本人写的"。
当"写得差"成为清白的证据,这把尺子就已经彻底错了。它奖励的不是思考,是破绽。
05但也有学校做对了
不能只说问题,得看已经跑通的做法。
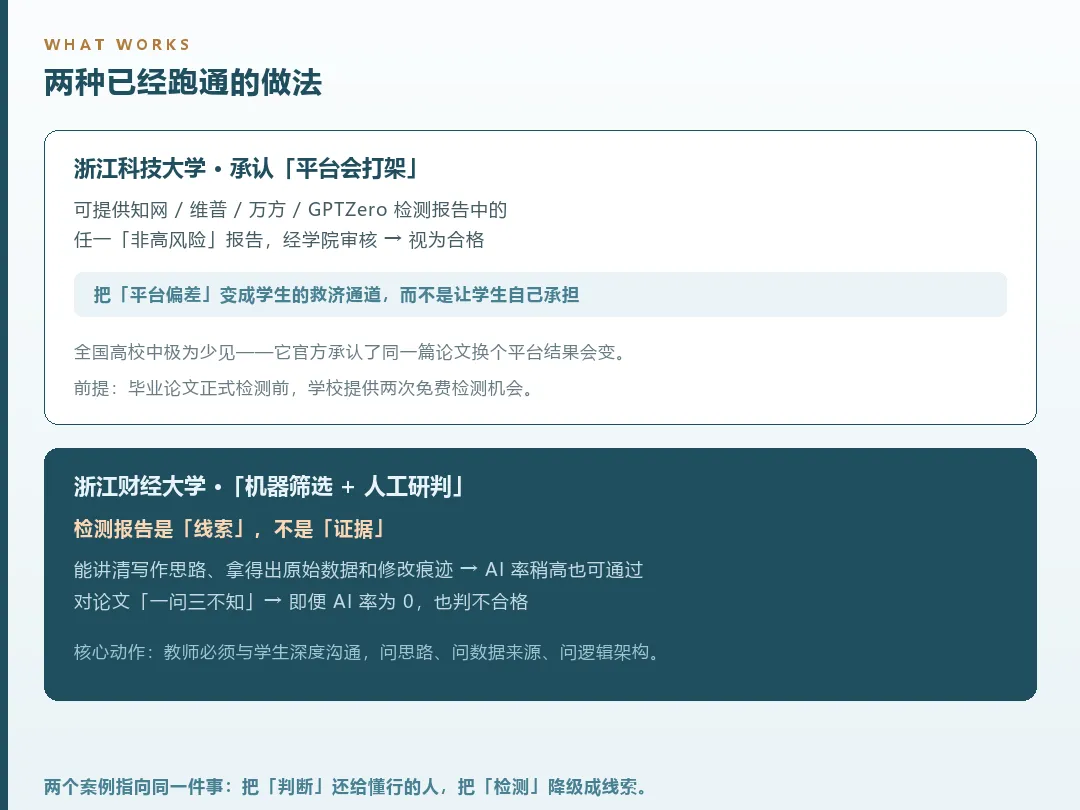
浙江科技大学有一条在全国高校里极少见的规则(经济学院 2026 届通知):
如对 AIGC 检测结果质疑,可提供知网、维普、万方或 GPTZero 检测报告中的任一非高风险检测报告,报经学院毕业设计工作领导小组审核通过后,可视为 AIGC 检测合格。
这条规则的分量在于:它官方承认了"不同平台结果会有较大偏差",并把这个偏差变成了学生的救济通道,而不是让学生自己承担。
浙江财经大学的做法是另一条路——"机器筛选 + 人工研判":
检测报告是"线索"而非"证据"。指导教师必须结合报告与学生深度沟通,问写作思路、数据来源、逻辑架构。如果学生能讲清楚、拿得出原始数据和修改痕迹,AI 率稍高也可以由教师专业判断通过;反过来,如果对自己提交的论文"一问三不知",即便 AI 率是 0,也判不合格。
这两个案例指向同一个方向:把"判断"还给懂行的人,把"检测"降级成线索。
06被误判了,该交什么材料
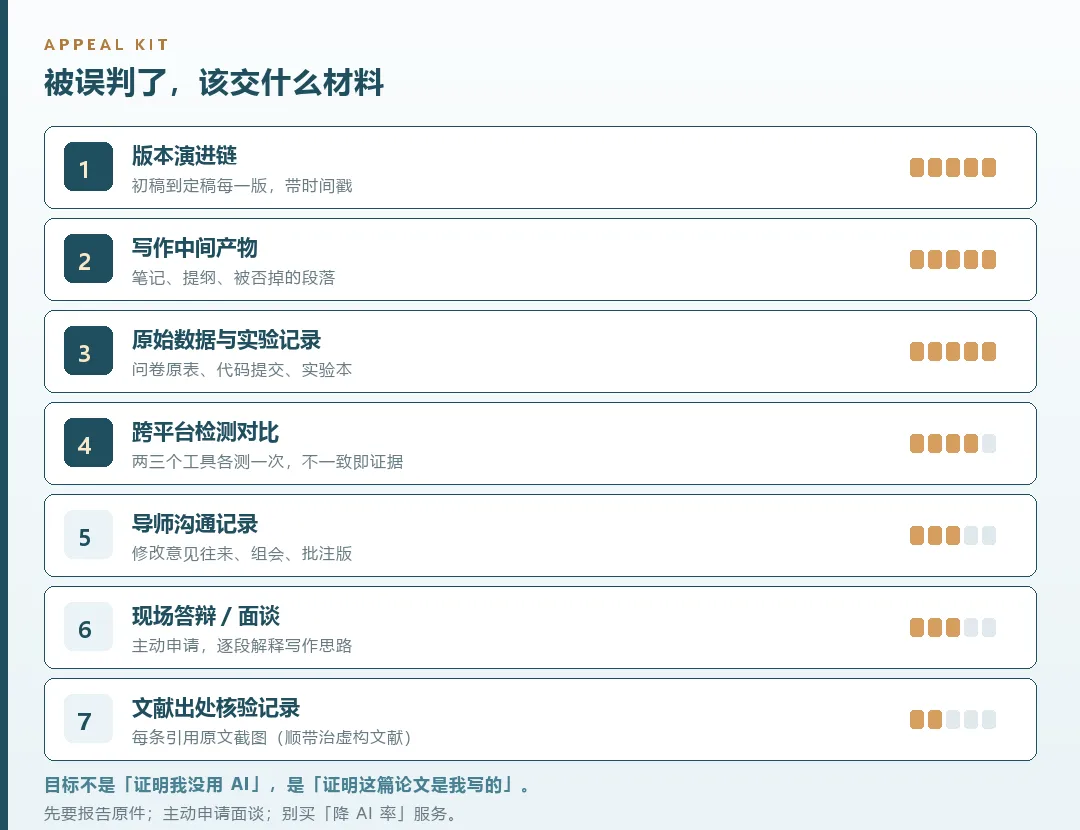
这是最实操的部分。前提先说清楚:申诉的目标不是"证明我没用 AI"——这件事很难证,因为你无法证明一个否定命题。目标是"证明这篇论文是我写的",这是一个可以被材料支撑的肯定命题。
按下面七类准备,从强到弱:
| 版本演进链 | |||
| 写作过程的中间产物 | |||
| 原始数据与实验记录 | |||
| 跨平台检测报告对比 | |||
| 导师沟通记录 | |||
| 现场答辩 / 面谈 | |||
| 文献出处核验记录 |
三条操作建议:
第一,先要报告原件。 不要接受口头或摘要式的通知。要求学校提供:用了哪个检测工具、具体分数、触发标记的阈值、以及被标红的段落位置。有多个已记录的案例中,学校没有向学生出示原始报告。
第二,主动申请面谈。 很多学校有这条通道但学生不知道。面谈时不要泛泛说"我自己写的",而是挑三段被标红的段落,逐句讲你是怎么想出来的——为什么选这个词、这段和上一段什么关系、数据从哪来。
第三,不要去买"降 AI 率"服务。 网上那类改写会把专业术语改错、把逻辑改乱,反而制造出真正的问题。而且这类操作本身就是新的学术风险。
07一句更根本的话
回到开头那个问题:检测工具为什么不准?
因为它回答的根本不是我们想问的那个问题。
我们想知道的是:这篇论文里的判断,是不是这个人自己做出来的。 它能回答的是:这段文字的写法,像不像机器生成的。
中间隔着的,是"人可以做很多机器做不了的事"——比如为了一个论证反复推翻自己,比如在数据不支持假设时诚实地改掉结论,比如明知道某个说法更好看但因为没有出处而不用。
这些都不体现在文字的统计特征里。
所以对写论文的人来说,最实际的结论是这一条:
既然一把尺子量不准,那就别只留一把尺子能看的东西。把过程留下。
初稿、推翻的版本、跑过的数据、改过的结论——这些不只是申诉材料,它们本来就是你做过这件事的证据。
沁言学术|AI 辅助论文写作平台
论文干货资料包
✅ 精选论文写作干货、通用模版、实用提示词,科研写作直接复用,省下300小时摸索时间。
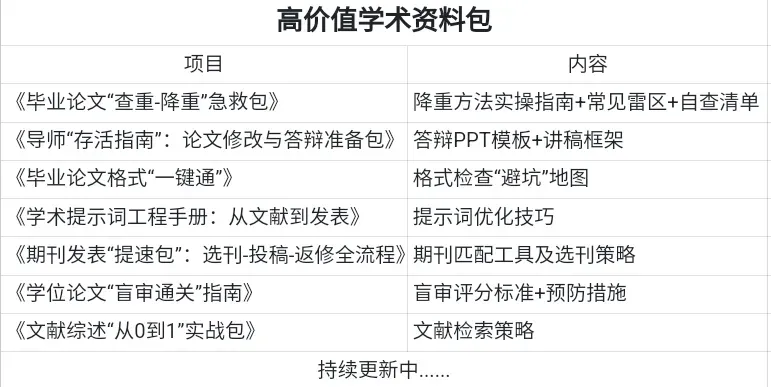
资料包详情
快速找到我们♥️
点击我,查看沁言学术所有功能模块的使用教程
视频号丨沁言学术安徽
小程序丨沁言学术SuperAgent